把记忆从文本里解放出来:ThinkFlow 用概率化潜在记忆 + 预测编码让对话 Agent 终身自进化
做记忆系统的同学估计都有同一个隐痛:不管你的 memory pipeline 设计得多精巧——抽取、摘要、入库、检索、拼接——只要中间经过"落地成文本"这一步,信息就必然有损。用户说"我最近不太想打扮了",显式记忆存下来的是一条干巴巴的事实,但这句话背后的情绪崩塌、和三个月前"我愿意花钱让自己好看"之间的剧烈反差,文本条目根本承载不了。
上周读到的 ThinkFlow(arXiv: 2609.17010)就是冲着这个根子来的:干脆别让记忆落地成文本,全程待在潜在空间里,做成一组概率化的"记忆技能"向量,再借认知科学里预测编码(Predictive Coding)的思路,让模型靠"预测用户下一句话"这个免费信号持续自我进化。说实话,这个方向今年已经有 MemGen(ICLR 2026)等探路者了,但 ThinkFlow 把"概率化建模 + 测试时自进化"这两件事第一次系统地串了起来,而且在 PersonaMem 上用一个 8B 模型追平甚至超过了 GPT-4o-mini 和 Llama3.1-405B 的表现——这个点值得我们仔细看看它是怎么做到的。
核心摘要:显式文本记忆把连续的人际交互压成离散字符串,细微的行为模式和情绪漂移全被压没了,而且部署后就固化,不会自己适应用户。ThinkFlow 提出端到端潜在记忆框架:用概率化潜在记忆技能(PLMS)把对话流压缩成 K 个解耦的高斯技能向量,门控潜在巩固器(GLC)控制新信息写入,上下文感知超对齐器(CAHA)负责把历史技能动态对齐到当前语义;训练上用"教师引导对齐冷启动 + 下一用户话语预测持续进化"的两阶段范式,实现无标注终身个性化。效果:Qwen3-8B 上 CC 数据集 Mauve 从 baseline 最高 58.19 涨到 77.20;PersonaMem 128K 设置下平均准确率 40.91%,超过 Llama3.1-405B 的 32.29%;token 开销 2,857、耗时 12.1 秒,只有 A-Mem 的 1/8。我的判断:这是潜在记忆路线里少见的"机制完整 + 效率可落地"的工作,但 BLEU 类指标在开放域对话上的说服力有限,且逐用户在线进化的工程代价论文没怎么展开,这两点读的时候要带着保留。
论文信息 - 标题:ThinkFlow: Self-Evolving Probabilistic Latent Memory for Lifelong Conversational Agents - 作者:Cai Ke, Xin Liu, Han Zhang, Jiangyue Yan, Zike Yuan, Ling Deng, Yue Yu, Hui Wang, Ruifeng Xu - 机构:鹏城实验室、哈尔滨工业大学(深圳)、中国联通粤港澳大湾区创新研究院 - arXiv:https://arxiv.org/abs/2609.17010 (2026 年 9 月 15 日提交)
顺带说一句,一作 Cai Ke 这条线已经连发了好几篇——Meta-Memory、Dynamic Memory Forest(SIGIR 2026)、Interactive Memory Learning(EMNLP 2026 Findings),ThinkFlow 是这条"对话记忆"研究线向潜在空间的一次范式跳跃。
🎯 问题:文本瓶颈到底卡在哪
先把论文要解决的问题掰开。终身对话 Agent 需要记忆系统维持长期个性化,但现有的显式记忆范式(expert pipeline 式的"抽取→摘要→检索→拼接")有两个结构性缺陷:
信息瓶颈。把连续、丰富的交互流强制物化成离散文本,隐含偏好、情绪状态、没说出口的行为模式这些"连续量"在摘要那一步就被丢掉了。论文 Figure 1 给的例子很形象:用户问"给我出个明天模拟面试的问题",显式记忆检索回来一堆东西——"用户看过明星访谈视频"(关键词噪声)、"用户 Python 排序小测挂了"(过时历史)、"用户偏好浅色模式"(琐碎属性),真正有用的"用户在面高级架构师岗位"只是其中一条。于是模型给出的回答是"我们来写个基础的 Python 脚本给明星名字排序,记得用浅色模式哦"——每一句都有"记忆依据",但组合起来完全跑偏。
部署固化。文本记忆库部署后就是静态的,没有显式反馈就不会自主进化。你不会每天告诉你的助手"我今天心情变了",但一个好的陪伴型 Agent 应该自己感觉出来。

图 1:两种记忆范式的对比。注意 (b) 里那条平滑的技能轨迹——情绪从"兴趣"滑向"焦虑"是个连续过程,而不是一条条离散记录
认知科学给了作者灵感:隐性心理理论(Implicit Theory of Mind)认为人脑根本不会给别人建"文本档案",而是在潜在抽象空间里持续追踪对方的心智状态;预测编码理论则说大脑不停生成对未来的自上而下预测,靠预测误差修正内部模型。ThinkFlow 就是把这两个机制工程化:记忆住潜在空间,进化靠预测用户下一句话的误差信号。
🏗️ 方法:三个组件 + 两阶段进化
形式化一下:第 \(t\) 轮对话,用户输入 \(x_t\),Agent 回复 \(a_t\),文本历史 \(H_{<t}\),潜在记忆状态 \(M_t \in \mathbb{R}^{K \times D}\)——\(K\) 个技能槽、每个 \(D\) 维。整套架构三个组件,训练两阶段,我们逐个看。

图 2:方法全景。右下 Phase 2 的 turn-by-turn 流程是这篇论文区别于静态潜在记忆工作的核心——记忆在每轮交互后被预测误差驱动更新
概率化潜在记忆技能(PLMS):不是向量,是分布
这是我觉得全文最有味道的设计。大多数潜在记忆工作(SoftCoT、Co-processor 这类)产出的是确定性向量——记忆就是一组点。ThinkFlow 不,它把每个记忆技能建模成一个高斯分布。
具体做法:当前轮的隐藏状态流(作者叫 thought stream)\(E_t \in \mathbb{R}^{L \times D}\),用 \(K\) 个可学习的潜在技能 \(S \in \mathbb{R}^{K \times D}\) 对它做 cross-attention 压缩。有个细节挺讲究——普通 attention 输出在压缩率很高时会塌缩,作者加了个保分布缩放因子:
其中 \(c = L/K\) 是压缩率。然后 \(C_t\) 过两个并行的线性层分别输出均值 \(\mu_t\) 和对数方差 \(\log\sigma_t^2\),训练时用重参数化 trick 采样:
再加个 KL 散度把近似后验往标准高斯先验上压。你想想看,这就是把 VAE 的思想搬到了记忆槽上:方差 \(\sigma_t\) 显式建模了"我对这条记忆有多确定"这件事。用户明确说了"我住巴黎",均值锐利、方差小;用户含糊其辞,分布就扁。这种认知不确定性的显式表达,是确定性向量给不了的。
这 \(K\) 个技能槽还会自主分化成专门通道——事实、情绪、偏好各占各的,互不干扰,论文叫"解耦的记忆技能表示"。后面 t-SNE 可视化会验证这不是空话。
门控潜在巩固器(GLC):垃圾信息别进来
潜在记忆面临的第二个问题是语义稀释——闲聊里的"哈哈""嗯""可能吧"也会触发更新,记忆库很快被噪声污染。GLC 用一个信息增益门控来把关:
门控值 \(g_t \in (0,1)^{K \times D}\),由新旧技能的拼接表示经 MLP 学出来。然后套一个 GRU 核做条件更新:
Figure 2 里给了直观例子:"ha-ha / uh / maybe"这类输入门控值低到 0.12,直接挡掉;"hotel / Paris / $200"这种实义信息门控值 0.91,放行入库。用 GRU 而不是简单线性插值,是为了保持潜在流的时序性,同时优雅遗忘过时内容。
上下文感知超对齐器(CAHA):历史记忆和当前语境的翻译官
第三个问题更隐蔽:历史潜在技能和 LLM 当前语义上下文之间存在分布鸿沟——记忆是过去压缩出来的,直接 prepend 进去可能"驴唇不对马嘴"。CAHA 用 hypernetwork 思路,根据当前 query \(x_t\) 的语言特征动态生成一个低秩变换矩阵:
\(W_{down} \in \mathbb{R}^{D \times r}\)、\(W_{up} \in \mathbb{R}^{r \times D}\) 构成秩 \(r\) 的瓶颈,参数量很小。最终对齐是残差形式:\(S_{aligned} = S_t + S_t \times W_{adapt}\),然后把这些对齐后的技能作为 soft prompt 前置给 LLM。主干 LLM 只挂 LoRA,不动全参数。
两阶段测试时进化:冷启动靠蒸馏,之后靠自己
这套架构最大的卖点是部署后还能继续学。分两阶段:
Phase 1:教师引导潜在对齐。用户第一个 session 冷启动,让一个强大的教师模型读完整文本历史 \(H_{<t}\),输出目标分布 \(P_T(y \mid H_{<t}, x_t)\);学生模型只能看当前 query 和潜在技能,输出 \(P_S(y \mid S_t, x_t)\)。用 KL 蒸馏逼学生模仿教师:
本质是把"读全文教师的理解能力"蒸馏进"只看潜在记忆的学生",建立初始记忆锚点。注意教师和学生用同一个基座模型实例化,保证表示空间和词表严格对齐。
Phase 2:下一用户话语预测。从第二个 session 开始教师下线,完全自监督。机制很巧:第 \(t\) 轮 Agent 回复 \(a_t\) 后把记忆更新到 \(S_{t+1}\);第 \(t+1\) 轮用户说了 \(x_{t+1}\)——系统用 \(S_{t+1}\) 和 \(a_t\) 去预测用户会说什么。如果记忆没抓住核心上下文,预测就会失败,交叉熵损失升高,这个高损失直接迫使 GLC 门控关闭,防止坏更新污染记忆库。再加一个最小熵置信先验 \(\mathcal{L}_{Conf}\) 防止预测塌缩成模糊分布:
这就是预测编码的工程版:用户的下一句话是免费、海量、持续不断的监督信号。用户根本不用给任何显式反馈,模型就靠"我猜你接下来要说什么,猜错了就修正"来跟踪你的状态漂移。
说实话我第一次看到这个设计时有个疑问:用户的下一句话经常是不可预测的(用户突然换话题怎么办),高 CE 不见得是记忆差。论文的处理是让高损失关门——这算是个保守的启发式,至少保证不被噪声带偏,但理论上会牺牲一部分对"用户行为突变"的响应速度。这点论文没展开讨论,算是个小遗憾。
🧪 实验:8B 追平 405B,Mauve 大幅领先
实验分两块:长期生成(CC、MSC、GC 三个长程开放域对话数据集,BLEU-4/ROUGE-L/BertScore/Mauve)和个性化记忆问答(PersonaMem,32K/128K/1M 三档语料规模)。基线铺得很全:Long Context、GraphRAG、MemTree、MemGPT、A-Mem、Mem0、MemoryOS、MemoChat、MemoryBank、Rsum、COMEDY、LD-Agent、THEANINE、LightMem,加潜在范式的 SoftCoT、Co-processor、MemGen。基座用 Llama3.2-3B 和 Qwen3-8B。
主实验(Table 1),Qwen3-8B 在 CC 上:
| 方法 | BLEU-4 | ROUGE-L | BertScore | Mauve |
|---|---|---|---|---|
| Long Context (128K) | 0.66 | 10.72 | 45.89 | 21.43 |
| Mem0 | 0.72 | 12.23 | 43.12 | 45.89 |
| MemoryBank | 1.22 | 14.91 | 43.40 | 47.53 |
| THEANINE | 1.23 | 14.77 | 43.27 | 58.19 |
| MemGen | 0.64 | 9.86 | 41.51 | 26.92 |
| ThinkFlow | 2.18 | 17.83 | 47.77 | 77.20 |
几个观察。第一,ThinkFlow 四项全面第一,Mauve 从 baseline 最高的 58.19(THEANINE)涨到 77.20,这个跨度相当能打——Mauve 衡量的是生成文本与人类文本的分布距离,是这组指标里最接近"像不像人话"的。第二,有意思的是直接喂全历史(Long Context)表现垫底,语义稀释是真实存在的。第三,潜在范式的另外两个代表 SoftCoT 和 MemGen 在这个任务上表现反而不如显式方法——说明"用潜在记忆"本身不保证赢,ThinkFlow 的门控 + 概率建模 + 进化机制才是关键增量。
不过我得泼点冷水:开放域对话上 BLEU-4 的绝对值普遍在 2 分上下,n-gram 重叠指标对这种任务的信息量本来就弱,2.18 vs 1.23 的差距有多少实际意义要打个问号。这组实验真正有说服力的是 Mauve 那一列。
PersonaMem(Table 2),这个基准覆盖 7 类个性化任务(回忆共享事实、确认最新偏好、追踪状态演变等),32K/128K/1M 三档。ThinkFlow-8B 平均准确率:
| 设置 | ThinkFlow-8B | 最强可比 baseline | 参考:闭源/超大模型 |
|---|---|---|---|
| 32K | 44.43(+5.40) | MemoryBank 39.03 | GPT-4o-mini 31.57 |
| 128K | 40.91(+3.86) | MemGen 37.05 | GPT-4o-mini 43.29 / Claude3.7-Sonnet 30.43 / Llama3.1-405B 32.29 |
| 1M | 41.94(+2.36) | MemGen 38.86 | Gemini2.0-Flash 44.71 |
128K 档超过 Llama3.1-405B 八个多点,也压过 Claude3.7-Sonnet;但注意 128K 和 1M 档 GPT-4o-mini / Gemini2.0-Flash 还是更高(43.29 和 44.71)——论文宣称的"rivals or even surpasses"要打折看,严格说是"超过超大开源模型,逼近但未全面超越一线闭源模型"。另外这些闭源模型的数字标了 ∗,是从 PersonaMem 原论文里搬来的,评估上下文不完全可比。
最亮眼的是细分任务里的 Revisit Reasons(回溯行为原因):1M 档 ThinkFlow 68.09,比最强 baseline 高出 15.32 个点。这类需要跨长程追踪"用户为什么改变主意"的任务,正好是潜在连续记忆的强项。
消融(Table 3,CC 数据集,Qwen3-8B),Mauve 列:
| 变体 | BLEU-4 | ROUGE-L | BertScore | Mauve |
|---|---|---|---|---|
| 完整 ThinkFlow | 2.18 | 17.83 | 47.77 | 77.20 |
| w/o PLMS | 1.88 | 16.54 | 45.53 | 66.48 |
| w/o GLC | 1.94 | 16.99 | 45.59 | 64.98 |
| w/o CAHA | 2.04 | 17.45 | 44.98 | 67.65 |
| w/o Phase1 | 2.00 | 17.33 | 44.84 | 67.87 |
| w/o Phase2 | 2.04 | 17.27 | 44.87 | 69.02 |
五个组件全都有正贡献,PLMS 和 GLC 拆掉后 Mauve 掉得最狠(-10.7 和 -12.2),验证了解耦技能表示和门控过滤是根基;两阶段训练各贡献 8~9 个点,测试时进化不是摆设。
机制分析里最说服我的是两张图。t-SNE 可视化显示,"共享事实"类记忆在潜在空间聚成一个致密的小簇(静态客观知识就该这样),而"追踪状态演变"的记忆铺开成一片宽阔的连续流形——潜在空间真的把"静态事实"和"动态状态"分开了,不是设计出来的标签,是自发涌现的结构。
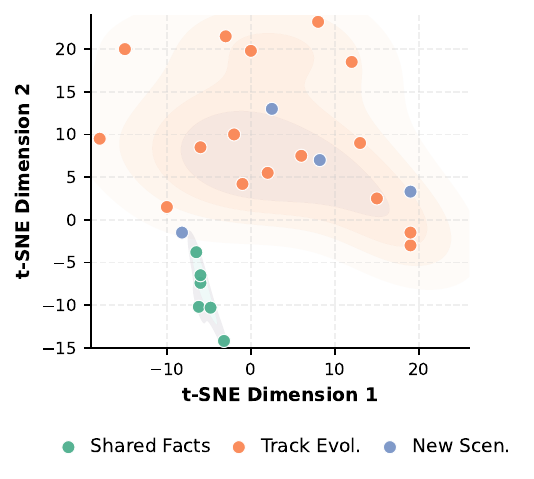
图 3:潜在记忆空间的可解释性验证——静态事实聚簇、动态状态成流形
技能数 \(K\) 从 1 扩到 10,平均准确率从约 38 单调涨到 42.5 左右,复杂推理子任务(Revisit Reasons、Track Evolution)受益最大。\(K=10\) 对应 7 类任务上留了冗余容量,作者说是"记忆容量超过任务复杂度时的性能上界测试"。
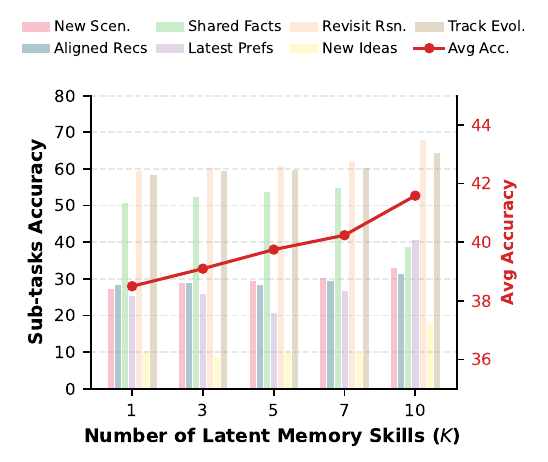
图 4:记忆容量扩展实验——K 越大解耦越细,个性化越准
效率是另一个杀手级卖点。CC 数据集上跨 session 累计统计:ThinkFlow 全程消耗 2,857 token、12.1 秒;A-Mem 要 27,450 + 43,793 隐藏 token、94.9 秒;MemTree 21,339 + 33,868 隐藏 token、57.8 秒。差了将近 8 倍。显式方法的大量开销藏在"中间记忆处理"的隐藏 token 里(抽取、摘要、写库都要跑 LLM),而潜在记忆全程不进文本态,这个优势是范式级的。
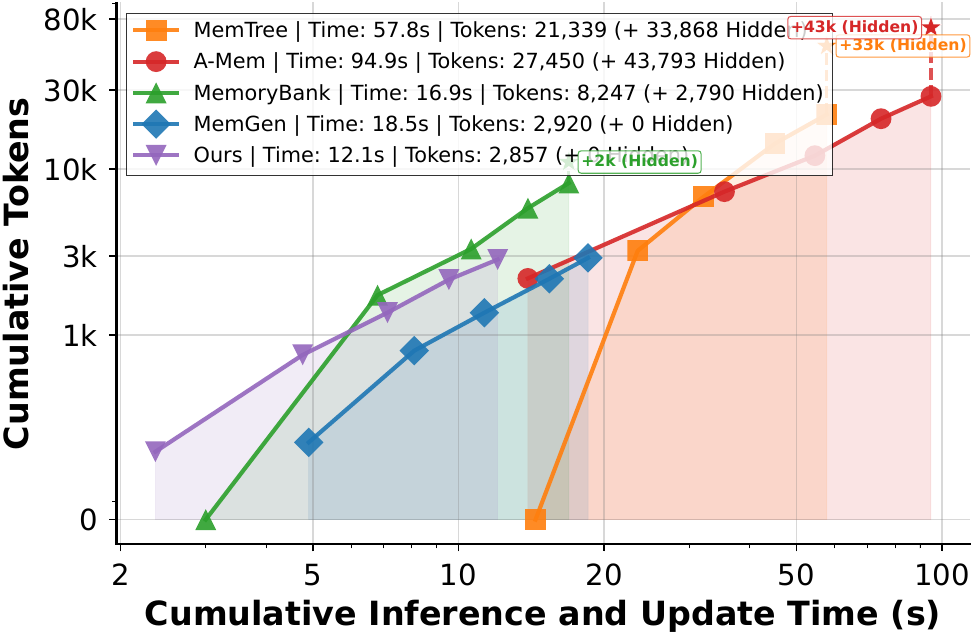
图 5:效率对比——注意图例里 A-Mem 的 "+43,793 Hidden" token,显式记忆的真实成本藏在水下
案例研究(Table 4)很打动人:夫妻关系危机导致用户兴趣剧变——Session 3 用户还说"我愿意花钱让自己好看",Session 5 爆发信任危机,当前轮说"感觉那是上辈子的事了,最近没心思打扮"。显式检索的 MemTree 被"dressing up"这个表面词触发,检索出过时的夹克记忆,回了一句"要不我们一起试试新风格"——情绪上完全不在一个频道。ThinkFlow 的潜在状态从"对时尚的兴趣"平滑漂移到"深度悲伤",回应是"在经历这么多痛苦的时候,对打扮失去兴趣再正常不过了。我陪着你,慢慢来。"这就是连续状态追踪和离散相似度检索的本质差别。
🤔 我的判断
这篇论文最值钱的地方,不是某个单点模块,而是它把"记忆"这个系统的三个层面统一进了潜在空间:存储(概率化技能分布,带不确定性)、管理(信息增益门控 + GRU)、进化(预测编码自监督)。显式范式里这三件事是割裂的 pipeline,各环节都过一遍文本,损失层层叠加;ThinkFlow 全程不落地,效率数字(1/8 时间、1/10 token)就是范式红利。
和同期的 MemGen 对比着看很有意思。MemGen 也是潜在记忆,但它强调"触发器决定何时回忆 + 编织器生成记忆 token 注入推理流",主干完全冻结,更像推理时的记忆外挂;ThinkFlow 则是把记忆做成一个持续在线更新的状态系统,强调跨 session 的终身进化。一个偏"推理时交织",一个偏"跨时间演化",其实互补——我很好奇把 MemGen 的触发机制和 ThinkFlow 的概率技能槽拼起来会怎样。
但有几个保留意见不得不说:
- 逐用户在线进化的工程代价。Phase 2 要求每个用户的记忆状态 \(M_t\) 都独立存储、每轮交互后反向传播更新——这在真实部署里是 per-user 的训练任务,存储、算力、隐私(潜在向量同样可能泄露个人信息,而且不可审计)都是坑,论文完全没碰。
- 不可读性的双刃。潜在记忆机器原生、人不可读,出错时没法 debug,也没法让用户查看/编辑"Agent 记住了我什么"。MemGen 的解读里也提到同样的担忧。对于需要合规审计的产品场景,这可能是硬伤。
- 评估指标的说服力。开放域对话的 BLEU/ROUGE 绝对值都低到 2 分上下,这个量级上的差距解读空间有限;真正撑住结论的是 Mauve 和 PersonaMem 准确率。
- 闭源 baseline 的数字是二手的(标 ∗ 从原基准论文搬来),评估条件不完全对齐,"超过 GPT-4o-mini"这类说法要留有余地。
对做记忆系统的工程启发倒是很直接:显式记忆管线里"文本落地"这一步如果省不掉,至少可以在关键路径上加一道潜在态缓存;而"用下一用户话语做免费监督信号"这个思路,即使不搬到潜在空间,拿来给显式记忆做写入质量控制(预测失败 = 上次写入没抓住重点)也是即插即用的。
📝 收尾
记忆系统这一年明显在从"文本数据库"向"机器原生表示"迁移,ThinkFlow 是这条路上机制最完整的尝试之一:概率化建模解决不确定性表达,门控解决噪声过滤,预测编码解决部署后进化。8B 追平超大模型的数字背后,本质是"信息不过文本这道窄门"带来的范式红利。它不会立刻取代 Mem0 这类工程成熟的显式方案——可解释性和可审计性的债总要还——但对于陪伴型、个性化驱动的场景,这条路值得认真跟。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我