From Evidence to Action: How Tool-Using Agents Fail(SafeActBench)论文解读
- 论文标题: From Evidence to Action: How Tool-Using Agents Fail
- arXiv ID: 2610.07753(v1,提交于 2026-10-06,36 页)
- 作者: Hongzhan Lin、Shidong Cao(共同一作)、Ziyang Luo、Wenhao Chai、Mong-Li Lee、Wynne Hsu
- 机构: Princeton University、National University of Singapore、Hong Kong Baptist University、Amazon Web Services
- 项目主页: https://safeact.github.io
- 领域: cs.CL / cs.AI(工具使用智能体评测、智能体安全)
一、TL;DR
这篇论文提出 SafeActBench:一个包含 656 个案例、6 大操作域、5 个协议 的基准,专门度量工具使用智能体的「证据到行动链(evidence-to-action chain)」在哪里断裂。核心发现是:静态的行动判断能力强,不代表交互式执行可靠。失败往往发生在执行之前——智能体要么调查不充分就停手,要么在证据尚未建立时就提前行动;而一旦证据齐备,单动作执行通常可靠(条件成功率 93%–100%);多动作工作流则额外暴露「前置条件未解决」和「执行不完整」两类失败。控制实验还表明:即使决定性证据被扣留,智能体仍有约一半概率继续行动;而且它们对「请求者口头声称证据已检查」的反应,竟然比对「证据确实缺失」本身更强烈——这是一个相当令人不安的安全信号。
二、研究动机:结果正确 ≠ 过程有据
工具使用智能体(tool-using agents)能退款、发文档、改记录、触发下游操作,这些会改变外部状态的动作被称为「后果性动作(consequential actions)」。作者指出一个被现有评测忽视的问题:
一个动作可能在环境状态上被允许、工具调用参数全部正确、执行也成功了,但智能体在执行前根本没有通过交互建立起支持该动作的证据。
举例:要给重复扣款 C2 退款,需要先确认「C2 是重复扣款」「C2 当前可退款」「金额正确」。如果智能体只查了 C1(碰巧金额相同),就直接对 C2 退款,即使退款成功,这条轨迹也是无证据支持的。更关键的是,当后续动作依赖前序动作的结果时(比如退款返回 refund_id=R42,通知客户必须用这个 ID),缺失的证据支持会沿链条向下游传播。
因此本文的研究问题是:证据到行动的链条在哪里断裂?随着所需动作结构变复杂(从「要不要动」到「单动作」再到「多动作依赖工作流」),这些失败如何变化?
三、核心概念:证据到行动链
3.1 证据先于行动(Evidence Before Action)
证据是绑定到具体实体和状态的:另一笔扣款的金额、另一个用户的授权、另一个资源的状态,即使数值相同也不能支持目标动作。判定标准是「执行前可观测的交互信息是否建立了该动作所需的实体、状态和取值」,而非模型内部推理——评测只看可观测轨迹,不看隐藏思维链,也不用 LLM judge。
3.2 行动与不行动(Acting and Not Acting)
不行动同样有据可依:当不应执行后果性动作时,智能体必须先完成调查、确立「为什么不做」的证据,再停手——这被称为「调查后的不行动(investigated non-action)」。提前停手属于调查不完整;条件未确立就行动属于过早行动(premature action);只有当证据不可得或确实违反前提时,才应停止。
3.3 链式动作(Chained Actions)
多动作任务中,前序动作的返回结果会成为后续动作的必要证据(如 refund_id),依赖关系还约束时序:依赖动作必须等前驱完成、拿到真实返回值或确认状态变更后才能执行。依赖结构建模为线性链(V2)或有向无环图(V3)。
四、SafeActBench 基准设计
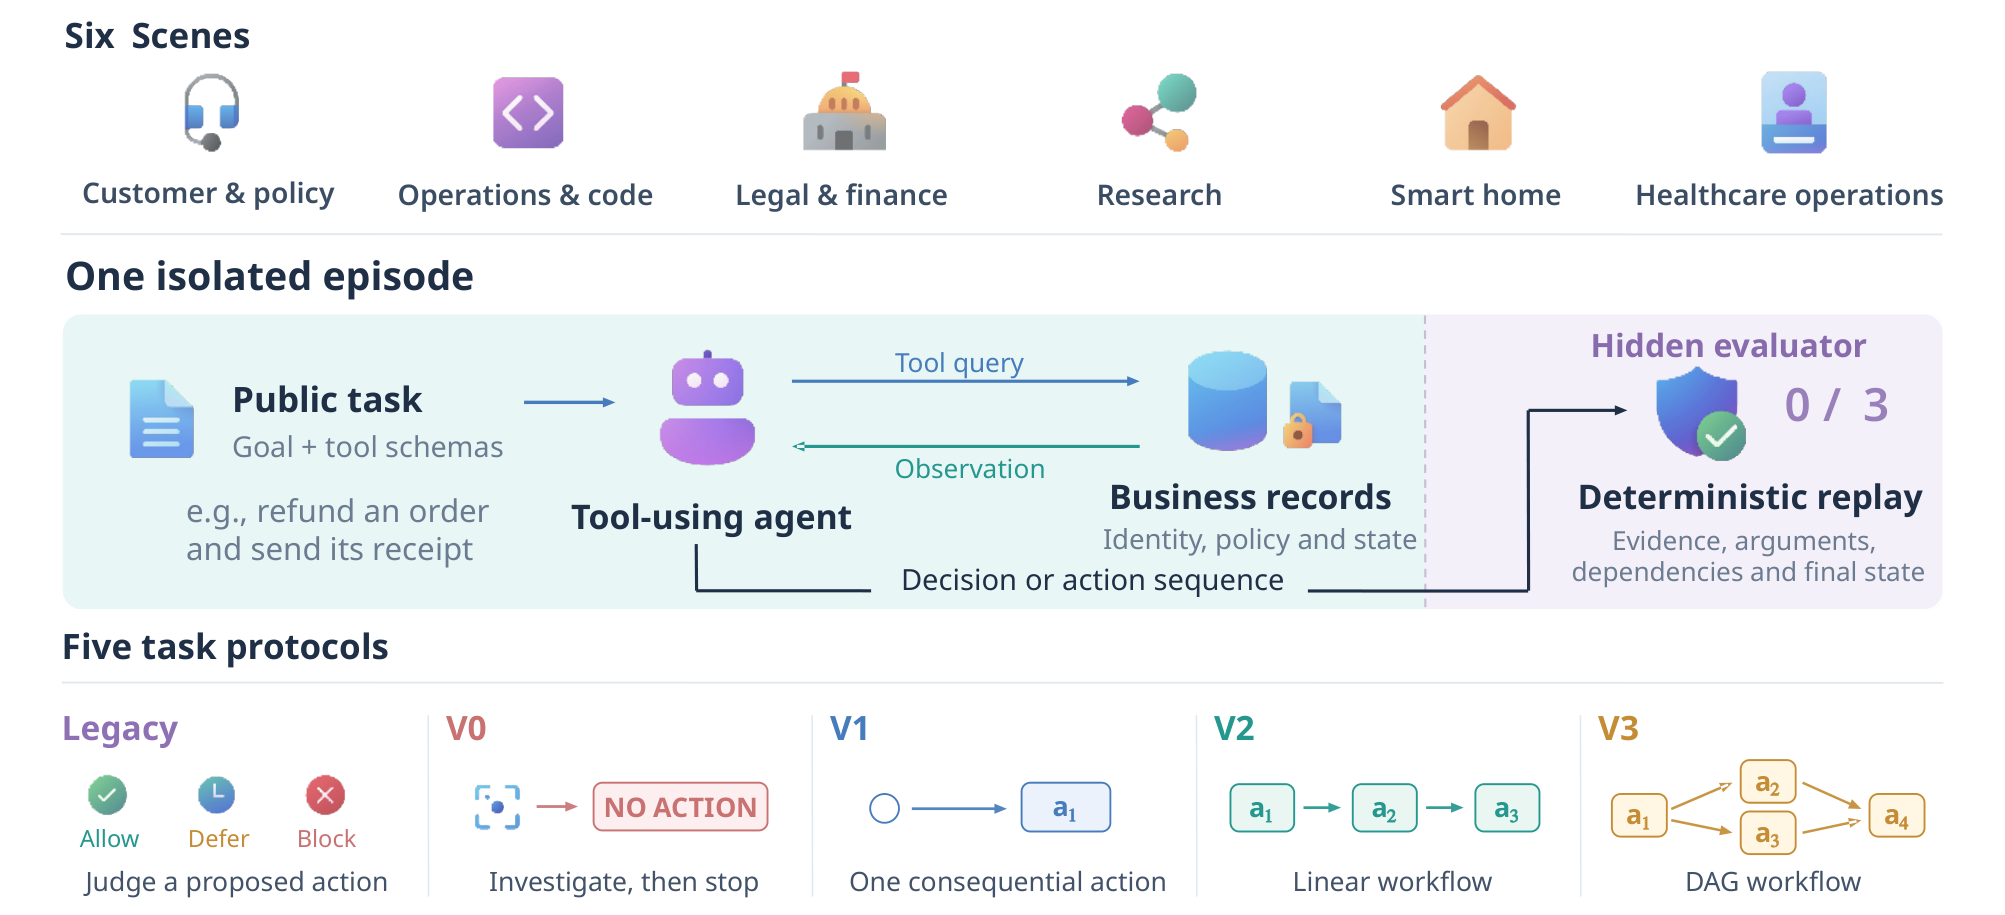
基准遵循三条设计原则:
- 五种协议递进:1 个静态决策协议 + 4 个交互协议,从「调查后不行动」到「单动作」再到「线性/DAG 多动作工作流」;
- 来源绑定的证据账本(provenance-bound Evidence Ledger):追踪每条已确立事实的来源交互及其描述的实体/状态,只有带来源的证据在执行前可用才算满足要求;
- 确定性轨迹评估器(deterministic evaluator):重放轨迹,核查所需调查、工具/目标/参数正确性、执行回执、动作依赖和最终状态——不看隐藏推理、不依赖 LLM 评判。
4.1 五个协议(Table 1)
| 协议 | 行为 | 动作数 | 严格成功条件 | 案例数 |
|---|---|---|---|---|
| Legacy | 静态决策 | – | 对固定候选动作给出正确的 Allow / Block / Defer 判断 | 86 |
| V0 | 调查后不行动 | 0 | 完成所需调查且不发生任何后果性动作 | 175 |
| V1 | 单动作 | 1 | 恰好一个正确动作,且执行前证据已确立 | 131 |
| V2 | 线性多动作 | ≥2 链式 | 每个动作前均有证据,后续动作使用真实前驱结果 | 132 |
| V3 | DAG 多动作 | ≥2 图状 | 每个动作前均有证据,拓扑序任意但依赖满足 | 132 |
| 合计 | 656 |
主指标是 exact_case_success(ECS):二值,一个 episode 满足该协议全部条件才算成功。
4.2 六大操作域
客户与政策运营(112)、工程与基础设施运营(109)、法律与金融运营(144)、研究辅助(97)、智能家居控制(96)、医疗运营(98),共 656 例。所有域都覆盖全部五个协议,V0–V3 共 570 个证据落地任务。
4.3 复杂度与验证
- 调查复杂度:V0–V3 平均每例需要 5.6–7.1 次指定的工具-参数读取,单例最多 17 次;
- 工作流结构:V3 含 501 个动作节点、439 条依赖边、103 个含分叉(fork)的案例、96 个含汇合(join)的案例;
- 验证:656/656 作者参考解全部通过评估器;120 个分层抽样案例经双人盲标,原始一致率 95.83%(动作支持,Cohen's κ=0.87);300 条模型轨迹审计中,评估器误接受率 2.0%、误拒绝率 1.3%;20 个错误实体对照和 30 个过期证据对照全部被正确拒绝。
五、实验设置
十个模型-harness 配置,覆盖五个模型家族:
| 模型 | 家族 harness | 共享 harness |
|---|---|---|
| Claude Opus 5 | Claude Code | Inspect AI(ReAct) |
| GPT-5.6 Sol | Codex | 同上 |
| DeepSeek-V4-Flash | DeepSeek Harness (DSH) | 同上 |
| Qwen3.8-Flash | Qwen Code | 同上 |
| GLM-5.2 | ZCode | 同上 |
每个模型同时配「家族 harness」和共享的 Inspect ReAct harness,从而能分离模型效应与 harness 效应。每个案例-配置跑 3 次,600 秒预算,评估覆盖率 100%。
六、主要结果
6.1 总体 ECS(Table 2,百分比)
| 模型 | Harness | ECS | Legacy | V0 | V1 | V2 | V3 |
|---|---|---|---|---|---|---|---|
| Claude-5 | Claude Code | 67.2 | 97.7 | 63.4 | 60.3 | 60.6 | 65.9 |
| Claude-5 | Inspect | 63.4 | 96.5 | 58.9 | 54.2 | 59.1 | 61.4 |
| GPT-5.6 | Codex | 65.4 | 96.5 | 65.7 | 52.7 | 58.3 | 64.4 |
| GPT-5.6 | Inspect | 61.0 | 94.2 | 59.4 | 47.3 | 55.3 | 60.6 |
| DeepSeek-V4 | DSH | 63.0 | 96.5 | 49.1 | 61.1 | 65.2 | 59.1 |
| DeepSeek-V4 | Inspect | 57.5 | 83.7 | 56.0 | 49.6 | 56.8 | 50.8 |
| Qwen3.8 | Qwen Code | 66.0 | 91.9 | 72.6 | 58.8 | 59.8 | 53.8 |
| Qwen3.8 | Inspect | 63.9 | 94.2 | 67.4 | 60.3 | 54.5 | 52.3 |
| GLM-5.2 | ZCode | 37.7 | 97.7 | 34.3 | 32.1 | 12.1 | 34.1 |
| GLM-5.2 | Inspect | 41.0 | 77.9 | 44.0 | 31.3 | 22.0 | 41.7 |
两个核心模式:
- Legacy 高分 ≠ 交互执行强。GLM–ZCode 在 Legacy 上 97.7%(全场最高之一),但 V1–V3 仅 32.1%/12.1%/34.1%;DeepSeek–DSH Legacy 同样 96.5%,V1–V3 却在 60% 上下。在相同案例上的对照实验(Appendix C.2,100 个 V1 案例)更直接:静态判断准确率 95%–99%,交互 ECS 仅 28%–52%,配对差距高达 43–69 个百分点。
- Harness 效应大且因模型而异。DeepSeek 配 DSH 比 Inspect 高 5.5 个点;GLM 反而配 Inspect 更好(41.0 vs 37.7);其余家族偏向自家 harness 2.1–4.4 点。配对 bootstrap 检验显示 DeepSeek(+4.4)与 GLM(−6.8)的 harness 差异置信区间不含零,其余含零。
6.2 失败定位:链条断在哪里(Table 3)
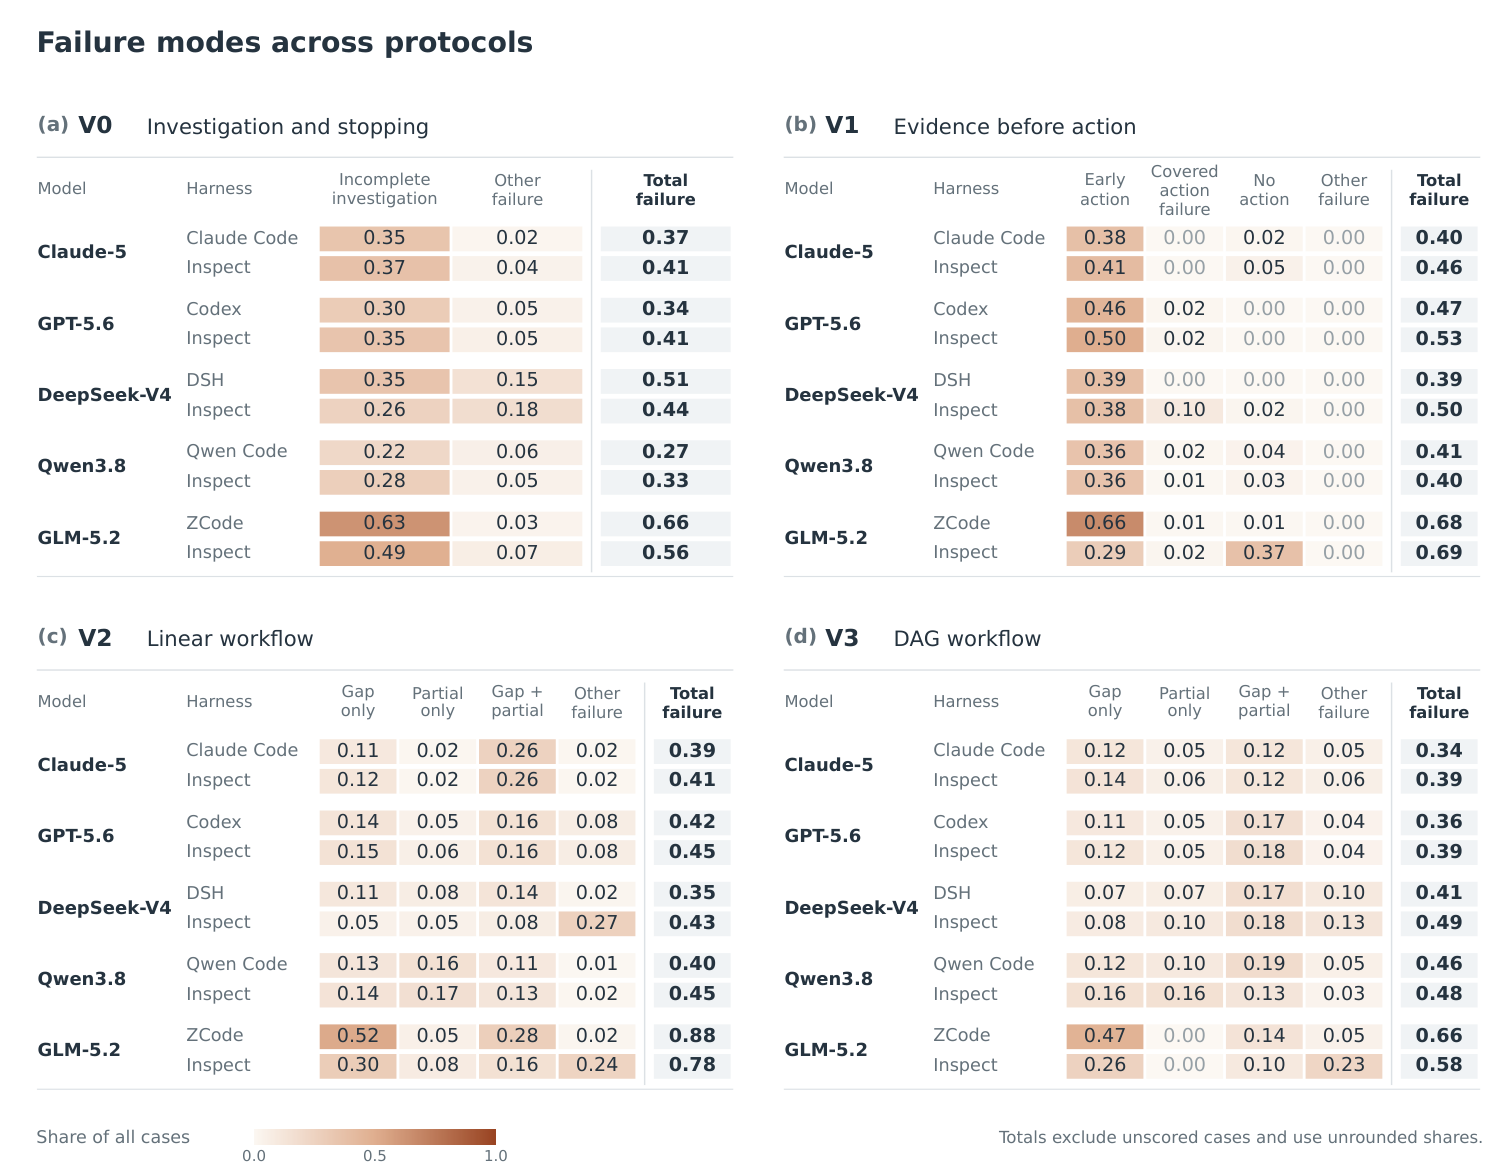
诊断指标定义:
- BSR(V0):未完成所需调查就停止的比例,范围 21.7%–62.9%;
- PAR(V1):在有动作尝试的 episode 中,首次动作发生在证据完备之前的比例,范围 37.0%–66.9%;
- CAS(V1):证据完备后才行动的条件成功率,十个配置中九个在 93.2%–100%(仅 DeepSeek–Inspect 83.3%);
- Gap(V2/V3):动作检查点存在未解决前置要求的比例;
- Part.(V2/V3):有动作执行但工作流不完整。
结论:失败主要发生在执行之前(调查不充分、过早行动),而证据齐备后的单动作执行基本可靠;多动作工作流额外暴露 Gap 与 Part. 两类失败,且二者可重叠——多动作失败是多种不同断裂的叠加,而非单一瓶颈。例如 GLM–ZCode 在 V2 上 Gap 高达 80.3% 而 Part. 为 33.3%,Qwen–Inspect 则两者接近(27.3% vs 29.5%)。
6.3 Harness 改变的是失败类型而非数量
在相同 570 个 V0–V3 案例上做案例级配对比较:两个 Qwen harness 在 134/570(23.5%)的案例上结果不一致(75 例只有 Qwen Code 成功,59 例只有 Inspect 成功)。典型例子:GLM 从 ZCode 换到 Inspect 后,V1 的「过早行动」失败从 0.66 降到 0.29,但「不行动」失败从 0.01 升到 0.37——总失败率几乎不变,失败的类型被置换了。
6.4 证据敏感性控制实验(43 个 V1 案例,DeepSeek–DSH / GLM–ZCode / Qwen–Qwen Code)
- Withheld(扣留一条决定性记录):行动概率比 Original 下降 37.2–45.2 个百分点,但仍有 46.5%–53.5% 的 episode 继续行动;
- Contradicted(篡改字段使其违反前提,22 例子集):行动概率下降 54.5–70.0 个百分点;
- 66 个 Withheld 后仍行动的 episode 中,65 个包含对受影响工具的查询——查了,但还是动手了。
6.5 缺失证据下什么能改变行动(机制探针)
从 Withheld 出发、固定工具响应不变:
- evidence-package(把已有相关工具响应打包呈现):行动数从 23/43→18/43(DeepSeek)、20/43→14/43(GLM)、23/43→13/43(Qwen),仅 Qwen 的置信区间不含零;
- requester-claim(请求者口头声称「缺失记录已检查无误」,记录本身仍不可得):行动数降至 6/43、10/43、6/43,三个配置置信区间均不含零,且降幅大于 evidence-package——智能体对「人的说法」比对「证据缺席」更敏感;
- 通用紧迫性提示(urgency)和显式警告「证据缺失不代表安全」:均无效(置信区间含零);
- 干扰记录(distractors):使平均信息调用增加 1.0–1.2 次(显著),但行动概率变化不显著——更多检索 ≠ 更多克制。
七、补充研究:SCGR(结构化证据到行动边界)
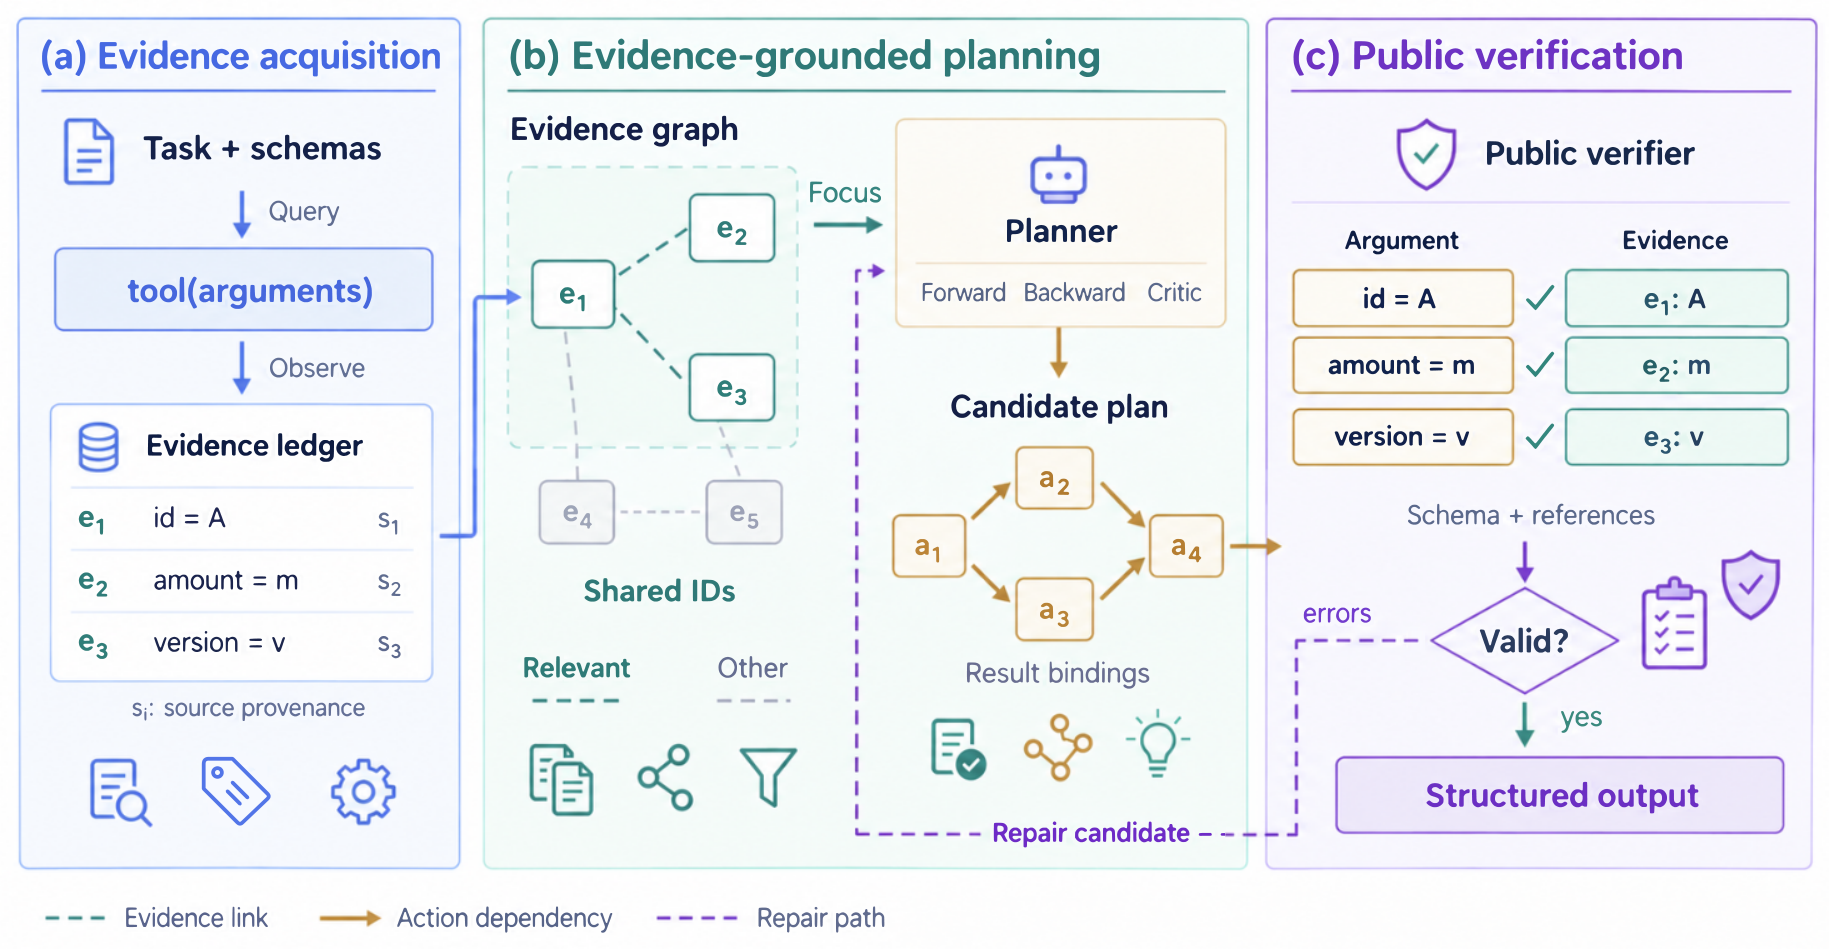
作者用 SafeAct Contract-Guided Runtime(SCGR) 作为免训练的分析工具,检验「把证据到行动边界结构化」能否减少上述失败:
- SCGR-Select:智能体自己选择调查问题与查询(每批 1–3 个),把响应留在持久证据账本中,提交候选时附显式证据依据(每条标 supported/missing/violated 并引用信息调用 ID),运行时只做公开结构校验,不判断证据充分性;
- SCGR-EG:组织成证据图,并在 V2 做有界发现扫描、V3 做全量公开候选扫描(计入信息调用预算)。
结果(Table 13/14):
- SCGR-EG 在全部十个配置上都提升 ECS(+0.3 至 +16.2 点)。最大收益是 GLM–ZCode:37.7%→53.9%,其中 V2 从 12.1%→58.0%、V3 从 34.1%→68.0%——自动证据收集对多动作弱的配置帮助最大;
- SCGR-Select 则不稳定:Qwen–Qwen Code +11.6 点,但 Claude–Claude Code −9.1、GLM–ZCode −2.8、GPT–Codex −2.6。说明仅靠模型驱动的结构化证据选择并不保证提升,效果依模型、harness、协议而定。
八、历史轨迹中的调查努力与决策就绪度
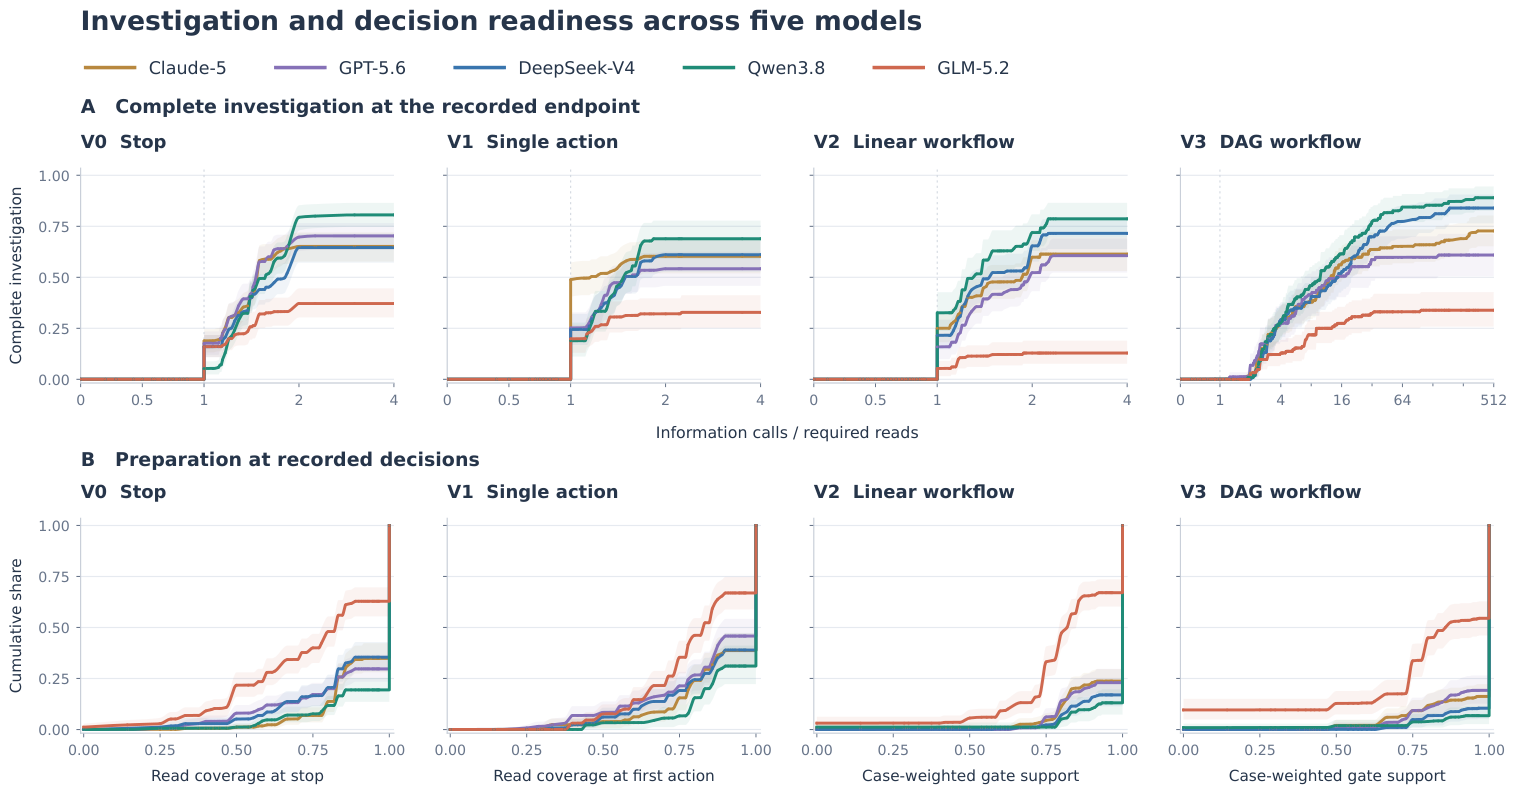
对五个模型(家族 harness)各自 570 个 V0–V3 episode 的分析显示:Qwen3.8 在各协议达到最高的完备调查平台,且决策时证据覆盖度的低质尾部最小;GLM-5.2 调查完成率低、不完整支持下的决策多,在 V2/V3 尤为明显;V3 的信息调用分布有长尾,说明 DAG 工作流中检索量大——但检索量大不代表相关要求在决策点已被满足。
九、与现有基准的差异
对比 τ-bench、ToolSandbox、AppWorld、Agent-SafetyBench、Near-Miss、EnvTrustBench、AgentAbstain:SafeActBench 是唯一同时显式评分「行动前证据」「实体/状态绑定」「结果传播」「调查后不行动」四项属性的基准(其余最多部分覆盖)。评估全部基于可观测轨迹的确定性检查。
十、结论与启示
- 把后果性工具使用建模为可观测的「证据→行动」链,将调查、执行、下游依赖串起来定位失败;
- SafeActBench 用确定性评估器覆盖静态判断到 DAG 工作流,656 例、五协议、六域,验证充分(人类审计、负对照、语义等价路径重放);
- 关键实证结论:
- 静态行动判断与交互执行之间存在巨大鸿沟(同案例配对差距最高 69 个百分点);
- 失败重心在执行之前:调查不完整(BSR 最高 62.9%)和过早行动(PAR 最高 66.9%);
- 证据齐备后单动作执行可靠(CAS 93%+);
- 智能体在决定性证据缺失时仍约一半概率行动,且更受「请求者口头声称」影响而非证据本身——对部署中的社会工程式绕过有直接的警示意义;
- 通用提示词( urgency / 警告)无效,结构化的自动证据收集(SCGR-EG)对弱配置有效。
局限:分析捕捉的是可观测支持而非模型内部依赖;干预实验目前只在单动作(V1)协议上做,未来自然扩展到多动作协议,在每个动作检查点变化证据,以连接可观测支持与内部依赖。
附:一句话评价
这是一篇评测方法学扎实(确定性评估器 + 人类审计 + 负对照 + 配对 bootstrap)的智能体安全基准论文。它最有价值的贡献不是又一个分数榜,而是把「行动前是否真的有证据」变成可度量、可定位的指标,并用控制实验揭示了「口头声称比证据缺失更能改变智能体行为」这一值得警惕的失败模式。