SSR:小模型搜索智能体不用"想"了,从 6 句话里挑一句就行
📌 核心摘要
跑多模态搜索智能体的人大概都观察过一个尴尬现象:2B、4B 的小模型每一步动作前都要生成一大段 freeform 推理,洋洋洒洒一百多个 token,仔细看内容却车轱辘话居多——对动作选择的指导有限,推理延迟倒是实打实地堆上去了。Apple 和 CMU 的这篇 SSR(arXiv:2610.01892)给了一个很干脆的回答:别生成了,直接选。他们把搜索智能体反复用到的高层推理归纳成 6 条预先写好的自然语言候选,每一步让模型用 teacher-forced prefill 并行给候选打分、按似然挑一条,整个推理过程一个新 token 都不用解码。结果是 4B 模型平均成功率 61.37%,追平同规模 SOTA 的 61.25%,同时每轮推理延迟砍掉 90% 以上,整题模型推理延迟降 28%–54%。这不是底层推理能力的突破,但它精准踩中了"小模型推理是负担不是资产"这个真痛点,工程价值很实在。
📖 论文信息
- 标题:Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
- 作者:Feiyu Gavin Zhu(Project Lead)、Xiaoyu Zhu、Jiqi Yang、Rui Yang、Arnab Kumar Mondal、Yancheng Wang、Xinke Deng、Jean Oh、Reid Simmons、Joerg Liebelt、Xiang Kong、Zhongyu Jiang
- 机构:Apple、Carnegie Mellon University
- 链接:https://arxiv.org/abs/2610.01892 (2026 年 10 月 1 日提交,v2 于 10 月 8 日更新)
- 项目页:https://zfy0314.github.io/ssr-webpage/
🎯 问题动机:小模型的"思考"经常是在空转
标准的 ReAct 式智能体大家都熟:观察 → 推理 → 动作,循环往复。推理这一步的初衷是好的——让模型盘一盘手上的证据,再决定下一步干嘛。但落到 2B/4B 这种小模型身上,事情就变味了。
我之前调小模型 agent 的时候就有这个体感:模型每一步都"看起来很努力"地写一大段思考,但把轨迹拉出来看,十段思考里有八段是同义反复,真正起决策作用的可能就一句话。这些 token 全是自回归一个一个解码出来的,每一步动作前都要串行等它写完。延迟就这么堆起来了。
现有的解法——prompt 里要求简洁、或者用 RL 奖励短推理——都只是让文本变短,没有动自回归解码这个串行依赖本身。SSR 换了个正交的方向:不改长度,改表示。
作者的观察其实挺朴素的:多模态搜索任务里,问题千变万化,但"下一步该怎么走"的高层推理模式是反复复用的。找"某 AI 会议在哪开"和找"乐高是哪年成立的",实体和问题完全不同,推理骨架却是同一条——"实体已知但所问信息缺失,那就搜实体名加目标属性"。既然推理空间根本撑不满整个自然语言空间,那为什么还要每次都从零生成?
这个观察跟之前 thought templates、reasoning memory 那批工作一脉相承,但 SSR 把它推到了一个更激进的位置:推理干脆不做生成,只做选择。
🧠 方法核心:把推理从解码问题变成打分问题
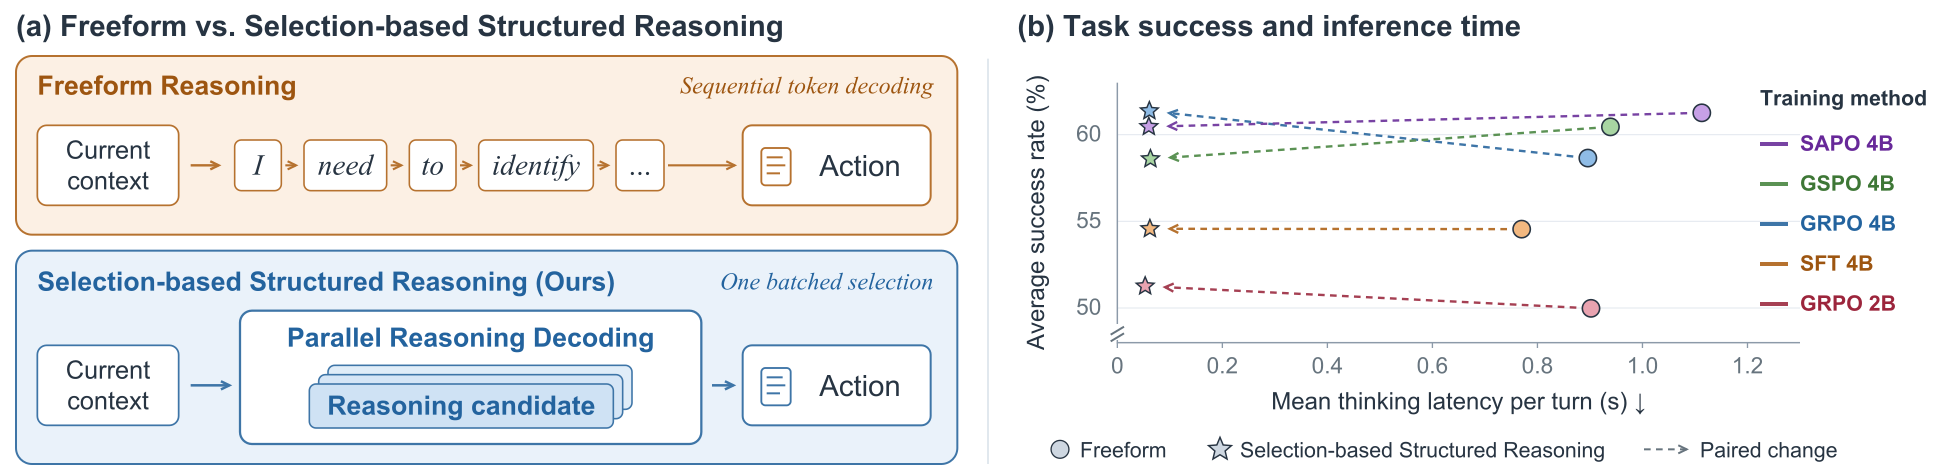
Figure 1:(a)Freeform 推理逐 token 串行解码后才能出动作;SSR 用一次批量选择替代。(b)四种训练目标、两种模型尺寸下,SSR(星号)在成功率基本持平甚至更高的同时,把每轮平均推理延迟压到 0.1 秒以内——freeform(圆点)都在 0.8–1.1 秒区间。
一句话讲清核心 idea
维护一个推理候选库 \(\mathcal{R}=\{r_1,\ldots,r_N\}\),里面是几条写好的自然语言推理模板。每一步,模型不生成推理,而是给每条候选在当前上下文下的似然打分,softmax 之后采样一条,把这条文本塞进上下文,然后照常自回归生成动作。
美妙的地方在于分工:候选文本负责"往哪走"的可复用策略,动作生成负责"具体怎么走"的实例化细节(搜索 query 写什么、裁剪框画在哪)。可复用和实例特定被 cleanly 拆开了。
打分机制:语言模型自己就是分类器
对候选 \(r_i\)(含 \(K_i\) 个 token),打分函数是长度归一化的对数似然:
其中 \(\alpha \in [0,1]\) 控制长度归一化。作者用 \(\alpha=1\),也就是按平均 token 对数似然比较候选——不归一化的话,负对数概率求和会系统性偏向最短候选。打分再过个带温度 \(\tau\) 的 softmax,得到候选上的分类分布 \(q_\theta(\cdot \mid h_t)\),采样即选择。
注意这里没有任何额外的分类头,也不需要 SFT 预热——打分和动作生成用的是同一套模型参数、同一个 system prompt。模型理解上下文语义的能力被直接拿来匹配最合适的推理,这个设计挺干净的。
延迟为什么能砍掉九成:并行打分
关键在候选文本是预先写死的。这就解锁了两层并行:
- Token 级:候选的每个前缀都是已知的,teacher-forced prefill 一次批量前向就能算出候选内所有 token 的 log-prob,不用一个个解码;
- 候选级:所有候选共享历史 \(h_t\) 的同一份 KV cache,\(N\) 条候选的打分可以并发计算。
整个"推理"阶段,模型一个新 token 都没生成。作者还给了个计算深度的对比:设历史长度 \(H\)、候选数 \(N\)、最长候选 \(K_{\max}\)、freeform 推理长度 \(L\),则
freeform 的串行深度里有个躲不掉的因子 \(L\),SSR 直接把它消掉了。当然这是并行深度的理论刻画,实际延迟收益还得看实现——但从后面 90% 的实测降幅看,理论没吹牛。

Figure 2:一个真实案例的对比。左下 freeform 推理写了 156 个 token、耗时 1822 ms,还把爱丁堡的 Old College 错认成苏格兰国家博物馆,搜错了地方;SSR 选中"Identify by image"这条候选只用了 31 个 token、33 ms,直接触发以图搜图找到了正确答案。右侧是并行推理解码的细节:共享历史 KV cache,候选内 token 级并行 prefill,候选间并发打分,一次批量前向完成全部选择。
这个案例值得多说一句。freeform 那条轨迹生动展示了小模型推理的真实风险——它不仅慢,还可能是错的:模型自信满满地编了一个错误实体,然后基于错误实体去搜索。SSR 的候选"我不能仅凭外观确认图中实体,应该先用图片本身搜索识别"恰好是治这个病的。推理被约束在一个小而正确的空间里,某种意义上也是防 hallucination。
训练:SFT 和 RL 都能直接套
SFT 侧,损失就是分类选择损失加 token 级动作损失的加权和,权重 \(\lambda^{\text{SFT}}_{\text{reason}}\):
RL 侧更有意思。GRPO 的改动其实很小:freeform GRPO 里推理部分的 token 级重要性比率,换成一个分类比率就行:
选中的候选文本被 harness 整块插入上下文,对梯度的贡献就收敛到这一个分类项上。动作 token 照旧走 token 级比率,进标准的 clipped surrogate。同一套选择+动作结构也能套 GSPO、SAPO,附录 B 给了变体目标和一个 selector-gradient 近似(多次梯度更新时复用 rollout 会引入近似误差,这个后面实验里会回来咬人一口)。
还有个容易被忽略但很实用的点:很多 RL 训练 agent 的工作需要先 SFT 预热让模型学会某种推理格式,SSR 不需要——因为选择机制天然把推理约束在库内,RL 可以裸跑。省一整个训练阶段。
📊 实验:性能不掉,延迟砍掉一半以上
实验设置先交代清楚:基座是 Qwen3-VL 的 2B 和 4B;训练数据用 VisualProbe、DeepEyes、FVQA-train;评测覆盖七个多模态搜索基准——MMSearch、HR-MMSearch、FVQA-test、InfoSeek、SimpleVQA、LiveVQA、MAT-Search;工具 harness 含以图搜图、文本搜索、图像裁剪;延迟 profiling 在 H100 上用 SGLang 跑,每个基准采 100 题。推理库是 6 条人工写的候选,跨基准共享。
主实验:4B 追平同规模 SOTA
Table 1(成功率 %,节选关键行):
| 模型 | 尺寸 | MMSearch | HR-MMSearch | FVQA-test | SimpleVQA | LiveVQA | MAT-Search | InfoSeek | AVG |
|---|---|---|---|---|---|---|---|---|---|
| Gemini-3-Flash(zero-shot) | – | 62.57 | 41.64 | 64.89 | 67.92 | 48.06 | 82.67 | 61.10 | 61.26 |
| Qwen3-VL-8B-Instruct(zero-shot) | 8B | 47.37 | 27.87 | 53.61 | 62.29 | 39.37 | 82.67 | 46.15 | 51.33 |
| MMSearch-R1 | 7B | 53.80 | 20.33 | 58.40 | 57.40 | 48.40 | 74.00 | 55.10 | 52.49 |
| TAPO + GSPO | 4B | 60.82 | 31.48 | 66.61 | 70.98 | 56.14 | 83.33 | 59.40 | 61.25 |
| SSR(ours) | 4B | 61.40 | 30.16 | 70.22 | 71.08 | 57.19 | 78.67 | 60.90 | 61.37 |
| SSR(ours) | 2B | 51.18 | 17.06 | 61.16 | 61.83 | 51.54 | 62.59 | 53.44 | 51.26 |
4B SSR 平均 61.37%,比同规模最强的 TAPO+GSPO 的 61.25% 略高。2B SSR 的 51.26% 已经能摸到 zero-shot 8B Qwen3-VL 的水平。
但得泼点冷水:跟闭源大模型比,差距还是明显的——Gemini-3-Pro 69.06%,GPT-5.2 67.64%。SSR 解决的是"小模型推理开销"问题,不是"小模型能力上限"问题。另外 HR-MMSearch 这个高分辨率图像基准上,SSR 的 30.16% 明显弱于 TAPO+GSPO 的 31.48% 和 Gemini-3-Flash 的 41.64%,高分辨率细节理解这种硬功夫,靠选推理模板补不回来。
配对对比:SSR vs freeform,四种训练目标全覆盖
Table 2(核心表,4B/2B,配对比较):
| 训练目标 | 尺寸 | 成功率 ↑ | 每轮推理延迟 ↓ | 每题模型延迟 ↓ | 有效推理吞吐 ↑ |
|---|---|---|---|---|---|
| GRPO-freeform | 4B | 58.65 | 0.896 s | 5.456 s | 72.7 toks/s |
| GRPO-SSR | 4B | 61.37(+4.6%) | 0.061 s(降 93.2%) | 2.514 s(降 53.9%) | 3029.9 toks/s |
| GSPO-freeform | 4B | 60.45 | 0.939 s | 5.195 s | 71.9 toks/s |
| GSPO-SSR | 4B | 58.60(-3.1%) | 0.063 s(降 93.3%) | 3.706 s(降 28.7%) | 2526.2 toks/s |
| SAPO-freeform | 4B | 61.26 | 1.113 s | 6.145 s | 69.4 toks/s |
| SAPO-SSR | 4B | 60.46(-1.3%) | 0.060 s(降 94.6%) | 2.862 s(降 53.4%) | 3215.3 toks/s |
| SFT-freeform | 4B | 54.55 | 0.770 s | 5.308 s | 70.9 toks/s |
| SFT-SSR | 4B | 54.57(+0.0%) | 0.062 s(降 91.9%) | 3.318 s(降 37.5%) | 2567.0 toks/s |
| GRPO-freeform | 2B | 49.98 | 0.902 s | 4.153 s | 87.2 toks/s |
| GRPO-SSR | 2B | 51.26(+2.6%) | 0.053 s(降 94.1%) | 2.125 s(降 48.8%) | 3302.6 toks/s |
这张表是全文最值钱的东西。几个观察:
延迟收益非常稳。不管哪种训练目标、哪个尺寸,每轮推理延迟从 0.77–1.11 秒砍到 0.05–0.06 秒,全是 90% 以上的降幅。有效推理吞吐从 70 左右的 toks/s 跳到 2500–3300 toks/s——40 倍往上,基本上就是 prefill 的 token 处理速度了。
性能侧有分化。GRPO 下 SSR 反而涨了(4B 涨 4.6%,2B 涨 2.6%),SFT 持平,但 GSPO 和 SAPO 下分别掉了 3.1% 和 1.3%。作者自己承认这可能来自附录 B.3 的 selector-gradient 近似——每次 rollout 做多次梯度更新时近似会变不准。这个坦诚挺好,但也提醒我们:SSR 和训练算法之间不是完全解耦的,搭配某些 RL 变体时有真实损耗。
跟其他高效推理方法比:快 7 倍,成功率还最高
作者把四类高效推理 baseline 在同一套 GRPO-freeform pipeline 上复现对比:Chain-of-Draft、Sketch-of-Thought(prompt 压缩派)、efficiency-reward RL(学短推理派)、Probe & Prefill(轻量分类头决定要不要推理)。
Table 3(profiling 子集):
| 方法 | 子集成功率 ↑ | 推理延迟/轮 mean | 推理延迟/轮 p95 | 模型延迟/题 mean | 有效推理吞吐 ↑ |
|---|---|---|---|---|---|
| MMSearch-R1-4B | 51.59 | 1.235 s | 1.892 s | 5.601 s | 73.8 |
| Chain-of-Draft | 54.06 | 0.416 s | 0.798 s | 3.657 s | 69.9 |
| Sketch-of-Thought | 56.07 | 0.543 s | 1.054 s | 3.487 s | 71.7 |
| Efficiency-reward RL | 56.28 | 0.756 s | 1.273 s | 4.638 s | 68.9 |
| Probe & Prefill | 55.49 | 0.890 s | 1.564 s | 5.219 s | 65.8 |
| SSR | 58.36 | 0.061 s | 0.071 s | 2.514 s | 3029.9 |
SSR 成功率最高,推理延迟比所有 baseline 快约 7 倍以上。更让我注意的是 p95:SSR 的 p95 是 0.071 秒,只比均值高 10 ms,而 baseline 的 p95 在 0.8–1.9 秒。这个 mean-p95 差极小的性质其实很关键——选择式推理的计算量是固定可预测的(永远是给 6 条候选打分),freeform 生成的长度不可控,长尾延迟自然大。对要做线上服务的 agent 系统来说,延迟可预测性的价值不亚于均值本身。
不过要公平地指出:Table 3 的成功率是在 100 题/基准的 profiling 子集上测的,样本量不大,58.36 vs 56.28 这个差距的统计意义有限。延迟差距倒是实打实的数量级差异,不受影响。
消融 1:必须选全文,选索引会掉点
Table 4(推理方式消融,成功率 %):
| 推理方式 | MMSearch | HR-MMSearch | FVQA-test | SimpleVQA | LiveVQA | MAT-Search | InfoSeek | AVG |
|---|---|---|---|---|---|---|---|---|
| 并行解码-完整文本 | 61.40 | 30.16 | 70.22 | 71.08 | 57.19 | 78.67 | 60.90 | 61.37 |
| 并行解码-仅索引 | 60.82 | 22.30 | 67.56 | 69.99 | 55.56 | 77.33 | 59.30 | 58.98 |
| 自回归-带 SFT | 61.40 | 29.84 | 69.22 | 69.10 | 56.97 | 72.00 | 61.55 | 60.01 |
| 自回归-无 SFT | 60.23 | 33.11 | 67.28 | 68.41 | 54.67 | 79.33 | 58.60 | 60.23 |
两个信息。其一,"仅索引"变体(给候选编号 [1] [2] 打分而不是给全文打分)平均掉了 2.39 个点(相对降幅约 3.9%),七个基准全线下滑——说明打分过程真的在利用候选文本的语义,不是随便选。其二,自回归生成候选这条路:带 SFT 预热能逼近选择式(60.01 vs 61.37),但离了 SFT 就退化成 freeform——模型根本约束不住自己只从库里挑。选择机制本身就是最硬的格式约束,不需要训练去教会模型守规矩。
消融 2:库里放几条?
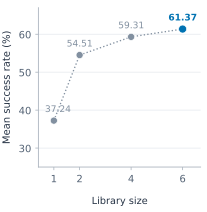
Figure 3:平均成功率随库大小单调上升——1 条通用候选 37.24%,2 条 54.51%,4 条 59.31%,6 条 61.37%。
从 1 条到 2 条的跳跃最惊人:涨 17.27 个点。1 条候选时库里只有一句"I am a helpful assistant"式的废话,2 条时变成"回答 or 调工具"的二选一。你想想看,哪怕只是让模型显式区分"现在该答了还是该再搜一步",收益就接近 17 个点——这说明在搜索 agent 里,什么时候停止检索、什么时候给出答案这个决策本身被严重低估了。4 条到 6 条的边际收益已经很小(59.31 → 61.37),推理粒度细化是有天花板的。
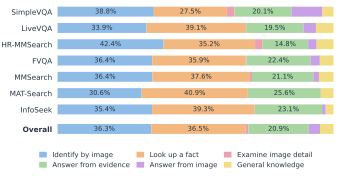
Figure 4:六种候选在不同基准上的被选比例。最简单的 SimpleVQA 最爱选"Answer from image"(38.8%),最少选"Look up a fact";以高分辨率图为中心的 HR-MMSearch 选"Examine image detail"的比例最高。同一个模型、同一个库,选择分布随任务特性自适应。
还有个 sanity check 数据我很喜欢:99.9% 的轮次里,生成的动作类型和所选候选的预期动作类型一致。选了"zoom into image"就真的会调裁剪工具,说明语义引导确实传导到了动作层,不是摆设。
附录里的一个彩蛋:freeform 推理可能根本没帮你
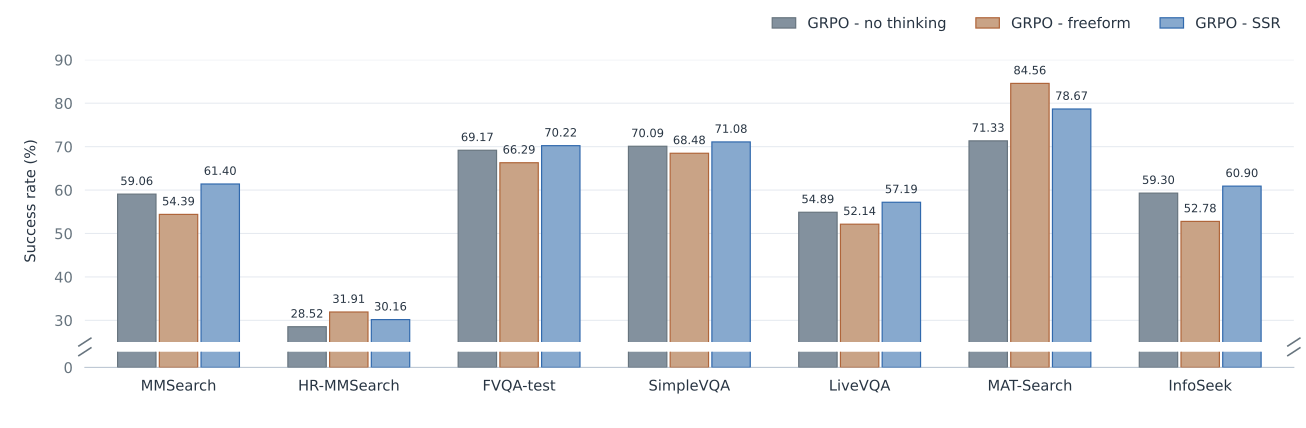
Figure 5:GRPO 训练的 Qwen3-VL-4B 在七个基准上,不思考(灰)、freeform 思考(橙)、SSR(蓝)三方对比。SSR 在 7/7 个基准上超过不思考;freeform 只在 2/7 个基准上超过不思考。
附录 G 这个对比我觉得是全文最尖锐的发现:freeform 推理的均值(58.65%)比完全不思考(58.91%)还低 0.26 个点。你花了 0.9 秒/轮的推理延迟,换来的收益是负的。SSR 比不思考高 2.47 个点,而且是 7 个基准全胜,优势幅度 0.99 到 7.34 个点不等。
这个结果对小模型 agent 的叙事冲击挺大的。"先想再做"不是免费的午餐,小模型的 freeform 思考经常只是昂贵的噪声。
🔬 批判性审视:几个值得追问的点
推理库是人工写的。 6 条候选全靠手工撰写,针对"多模态搜索"这个场景。论文把"库怎么来"的问题绕开了——换一个任务域(比如网页操作、代码调试),是不是还得重新手写一遍?候选写得好不好直接决定上限,这其实是把 prompt engineering 的成本从推理时挪到了设计时。作者引用 thought templates 那批工作暗示了自动归纳的可能性,但论文里没做。
6 条够不够,论文自己的数据已经给出暗示。 库大小消融显示 4 条到 6 条只涨 2 个点,边际递减明显。但这既可能是"6 条覆盖了搜索任务的大部分模式",也可能是"选择机制本身的表达力到头了"。区分这两种解释需要更细粒度的实验,比如把候选拆成 20 条看是否继续涨。
GSPO/SAPO 下的性能回退没有彻底解决。 作者归因于 selector-gradient 近似,但没有给出修复方案或验证实验。如果你的 RL 栈恰好是这两个算法,SSR 的净收益要打个问号。
效率口径的选择性。 每题模型延迟降 28–54% 听着不如"推理延迟降 90%"震撼,但这是诚实的口径——动作生成还是自回归的,工具执行时间也被排除在测量外(作者明说了理由,但真实部署里工具延迟往往才是大头)。另外所有 baseline 都在同一 pipeline 上复现,这点做得比很多论文规范。
💡 我的判断
这篇论文不是那种"刷新认知"的底层突破,但它是我近期看到的对"小模型 agent 推理开销"问题最干脆利落的回答。核心洞察一句话:搜索 agent 的推理空间远比自然语言空间小,把它组织成可复用的候选集,生成问题就变成了可并行的打分问题。
跟同期工作摆在一起看:Chain-of-Draft、Sketch-of-Thought 那批是在"生成范式内做减法",SSR 是直接换范式;HyperEyes 是在交互轮次粒度省成本,SSR 是在轮内推理粒度省成本——两者其实是互补的,叠加起来想象空间不小。
工程上几个可以直接拿走的点:teacher-forced 并行打分 + 共享 KV cache 这套推理实现,在任何"输出空间可以枚举"的场景都适用,不局限于搜索 agent;分类比率替代 token 级比率的 GRPO 改造很轻,值得在自己的 RL 栈里试试;还有那个"freeform 推理不如不思考"的发现,做小模型 agent 的都该回去测一测自己的思考链是不是真的在赚钱。
最大的遗憾是库的手工属性。如果下一步有人把"从历史轨迹里自动挖掘推理候选"做成闭环——跑一批轨迹、聚类归纳出候选、再训练选择策略——那这套东西就从"针对搜索任务的精巧设计"升级成"通用 agent 推理压缩框架"了。我猜这个方向很快会被人做掉。
对小模型、端侧 agent 场景来说,这类"把推理压进可枚举空间"的方法,很可能会成为标配。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我