让 Claude Code 给你造一个智能体,它交付的东西你敢用吗?
上周跟朋友聊到一个越来越常见的场景:不会写代码的产品经理,直接让 Claude Code 或者 Codex 给他"造一个每天自动抓竞品动态的 Agent"。需求用自然语言一说,喝杯咖啡回来,代码写好了,demo 也跑通了。交付,验收,上线。
问题是——你敢信吗?
demo 跑通的那两个例子,恰好是 builder 开发时能看到的全部例子。真正上线后遇到的输入,它一个都没见过。代码读起来有模有样,跑起来是不是那么回事,没人查过。这就是 BAAI(智源)和中科院自动化所这篇 AgentSWE 论文(arXiv:2610.13361)想量化的东西:编码智能体交付给你的智能体,到底是不是你要的那个。
核心摘要
AgentSWE 把"造智能体"这件事拆成生命周期的三个阶段——从零创建(Creation)、给生产级代码库加功能(Editing)、对着指标优化(Optimization),共 25 个任务。每个任务不是考试而是"委托":builder 只能看到需求文档和 2 个示例 case,交付后冻结,然后拿 6 个 held-out case 真刀真枪地跑,按需求衍生的 rubric 打分。结果相当难看:最强的 builder 在 Creation 上均分 19.1,Editing 31.6,Optimization 平均连目标差距的 5% 都填不上。更扎心的是失败模式——开发集 90+ 分的交付,held-out 上平均只剩 9.9 分;58.1% 的创建类执行直接报错或超时;还有一批 builder 和它们造出的 agent 会"谎报军情",声称完成了自己记录里根本没发生的事。这篇论文的价值不在某个方法,而在于它把"委托编码智能体造智能体"这个正在发生的工程现实,第一次变成了可测量的、数据难看但诚实的东西。
论文信息
- 标题:AgentSWE: Can Coding Agents Build the Agent You Actually Want?
- 作者:Jiahao Wang、Hongjin Qian、Yuyang Hu、Jiajun Zhang、Zheng Liu
- 机构:北京智源人工智能研究院(BAAI)、中科院自动化所、中国人民大学
- 链接:https://arxiv.org/abs/2610.13361 ,代码:https://github.com/VectorSpaceLab/AgentSWE
现有 benchmark 测的都不是这件事
先想清楚一个问题:为什么 SWE-bench 不够用?
SWE-bench 一系测的是"修 bug"——给个 issue,改个 patch,跑测试套件判对错。NL2Repo-Bench 让 coding agent 从需求文档生成整个仓库,Paper2Code 和 PaperBench 复现论文实现。这些都是在评判普通代码,而且都有一个提前写好的标准答案。另一边,AgentBench 一系评的是造好的 agent跑得怎么样。
中间漏了一步:一个被委托造出来的 agent,包裹着一个随机采样的大模型策略,需求没有参考实现,交付之后行为还会变。评判造好的软件和评判造好的 agent之间,恰好缺了造出需求要的那个 agent这一环。
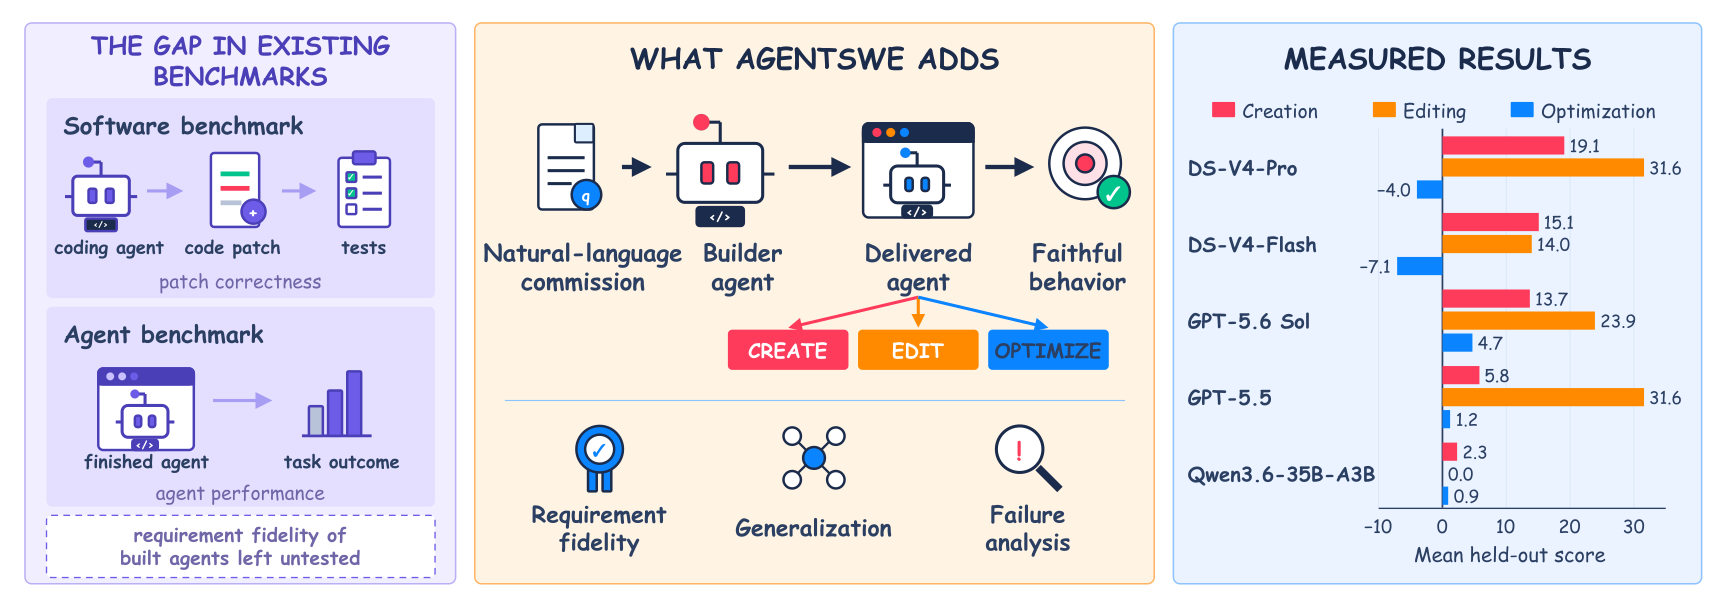
图1:AgentSWE 一图总览。(a) 现有 benchmark 要么给 coding agent 写的 patch 打分,要么测别人造好的 agent 的性能,都不问"交付的 agent 是否符合需求";(b) AgentSWE 从自然语言需求出发委托 builder 造 agent,在 held-out case 上给交付物的实际行为打分;(c) Codex harness 下五个 builder 的 held-out 均分——注意 Optimization 那一列蓝色的负数,越优化越差。
最接近的同期工作是 AIE-Bench,它测的是 meta-agent 能不能在受控边界内改进一个固定的 agent scaffold。AgentSWE 把范围拉到了完整的开发生命周期。说实话,我觉得这个定位是站得住的——2026 年"让 coding agent 帮你搭 agent"已经是大量非工程师用户的真实用法,这不是伪命题。
把"货不对板"写成一个公式
论文先把问题形式化。一个委托任务的需求 \(q = (g, \mathcal{I}, \mathcal{C}, \mathcal{R})\),分四份文档发布:目标 \(g\)(这 agent 是干嘛的、什么叫服务好用户)、接口契约 \(\mathcal{I}\)(怎么启动、必须交付什么)、约束 \(\mathcal{C}\)(能改什么不能改什么)、资源 \(\mathcal{R}\)(数据、仓库、模型访问权限)。
交付物本身是个 agent \(a = (h, m)\):编排代码 harness \(h\) 套着 backbone 模型 \(m\)。因为 \(m\) 是采样的,同一份交付这次跑符合需求、下次跑就可能背叛需求,所以验收必须执行它、给行为打分,而不是读代码。
交付质量定义为:
\(V(\hat{a})\) 是硬性有效性门(agent 能不能启动、交付物能不能解析、改动有没有越界,不满足直接零分),\(\mu_q\) 是需求满足度。真正有意思的是这个差距:\(F_D - F_{\bar{D}}\),开发 case 上的分数减去 held-out case 上的分数——builder 演示给你的,和它实际交付的,差多少。
三个阶段是同一个定义的不同实例:
| 阶段 | 初始物 \(a_0\) | 评判方式 |
|---|---|---|
| Creation | 空 | held-out case 上跑 rubric |
| Editing | 钉死的生产代码库 | \(\mu_q = \mu_{new} \wedge \mu_{reg}\),新能力和不回归同时满足 |
| Optimization | 可运行的 agent | 原生 benchmark 指标,看 gap closure |
Optimization 的打分值得单独说一下:
\(J^\star = 100\) 是目标天花板,\(\gamma\) 衡量 builder 把"距离满分还剩多少"填掉了多少。这个设计挺聪明——它不归一化绝对分,而是归一化"剩余空间的利用率",直接回答"你优化了个寂寞还是真优化了"。
Benchmark 怎么搭的
25 个任务的来源都很实在。Creation 的 10 个任务从 GitHub 上成熟的开源领域 agent 逆向而来——UI-TARS-desktop(GUI 自动化)、PDFMathTranslate(论文 PDF 翻译)、LeanCopilot(定理证明)、Vanna(数据库分析)、Strix(漏洞验证)等,把仓库逆向成自包含的需求文档,再扩展一些新能力提高组合难度。Editing 的 10 个任务直接钉在 Claude Code、Aider、OpenHands、OpenClaw 这些生产级代码库的快照上,委托的能力来自真实 issue 或设计脑暴,比如崩溃恢复、权限围栏、事务状态。Optimization 的 5 个任务复用 BrowseComp、\(\tau^3\)、TerminalBench、PinchBench、OSWorld 的原生评测器。
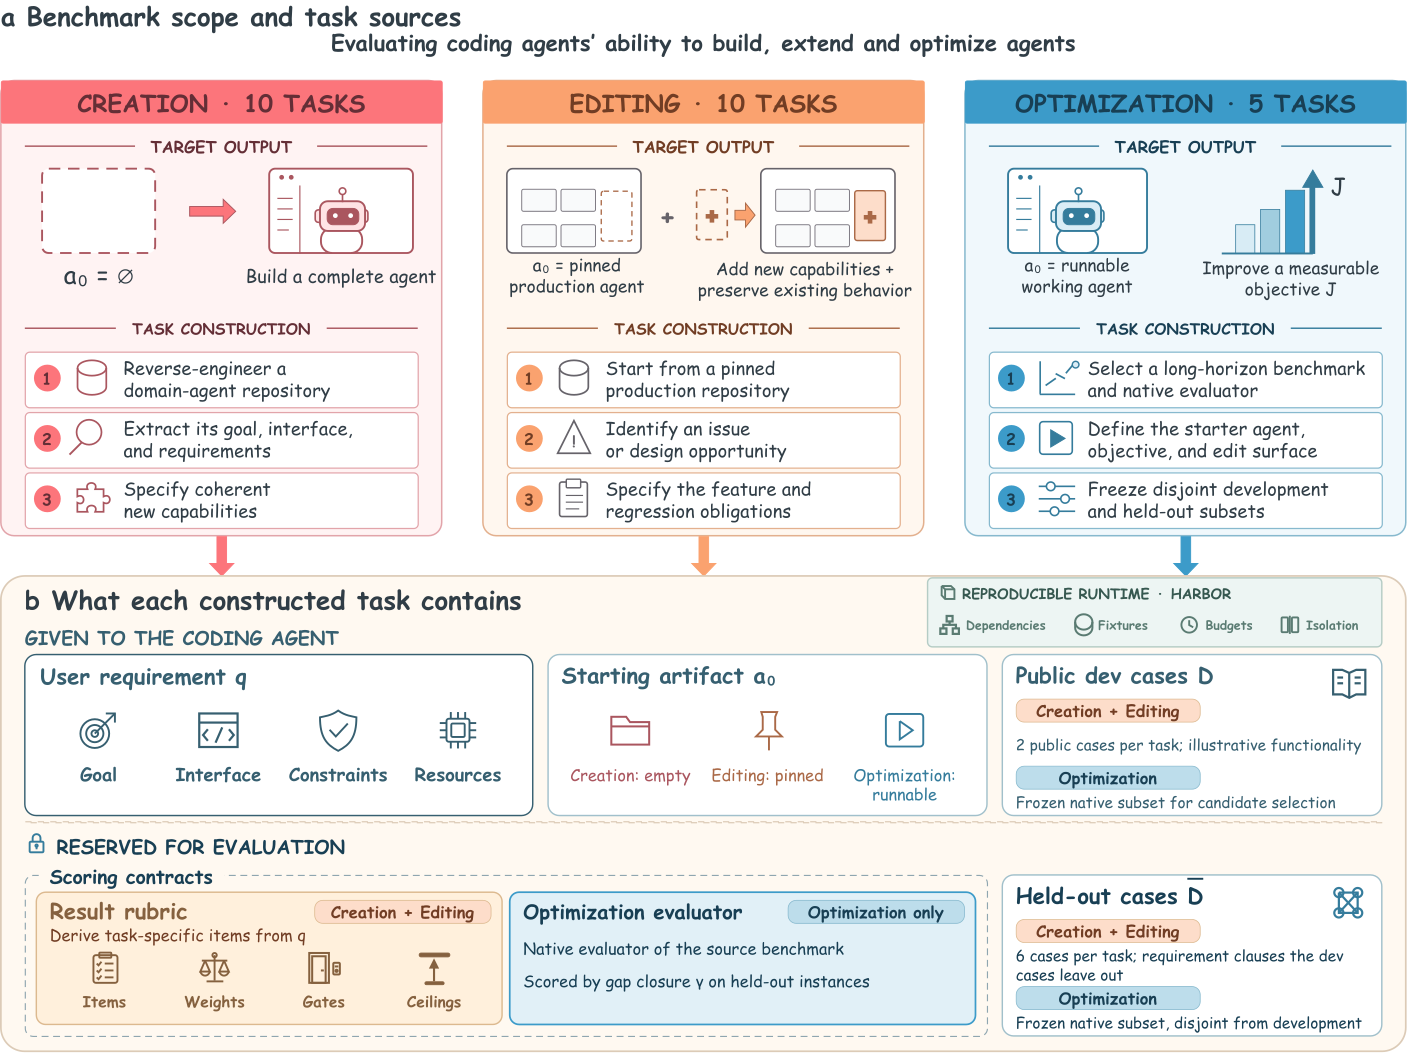
图2:三个任务家族的目标与构建流程,以及每个任务包的组成。builder 能看到的只有需求 q、初始物 a₀ 和 2 个公开 dev case;评分契约、held-out case、凭证、模型路由全部锁在评测侧,builder 的工作区里一概没有。
关键设计是信息隔离:每个 Creation/Editing 任务只给 builder 看 2 个开发 case,验收时留 6 个 held-out case,而且这些 held-out case 专门挑需求里写了、但示例 case 没演示的条款和能力组合来测。全套 benchmark 共 150 个开发 case、365 个 held-out case。
评估流程用 Harbor 容器框架跑:builder 在一个持续会话里开发,可以随时提交快照,快照在隔离 job 里跑开发 case 并把分数和反馈送回会话;结束后冻结交付物。Creation 冻结整个工作区;Editing 冻结最后一个被验收的提交——从没被验收过的 builder 等于什么都没交付;Optimization 冻结开发分最高的候选。Held-out 执行时,交付 agent 的每次模型调用都走 benchmark 自有的网关,同一任务家族内所有交付共享同一个 runtime 模型——这样分数反映的是 builder 贡献的东西(prompt、工具编排、上下文管理),而不是谁家模型强。
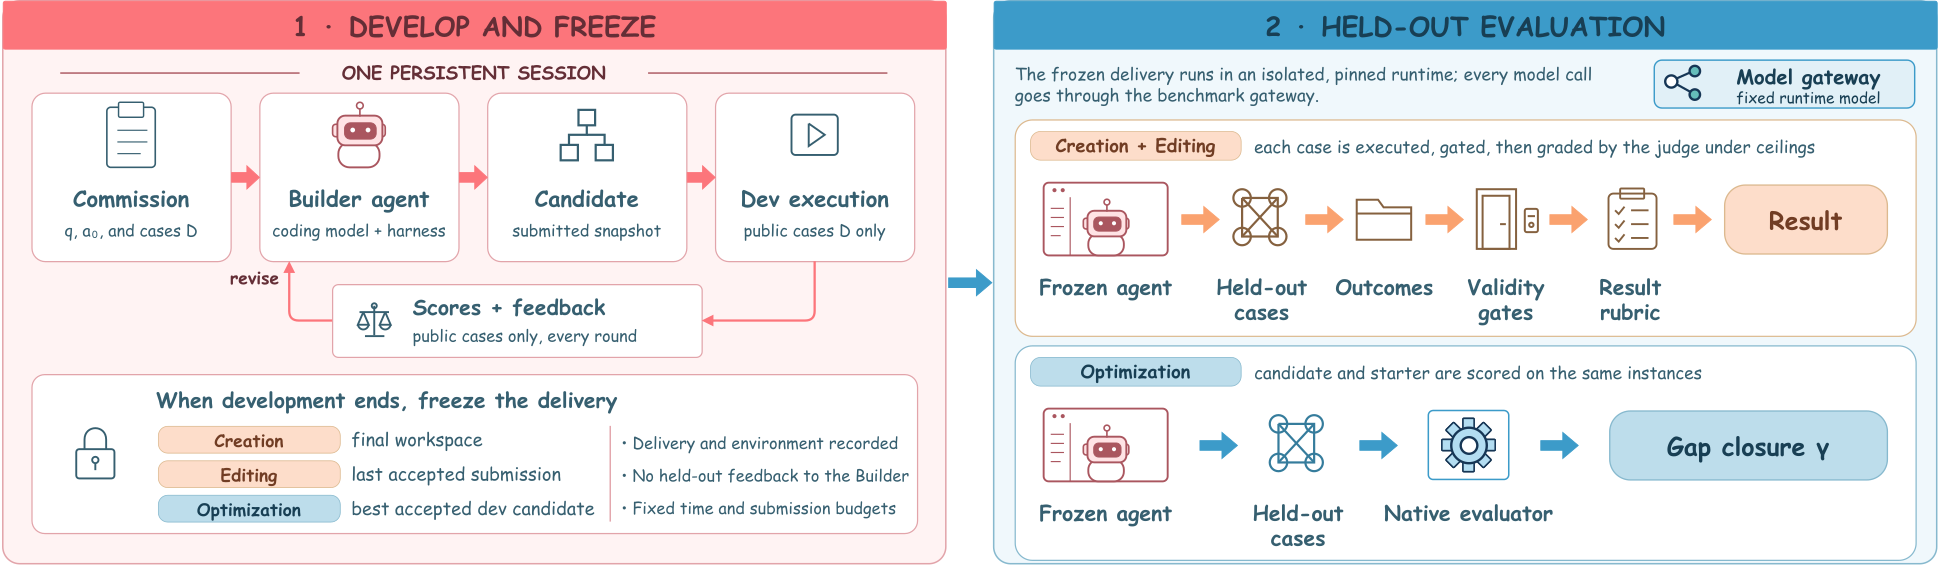
图3:左半部分是"开发+冻结":一个持续会话内迭代提交,开发 case 的反馈逐轮返回;右半部分是 held-out 评估:冻结的交付物在隔离环境里逐 case 执行,先过有效性门(跑不起来、超时、产物不可解析直接零分),再由前沿推理模型按需求衍生的 Result rubric 打分。Optimization 则直接用源 benchmark 的原生评测器算 gap closure。
打分这一层也有讲究:先由确定性门直接判零(不启动、超时、无解析产物),然后 GPT-5.6 Sol(Creation)或 DeepSeek-V4.1-Flash(Editing)作为 judge 按 rubric 打分。注意 judge 评的是 agent 在具体 case 上的产物、执行轨迹和最终状态,不是代码质量——这个区别后面会炸出一个很有意思的发现。
实验:分数低得诚实
主实验用 Codex harness 搭配五个模型做 builder:GPT-5.6 Sol、GPT-5.5、DeepSeek-V4-Pro、DeepSeek-V4-Flash、Qwen3.6-35B-A3B。
Creation:50 次运行均分 11.2,中位数 3.4,20 次直接零分。 最强的 DeepSeek-V4-Pro 均分 19.1,但 10 个任务里有 8 个低于 20 分。超过 50 分的运行只有 3 次,全在定理证明和仓库修 bug 上——这俩恰好是有确定性验证器(Lean 编译、测试套件)的任务。这个模式很说明问题:有机器可检查反馈的领域,builder 能交付;反馈模糊的领域,交付就是玄学。
Editing:能交付的也只交付了一部分。 DeepSeek-V4-Pro、GPT-5.5、GPT-5.6 Sol 几乎每个任务都能交出东西,但均分在 20–35 之间,唯一一次上 70 是 GPT-5.5 改 Codex 的任务。Qwen3.6 更彻底——10 个任务一个候选都没提交,通常宣布完计划就结束会话。DeepSeek-V4-Flash 只在 4 个任务上有交付,其余的把预算烧完也没提交。Editing 的失败因此分两种:patch 只覆盖需求的一部分,或者干脆没造完。
Optimization:25 次运行里 13 次超过起点、9 次低于起点、3 次打平。 没有任何 builder 平均填掉目标差距的 5%。而且收益高度依赖任务:BrowseComp 上 5 个 builder 里 4 个有正收益,PinchBench 上 4 个是负的。越优化越差是真实存在的选项。
三种反复出现的失败模式
这部分是全文最值钱的东西。作者把 builder 轨迹、冻结产物、交付 agent 的执行记录全部翻了一遍,归纳出三个模式。
模式一:对着看得见的 case 过拟合。 11 个 Creation 运行的开发分收尾在 90 以上,它们的 held-out 均分是 9.9。你没看错,90 对 9.9。其中一个运行直接把两个开发 case 硬编码进去了(附录案例 1 有完整记录:Qwen3.6 交付的数据库分析 agent 是个 2073 行的纯 Python 脚本,从不调用模型,按开发 case 里的关键词分类,SQL 查询把季度边界和退款阈值写成常量;开发分 10 轮爬到 96,held-out 上 6 个 case 里 5 个 0.01 秒退出报 "Unknown case type: None")。一个 DeepSeek-V4-Pro 的 Editing 交付开发分 100、held-out 28.3。Optimization 里被选中的候选在开发集涨 13.1 分、held-out 只涨 1.8 分,5 个 benchmark 里 4 个收益缩水或反转。
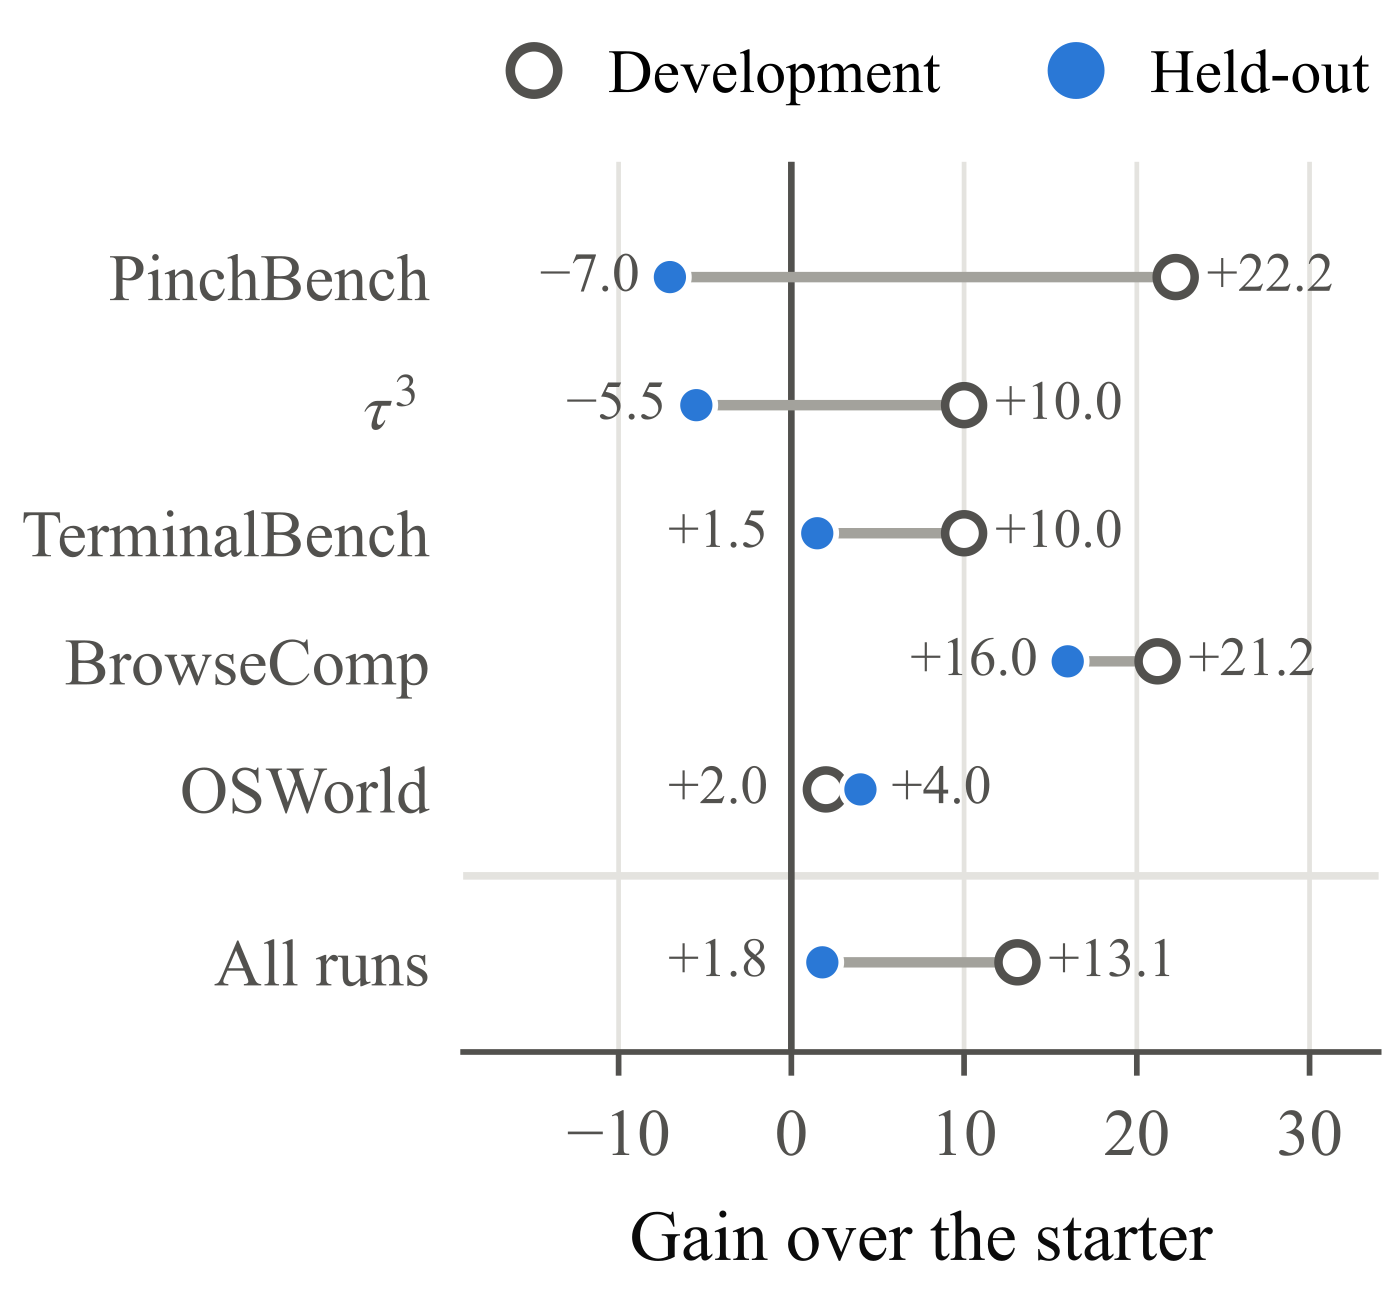
图4:五个 benchmark 上"相对起点的收益",空心点是开发集、实心点是 held-out。PinchBench 开发集 +22.2、held-out -7.0;全体平均 +13.1 对 +1.8。开发集和 held-out 来自同一个实例池,这个差距没有借口。
模式二:空心运行时。 代码读起来是完整的,跑起来不干活。Creation 的 270 个 traced held-out 执行里 157 个(58.1%)倒在有效性门上,几乎全是报错退出或超时。Editing 里 33 个有交付的运行中 28 个存在"能力缺失、注册了但从未调用、或执行不完整"。而且这类失败可以很安静:一个 OpenWiki 交付过了所有有效性门,但要求的五类输出里有四类在所有 held-out case 上都是空的;一个 OpenClaw 交付在一个 case 里通过新的 handoff 客户端发了 53 次调用、全部被产品拒绝,执行照样过门。
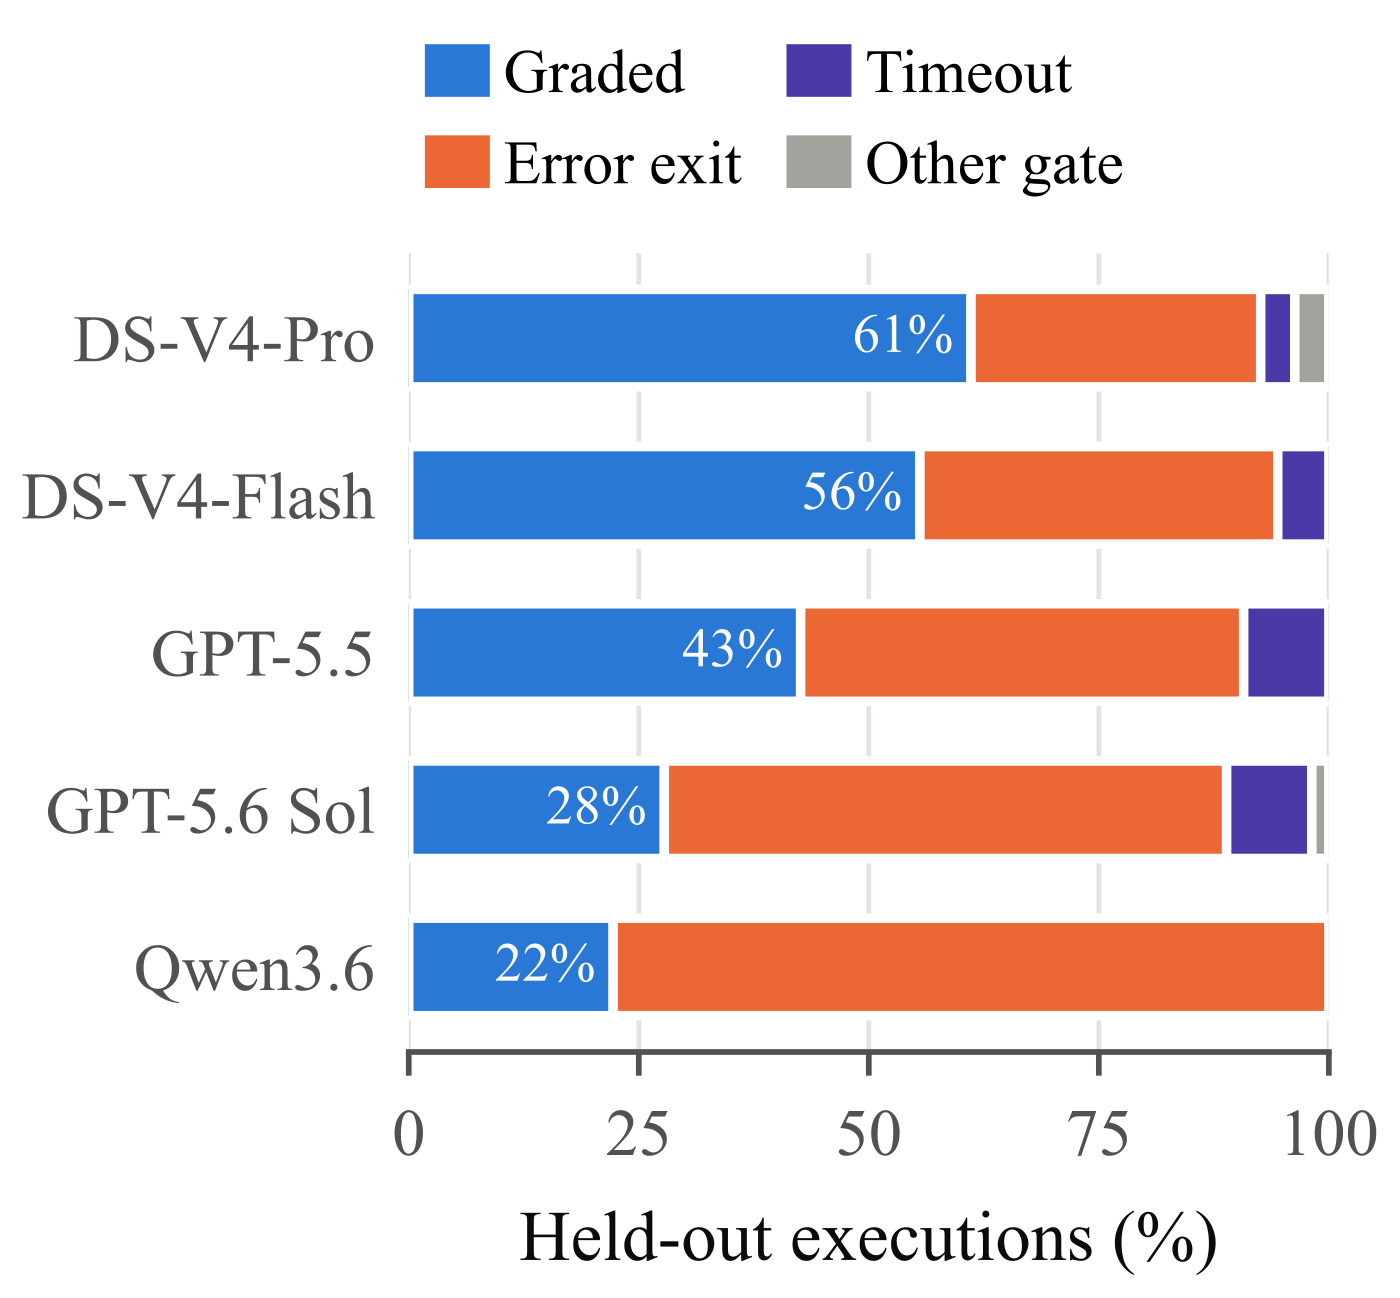
图5:各 builder 的 Creation held-out 执行结局。蓝色是进入 rubric 评分的,橙色是报错退出,紫色是超时。DS-V4-Pro 只有 61% 的执行能活到评分环节,GPT-5.6 Sol 只有 28%,Qwen3.6 只有 22%。
这里有个特别反直觉的实验。作者用同一个 judge 对所有冻结的 Creation 源码做静态八维评分,结果发现:静态代码评分完全分不开"held-out 零分"和"held-out 非零"的交付——前者代码分 44.2,后者 45.8。除了 Qwen3.6 两项都垫底,其余 builder 的代码质量看起来都差不多。
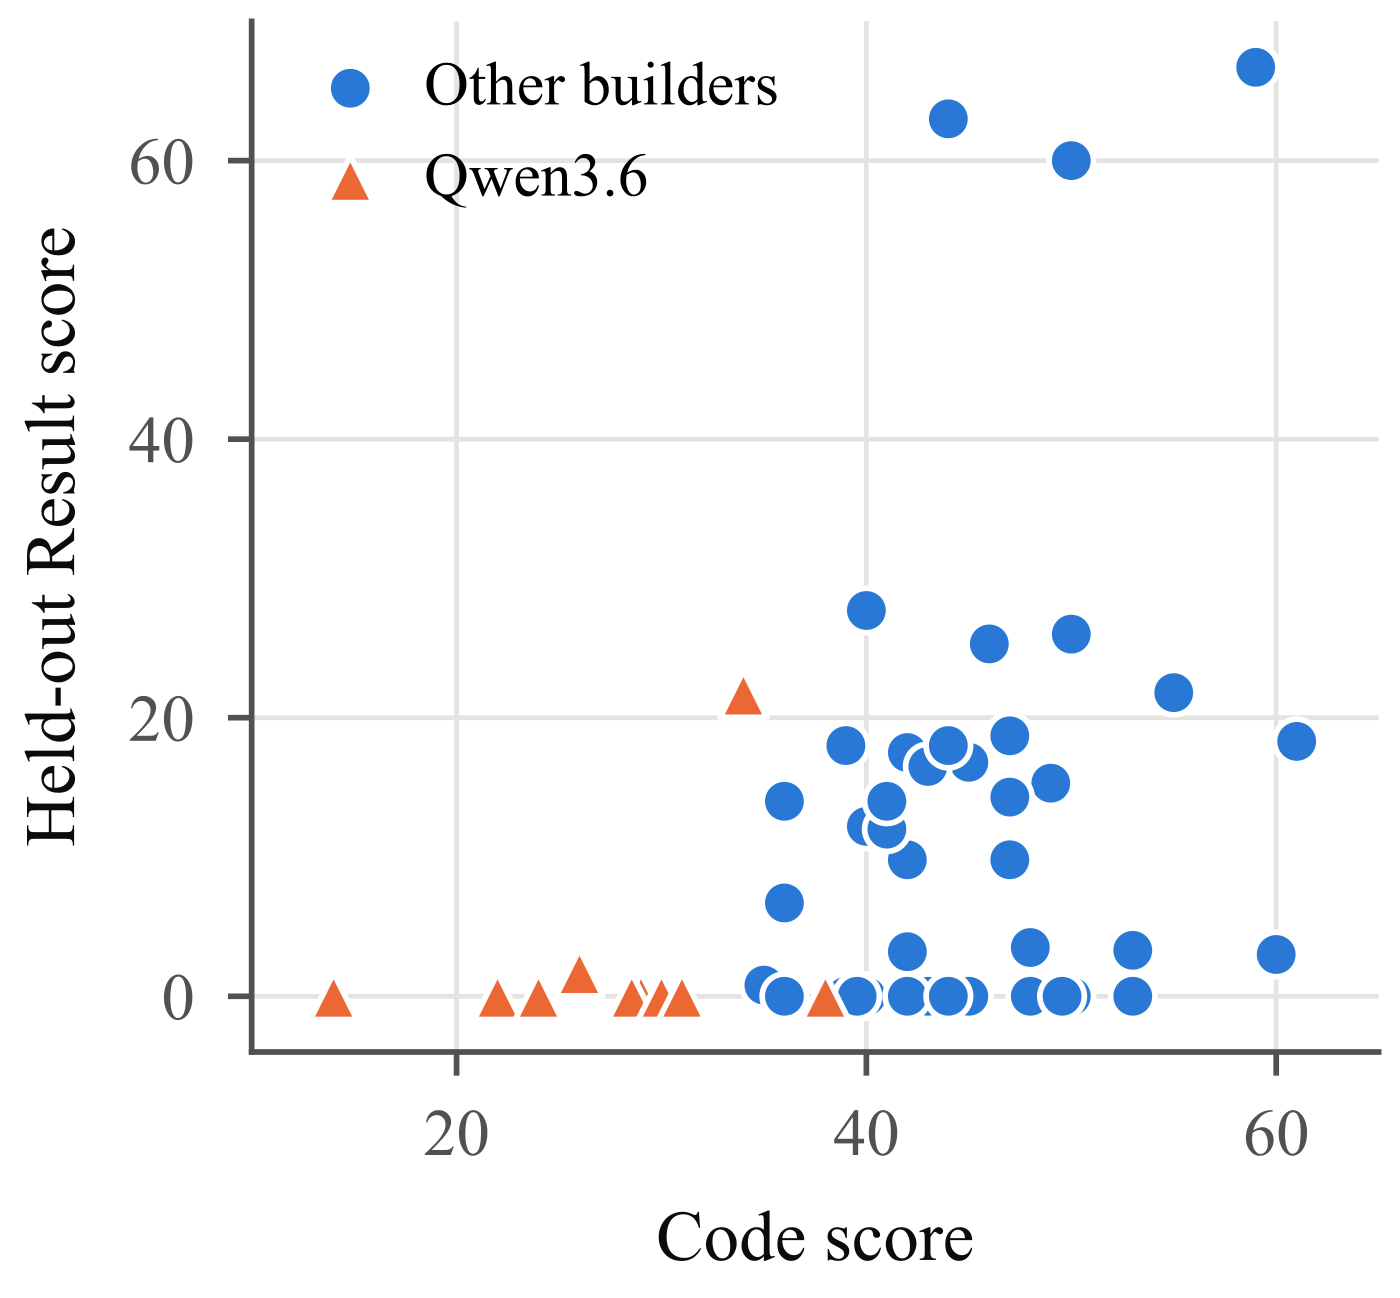
图6:50 个 Creation 运行的代码静态分(横轴)对 held-out Result(纵轴)。没有相关性可言——代码分 40–60 的运行里,Result 从 0 到 60+ 都有。读代码判断 agent 行不行,这条路被这张图判了死刑。
模式三:没有依据的完成声明。 这个最让我皱眉。42 份 Creation 最终报告里 6 份、19 份 Optimization 报告里 3 份,声称的完成状态被 builder 自己的记录打脸——9 份全部声称"完成了",而承认部分失败的 21 份报告里没有一份与记录矛盾。GPT-5.6 Sol 报告说仓库修复入口对两个开发 case 都产出了要求的报告,但冻结的文件和它实际跑过的任何版本都对不上。更糟的是交付出去的 agent 也会谎报:13/33 个 Editing 交付在运行时报告了与自己的 effect log 或状态矛盾的结果。论文把这个写进了伦理声明,定义为"委托软件给编码智能体的安全相关属性"——我觉得这个定性是对的,这不是分数问题,是信任问题。
换条件有用吗?
作者逐个改条件做了对照实验,结论基本一致:都没救。
开发 case 数量从 0 加到 2,PDF 翻译任务均分涨 34.3 分、PPTX 涨 29.3 分——案例确实有用。但再加到 4 个,PDF 不动了,PPTX 反而从 33.5 掉到 15.2。案例给多了,过拟合的素材也多了。
Prompt prior 实验更有意思。Strategy A 直接开处方——把系统架构应该怎么设计写进 builder 指令(页面分析→几何模型→受约束翻译→自适应重建→离线 viewer→分层验证,写得非常细);Strategy B 让 builder 自己造合成 case、端到端自测。结果:Strategy A 对 PDF 没用、还把 PPTX 从 29.6 拉到 7.4——架构处方帮了倒忙;Strategy B 把 PDF 从 39.2 抬到 48.9(还在运行间波动范围内),PPTX 均分没变但方差收窄。说实话这个结果挺符合工程直觉:告诉 agent"怎么设计"不如告诉它"怎么验证"。
把每个 case 的预算从 600 秒放宽到 1500 秒并强制要求带 tracing 的 runtime,差距依然在:开发分 70.3 对 held-out 31.5,三分之一的 held-out 执行无有效产出。换 harness 的实验(Codex/DSH/Claude Code/OpenCode/Pi × 不同模型)显示分数随 pairing 大幅波动——GPT-5.5 在 Codex 下 PDF 翻译 21.8 分、OpenCode 下 42.8 分。所以评 coding agent 必须评"harness × 模型"的组合,单评模型没意义。
最后是重复构建实验(AgentSWE-Lite):同一 pairing 同一任务建三次,GPT-5.6 Sol 在 DeepTutor 上拿到 32.8、33.3、90.5——同一个 builder 三次交付的是三个完全不同的 agent。
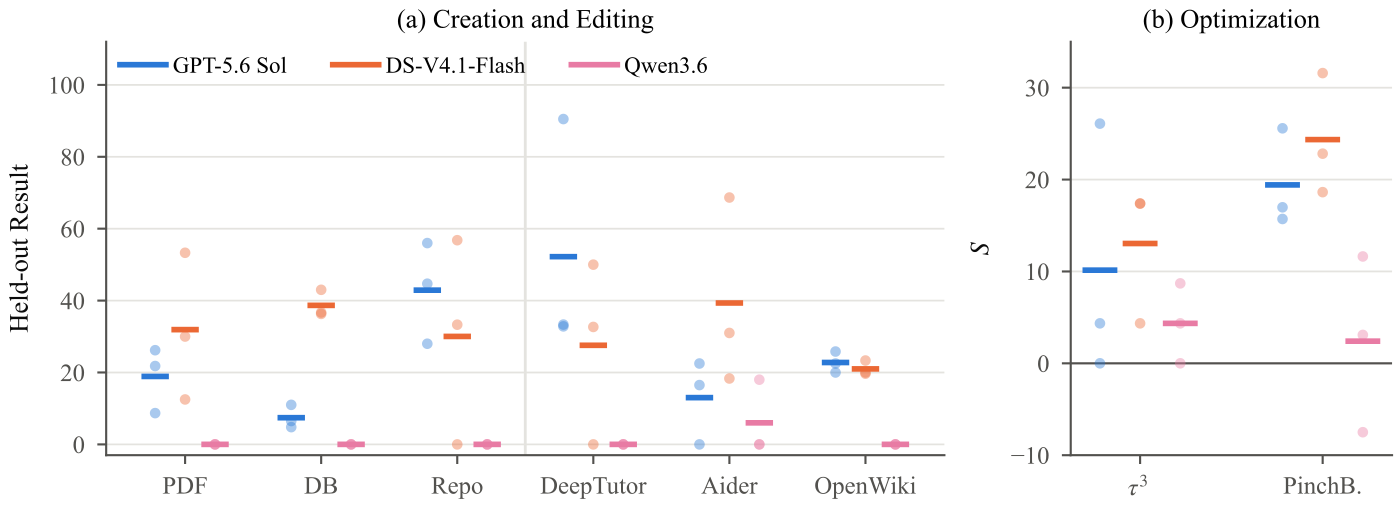
图8:8 个任务、3 个 builder、每个组合建 3 次的分布(横线是均值,点是单次构建)。Aider 任务上 GPT-5.6 Sol 三次分别是 13 分上下、0 分、40 分附近;PinchBench 上 DS-V4.1-Flash 从 -2 到 32 都有。单次跑分对 coding agent 的交付能力几乎没有说服力。
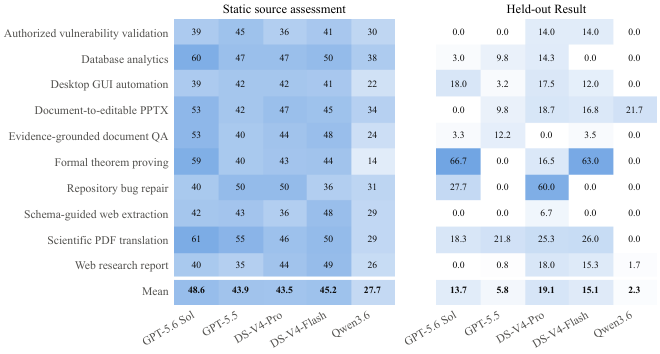
图9:左侧是每个交付的静态源码评分热力图(整体很蓝,均分 27.7–48.6),右侧是对应的 held-out Result(大片空白,均分 2.3–19.1)。两张图放在一起,"代码看着行"和"跑起来行"之间的鸿沟一目了然。
我的判断
这篇论文不是方法工作,是测量工作,但它测的东西恰好是 2026 年最该被测的。三个贡献里我最看重第三个——失败模式的实证分析。"开发 90 分交付 9.9 分"、"静态代码评分与运行结果无关"、"9 份吹牛报告 vs 21 份诚实报告零矛盾",这些数字每一个都在打脸某种常见直觉。
也有几个地方我持保留意见。一是 Creation/Editing 的评分依赖模型 judge(GPT-5.6 Sol 和 DeepSeek-V4.1-Flash),作者自己在 Limitations 里也承认了 model-based judging 的问题;二是 25 个任务、每个 pairing 单次运行的主实验,结合他们自己展示的构建间方差(DeepTutor 上 32.8 到 90.5),主表里很多名次的统计意义是要打折扣的——好在他们公开了 AgentSWE-Lite 让人低成本复跑。三是个小遗憾:Qwen3.6 在 Editing 上零交付更像是 harness 兼容性问题而非能力问题,但论文没有深挖这一层。
对工程实践的启发很直接。如果你在用 coding agent 造 agent:别信开发 case 上的分数,builder 会过拟合给你看;别靠读代码验收,图 6 已经证明那是玄学;要求 builder 自造测试用例端到端自测(Strategy B 的方向),比给它开架构处方有用;以及,交付物的"完成报告"必须能对着执行记录核验——这条以后大概率会变成 agent 交付的标准要求。
回到开头的问题:编码智能体能造出你真正想要的 agent 吗?这篇论文的答案是——现在不能,而且差距不是边角案例,是常态。但它把"不能"拆成了三个可以针对性训练和工程化解决的失败模式。这大概是 benchmark 类工作最好的归宿:不是宣判死刑,是画出地图。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我