梯度只存 1/64,27B 模型单机 8 卡就能 RL:LoGRA 把 RL 后训练的显存门槛砍掉了近一半
你有没有算过这笔账:一个 7B 的 Qwen 模型,BF16 权重只要 14 GB 左右,可一旦你要用 Adam 做 RL 后训练,光优化器的两个 FP32 动量缓冲就要再吃 56 GB。也就是说,你的卡明明跑得动这个模型做推理,却根本没法让它"学习"。
NVIDIA 这篇 LoGRA 论文(arXiv:2610.06647)就是冲着这个矛盾来的。说实话我一开始看到"低秩梯度压缩"这个方向是有点审美疲劳的——GaLore、Flora 之前都做过类似的事。但读完之后我改变了看法:这篇论文真正值钱的地方不是压缩本身,而是它把梯度压缩这件事完整地塞进了 RL 的"训练-采样"闭环里,连 rollout 侧的权重同步都一起省了,还配了一个 predicted-KL 步长控制器来兜底稳定性。
核心摘要
痛点:RL 后训练的显存开销远超推理——梯度加优化器状态轻松达到权重本身的好几倍,27B 模型在单机 8×H100 上用 Dense Adam 直接 OOM。
方案:不显式存储完整梯度,而是在反向传播过程中直接累积低秩梯度速写(sketch):用一个固定的随机投影矩阵 \(A\) 把 \(d\times k\) 的梯度压成 \(d\times r\) 的 \(S=GA^\top\),更新时再以 \(W\leftarrow W-\alpha\eta UA\) 的形式把低秩更新合并回全量权重。同一个压缩表示还顺手用于 rollout 策略同步,通信量从 \(O(dk)\) 降到 \(O(dr)\)。稳定性上,用 predicted-KL 控制在应用更新前预估策略偏移量,把每步的 KL 变化约束在预算内。
效果:7B 模型平均训练显存降 45.7%(31.82 → 17.29 GiB/GPU),精度不降反略升;27B 模型在单机 8 卡上稳定训练超过 1100 步,而 Dense Adam 连第一步优化器状态都分配不出来。
我的评价:这不是一个理论突破,而是一个非常扎实的工程整合——把梯度压缩、RL 闭环、trust-region 式的步长控制缝合成了一套可直接落地的配方。如果你手上卡不够但又想跑大模型 RL,这篇值得细读。
论文信息 - 标题:LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches - 作者:Shaokun Zhang, Yifan Zhang, Jian Hu, Yueying Li, Hao Zhang, Binfeng Xu, Jan Kautz, Yi Dong - 机构:NVIDIA - 链接:https://arxiv.org/abs/2610.06647 (v2,2026-10-06)
📖 为什么 RL 后训练这么吃显存
很多人对大模型显存的直觉来自推理:7B 模型 BF16 也就 14 GB,一张 24 GB 的消费卡都能跑。但训练完全是另一回事。
RL 后训练的显存大头有三块:权重本身、梯度缓冲、优化器状态。Adam 要维护一阶和二阶两个 FP32 动量,对 7B 模型就是 56 GB。更要命的是 RL 是个循环系统——rollout 引擎生成响应、reward 打分、trainer 更新权重、再把新权重同步回 rollout 引擎。每一步都要在生成和训练两套状态之间倒腾,通信和显存双重压力。
已有的解法大致三条路:系统层的 FSDP 分片、梯度检查点、CPU offload;参数高效路线的 LoRA(冻结主干只训低秩 adapter);以及梯度压缩路线的 GaLore、Flora(保持全量权重可训,但压缩梯度和优化器状态的表示)。
LoGRA 属于第三条路,但针对 RL 场景做了两件前人没做透的事:一是在反向传播时直接累积投影后的速写,全程不实例化完整梯度;二是把同一个压缩表示复用到 rollout 同步上。这个思路跟 Flora 那篇"LoRA 其实是梯度压缩器"的洞察一脉相承,但 LoGRA 把它推到了 RL 的完整闭环里。
🧠 方法核心:梯度速写 + KL 预算控制
一句话直觉
二元 outcome reward 的 RL,每个响应只拿到一个"对/错"信号——这么稀疏的监督信号,真的需要一个 \(d\times k\) 的完整梯度矩阵来承载吗?LoGRA 的答案是:不需要,\(d\times r\) 就够了。
梯度速写怎么工作
对模型里一个权重矩阵 \(W\in\mathbb{R}^{d\times k}\),标准 SGD 更新是 \(W\leftarrow W-\eta G\),其中 \(G=\nabla_W\mathcal{L}\) 和权重同尺寸。LoGRA 选一个远小于 \(\min(d,k)\) 的秩 \(r\),采样一个随机投影矩阵 \(A\in\mathbb{R}^{r\times k}\)(默认是 \(1/\sqrt{r}\) 缩放的随机符号矩阵,不学习、一个 batch 内固定),把梯度表示成:
存储量从 \(dk\) 降到 \(dr\)。论文给了个具体数:\(d=k=4096\)、\(r=64\) 时,FP32 梯度缓冲从 64 MiB 缩到 1 MiB——64 倍。
关键的工程细节是:这个 \(S\) 不是先算出 \(G\) 再压缩的,而是在反向传播时先投影权重梯度计算所需的输入,再乘 backward 导数,直接把各 microbatch 的贡献累积进 \(S\)。完整梯度从头到尾不存在,前向计算完全不受影响。
更新权重时,把速写乘回 \(A\) 得到全尺寸近似梯度 \(\widehat G = SA\),即:
其中 \(U\) 是优化器调整后的速写(基础 SGD 时 \(U=S\);主实验用的 RowAdam 按行做自适应缩放,每行维护平方幅度的滑动估计,但不做逐参数的一阶动量)。\(\alpha\) 是步长乘子,由 KL 控制器决定。因为 \(S\) 只有 \(r\) 列,每次更新秩至多为 \(r\),但每步重采样 \(A\) 让不同步的更新落在不同子空间里,累积起来的权重变化不受秩约束——这点和 GaLore 的投影刷新思路一致。
更新直接合并进全量权重,没有 LoRA 那种持久的 adapter 分支。训练完得到的就是一个普通模型,部署零额外成本。
顺手解决 rollout 同步
这是我个人觉得设计最巧的地方。RL 系统每步训练完都要把新权重推给 rollout 引擎,全量推送一个 7B 模型的更新是几十 GB 级别的通信。LoGRA 里,rollout 侧只需要拿到 \(\alpha\eta U\) 这个 \(d\times r\) 的因子,加一个种子——用它本地重新生成 \(A\),就能应用完全相同的更新。通信载荷从 \(O(dk)\) 变成 \(O(dr)\) 加一个种子。
Predicted-KL 步长控制
光有压缩还不够。RL 里一个参数空间上很小的更新,也可能让策略的输出分布剧烈漂移——这正是 TRPO 当年要解决的问题。LoGRA 的做法是:更新应用之前,先预估它会造成多大 KL 偏移,超预算就缩回去。
具体来说,从当前 batch 抽一小部分响应的上下文 \(\mathcal{P}\),比较当前策略和拟更新策略在这些上下文上的 next-token 分布。论文附录推导出一个二阶近似:平均 KL 随步长呈二次增长——
其中 \(q(D)\) 是对未缩放提案(\(\alpha=1\))的预估 KL,通过 token logit 沿更新方向的变化率的加权方差计算:
给定 KL 预算 \(\delta\),因为预估 KL 随 \(\alpha^2\) 缩放,直接开根号定步长:
\(\alpha_{\max}\) 防止预估 KL 很小时步长被无限放大。预算可以恒定,也可以退火——主实验用的是从 \(2\times10^{-4}\) 余弦退火到 \(2\times10^{-5}\)。另外还有个 mismatch subtraction 的实用细节:rollout 引擎和 trainer 在相同名义权重下的概率本来就有系统偏差(框架、kernel 差异),不扣掉这部分会把预算白白吃掉。
这套东西的好处是它不依赖 Adam 的逐参数自适应——SGD 配 KL 控制就能稳住训练,而 SGD 没有优化器状态,又省一大块显存。环环相扣。
📊 实验:省显存不掉点,27B 单机可行
主实验设置
模型覆盖 Qwen2.5-Math-1.5B/7B 和 Qwen3.8-27B,训练数据 DAPO-Math-7.5K,MATH-500 上每 5 步(27B 每 10 步)评估。刻意用了最朴素的 PPO 变体:每 prompt 采一条响应、全局运行均值做 baseline——作者明说这是为了把方法本身的效果从花哨 RL 算法的增益里隔离出来。这个实验洁癖我挺欣赏。硬件是单机 8×H100 80GB,4 卡 FSDP 训练、4 卡独立做生成。
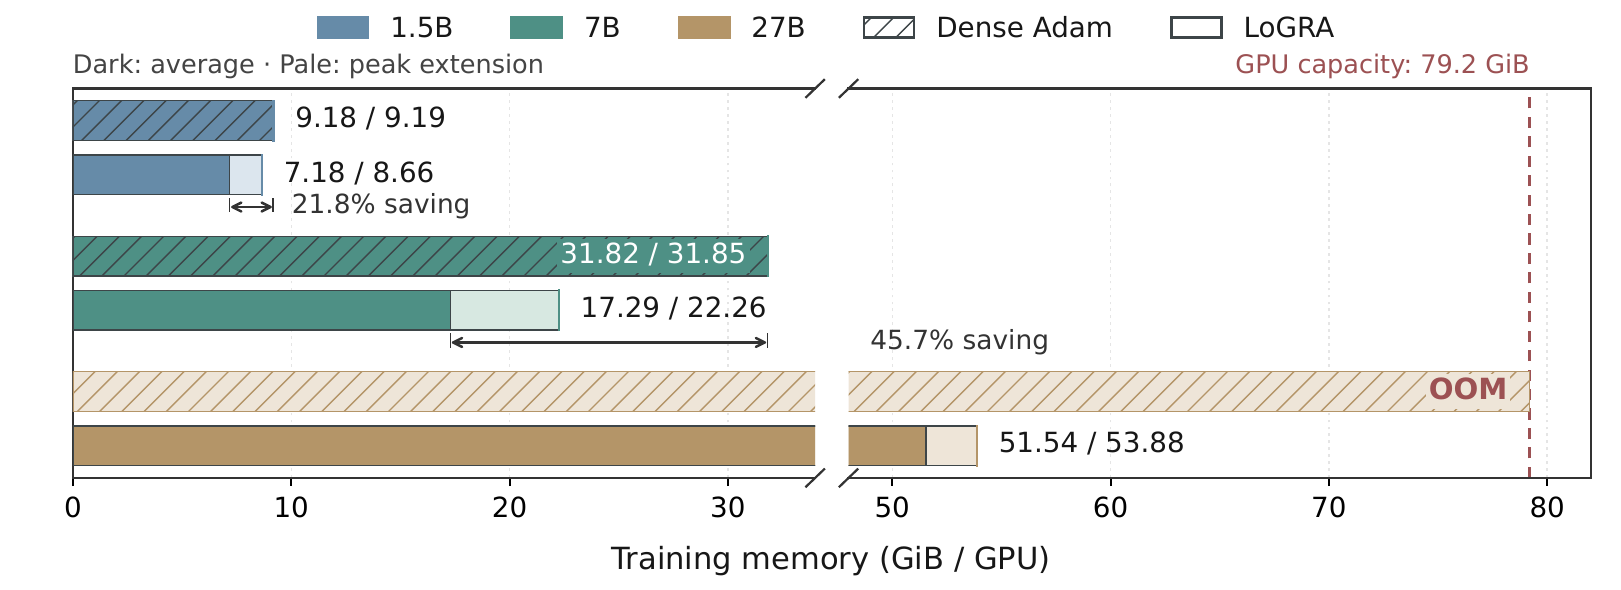
图1:1.5B / 7B / 27B 三个规模下 Dense Adam 与 LoGRA 的训练显存(GiB/GPU)。箭头标注平均显存节省比例;27B 的 Dense Adam 直接 OOM,LoGRA 平均 51.54 GiB 稳稳在 79.2 GiB 容量内。
主结果表格
| 模型 | 方法 | 平均显存 ↓ (GiB/GPU) | 峰值显存 ↓ (GiB/GPU) | 更新/小时 ↑ | Peak Pass@1 ↑ (%) | Peak Pass@4 ↑ (%) |
|---|---|---|---|---|---|---|
| 1.5B | Dense Adam | 9.18 | 9.19 | 54.28 | 63.77 | 80.33 |
| 1.5B | LoGRA | 7.18 | 8.66 | 55.44 | 67.87 | 82.47 |
| 7B | Dense Adam | 31.82 | 31.85 | 25.28 | 72.48 | 85.33 |
| 7B | LoGRA | 17.29 | 22.26 | 25.73 | 72.33 | 85.13 |
| 27B | Dense Adam | OOM | — | — | — | — |
| 27B | LoGRA | 51.54 | 53.88 | 6.99 | 71.52 | 81.87 |
表1:主实验精度、显存、吞吐对比(3 seeds)。1.5B 上 LoGRA 显存降 21.8%、Pass@1 反而涨了 4 个点;7B 显存降 45.7%、精度基本持平;27B Dense Adam 第一步就 OOM。
几个值得停下来看的数字:
1.5B 上 LoGRA 的 Pass@1 反而高了 4.1 个点(67.87 vs 63.77)。这挺反直觉的——压缩梯度居然还涨了精度?我的猜测是低秩更新加 KL 预算起到了某种正则化效果,抑制了小模型上的过拟合/策略抖动。论文没展开讨论这个,有点可惜。
7B 上精度基本持平(72.33 vs 72.48),显存砍掉近一半。这才是这套方法的常态预期:免费午餐没有,但半价午餐是真的。
吞吐几乎无损。55.44 vs 54.28 updates/h(1.5B)、25.73 vs 25.28(7B)。说明投影和 KL 估计的开销被省下的显存搬运抵消了。
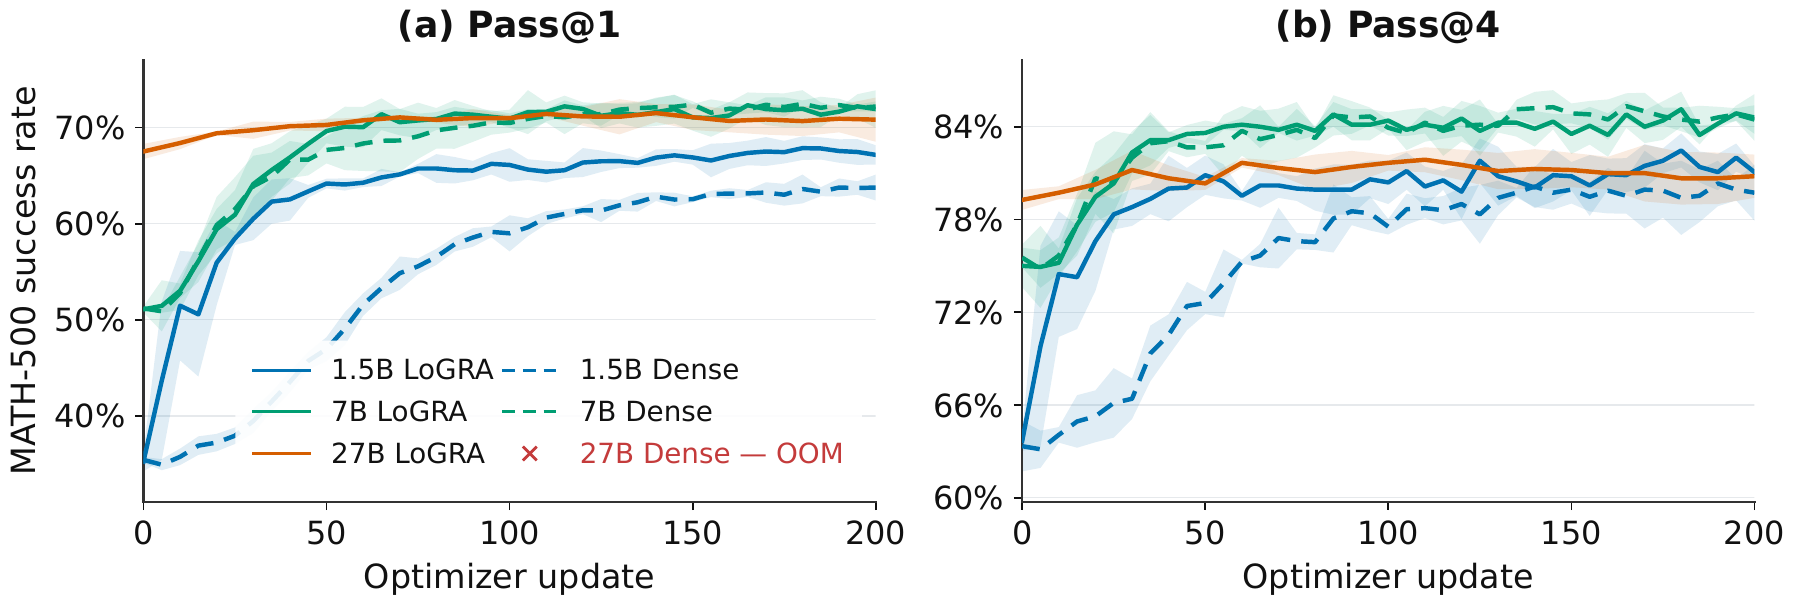
图2:前 200 步更新的 MATH-500 成功率(3 seeds 均值 ± 标准差)。1.5B LoGRA(实线蓝)全程压过 Dense(虚线蓝);7B 两条绿线几乎重合;27B(橙)只有 LoGRA 一条线——Dense 根本没有曲线可画。
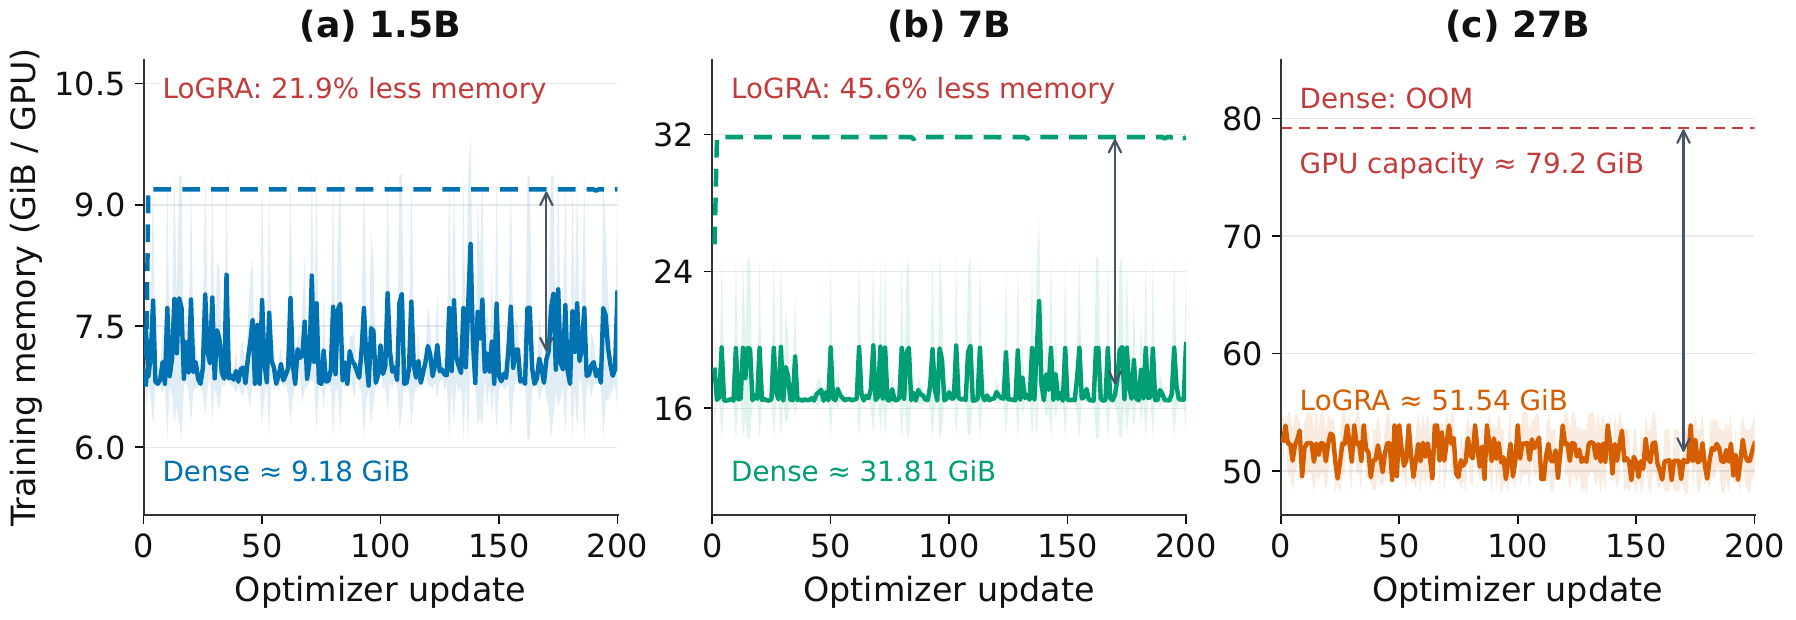
图3:逐步的峰值显存。Dense 的显存曲线是平的(优化器状态一分配就恒定),LoGRA 明显低且随 KL 预算有波动;27B 面板里红色虚线是 79.2 GiB 的卡容量,Dense 的箭头直接顶穿。
27B 长程训练:真正的卖点
主实验之外,作者在 Reasoning-Gym Hard 混合任务(38,948 训练 prompt、193 道 held-out 难题、8 类任务)上用 LoGRA 训 Qwen3.8-27B 超过 1100 步。这里预估 \(q(D)\) 用的是基于直接 KL 评估的有限差分探针,而不是公式 6 的 JVP 估计器——效率考虑。
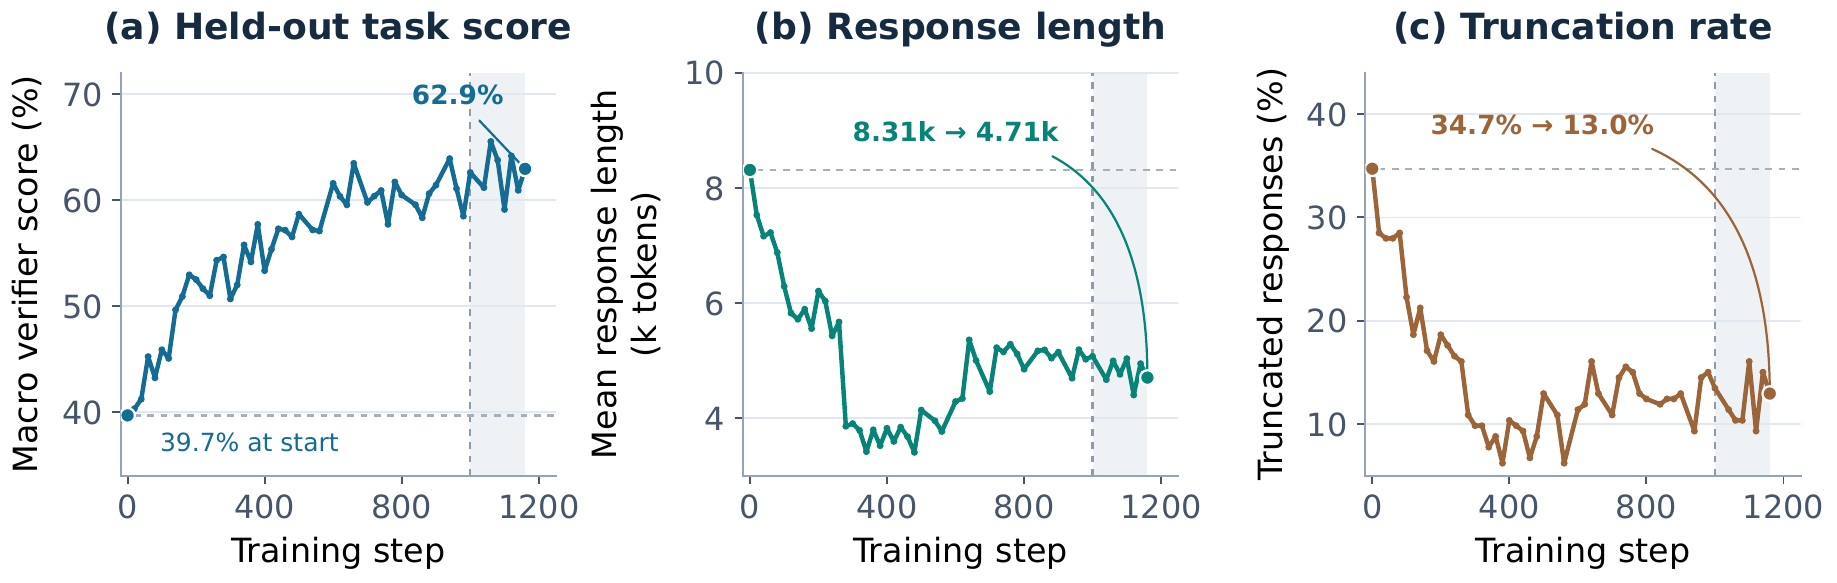
图4:(a) held-out 宏平均 verifier 分数从 39.7% 涨到 62.9%,峰值 65.52%(第 1060 步);(b) 平均响应长度从 8.31k 降到 4.71k token;(c) 16,384 token 截断率从 34.7% 降到 13.0%。三个指标都没有崩坏迹象。
这组图的信息量其实比主实验大。响应长度下降、截断率下降、分数上升——说明模型在长程训练中学会的是"更紧凑地推理",而不是靠堆长度刷分。RL 长程训练最怕的就是后期响应长度失控膨胀然后崩掉,这里 1100 步没出现,predicted-KL 控制应该记一功。
🔬 消融:秩是关键变量,刷新投影没那么重要
投影设计的三个维度
作者消融了秩 \(r\in\{4,16,64,256\}\)、基是否每步刷新、投影分布(Rademacher vs 高斯)三个因素:
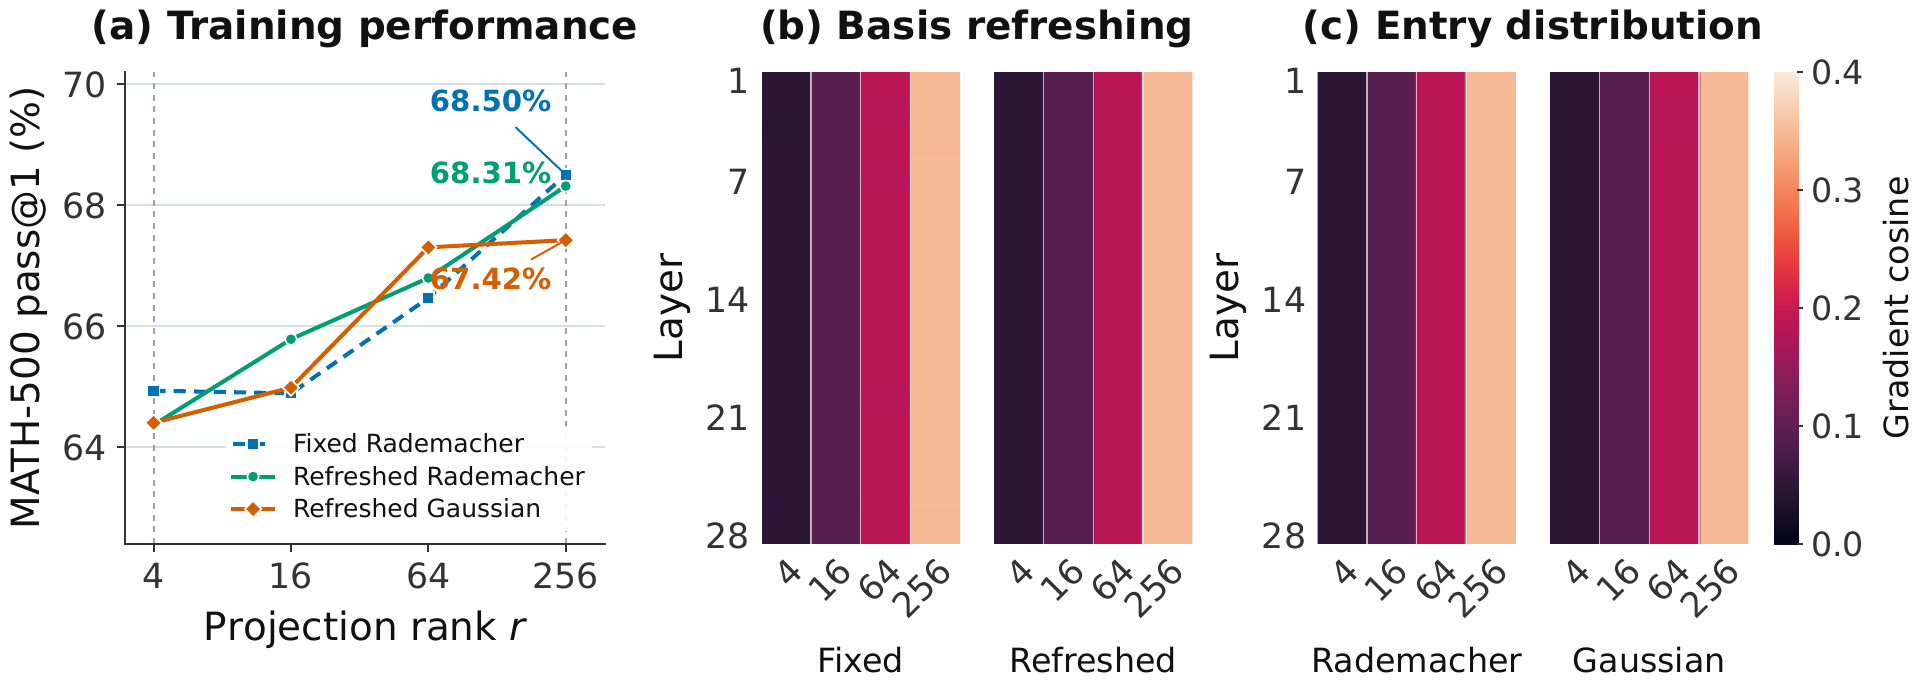
图5:(a) MATH-500 pass@1 随秩变化,三种投影配置都是秩越大越好;(b)(c) 梯度重建余弦相似度热力图(层 × 秩),固定 vs 刷新基、Rademacher vs 高斯的差异肉眼几乎不可见。
结论挺干净:秩是唯一有分量的变量。秩从 4 到 256,pass@1 提升 3.02–3.95 个点;重建余弦相似度从约 0.046 涨到 0.348。而固定 vs 刷新 Rademacher 的最大差异只有 0.0014,Rademacher vs 高斯只有 0.0008。
这个结果其实打了 Flora 的脸——Flora 的核心动机就是刷新投影避免被困在固定低秩子空间里,但在 RL 后训练这个场景(至少 200 多步的尺度上),刷新没带来稳定收益。作者的解释比较克制:可能固定子空间在短训练周期内已经足够捕获任务相关信号。我觉得还有一个更朴素的解释:RL 的梯度信号本来就稀疏低秩,投到哪个随机子空间差别不大。
和 LoRA 的正面对比
| 方法 | 平均显存 ↓ (GiB) | 峰值显存 ↓ (GiB) | Pass@1 ↑ (%) | Pass@4 ↑ (%) | 秒/更新 ↓ |
|---|---|---|---|---|---|
| LoRA | 13.21 | 13.38 | 70.45 | 81.40 | 10.63 |
| LoGRA | 7.18 | 8.66 | 68.47 | 81.80 | 11.31 |
表2:Qwen2.5-Math-1.5B 上 LoRA 与 LoGRA(均秩 256,前 300 步)。
作者自己写得很诚实:LoRA 的 Pass@1 更高、单步更快,LoGRA 只在显存和 Pass@4 上占优。显存才是 LoGRA 的存在理由,不是精度也不是速度。而且别忘了 LoRA 训完是带 adapter 的模型,要做全量部署还得 merge;LoGRA 直接产出全量权重。
KL 预算消融
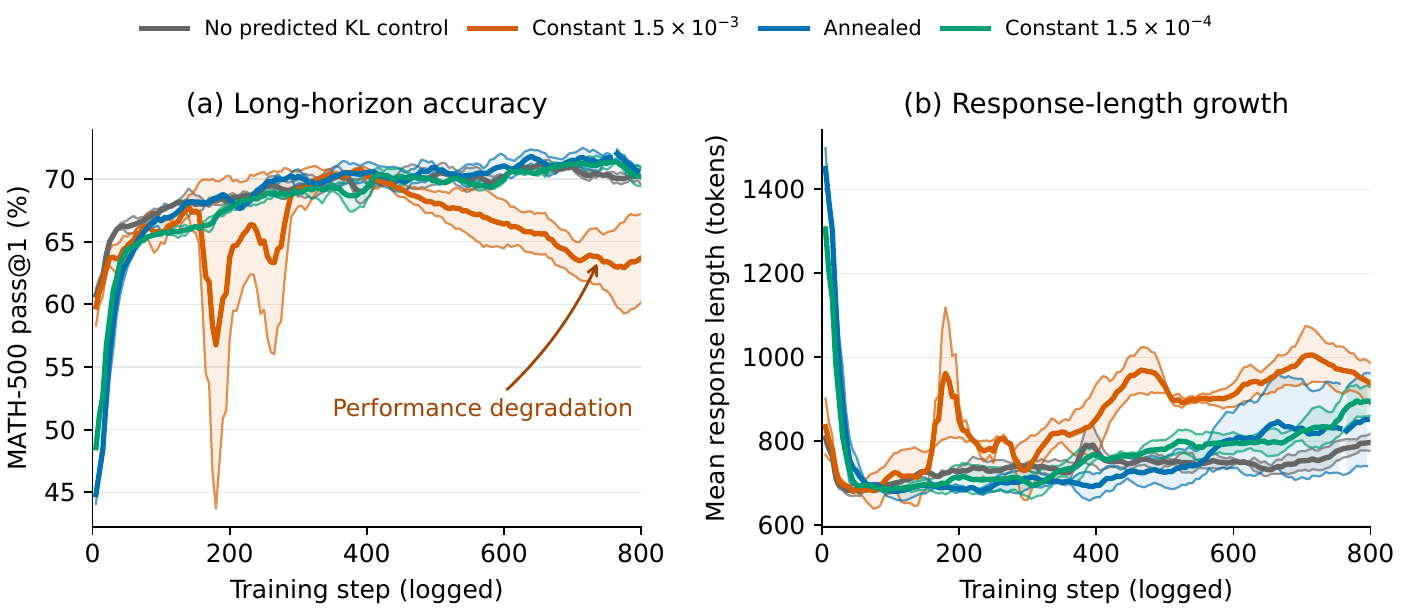
图6:(a) 长程 MATH-500 pass@1:橙色大预算(恒定 \(1.5\times10^{-3}\))在 400 步后明显退化,灰色无控制、绿色小预算、蓝色退火都稳定;(b) 响应长度:大预算同样出现膨胀。
700–800 步的尾部均值:无控制 70.30%、大恒定预算 63.43%、小恒定预算 71.03%、退火 71.47%。退火最好,大预算直接翻车。作者的态度同样克制:两种子实验说明校准良好的 KL 控制有益,但不能证明它对稳定性是必需的——无控制基线这次也没崩。这种不过度宣称的写法在今年的论文里算少见的。
🤔 我的判断
亮点:把梯度压缩真正闭环进了 RL 系统——sketch 累积、低秩更新、rollout 同步复用同一表示、KL 预算兜底,每一环都扣得上。27B 单机 8 卡跑 1100 步这个 demo 的实用价值是实打实的:以前这个配置想都别想。
要泼的冷水:第一,实验全部集中在数学推理(可验证奖励、单响应、全局 baseline),这是最有利于梯度压缩的场景——reward 信号本身就接近一维。换成多轮 agentic RL 或者过程奖励,低秩假设还成不成立,论文没回答。第二,1.5B 上的精度反超很可能有小模型+特定数据的运气成分,不宜外推。第三,predicted-KL 需要在更新前额外做一次前向评估(有限差分探针还要多次),这部分开销在长 context 场景未必便宜,论文没给单独的计时拆解。
工程上的启发:如果你在做 RL infra,有两个思路可以直接拿走——一是"梯度根本不需要完整落地"这个实现技巧(先投影输入再乘导数),改 backward 的 hook 就能做;二是用 KL 预算替代学习率调参,让步长自适应于策略偏移量,这对没有 Adam 状态的极简优化器尤其友好。代码在 NVIDIA 的 Molt 库里,可以翻。
说到底,这篇论文回答的问题很朴素:RL 后训练一定要这么贵吗?答案是不需要——梯度里的大部分信息本来就是冗余的,一个 sketch 加一颗随机种子就够了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我