蒸馏不止看输出:Latent-MOPD 把多个专家模型的"内心活动"也蒸进了一个学生
你有没有遇到过这种情况:手里攒了好几个 RL 调出来的专家模型,一个数学特别强,一个代码特别强,一个逻辑推理特别强,但你只能部署一个模型。最直接的念头是把它们的输出概率平均一下蒸给学生——结果往往是三个专家互相稀释,学生变成一个平庸的"老好人"。
上周挂到 arXiv 的这篇 Latent-MOPD(arXiv:2610.02381)就是来解决这件事的,而且它的切入点比常规的 token 蒸馏更深一层:不只蒸老师说了什么,还蒸老师想的时候脑子里发生了什么。
核心摘要:多教师 on-policy 蒸馏(MOPD)目前只在输出分布层面传递知识——学生自己生成回答,对应领域的老师逐 token 打分。这篇论文提出 Latent-MOPD,据作者所称是首个在表征层面做多教师 on-policy 蒸馏的方法:除了 token 预测,还把老师计算这些预测时用的隐状态也作为监督目标。三个关键设计——按师生关系选层、按领域组织纯批次更新、每个老师各自的"隐状态→token"淡入淡出调度——让一个 1.5B 学生在数学、代码、逻辑共 9 个 benchmark 上全面超过 token-only、表征-only 和均匀平均三类 baseline,并在其中 5 个 benchmark 上反超了该 benchmark 最强的那个老师。这不是底层理论突破,更像一套工程上相当讲究的整合配方,但配方里的每一步都有实验撑着,值得细读。
📖 论文信息
- 标题:Latent-MOPD: Latent Multi-Teacher On-Policy Distillation
- 作者:Zhengyu Fang、Seoyeon Hong、Jie Yang(共同一作),Muyang Li、Koyoshi Shindo、Brandon Joseph Lwowski、Jing Li(通讯)
- 机构:Case Western Reserve University、Zillow Group、University of Illinois at Chicago、University of Florida
- 链接:https://arxiv.org/abs/2610.02381 ,代码开源在 https://github.com/fangzy96/Latent-MOPD
- 提交时间:2026 年 10 月 1 日
🎯 问题动机:平均会稀释,路由只解决了"谁来教"
先把背景快速补齐。On-policy distillation(OPD,Agarwal et al., ICLR 2024)这两年成了后训练的热门手段:学生自己采样回答,老师在这些学生真实会走到的轨迹上给出逐 token 的稠密监督。相比离线蒸馏,它消除了训练-推理的状态错配;相比 RLVR,它的监督信号是稠密的而不是稀疏的 outcome reward。Thinking Machines 去年那篇 blog 把它带火之后,工业界很快跟进——MiniCPM 的训练配方里就有"SFT → 各领域 RL 出专家 → OPD 蒸回一个模型"这条流水线。
多教师场景(MOPD)的做法是给每个 prompt 按领域路由到对应专家。路由解决了"谁来教这个样本",但监督本身仍然只发生在输出层。
问题在于,输出分布是内部计算的终点。可解释性研究已经反复表明,隐状态里携带着中间推理步骤的信息,并且会因果地影响后续计算——即使这些步骤从来没被说出来。你想想看,老师"怎么算出来的"这部分知识,token 蒸馏是拿不到的。
单教师场景下已经有 LastOPD、OPRD 这类工作证明隐状态监督有效。但多教师完全是另一回事:三个专家的表征目标要同时压进同一个学生 backbone,怎么选层、怎么组织更新,论文开头就抛出了这个核心问题。
说实话我第一反应是:这会不会是个伪命题?隐状态蒸馏在单教师上 work 不代表多教师也需要——也许 token 通道就够了。但作者用一个挺狠的失败实验说服了我,这个后面讲。
🧠 两个反直觉的观察
在给出方法之前,作者先做了两个诊断实验,我觉得这是全文最有价值的部分之一。
观察一:层与层的对应关系,取决于师生关系。
作者用 CKA(centered kernel alignment)测了老师和学生在各层上的表征相似度。同家族(same-family,同一血脉 RL 出来的 1.5B 专家们)的 CKA 在大部分层都很高,差异主要集中在靠近输出的后段;而跨家族(cross-family,独立开发的 7B Qwen 系模型)在中层会出现一个明显的相似度"深谷"——中层几乎对不上,首尾反而还行。
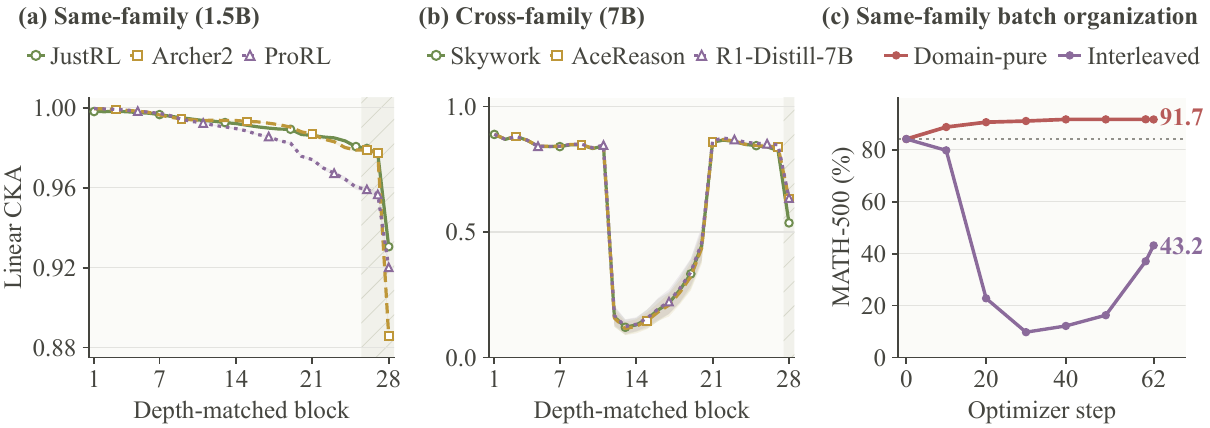
图1:表征目标选择与更新组织。(a) 同家族 1.5B 教师(JustRL、Archer2、ProRL)与学生各层 CKA 都很高,差异集中在尾部(注意纵轴是放大刻度);(b) 跨家族 7B 教师(Skywork-OR1-Math、AceReason-Nemotron、R1-Distill-7B)在中层出现明显相似度低谷;(c) 关键实验——同样的全层表征-only监督,domain-pure 批次(红色)稳稳跑完 62 步达到 91.7,而领域交错批次(紫色)在 20 步内就崩到 22.8,最终 43.2 远低于 base 的 84.1(虚线)。
这个观察直接决定了选层策略:同家族就对齐最后三层(差异所在即信息所在);跨家族中层对不上,干脆只对齐"直接喂给 LM head 的最终隐状态"——这是各模型中功能角色最一致的状态。
观察二:批次组织方式能决定训练死活。
这个实验真的让我愣了一下。同样是全层表征-only监督,每个样本的监督来源完全一样,唯一的区别是:一次优化器更新里是只有一个领域的样本(domain-pure),还是多个领域混在一起(interleaved)。结果 domain-pure 稳定收敛,interleaved 二十步内直接崩盘,MATH-500 从 84.1 掉到 22.8。
想想其实也合理:三个老师的隐状态目标在同一个 batch 里方向互相打架,梯度噪声大到把训练炸掉。但这么一个朴素的结论,之前的多教师蒸馏工作里没人明确指出过。路由决定了"谁教",但没决定"怎么排课"——这篇论文把这件事讲清楚了。
🏗️ 方法:Latent-MOPD 的三个部件
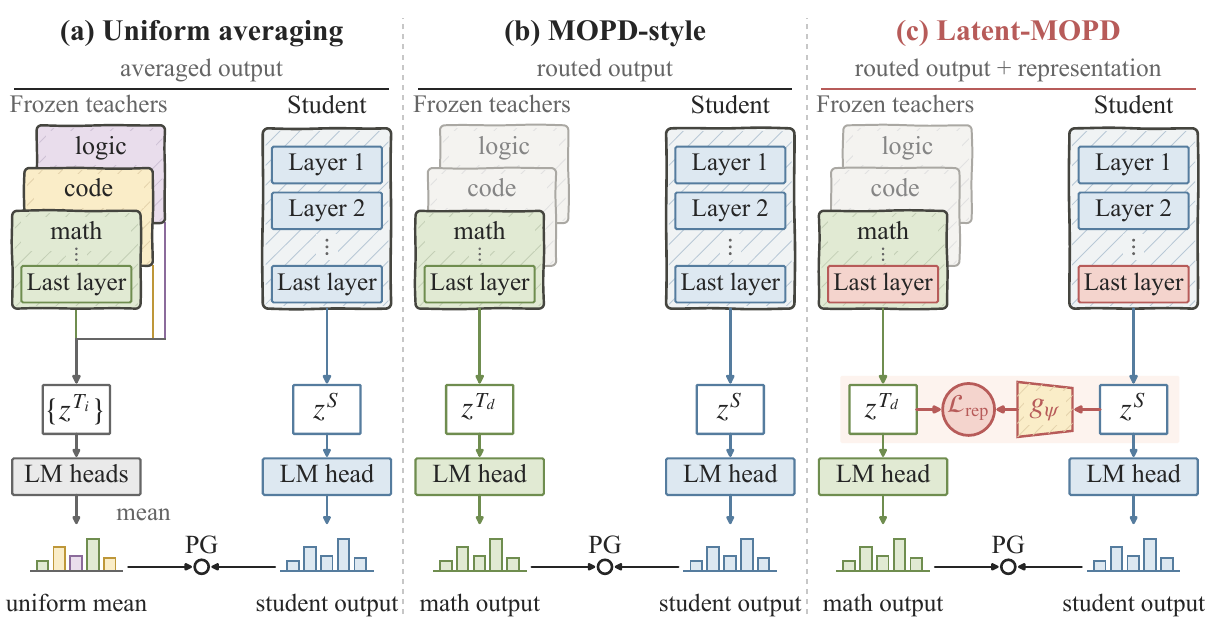
图2:三种监督设计在同一个学生前缀上的对比。(a) 均匀平均:三个老师的输出分布等权平均,专家的自信预测被稀释;(b) MOPD-style:按领域路由到单个冻结老师,只做 token 层监督(PG 指 LM head 之后的 policy-gradient 更新);(c) Latent-MOPD:在路由 token 监督之外,加了一条表征通道——用 \(g_\psi\) 把学生隐状态映射后对齐同一位老师的隐状态。图中画的是数学 prompt 的场景,只有数学老师被激活。
部件一:领域路由的 token 通道
沿用 MOPD 的做法:每个 prompt 带领域标签(数学/代码/逻辑),路由到对应专家,整条回答固定由这一个老师监督。具体估计器是学生侧 top-k(k=16)候选集上、用老师-学生 log 概率比做加权的 policy-gradient 式更新:
其中 \(A_{t,v}\) 是由 log 概率比算出、并按领域内 masked 标准差归一化的固定 advantage。这个设计的好处是学生自己选候选、老师打分,不需要全词表对齐。
部件二:选择性的晚层对齐
表征通道的损失很直接——归一化后的隐状态 L2 距离:
同家族时 \(g_\psi\) 就是恒等映射(宽度相同);跨家族时是一个所有老师共享的可训练线性映射(1536→3584),用岭回归在路由后的师生状态对上初始化。老师全部冻结,梯度只流向学生(和映射层)。
有个细节我觉得挺务实:28 层里只选 3 层,选中状态的存储量直接砍掉 89.3%——16384 个 token 位置、BF16、宽度 1536 的场景下,师生两份张量拷贝从 2.63 GiB 降到 0.28 GiB。而且多层之间是先按层各自平均再等权平均,选三层不会把表征权重放大三倍。这种细节说明作者真的跑过工程账。
部件三:每个老师各自时钟上的 crossfade
这是最精巧的一个设计。表征监督不是全程开的,而是渐进退出:
关键是 \(u\) 数的是当前这位老师完成的更新次数,不是全局步数。三个老师轮转授课,每位老师都走完自己完整的"先隐状态后 token"淡入淡出曲线:同家族 \(T_w=10\)、跨家族 \(T_w=7\)(折算全局步数分别覆盖 62 步中的前 30 步和前 21 步)。
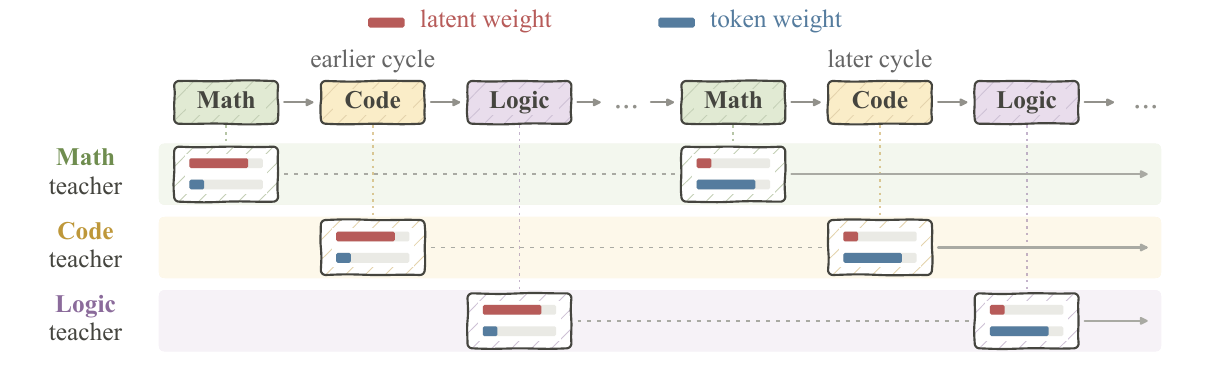
图3:跨教师的 crossfade 调度示意。domain-pure 更新按数学→代码→逻辑轮转,每个老师的隐状态权重(红)在自己授课周期的开头衰减、token 权重(蓝)同时上升——早周期里隐状态主导,晚周期里每位老师只剩一小段隐状态权重,之后完全切到 token 监督。每个老师走的是自己独立的时钟。
为什么需要这个?作者引用了 LastOPD 的发现:隐状态监督是一种"瞬态"信号,长期开着反而有害。论文里跨家族场景下全程表征-only的 baseline 直接掉到 base 水平之下(Norm 为 -0.05),证实了这个判断。
🧪 实验:学生反超老师
实验设置:学生是 DeepSeek-R1-Distill-Qwen-1.5B。同家族用三个同血脉 RL 调的 1.5B 专家(数学/代码/逻辑各一);跨家族用三个独立开发的 7B 模型(Skywork-OR1-Math、AceReason-Nemotron、R1-Distill-7B)。训练数据来自 DAPO-Math-17k、OpenCodeReasoning 和 Reasoning Gym,共 17856 个 prompt,62 步优化,全程无 verifier reward。
主结果一:同家族,一个 1.5B 学生在 5 个 benchmark 上超过最强老师
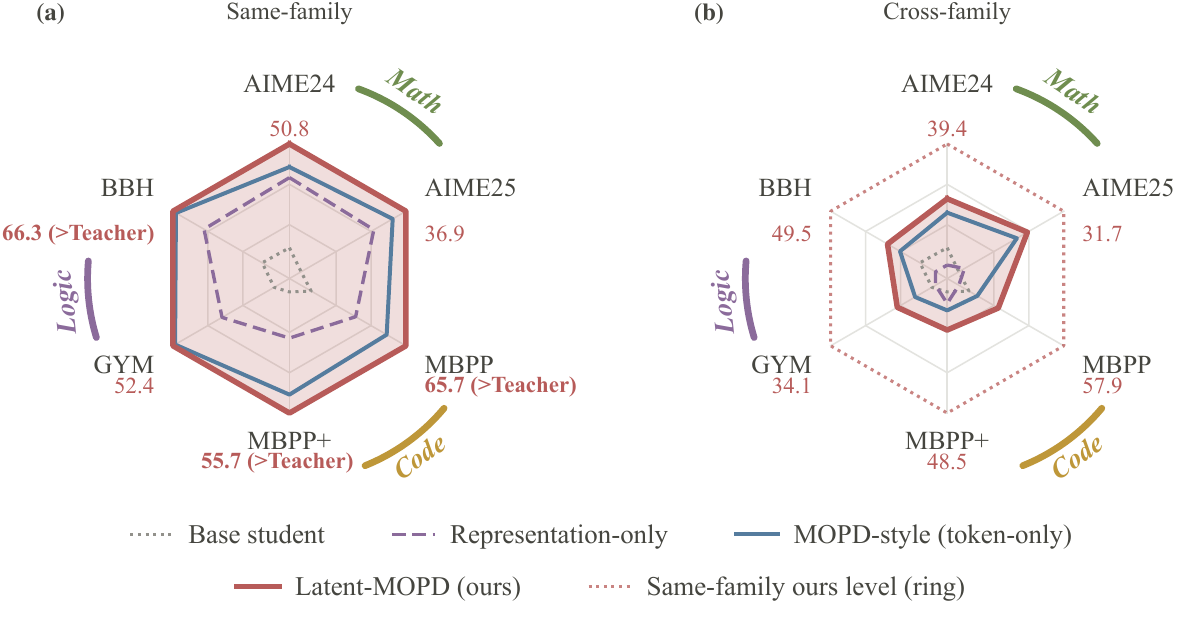
图4:九项 benchmark 雷达图。(a) 同家族:红色实线是 Latent-MOPD,在 BBH(66.3)、MBPP(65.7)、MBPP+(55.7)等五项上超过该 benchmark 最强教师(标注 >Teacher),蓝色 MOPD-style 和紫色虚线的表征-only 都被包在里面;(b) 跨家族:Latent-MOPD(last 1, Linear)同样全面超过两个单通道 baseline,粉色虚环是同家族成绩作为参照。
完整数字见下表(Norm 指标:base=0,最强教师包络=1):
| 方法 | GYM | BBH | MuSR | LCB-e | MBPP | MBPP+ | AIME24 | AIME25 | Minerva | Norm |
|---|---|---|---|---|---|---|---|---|---|---|
| 教师(数学) | 39.1 | 60.5 | 50.3 | 66.8 | 60.4 | 51.1 | 56.5 | 37.7 | 33.6 | -- |
| 教师(代码) | 25.6 | 41.6 | 45.1 | 73.5 | 62.0 | 52.6 | 42.1 | 30.0 | 32.2 | -- |
| 教师(逻辑) | 52.8 | 61.8 | 50.9 | 74.3 | 59.0 | 49.6 | 46.2 | 35.6 | 33.8 | -- |
| Base 学生 | 24.6 | 39.9 | 46.4 | 51.1 | 54.4 | 45.2 | 29.2 | 21.9 | 29.9 | 0.00 |
| 均匀平均 | 40.7 | 60.0 | 50.4 | 72.8 | 61.1 | 50.7 | 48.1 | 34.0 | 34.6 | 0.79 |
| MOPD-style (token-only) | 51.8 | 65.4 | 50.7 | 68.3 | 63.4 | 54.1 | 46.0 | 35.0 | 33.5 | 0.90 |
| Rep-only (last 3) | 42.9 | 59.3 | 49.5 | 69.8 | 60.6 | 52.2 | 44.0 | 34.2 | 31.9 | 0.73 |
| Latent-MOPD (constant) | 51.9 | 64.4 | 50.1 | 71.6 | 63.9 | 53.6 | 47.3 | 37.5 | 33.9 | 0.94 |
| Latent-MOPD (last 3) | 52.4 | 66.3 | 52.4 | 73.1 | 65.7 | 55.7 | 50.8 | 36.9 | 36.3 | 1.05 |
几个值得停一秒的数字。Norm 达到 1.05——超过了"最强教师包络"这个理论上界,说明学生不只是拼凑,而是产生了某种互补增强。相比 token-only 的 MOPD-style,Minerva 从 33.5 涨到 36.3,LiveCodeBench-easy 从 68.3 涨到 73.1。还有 crossfade 的功劳:对比同配置但权重恒定的版本(0.94),crossfade 在 9 个 benchmark 中的 8 个上更好。
坦白说这里我有个疑问:Norm 超过 1 听上去很漂亮,但它衡量的只是"聚合改进 / 师生差距之和"的比值,超过 1 并不代表全面碾压老师——AIME24 上学生 50.8 还是低于数学老师的 56.5。这个指标的定义方式多少有点讨巧,读者看雷达图比看 Norm 更实在。
主结果二:跨家族 7B 教师,6 个 benchmark 全胜单通道 baseline
| 方法 | GYM | BBH | MBPP | MBPP+ | AIME24 | AIME25 | Norm |
|---|---|---|---|---|---|---|---|
| MOPD-style (token-only) | 29.2 | 45.8 | 55.4 | 46.8 | 36.5 | 30.2 | 0.16 |
| Rep-only (last 1) | 23.6 | 35.3 | 53.2 | 46.2 | 25.6 | 22.7 | -0.05 |
| Latent-MOPD (last 3, Linear) | 34.6 | 47.6 | 59.4 | 50.9 | 36.9 | 30.6 | 0.25 |
| Latent-MOPD (last 1, Linear) | 34.1 | 49.5 | 57.9 | 48.5 | 39.4 | 31.7 | 0.26 |
| Latent-MOPD (last 1, MLP) | 32.5 | 47.0 | 58.9 | 50.4 | 42.9 | 31.0 | 0.27 |
跨家族场景才是最难的——教师隐宽度是学生的 2.3 倍,训练血脉完全不同。逻辑域收益最大:GYM 从 29.2 到 34.1,BBH 从 45.8 到 49.5。注意 Rep-only 那行:Norm 是负的,全程开表征监督在跨家族下直接帮倒忙。线性映射和两层 MLP 打平(各赢 3 个 benchmark),说明映射的容量不是瓶颈。
主结果三:从参数合并出发,62 步再进一步
第三个实验很有意思:先把三个同家族教师的权重直接平均(model soup),学生从这个"参数合并"出发再蒸 62 步。合并起点本身 Norm 就有 0.87,加 Latent-MOPD 后涨到 1.03,优于同起点的 token-only(0.97)和表征-only(0.91),GYM 从 46.3 到 52.2、AIME24 从 48.1 到 53.8。这等于把"权重融合"和"行为蒸馏"串成了一条零训练成本起点的流水线。
🔬 消融与机制分析
训练动态。 同家族在 MATH-500 上从 base 的 84.1 起步,第 20 步到 90.3,第 62 步到 92.0;跨家族从同一起点到 87.7。两条曲线在表征监督退出的 token-only 后半段都没有回落——收益不是表征阶段暂时"顶"上去的。
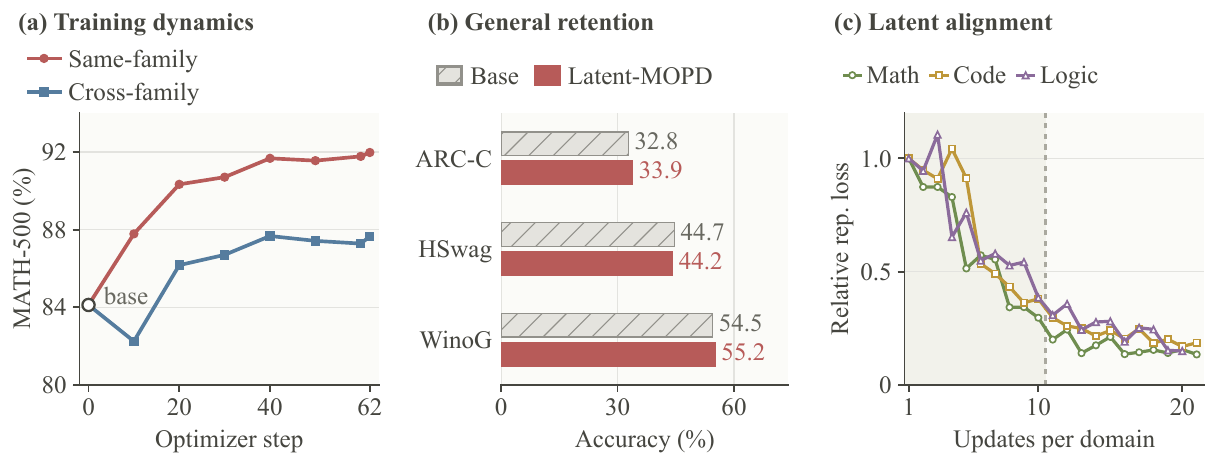
图5:(a) 两种场景下 MATH-500 训练曲线,均稳定上升且后期不回落;(b) 未参与蒸馏的通用能力测试(ARC-C、HellaSwag、WinoGrande)与 base 差距在 1.1 分以内,基本没有遗忘;(c) 学生在三个领域的原始表征损失(已排除权重衰减影响)持续走低,最终降到初始值的 0.13/0.19/0.15——说明学生真的在内部表征上向三位专家靠拢,而不只是损失权重在变。
输出对齐。 训练完后,学生在老师意见分歧的位置上更像"该领域的老师"了:MOPD-style 下数学行最像的居然是代码老师(0.966 对 0.938),Latent-MOPD 把这个错位纠正了过来(数学老师 0.969 成为最高),matching-teacher margin 在选中位置上提升 0.0648,配对置信区间为正。
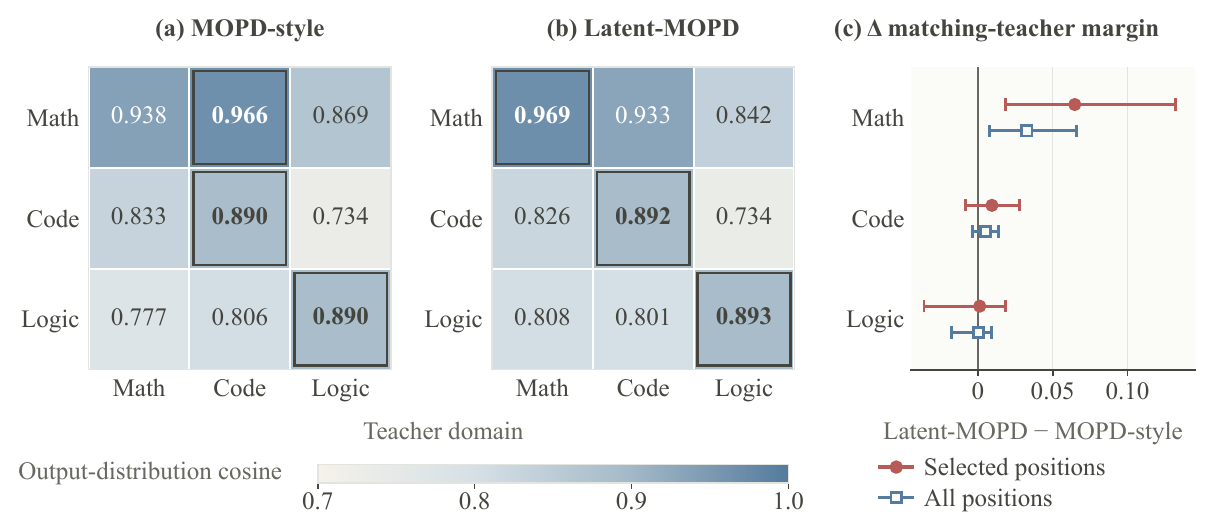
图6:训练后学生与三位教师的输出分布余弦相似度。(a) MOPD-style:数学行最大值错配在代码教师上;(b) Latent-MOPD:三个领域的对角线都是最大值,学生分别对齐到了各自领域的教师;(c) 数学、代码、逻辑三个领域的 matching-teacher margin 变化,均为正向。
通用能力保持。 在三个完全不在训练池里的通用套件上,学生与 base 的差距在 1.1 分以内(ARC-C 和 WinoGrande 还略有提升)。62 步的小预算蒸馏没有造成明显遗忘。
💡 我的判断
这篇论文最值钱的地方,在我看来不是"首个表征级多教师 OPD"这个名头,而是两个诊断性发现:domain-pure 更新组织和中层 CKA 深谷。前者用一次干净的对照实验证明了批次组织能决定表征蒸馏的生死,后者给"选哪层"这个一向靠拍脑袋的问题提供了可测量的依据。
方法本身是整合式的:crossfade 借自 LastOPD,路由借自 MOPD,参数合并借自 model soups。但整合得相当有章法——每个部件都有对应的消融撑着,crossfade 对比恒定权重赢了 8/9,三层对比单层赢了 8/9。这种"每个设计决策都被实验验证过"的论文,工程上抄起来风险很低。
局限性也得说清楚。一是规模很小:1.5B 学生、62 步、不到 8000 条回答,这套配方在 30B+ 或者上千步训练下是否还成立,完全是开放问题——尤其 domain-pure 批次在大 batch 场景下的吞吐代价不小。二是跨家族场景下学生离 7B 教师还差得远(AIME24 学生 39.4 vs 数学老师 61.9),"整合多个专家"目前还停留在"超过 base 和单通道 baseline",离"逼近教师团"有距离。三是论文没讨论路由标签从哪来——实验里领域标签是现成的,真实场景里 prompt 的领域分类本身是个前置问题。
如果你在维护一条"多专家 RL → 合并成单模型"的后训练流水线,这篇论文的三个配方——晚层对齐、domain-pure 更新、per-teacher crossfade——都值得直接试。代码开源,成本也不高(62 步就能看到效果)。但如果你的教师团规模差异巨大或领域数很多,建议先复现那个 domain-pure 稳定性实验再决定要不要全量上。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我