改技能要留"作案现场":EviSkill 用可回放证据卡给智能体技能进化装上行车记录仪
你有没有遇到过这种场景:让智能体跑了一批任务,从失败轨迹里总结出几条"经验教训"写进技能库,满心欢喜以为它会越用越聪明——结果下一轮它在新任务上犯起了从没见过的错。更气人的是,你根本查不出来是哪条"经验"把它带歪的,因为当初改技能的时候,没人记录这条改动是从哪条轨迹、哪一步、哪个错误里来的。
吉林大学这篇 EviSkill(arXiv:2610.05030)盯的就是这个痛点。他们的发现挺扎心:现有经验驱动的技能进化方法里,从轨迹提炼出来的编辑,有将近一半重跑一遍根本不奏效;而一次全局验证失败后,整个修订版本被扔进垃圾桶——但桶里其实藏着不少有用的改动,挑出来单独保留,性能能涨 12.5 个点。
核心摘要:EviSkill 把技能进化从"凭经验改"变成"带证据改"。每条候选编辑都被绑定到可回放证据卡(Replayable Evidence Card)上,卡里记着支持这条改动的具体轨迹区间;编辑要先在原始执行现场"回放"重跑、验证行为确实变了,才有资格进入候选修订;全局验证拒绝修订时,局部被验证过的编辑也不会被株连,而是挂进临时账本跨轮次继续观察。在 ALFWorld、AppWorld、ScienceWorld 三个交互式基准、六个 LLM 骨干上,EviSkill 在 18 个模型-数据集组合里拿了 14 个第一,相比无技能基线平均涨 17.93 个点。说实话,这篇不是底层范式突破,更像是给技能进化流程做了一次严谨的"司法化改造"——但改得相当扎实,工程上值得抄。
📖 论文信息
- 标题:EVISKILL: Grounding Skill Evolution in Replayable Evidence
- 作者:Yan Zhou、Yili Wang、Yiwei Dai、Qinggang Zhang、Xin Wang
- 机构:吉林大学人工智能学院
- 发表:arXiv:2610.05030,2026 年 10 月 4 日
- 代码:https://github.com/Zhouyaner/eviskill
🎯 问题动机:经验驱动的技能进化,病在哪
先交代一下背景。让 LLM 智能体不动参数、只靠外部技能库(skill library)积累可复用的程序性知识,这条路线从 Voyager 的技能库开始已经走了好几年。2025 年底 Anthropic 把 Agent Skills 做成开放标准之后,"技能怎么自动长出来、怎么持续改好"直接成了产业瓶颈——手工打磨的 skill 好用但太贵,自动生成的 skill 又被吐槽"像玩具不像工具"。于是一批工作开始做技能自动进化:Trace2Skill 从单条轨迹提炼教训合并成技能补丁,SkillGrad 把执行诊断转成文本梯度去改技能包,EvoSkill 靠失败分析提新技能再过淘汰赛,SkillOpt 用留出验证集分数决定接受哪次编辑。
这些方法有个共同范式:执行反馈 → 提炼成指导 → 迭代改技能。听起来很自然,但作者指出两个结构性毛病。

图1:两种范式的对比。上图(经验驱动):轨迹直接喂给编辑器产出编辑,过一道全局验证,不过就整个丢弃。下图(证据落地):先抽证据,编辑绑定证据,过局部验证再过全局验证,被拒的修订也不会全盘丢弃。
毛病一:编辑和支持它的证据之间没有显式关联。轨迹里有任务上下文、行为信号、大量冗余动作和偶发交互。完整保留轨迹,支持信息被淹没;抽象成文字教训,执行上下文又丢了。改完之后出了问题,你想回溯"这条改动当时是基于什么现场做出来的",查无此人。
毛病二:全局验证是粗放的一刀切。一次修订通常包含多条编辑,验证集分数没涨,整版丢弃——但里面可能只有一条编辑拖了后腿,其他几条明明是有效的修正。反过来,有些编辑的证据还不够充分,需要更多经验积累才能判断,一轮定生死太草率。
作者先做了两个预备实验,把这两个毛病量化出来,这也是全文我最喜欢的部分——不是拍脑袋说"现有方法不行",而是拿数据说话。
预备实验一:轨迹提炼的编辑,重跑一遍多少真的有效?
把 Trace2Skill 生成的编辑应用到原始技能上,然后在当初触发这些编辑的任务上重新执行,看行为结果。
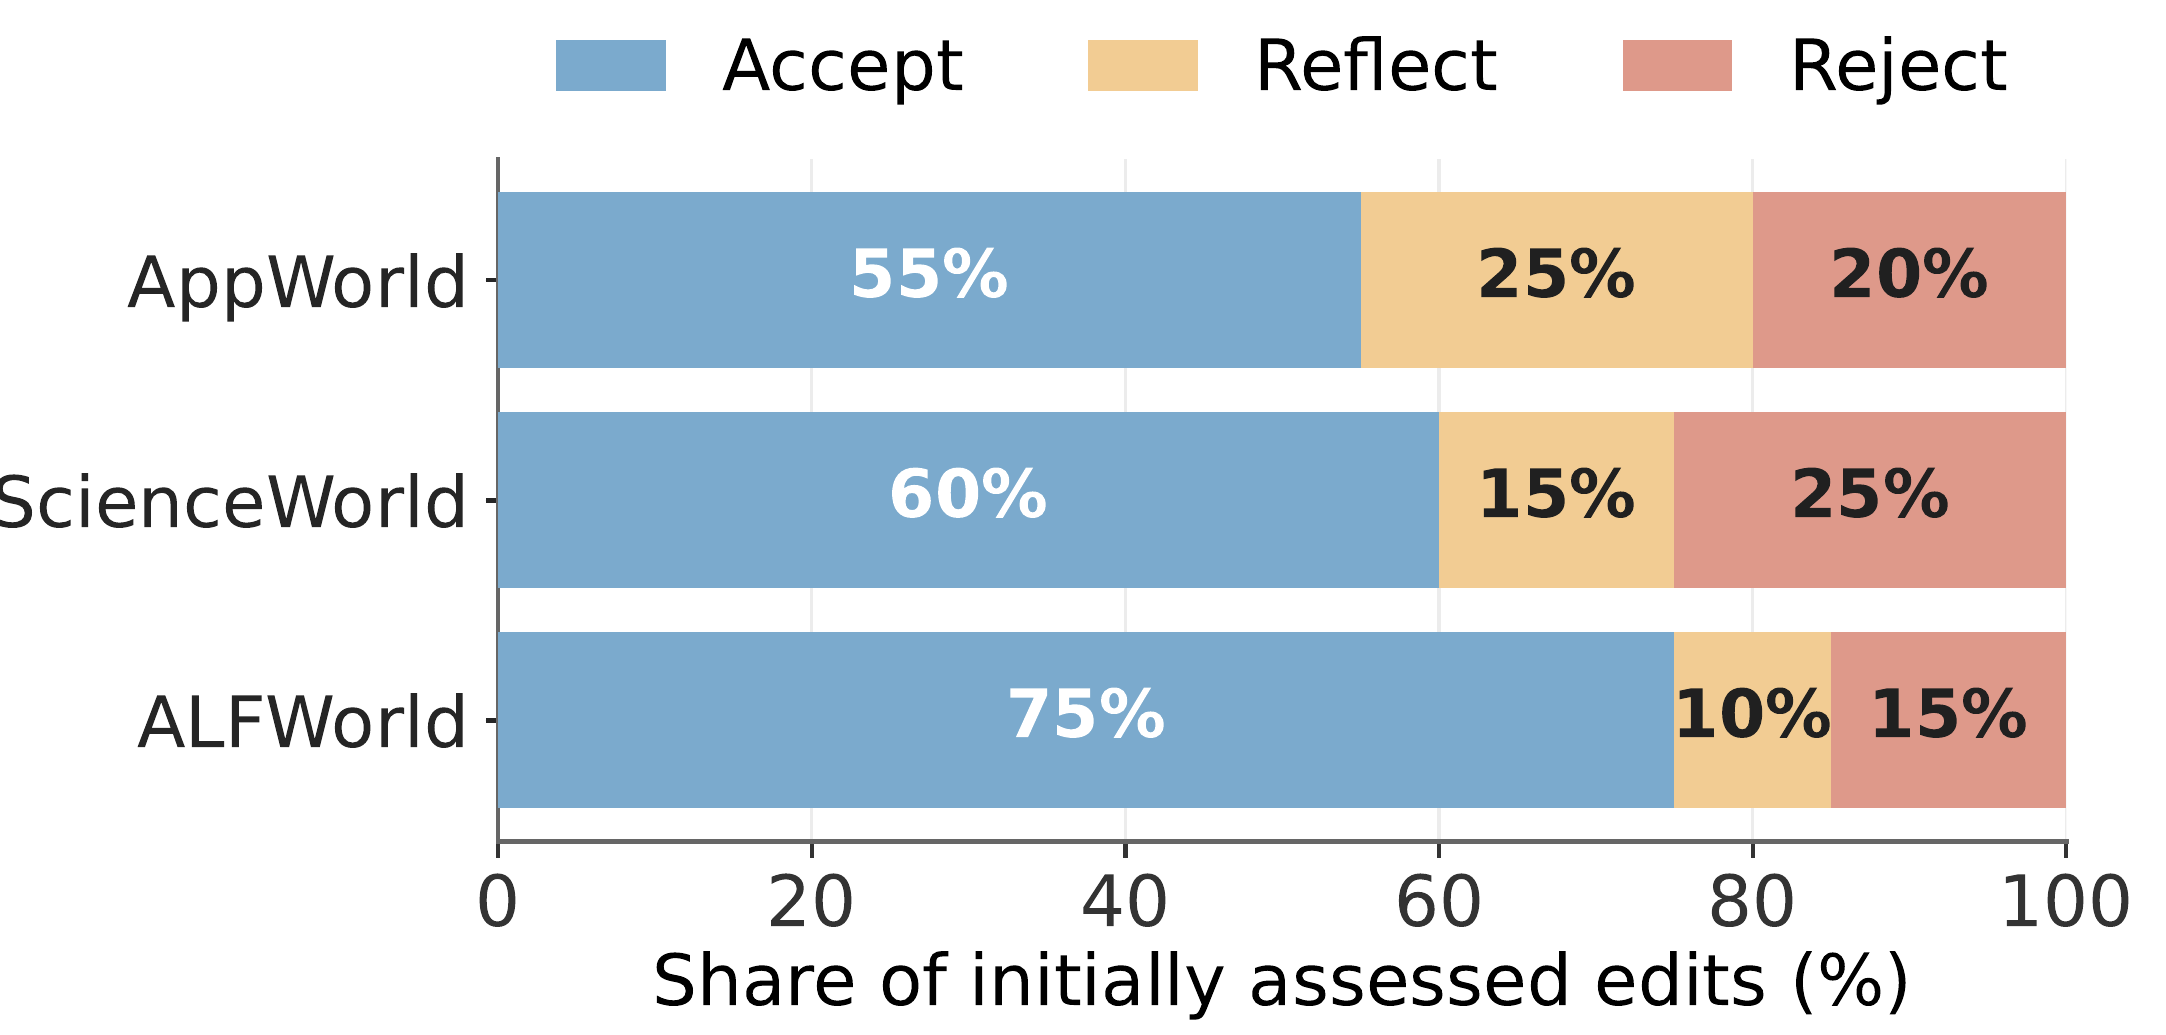
图2:Trace2Skill 编辑在原始任务上重执行的结果分布。ALFWorld 上 75% 的编辑确实改善了行为,但 AppWorld 只有 55%,ScienceWorld 60%——也就是说 25% 到 45% 的"经验总结"重跑一遍要么没用、要么起反作用。
看到这个数的时候我停了一下。将近一半的编辑是"看起来合理但跑起来不对"——这跟我们平时让 LLM 总结经验的直觉完全吻合:它很会讲出一个自洽的故事,但故事和真实行为改变之间隔着一条鸿沟。
预备实验二:被拒的修订里藏着多少好东西?
反过来,把全局验证拒绝掉的修订拆开,只保留其中部分编辑,效果怎样?
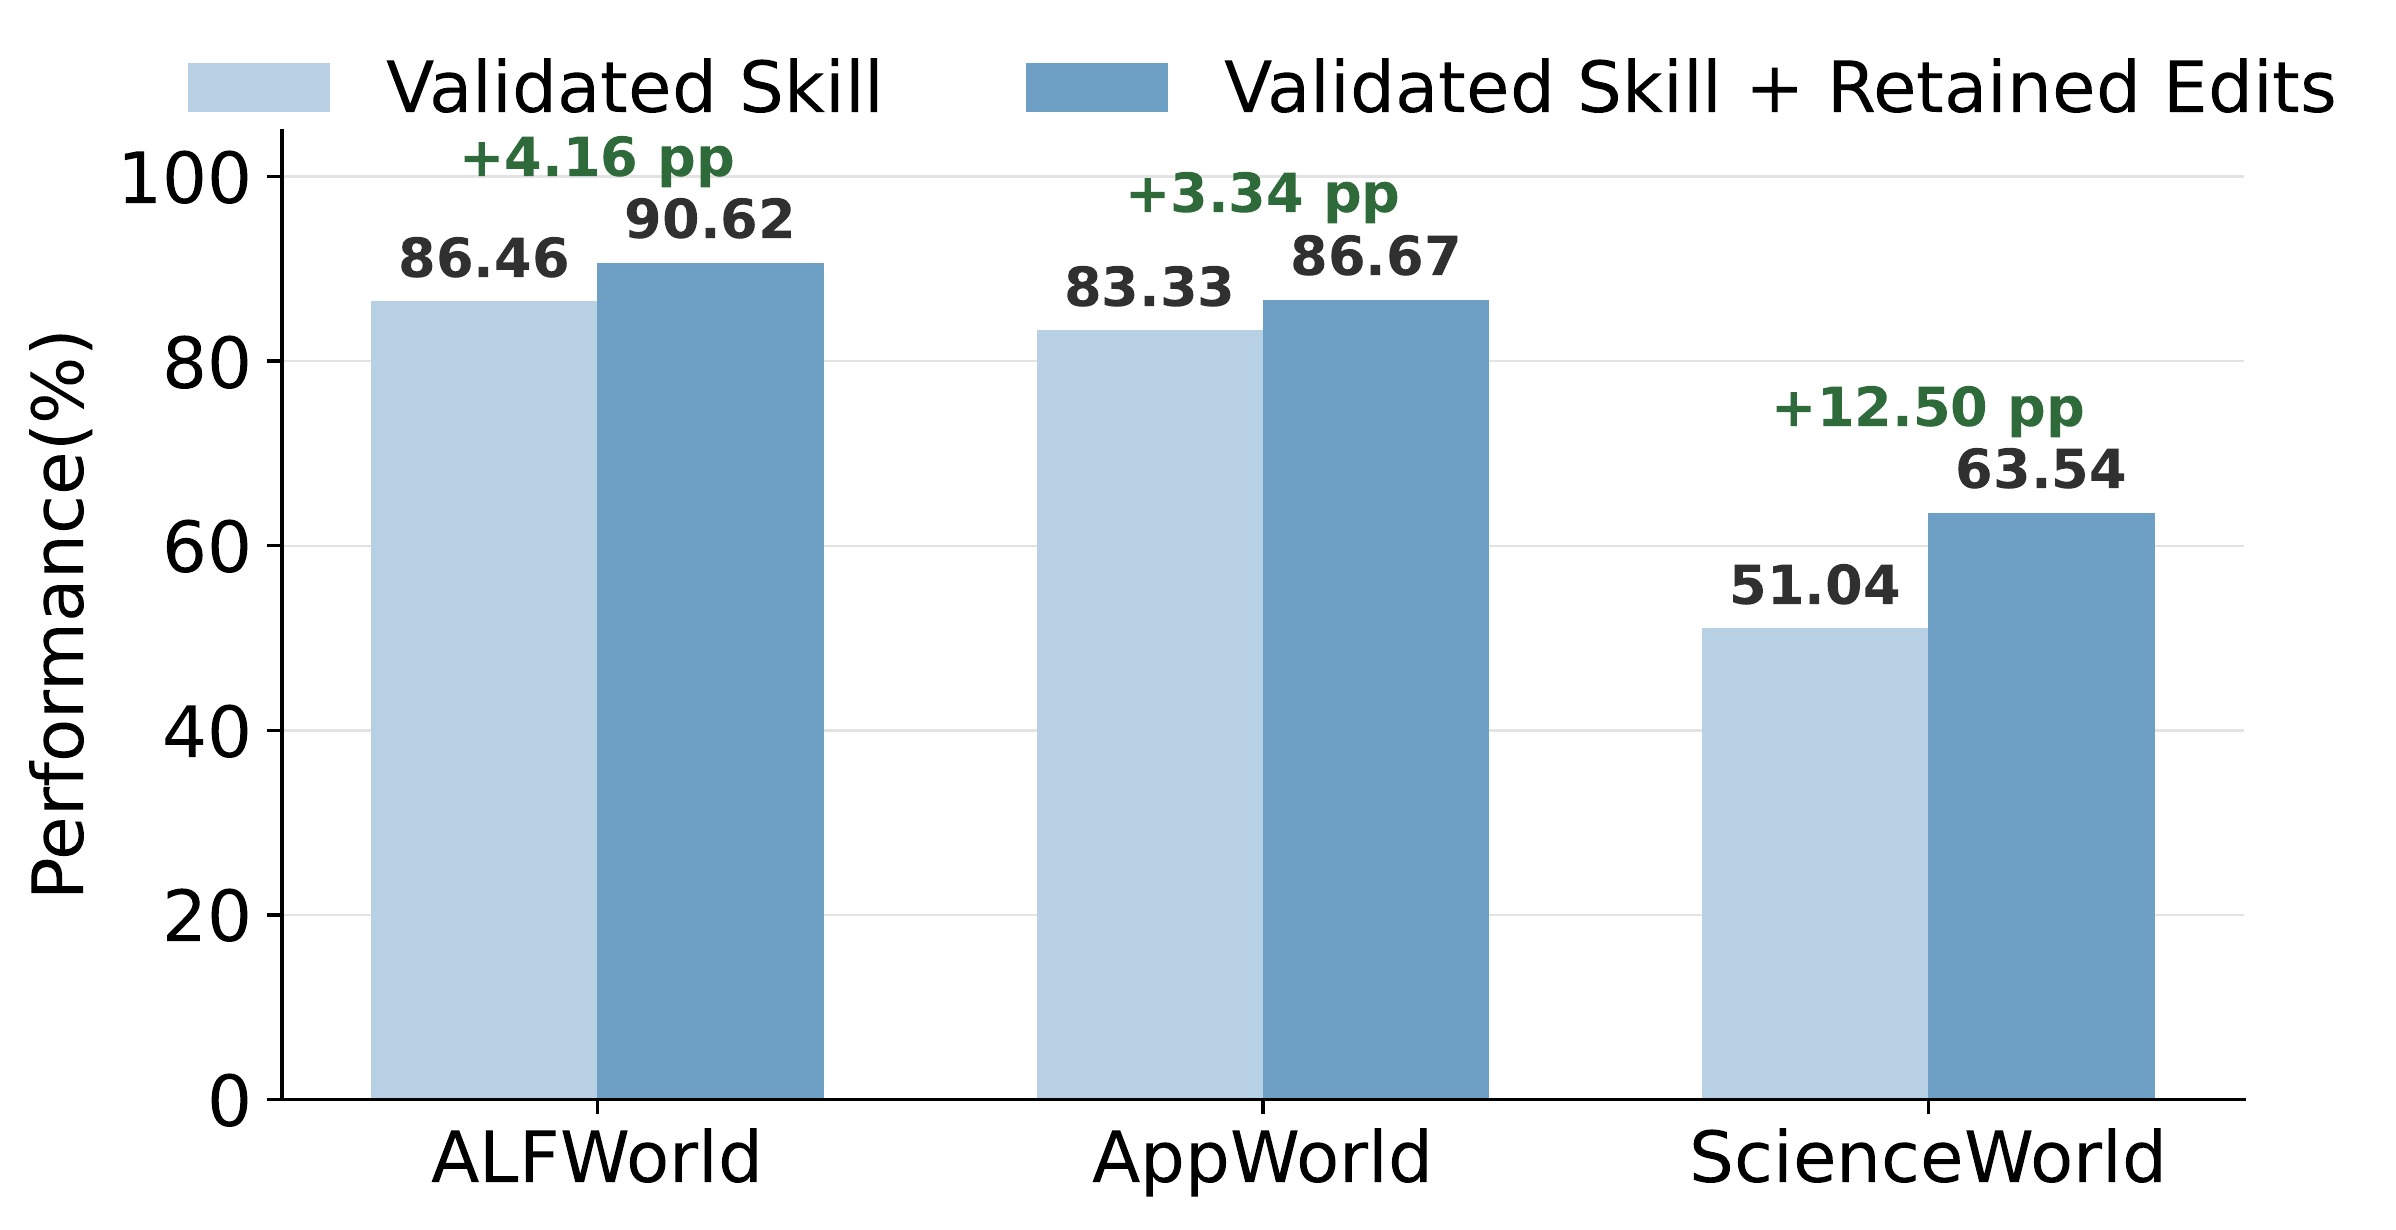
图3:Validated Skill(浅蓝) vs Validated Skill + 从被拒修订里挑出的保留编辑(深蓝)。ALFWorld 从 86.46 涨到 90.62(+4.16 个点),AppWorld 从 83.33 涨到 86.67(+3.34 个点),ScienceWorld 从 51.04 涨到 63.54——涨了 12.5 个点。
12.5 个点。就这么被"整版拒绝"的规则扔掉了。这两个实验合在一起,论点就很硬了:一条编辑不会因为来自经验就天然有效,也不会因为所在修订被拒就天然无效。判断的单位应该下沉到单条编辑,而判断的依据应该是可回放的执行证据。
🏗️ 方法:EviSkill 的三阶段流水线
EviSkill 的核心思想一句话:每条编辑都带证据出生,靠回放验证上岗,跨轮次接受再审查。整个框架围绕一个叫"可回放证据卡"的数据结构展开,组织成三个阶段。

图4:EviSkill 三阶段流水线与跨轮次携带机制。Phase 1 从当前轨迹和跨轮次轨迹对中抽证据卡、合成候选编辑;Phase 2 在触发区间上回放验证编辑,给出 accept/reflect/reject 判决;Phase 3 全局验证管最终入库,被拒后还有一轮"拒绝后回放"挑出有局部支持的编辑挂账保留。底部图例标出了 Validated Skill、Provisional Edit Ledger、三类证据卡和 Tracked Edit 等核心概念。
阶段一:证据落地的编辑合成
先区分两个技能状态:Validated Skill \(S_e^V\) 只有全局验证通过才更新,是"正式版";Working Skill \(S_e^W\) 是"开发版",在正式版基础上叠加一个临时编辑账本:
其中 \(P_e\) 是 Provisional Edit Ledger——那些局部回放支持过、但还没被全局验证接纳的编辑,按序叠加进来参与后续训练和再修订。这个设计很聪明:它让"还没转正但有潜力"的编辑继续在实际执行中接受检验,而不是晾在一边。
每个 epoch,智能体用 Working Skill 在训练任务集上跑轨迹。然后证据抽取器 \(f^{ext}\) 从两类来源抽证据卡:
- 轨迹证据卡:直接从当前轨迹里提炼修正建议;
- 对比证据卡:针对正在被追踪的编辑(Tracked Edits \(\mathcal{Q}_e\)),把相邻两个 epoch 在同一批任务上的完整轨迹对拉出来对比,识别"改了但没改好"的持续缺陷。
一张证据卡定义为三元组 \(C_i = \langle i, \mathcal{G}_i, d_i \rangle\):持久 ID \(i\) 用于跨轮次追踪;\(\mathcal{G}_i\) 是支持触发区间集合,每个区间 \(g=(x, e_g, s, t)\) 精确指向任务 \(x\) 在第 \(e_g\) 轮轨迹的第 \(s\) 到 \(t\) 步;\(d_i\) 是提议的修正内容。注意这个区间指针是全文最关键的机械设计——它让任何一条编辑都能随时回到"案发现场"重建执行状态。
活跃证据卡按来源上下文和修正意图分组进 Evidence Window,编辑器 \(f^{edit}\) 在每个窗口内合成候选编辑,同时保留编辑到卡片的链接。到这一步,编辑不再是一句漂浮的"以后记得先查天气再订机票",而是带着"这条建议来自任务 A 第 3 轮轨迹的第 12-18 步,当时 agent 直接调了订机票 API 导致日期错乱"的完整卷宗。
阶段二:回放引导的编辑验证
这是整个框架的"法庭质证"环节。对每条候选编辑 \(u\),系统取出它支持卡里的所有触发区间,把原轨迹前缀原样复制过来重建现场,然后让智能体在 \(S_e^W \oplus u\) 下只重跑 \([s, t]\) 这一段——不用重跑整条轨迹,这个局部化设计后面效率分析里会看到省了很多计算。
评估器 \(f^{eval}\) 对比源片段和回放片段,给出三选一判决:
- accept:回放支持预期修正且没引入新失败;
- reflect:有局部缺陷但反馈可以指导修订——编辑器据此产出修订版 \(u'\),再回放再审一次;
- reject:直接否决。
只有 accept 的编辑(含反思后再审通过的)才能进入候选修订,合并后形成 \(\widetilde{S}_e\) 送去全局验证。
阶段三:跨轮次证据传播
全局验证的规则很简单粗暴:验证集分数涨了就整体接纳,没涨就保持原样。EviSkill 没有动这个规则本身——它动的是拒绝之后发生的事。
修订被拒后,每条合并编辑会再走一轮"拒绝后回放",这次是在 \(S_e^V \oplus v\) 下验证——关键区别在于剥离了账本里的其他临时编辑,单独看它自己是不是有效的。通过局部检验的编辑进账本 \(P_{e+1}\) 挂账保留,下轮 Working Skill 继续带着它们跑;证据卡那边也有完整的生命周期管理:支持临时编辑的卡被保护起来不参与新合成但保留引用,被接纳编辑的卡归档,反复回放被拒的卡标记为陈旧。
整个过程跑完 \(E\) 轮后,最终的 Validated Skill 冻结用于测试集推理,没转正的临时编辑全部舍弃。
我的直觉评价:这套机制说到底就是给技能进化引入了"无罪推定+缓刑观察"——单条编辑只要局部证据扎实,就不会被一次全局失败株连;但也别想蒙混过关,每轮都要带着证据接受复查。比 SkillOpt 那种纯靠验证集分数投票的做法精细了一个量级。
🧪 实验:三个基准、六个骨干、18 组对照
实验设置:ALFWorld(134 个测试任务,文本家居环境)、AppWorld(168 个,API 应用操作)、ScienceWorld(211 个,科学实验)。训练/验证/测试严格不相交。六个 Action Agent 骨干:GPT-5.5、GPT-5.4、GPT-5.4-mini、Qwen3.6-35B-A3B、Qwen3.5-9B、Qwen3.5-4B。证据抽取、编辑、评估三个角色统一用 GPT-5.5。进化跑 4 个 epoch。基线分两组:非进化的 NoSkill 和 LLM Skill(固定初始技能),进化的 Trace2Skill、EvoSkill、SkillGrad、SkillOpt。
主实验表数字太多,挑代表性的四个骨干给你看 EviSkill 的准确率(括号内为相对 NoSkill 的点数变化):
| 骨干 | 基准 | NoSkill | 最强进化基线 | EviSkill | 相对 NoSkill |
|---|---|---|---|---|---|
| GPT-5.5 | ALFWorld | 90.30 | 95.52 (SkillGrad) | 96.27 | 涨 5.97 个点 |
| GPT-5.5 | AppWorld | 85.71 | 92.86 (SkillOpt) | 94.64 | 涨 8.93 个点 |
| GPT-5.5 | ScienceWorld | 76.30 | 80.09 (SkillOpt) | 83.41 | 涨 7.11 个点 |
| GPT-5.4 | ALFWorld | 75.37 | 94.78 (Trace2Skill/SkillOpt) | 95.52 | 涨 20.15 个点 |
| GPT-5.4 | ScienceWorld | 52.13 | 66.35 (LLM Skill) | 76.78 | 涨 24.64 个点 |
| Qwen3.5-9B | ALFWorld | 54.48 | 87.31 (SkillGrad) | 91.04 | 涨 36.57 个点 |
| Qwen3.5-9B | ScienceWorld | 8.53 | 22.27 (SkillOpt) | 37.91 | 涨 29.38 个点 |
| Qwen3.5-4B | ALFWorld | 43.28 | 84.33 (SkillGrad) | 85.07 | 涨 41.79 个点 |
| Qwen3.5-4B | ScienceWorld | 4.27 | 14.69 (SkillOpt) | 20.85 | 涨 16.59 个点 |
表1节选:EviSkill 在 18 个模型-数据集组合中 14 个第一、16 个前二,全部组合超过 NoSkill,平均涨 17.93 个点。
有几个细节值得说道。
一是进化基线经常打不过固定技能。GPT-5.5 在 ScienceWorld 上,初始 LLM Skill 有 76.78%,而 Trace2Skill、EvoSkill、SkillGrad 分别只有 65.40%、54.50%、67.30%——越进化越差。EvoSkill 在 ScienceWorld 上比无技能还低 21.8 个点,这个数相当难看。原因正是前面预备实验揭示的:无效的编辑被囫囵吞进去,有用的又被整版扔掉。EviSkill 在 17 个组合上超过 LLM Skill,剩 1 个打平,说明它把"保住已有知识"和"吸收新经验"这对矛盾处理得比较稳。
二是弱模型收益更大。Qwen 家族平均涨 22.85 个点,GPT 家族 13.00 个点。作者自己也很坦诚地指出,这部分是因为 Qwen 的无技能基线低、上升空间大,解读时要留个心眼。
三是 AppWorld 上优势不稳定,有 2 个组合没拿第一但也都超过 NoSkill——这个环境的任务类型杂,各进化方法的表现波动本来就大。
消融:两个组件各自值多少
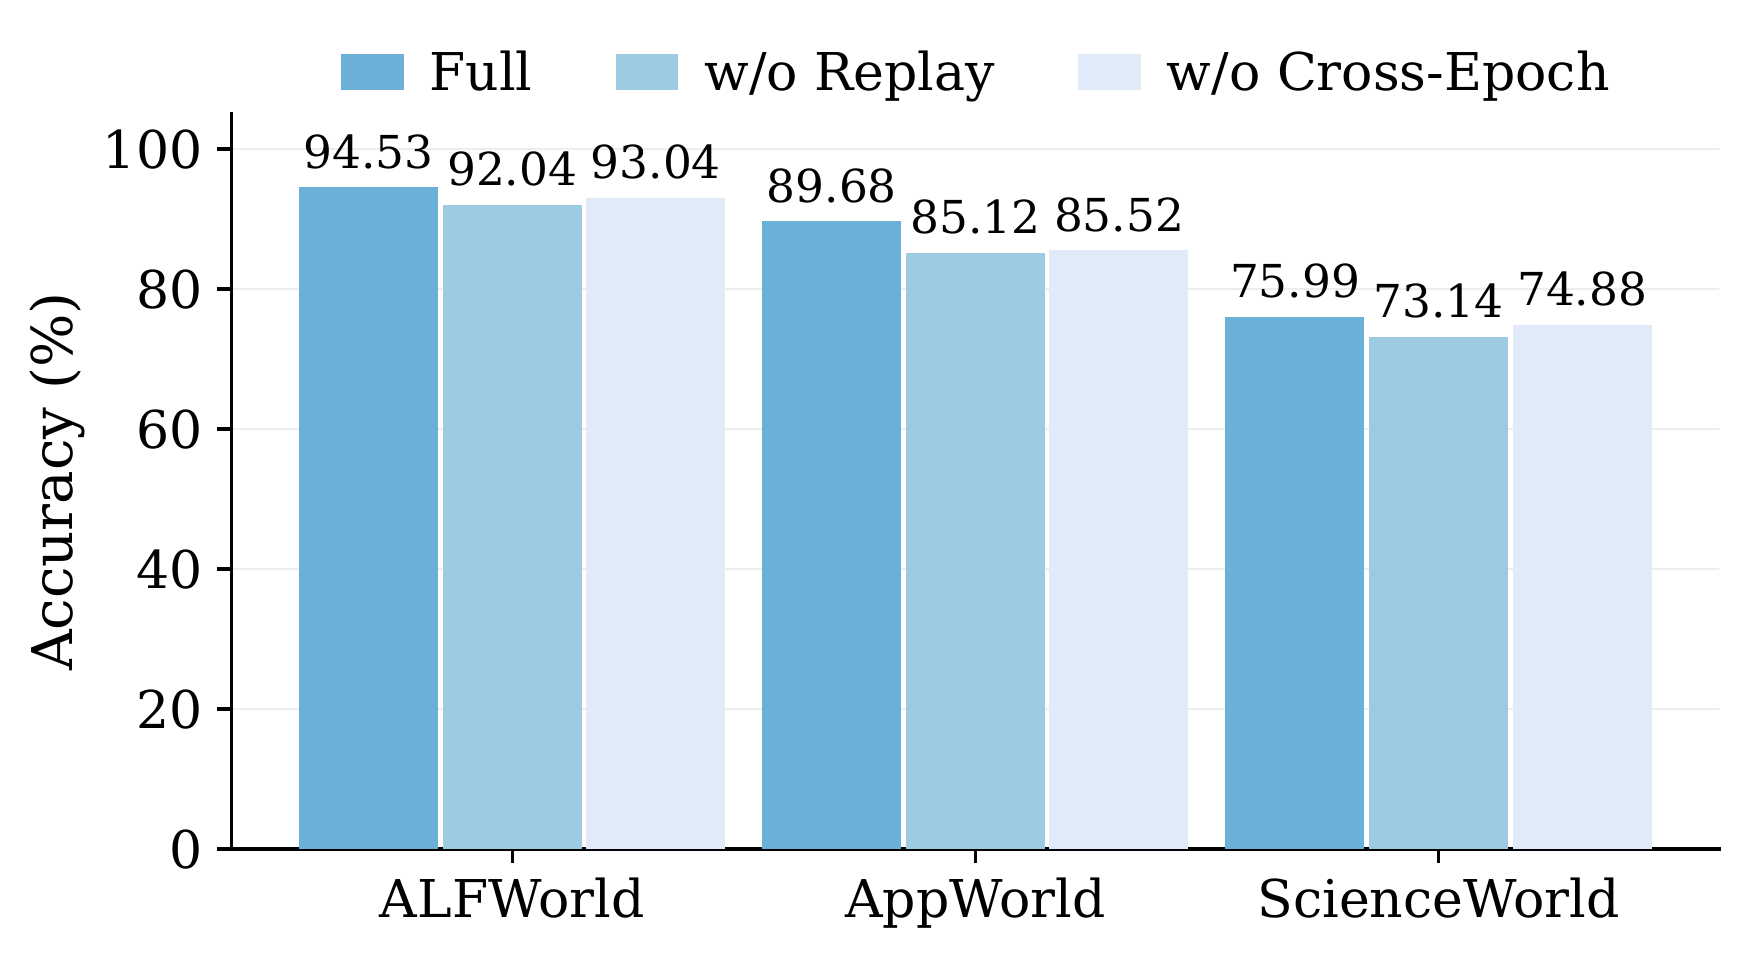
图5:Full(完整版)、w/o Replay(去掉回放验证)、w/o Cross-Epoch(去掉跨轮次传播)在三个基准上的 GPT 家族平均准确率。完整版全部最高。
去掉回放验证,ALFWorld/AppWorld/ScienceWorld 分别掉 2.49、4.56、2.85 个点;去掉跨轮次传播也全线下滑,AppWorld 从 89.68 掉到 85.52。有意思的是 Qwen 家族上的消融图案不一样:跨轮次传播的贡献反超回放验证(ALFWorld 掉 3.48 vs 2.24)。作者的解释是弱模型产生的候选编辑质量参差,多次审查和证据复用的收益更大——这个解释合理,但也暗示这套框架的价值和基座能力负相关,GPT-5.5 这种强模型上两个组件的边际收益都在收窄。
作者还把跨轮次传播拆成两条通路单独消融(ALFWorld + Qwen 家族):只保留未解决的证据卡涨 1.74 个点,只保留临时编辑涨 2.24 个点,两者都要的完整版 88.06%,比任一单通路再高 1 个多点。两条通路是互补的,不是重复建设。
机制分析:回放到底拦下了什么
这部分是全文最硬核的证据链,作者分析了 18 次完整运行、72 个 epoch 的编辑流转数据。
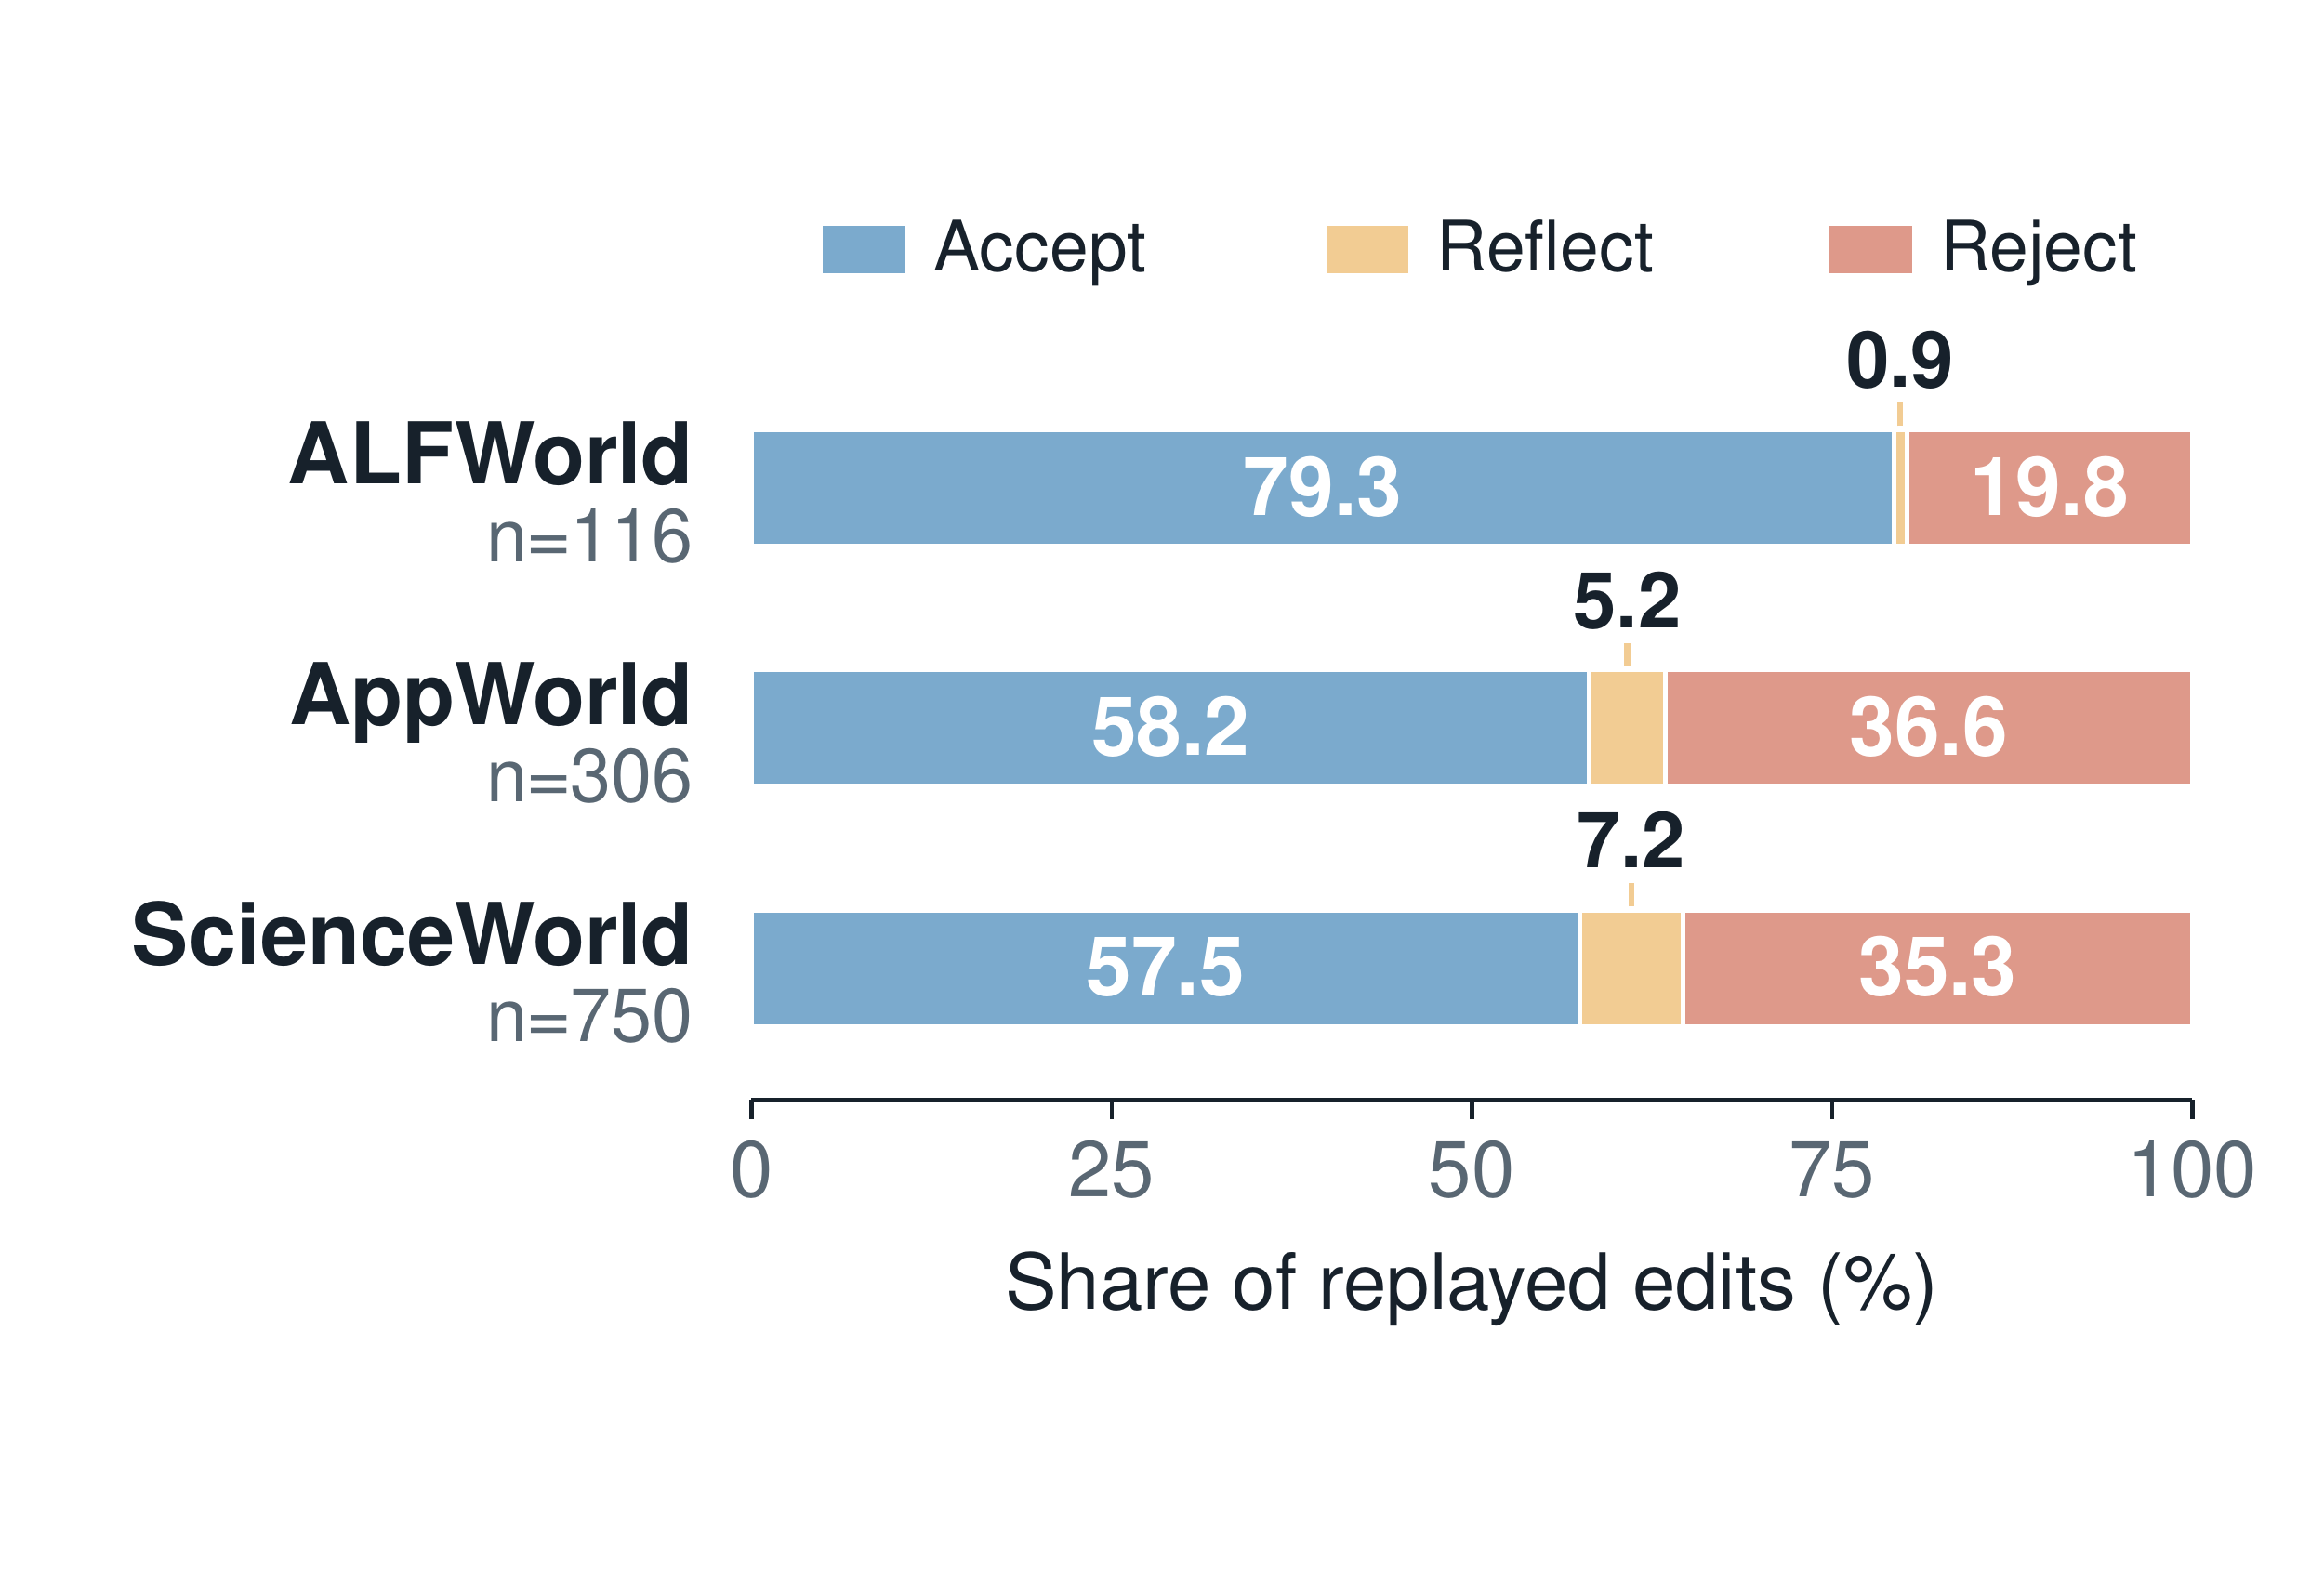
图6a:初次回放判决分布。ALFWorld(n=116)79.3% 直接通过;AppWorld(n=306)58.2% 通过、41.8% 被反思或拒绝;ScienceWorld(n=750)57.5% 通过、42.5% 被反思或拒绝。
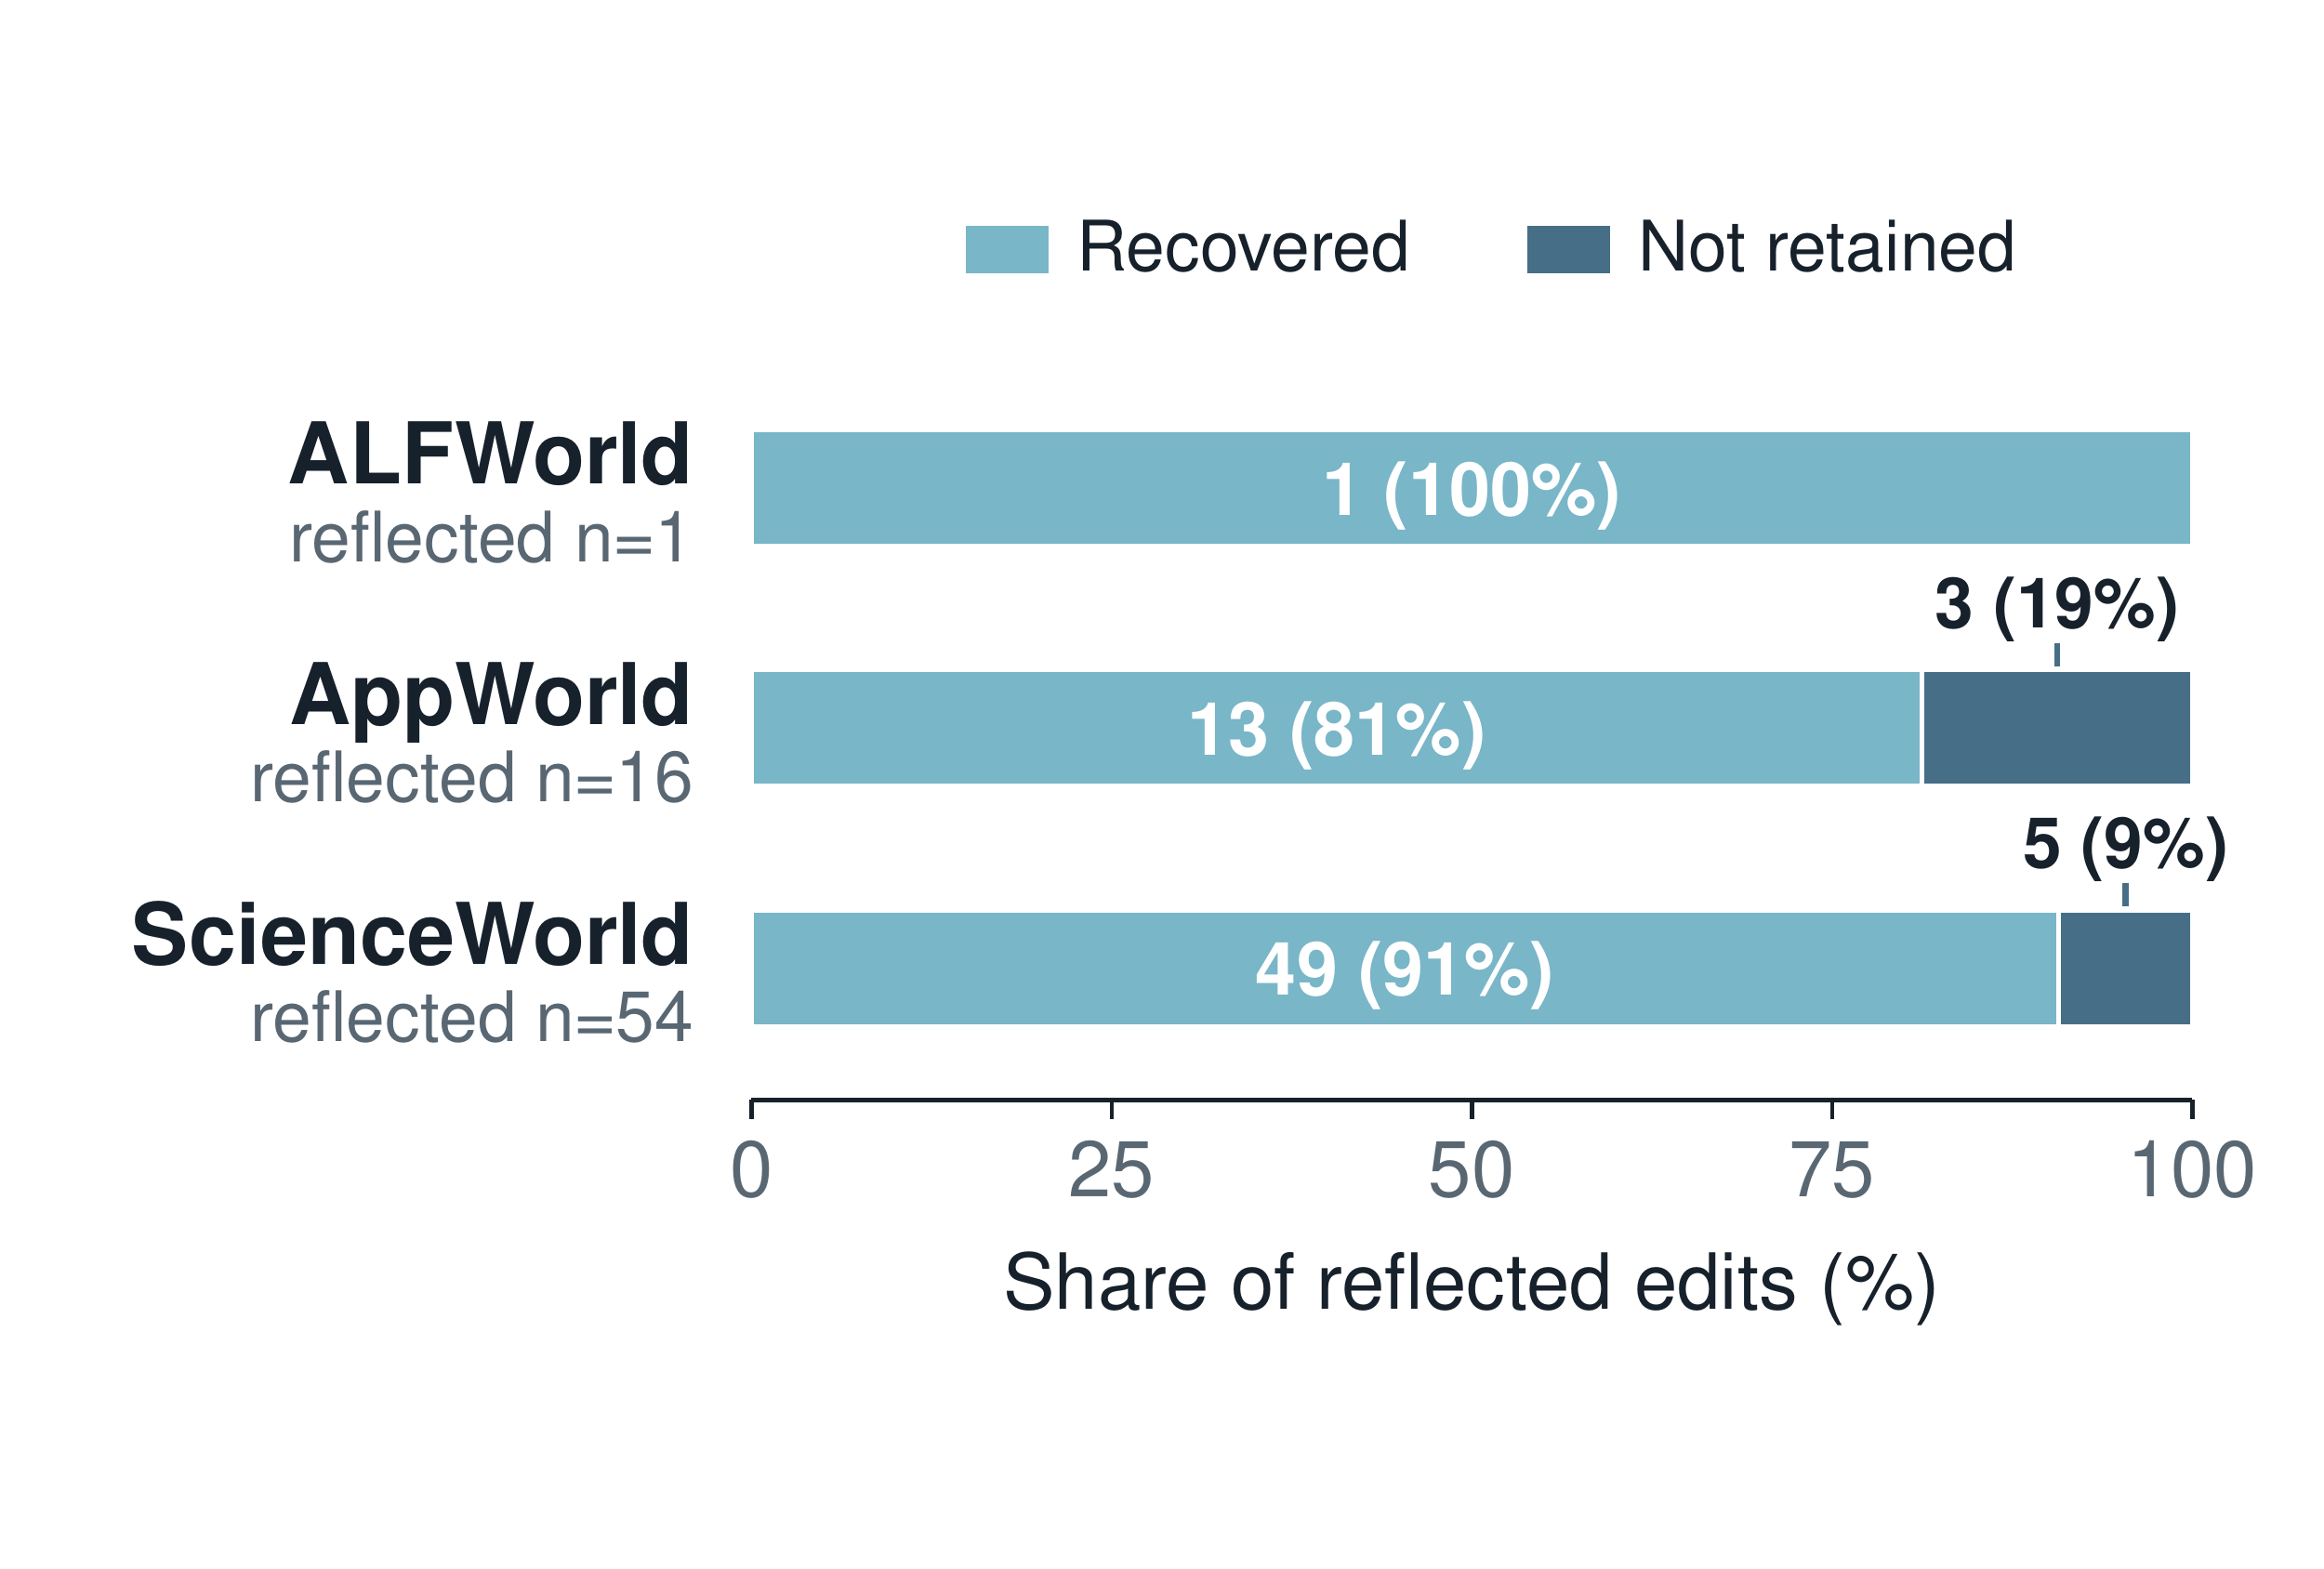
图6b:被判 reflect 的编辑经反馈修订后,ALFWorld 1/1 全部救回,AppWorld 13/16(81%)救回,ScienceWorld 49/54(91%)救回。
两张图合起来讲了一个完整的故事:四成左右的候选编辑第一次回放就露馅——证据落地不等于行为有效;但被判"反思"的编辑里,八九成能靠反馈修订救回来。回放既是过滤器也是维修台。这里要提醒一句:救回率的分母是被挑出来给反思机会的子集,不是所有未通过编辑,作者自己也标注了这一点,没有夸大。
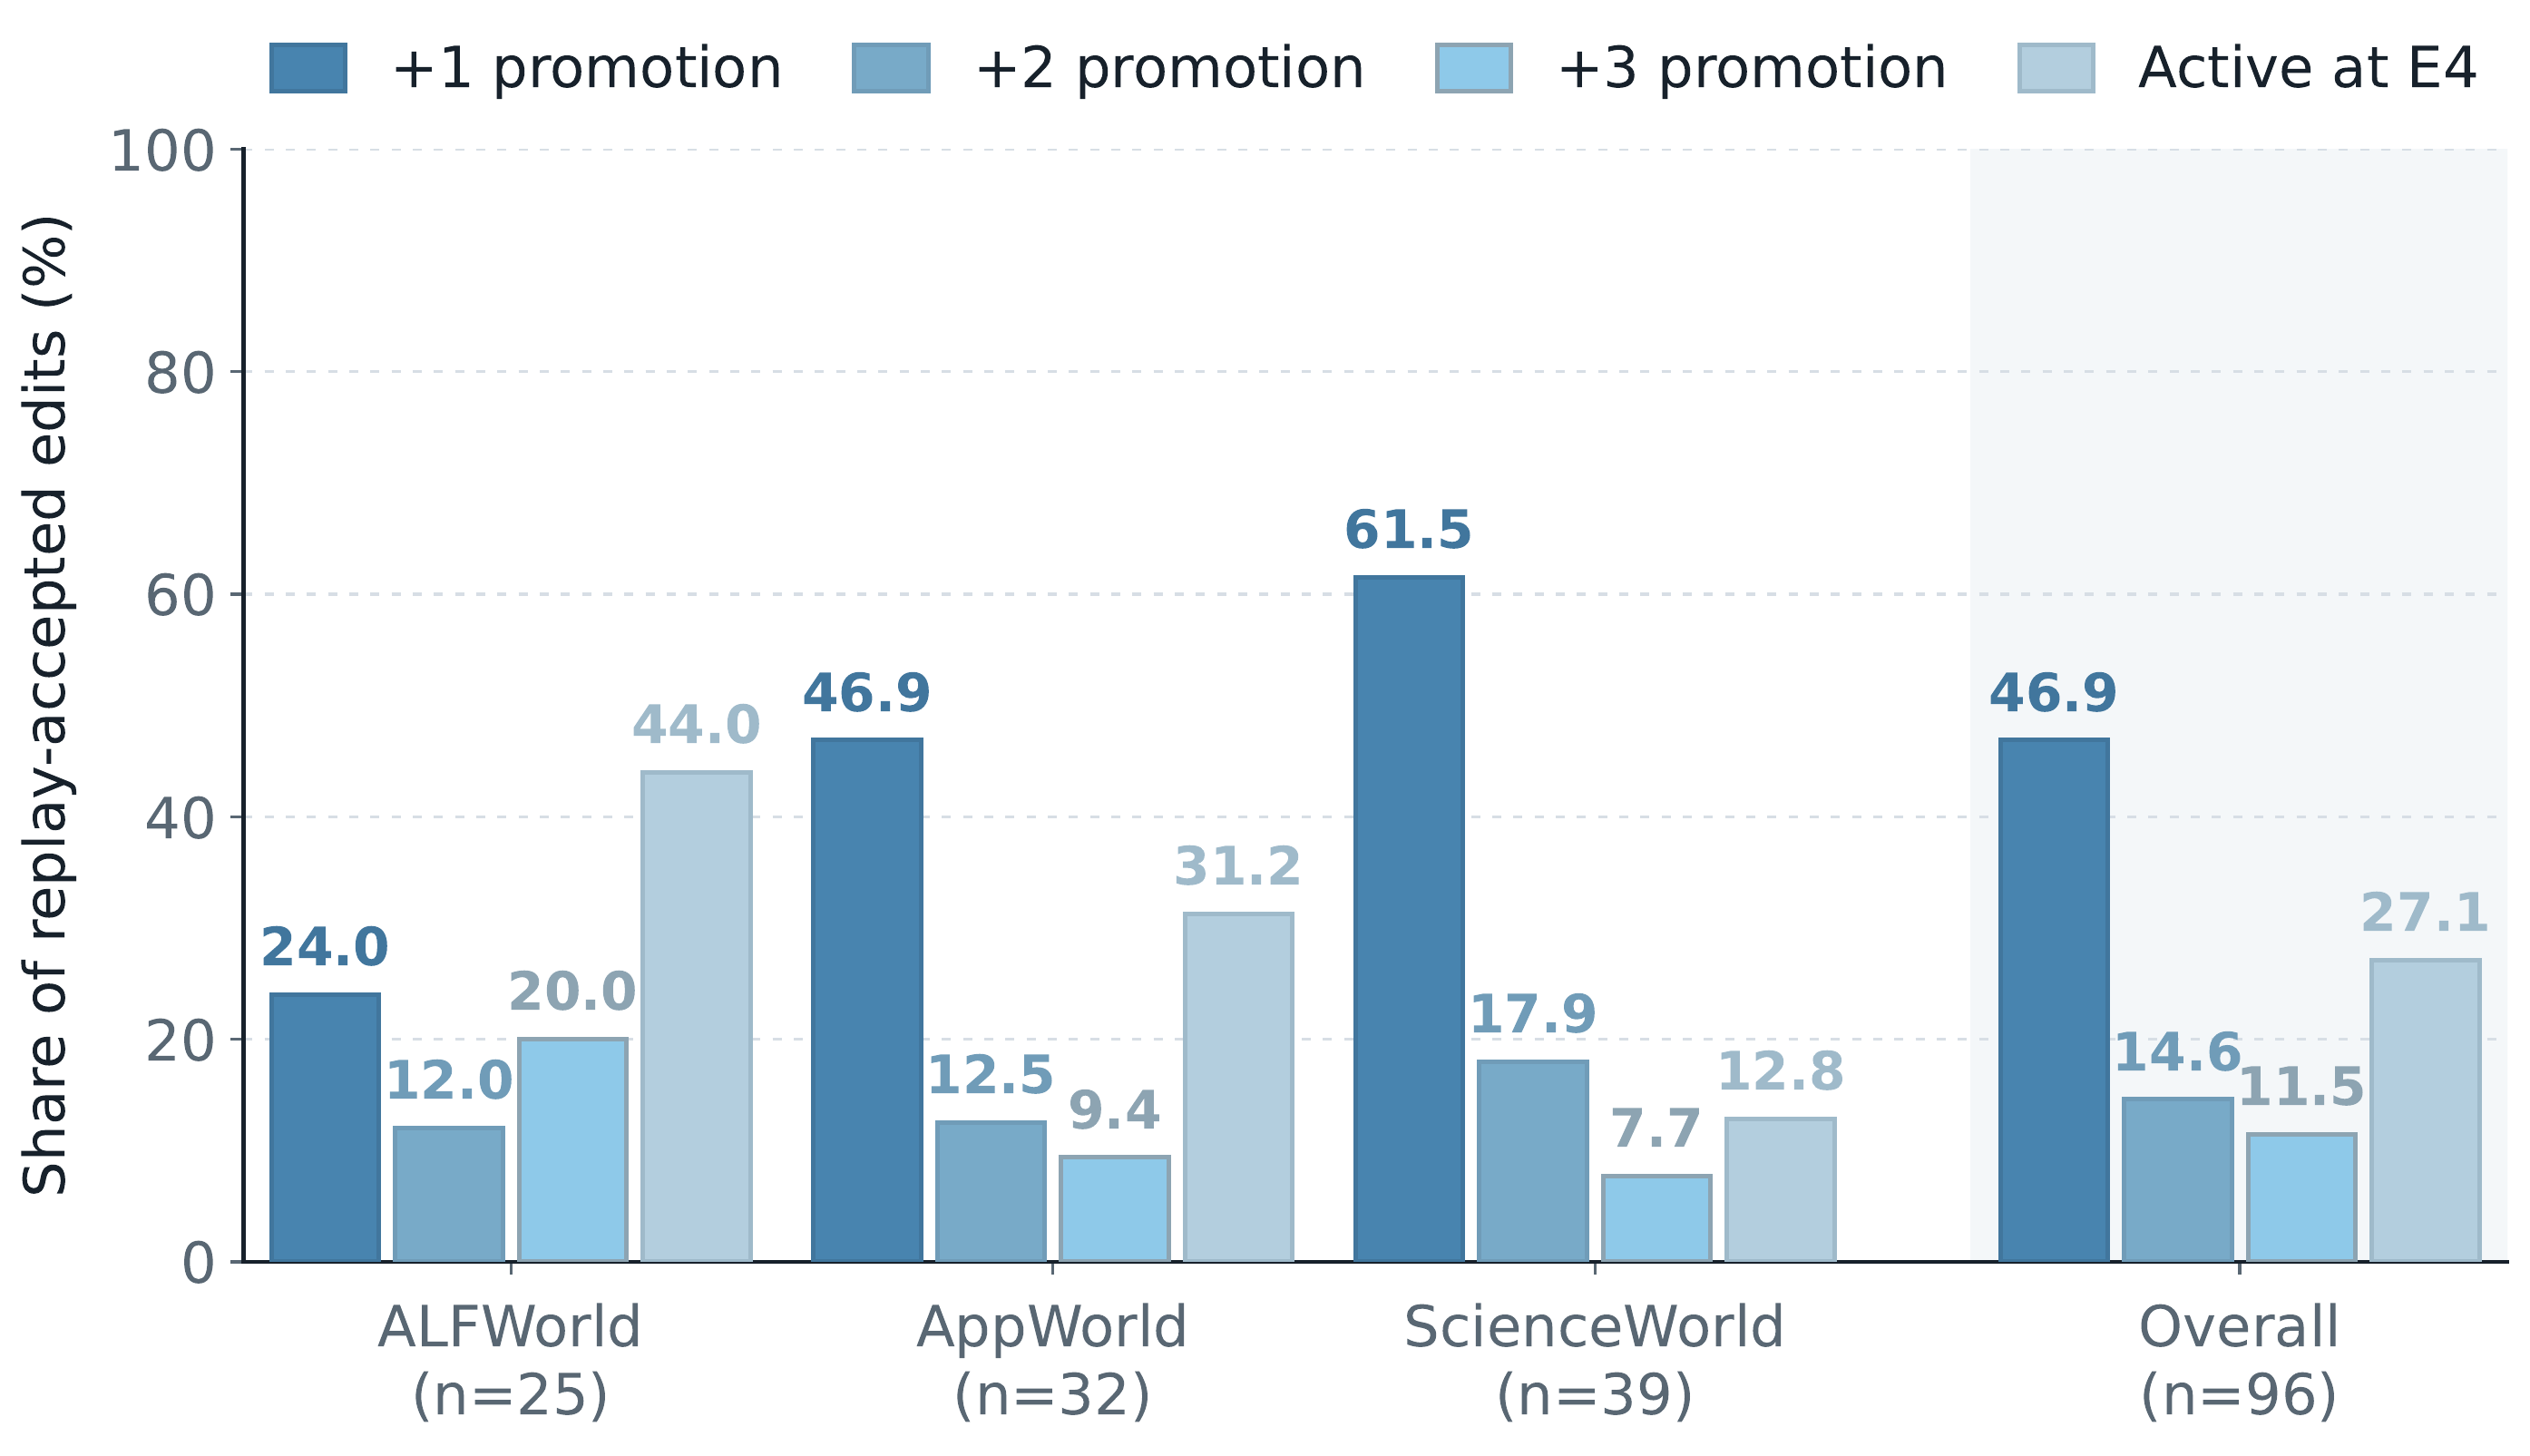
图7:96 条在拒绝后回放中被保留的临时编辑,46.9% 在下一轮转正进 Validated Skill,14.6% 隔两轮,11.5% 隔三轮——72.9% 最终修成正果,剩 27.1% 在第四轮结束时还在观察期。
72.9% 这个数字直接回击了"整版拒绝"的粗放规则:被全局验证否决的修订里,被局部证据支持的编辑大多数后来被证明是对的。如果按老方法整桶倒掉,这些修正就永远丢了。
证据卡那边的复用数据也不错:23.0% 的证据卡在至少两个不同 epoch 被选进 Evidence Window 参与合成,54.3% 只被选一次。ALFWorld 上 66.6% 的卡是"pre-resolved"(不用进窗口就被解决),说明简单环境的证据消化快;AppWorld 和 ScienceWorld 的跨轮复用比例明显更高。
效率:回放不是免费的,但局部化省了一大块
看到这套机制我第一反应是成本——每轮都要重建现场重跑片段,token 开销会不会爆炸?作者附录里给了两组数。
一是经验转化率:每 100 次训练 rollout 换来的验证集收益,EviSkill 是 3.77 个点,EvoSkill 1.55,SkillGrad 0.84。同样的交互预算,EviSkill 榨出的进化收益是 SkillGrad 的 4 倍多。
二是局部回放的节流效果:证据窗口回放只执行了 18,007 步,如果整轨迹回放要 53,242 步,省了 66.18%;拒绝后回放从 3,863 步压到 1,205 步,省 68.81%。触发区间指针这个设计在这里变现了——不用为验证一条编辑重跑整条轨迹。
🤔 我的判断
这篇论文最值钱的地方,是把技能进化里"编辑的有效性"这个一直含混处理的问题,拆成了三个可以分别回答的子问题:改什么(证据卡绑定现场)、为什么改得对(回放验证行为)、什么时候转正(全局验证+挂账观察)。任何一个单独看都不新鲜——重放验证在 Voyager 时代就有雏形,验证集准入在 SkillOpt 里也有——但把它们缝成一套自洽的证据生命周期管理,并用预备实验先把痛点钉死,这个工程完成度很高。
但有几个地方我觉得要泼点冷水。
第一,回放验证的前提是现场可重建。这套机制依赖把轨迹前缀复制过来重跑,要求环境本身可重置、可重入。ALFWorld、AppWorld、ScienceWorld 都是这类沙盒环境,但你想想真实场景——发出去的邮件、扣掉的款、写进生产数据库的记录,哪来的"重放"?这套范式往真实业务 agent 上迁移时,证据卡可以照抄,回放验证这环得换成别的东西,比如影子环境或干跑模式。论文没有讨论这个边界,是个明显的留白。
第二,三个裁判角色(抽取、编辑、评估)全是 GPT-5.5,用强模型当裁判审弱模型的编辑,这套 pipeline 的成本结构决定了它更适合离线技能打磨,而不是在线实时进化。附录 F 的效率分析只算了环境步数,没算 LLM 调用 token——说实话这块才是大头,我有点好奇但没地方查证。
第三,4 个 epoch 的预算挺短。27.1% 的挂账编辑到结束还没转正,它们的命运未知。如果跑到 8 轮、12 轮,账本会膨胀到什么规模?陈旧卡标记规则能不能压住噪声累积?这些长程问题一篇论文回答不完,但决定了这套机制在"持续运行几个月"的真实部署里会不会退化。
跟同期工作摆在一起看:Trace2Skill 是"提炼派",SkillGrad 是"梯度派",SkillOpt 是"验证集投票派",EviSkill 是"证据司法派"。它不生产新的经验来源,而是把经验到知识的转化过程管得更严。在 Agent Skills 已经成为工业标准、skill 自动生成质量又被广泛吐槽的当下,这种"治理层"的工作我认为比再提一个生成方法更解渴。
如果你在做智能体技能库或经验记忆系统,有三个设计可以直接拿走:编辑与证据的持久化绑定(ID+轨迹区间指针)、accept/reflect/reject 三态回放判决(reflect 给了编辑第二次生命,救回率八九成)、以及被拒修订的"缓刑账本"机制。就算不照搬整套框架,单是"别让一次全局失败株连局部有效的编辑"这条原则,就值回阅读时间了。
📚 参考
- 论文:https://arxiv.org/abs/2610.05030
- 代码:https://github.com/Zhouyaner/eviskill
- 相关工作:Trace2Skill、EvoSkill、SkillGrad、SkillOpt、Voyager(技能库)、Agent Skills 开放标准
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我