给 Agent 的经验也做一次 BPE:X-Tree 把轨迹"分词"成技能树,零 LLM 调用换来 4-6 个点的泛化提升
做 Agent 训练的人大概都有过这种感觉:辛辛苦苦收集了几千条轨迹,SFT 一训、GRPO 一跑,模型好像学了,又好像没学透。同一段"先填日期再点 Apply"的操作,在第一百条轨迹里出现过,在第一千条里也出现过,但训练目标压根不知道这件事——它把每个 token 一视同仁地平摊过去。
这篇 X-Tree 论文(arXiv:2609.32993)问了一个很朴素的问题:文本进模型之前要先过 BPE 分词器,把反复共现的字符对合并成词表;那为什么经验进训练之前,不能也"分词"一次,把反复出现、并且经常出现在成功 episode 里的动作序列合并成技能?
核心摘要:作者把 BPE 的思想平移到 Agent 轨迹上——先把每个原子动作规整化成 typed token(动词+角色),再用一个叫 \(\mathcal{X}\)-Score 的指标(频次 × 长度 × 成功率)贪心合并相邻符号,递归长出一棵可复用经验树 X-Tree。整个过程纯计数、确定性、零 LLM 调用。然后这棵树以三种方式进入训练:offline RL 里当训练实例、online RLVR 里当自适应奖励加成、OPSD 里当自蒸馏教师的特权上下文。在 WebArena、ScienceWorld、WebShop 三个环境、1.5B 到 7B 三个规模上,同数据同预算下最多提升 WebArena 4.5 个点的 SR、ScienceWorld 5.8 个点、WebShop 4.1 个点的成功率。我的判断:这不是底层突破,但属于那种"怎么想都该有人做"的干净想法,而且消融做得相当扎实,值得做 Agent 后训练的人细读。
📖 论文信息
- 标题:X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
- 作者:Sitao Cheng、Xunjian Yin、Zhiyuan Sun、Yuxuan Li、Ruiwen Zhou、Xiangru Jian、Victor Zhong
- 机构:University of Waterloo、Duke University、National University of Singapore
- 链接:https://arxiv.org/abs/2609.32993 (2026 年 9 月 26 日提交)
- 代码:https://github.com/sitaocheng/X-Tree/
- 主页:https://sitaocheng.github.io/xtree/
🎯 问题动机:经验很贵,但训练在用"平铺"的方式消费它
先想清楚这篇论文针对的痛点是不是真的存在。
多步 Agent 的训练数据是轨迹:一串动作加观测。但不管是 SFT 还是 RLVR,目标函数对轨迹里的每个 token 等权重。问题在于,轨迹内部是有层次结构的——"填起始日期 → 填结束日期 → 点 Apply"这种子程序会在不同任务里反复出现。人类学习者恰恰是靠这种层级来规划的:从目标到子目标再到原子动作。训练目标看不见这层结构,就等于每条轨迹只被利用了一部分。
而经验恰恰是稀缺资源。一条轨迹要么人手工采,要么模型合成再加 verifier 验证,环境要搭、任务要写、奖励要调。这跟网页文本的获取成本完全不是一个量级。所以"如何从固定的一池经验里榨出最多信号"是个真问题,不是伪命题。
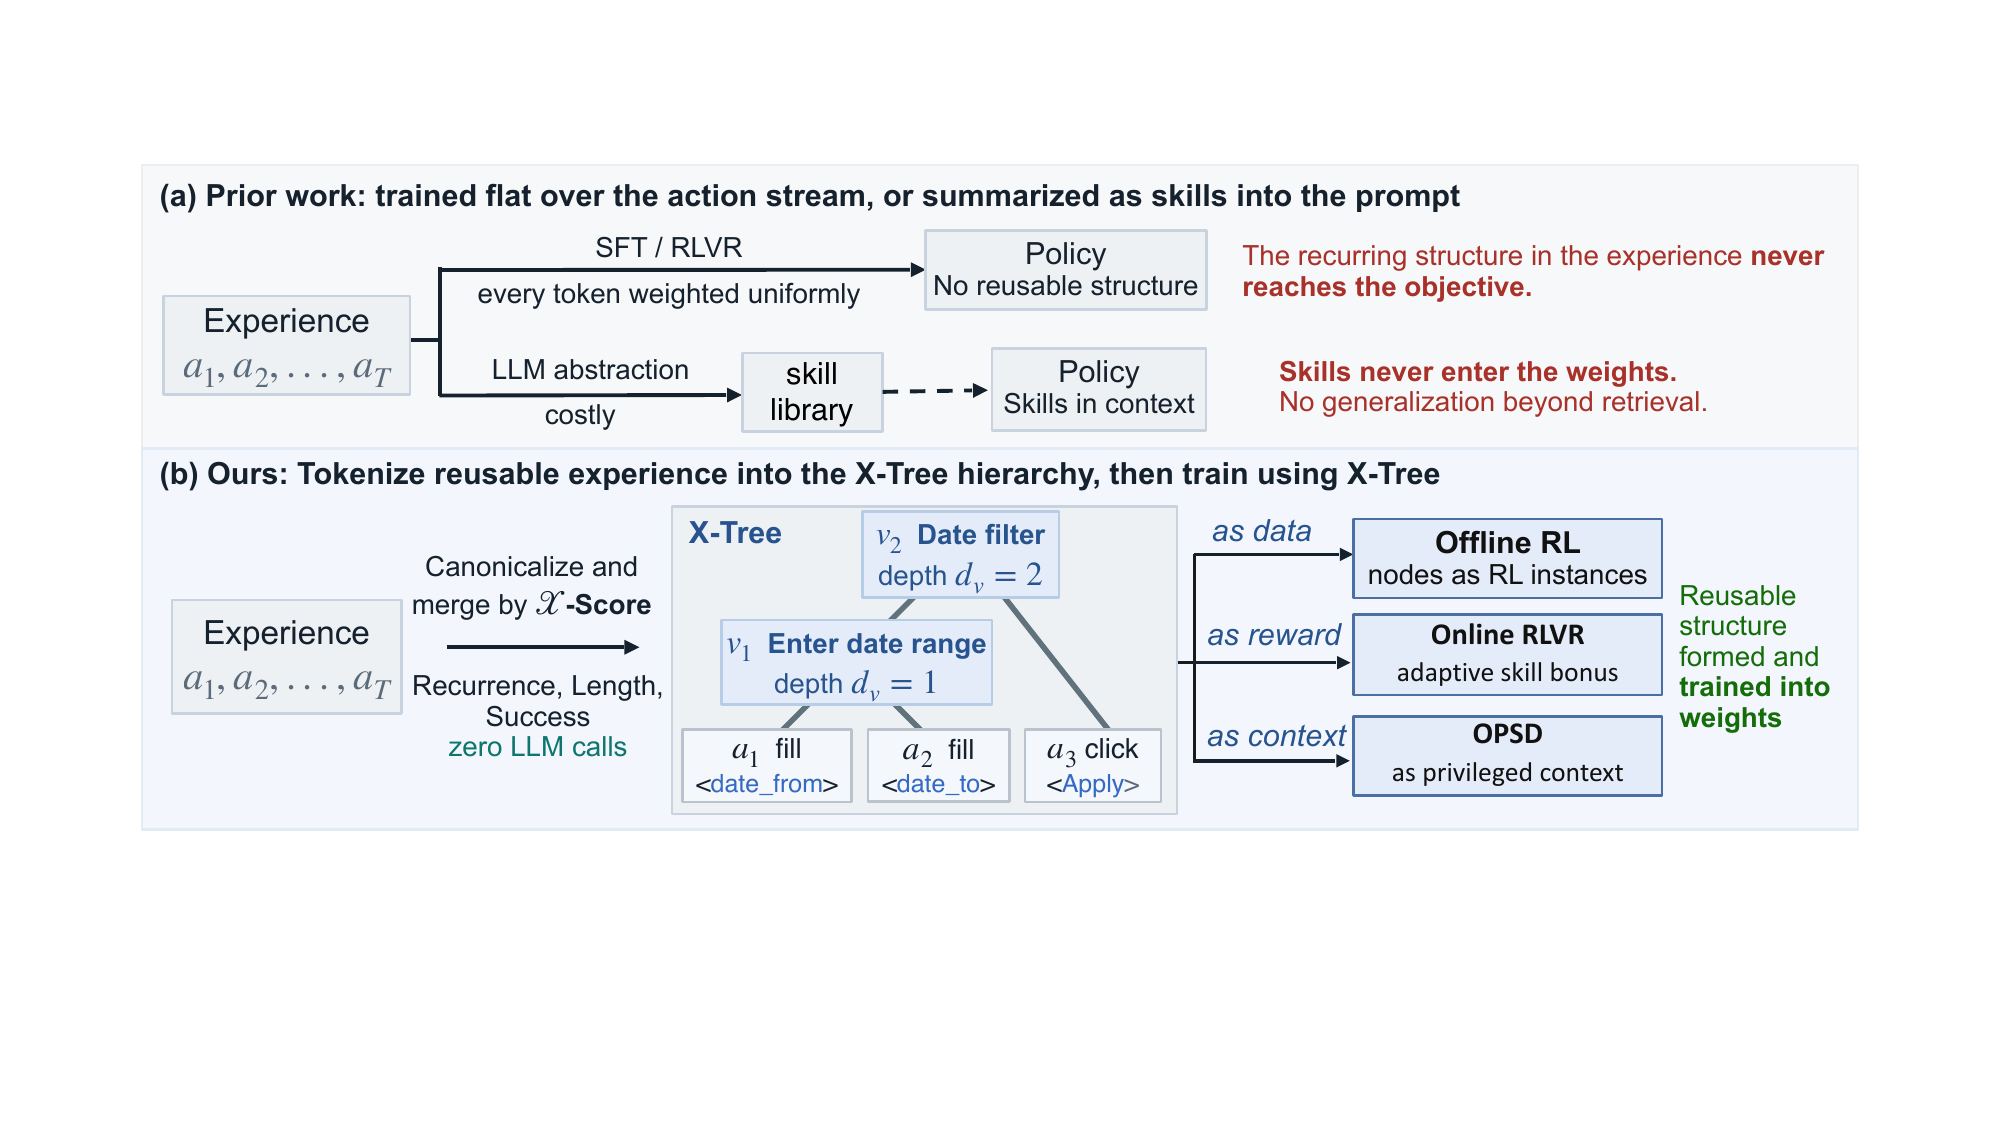
图1:(a) 以往的做法——SFT/RLVR 对动作流平铺训练,每个 token 等权,经验里反复出现的结构永远到不了优化目标;或者靠 LLM 把经验抽象成技能库塞进 prompt,技能从不进权重,泛化不出检索范围。(b) X-Tree 的做法——按 \(\mathcal{X}\)-Score(复发性、长度、成功率)把经验规整化并合并成层级树,零 LLM 调用,然后以 data(offline RL)、reward(online RLVR)、context(OPSD)三种身份训进权重。
已有的替代方案也不是没有。Voyager 式的 harness 系统会让 LLM 把过往经验总结成自然语言技能库,用时检索进上下文。这条路有两个软肋:技能只活在 prompt 里,不进权重,换个任务检索不到就没用;而且技能库本身依赖 LLM 来写,贵、不可控、没法从数据独立复现。X-Tree 想同时躲开这两个坑。
🧠 方法核心:把 BPE 搬到动作序列上
一句话版:把每条轨迹看成"字符流",动作规整化后当"字符",用一个比纯频次更聪明的打分函数做 BPE 式贪心合并,合并出来的每个内部节点就是一个技能。
规整化:让重复变得可见
原始动作太吵了。fill(bid, '2/2/26') 和 fill(bid, '3/5/26') 是两个不同的字符串,但结构上是同一个动作。X-Tree 先把每个原子动作(不含思考部分)映射成 typed token:verb⟨role⟩,比如 fill(bid,'2/2/26') ↦ type⟨date⟩。元素 id、输入文本这些具体值全部剥掉。规整化要保证三件事:无损(剥掉的值仍可从原轨迹找回)、完备(没有动作无法规整化)、同构动作共享符号。这一步做完,"复发"才变得可数。
\(\mathcal{X}\)-Score:比 BPE 多两只眼睛
文本 BPE 只看频次。经验数据里信号更多:一对动作值得合并,当它反复出现、足够长(合并后压缩收益大)、而且经常出现在成功的 episode 里。打分函数是:
其中 \(f_{uv}\) 是符号对相邻出现的次数,\(\ell_u\) 是符号 \(u\) 展开成原子动作的个数,\(\mathrm{succ}(uv)\) 是这对出现在成功 episode 里的比例,\(\epsilon\) 是平滑项,\(p_\ell\)、\(p_s\) 都设 1。每轮贪心地合并分数最高的一对。
还有一道压缩约束防止语料坍缩成几个巨型符号:只有当 \(f_{uv} - 1 > \eta(\ell_u + \ell_v)\) 才允许合并——省下的符号数得大于新词条目的成本 \(\eta\)。
整个过程确定性、可审计、零 LLM 调用。合并结束后得到一棵树:叶子是规整化后的原子动作,内部节点是技能,深度 \(d_v\) 比最深的子节点大 1。对一条新轨迹,X-Tree 给出它的顶层 tiling——用挖出来的最大技能去切分它,盖不住的地方留原子动作。
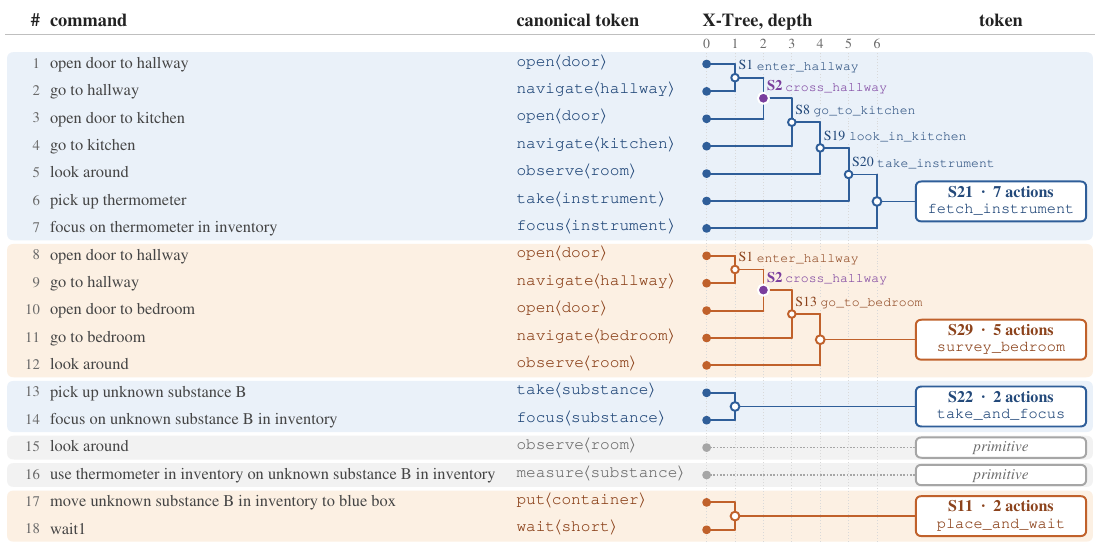
图5:一个具体例子。左边是原始轨迹(开门、穿走廊、捡温度计……),中间是规整化后的 canonical token,右边是 X-Tree 的层级结构——move_to_kitchen、open_door_hallway 这类深度 2-4 的节点把 18 步原始动作压成 5-7 个技能块。注意"去厨房拿温度计测物质温度"这种长程序列被识别成一个完整技能。
三种方式把树训进权重
树挖出来了,怎么用?作者给了三条路,对应三种训练场景。这是我觉得这篇论文最"工程友好"的地方——它不强绑定某一种训练范式。
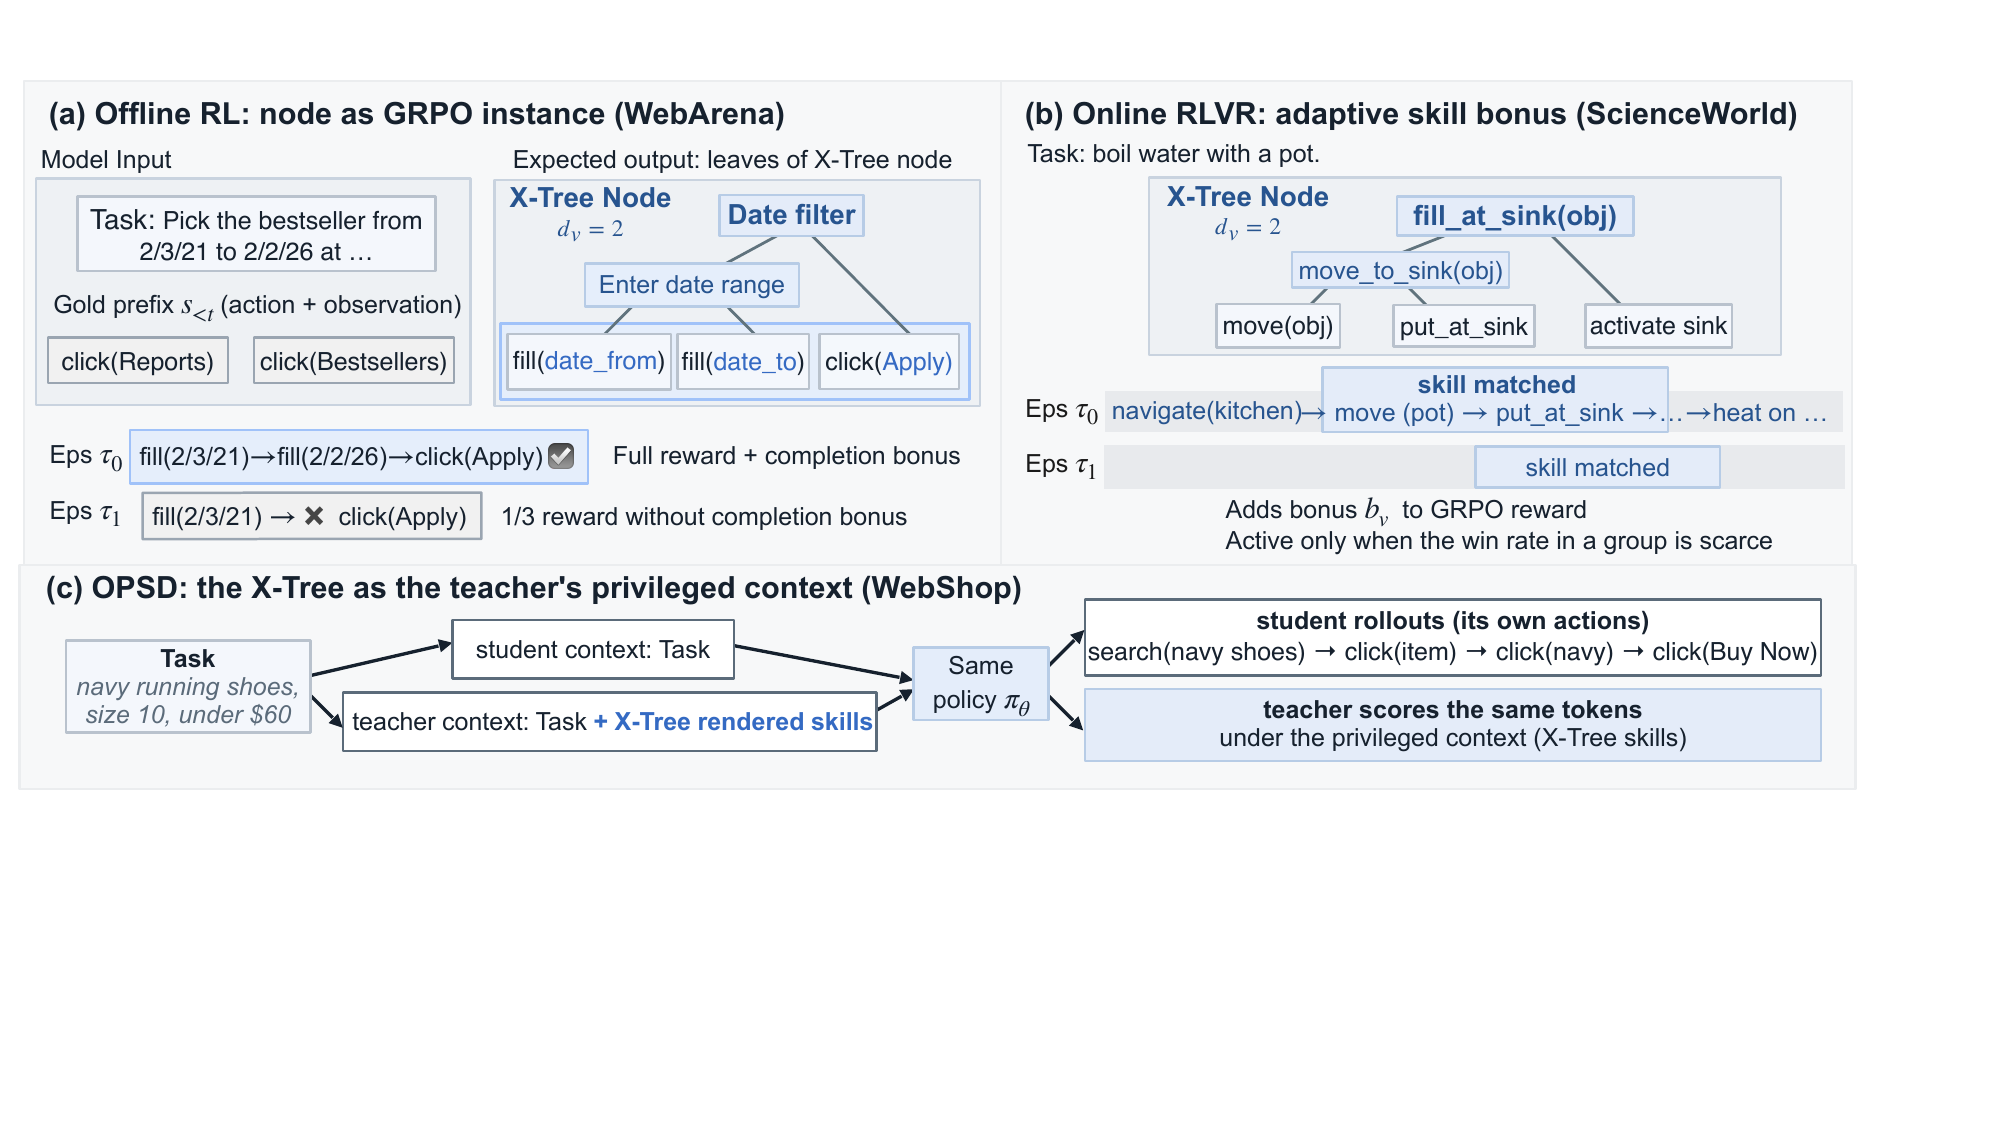
图2:(a) Offline RL:X-Tree 节点作为 GRPO 实例,从 gold prefix 出发部分 rollout,按节点完成度给奖励。τ₀ 完整复现"填日期→点 Apply"拿满奖励加完成加成;τ₁ 第二步就急着点 Apply,只拿 1/3 的步进匹配奖励。(b) Online RLVR:rollout 执行到 X-Tree 节点时加自适应加成,只在组内胜率稀缺时生效。 (c) OPSD:同一套权重,teacher 的上下文里多了 X-Tree 渲染出的技能文本,student 没有,按 token 对齐做蒸馏。
路线一:Offline RL——每个节点当一个 RL 实例。没有环境可交互时,唯一信号是和 gold 轨迹的吻合度,长 horizon 下极其稀疏。X-Tree 把每个节点变成一个训练实例:输入是节点之前的 gold 前缀,模型接着生成最多 \(\ell_v\) 步,奖励分两部分:
前一项是步进匹配奖励(rollout 在 gold 路径上走了多远,走错即停),后一项是节点完成奖励 \(c_v\)(整节点全部匹配才为 1),并按深度 \(d_v\) 放大——越深的组合越难、越值得奖励。\(\alpha=0.3\),\(\gamma=0.5\)。这个设计挺精巧:它把一条长轨迹的信号密度凭空抬高了一个量级,而且深层技能天然获得更高权重。
路线二:Online RLVR——自适应技能加成。有 verifier 时问题是另一种:训练早期一组 rollout 全失败,GRPO 的组内优势全是零,梯度直接消失。X-Tree 补上这个空缺:
rollout 执行到的每个节点给加成 \(b_v\)(ScienceWorld 上 \(b_v = 1+\gamma d_v\),WebShop 上按节点成功率乘以有效步数折算),关键是权重 \(\lambda_g\):组内胜率 \(w_g\) 为零时加成满额,胜率到 \(w_{\mathrm{ref}}\) 时加成归零。这是个"只在 verifier 哑火时上岗"的辅助信号,verifier 自己能区分好坏时它就退出去。嵌套技能只按最外层与已奖励内层的差值计,避免重复计分。
路线三:OPSD——自教师的特权上下文。On-policy self-distillation 让同一个模型扮两个角色:teacher 多读一份特权信息,student 没有,然后按 token 对齐蒸馏。X-Tree 渲染成技能文本(每个节点一行,带成功率和出现次数)塞进 teacher 的上下文:
其中置信门 \(g_t = \sigma(\beta\delta_t)\) 只在 teacher 因技能文本而更确信的 token 上接近 1——student 只在"技能真的帮上忙"的位置被拉向 teacher。\(c=0.01\)。因为 teacher 和 student 是同一套权重,任何差距都只能归因于那份技能上下文,这个对照设计很干净。
📊 实验:三个环境、三个模型规模
实验用 Qwen2.5-Instruct 系列(1.5B/3B/7B,WebArena 用 7B),三个种子取均值。
Offline RL(WebArena):从 7.9k 条轨迹挖 256 个技能,694 个确定性任务上评测。结果如下(SR,%):
| 方法 | gitlab | shopping | admin | map | wiki | 全部 | |
|---|---|---|---|---|---|---|---|
| Qwen2.5-7B 基座 | 6.4 | 7.8 | 7.7 | 2.4 | 9.0 | 2.4 | 6.5 |
| Go-Browse(SFT,2 epochs) | 16.8 | 21.7 | 22.9 | 16.4 | 10.4 | 7.1 | 18.4 |
| Go-Browse(SFT,4 epochs 等算力) | 17.5 | 19.4 | 24.4 | 16.1 | 13.4 | 11.9 | 18.8 |
| Offline RL + outcome 奖励 | 15.5 | 23.4 | 23.1 | 15.2 | 7.5 | 14.3 | 18.2 |
| Offline RL + 随机 span | 18.4 | 20.9 | 26.6 | 14.7 | 11.9 | 14.3 | 19.5 |
| X-Tree 平铺混合 | 16.1 | 24.5 | 25.4 | 19.9 | 14.4 | 23.8 | 20.7 |
| X-Tree 课程式(按深度) | 17.8 | 21.5 | 28.6 | 20.8 | 12.4 | 23.8 | 21.2 |
| X-Tree Full | 22.0 | 26.6 | 29.3 | 18.8 | 10.4 | 14.3 | 22.9 |
同一池轨迹、不加任何新信息,22.9 对 18.4,相对 Go-Browse 涨了 24%。注意 SFT 加到 4 个 epoch(等算力对照)只涨 0.4,说明增益不来自算力。涨得最多的是 admin(+6.4)、gitlab(+5.2)、shopping(+4.9)——恰恰是流程最密集的三个站点;reddit、map、wiki 这种主要靠查询构造的站点收益小。说实话这个分布反过来验证了方法的合理性:X-Tree 挖的是程序性结构,对查询型任务本就该没用。
消融(Table 2)是我觉得最有说服力的部分:
| 消融项 | SR | Δ |
|---|---|---|
| X-Tree Full | 22.9 | – |
| 整轨迹(不要树) | 19.9 | -3.0 |
| 随机 span(同数量同长度分布) | 19.5 | -3.4 |
| 随机树(同合并次数,打乱 \(\mathcal{X}\)-Score) | 17.9 | -5.0 |
| 二元 outcome 奖励 | 18.2 | -4.7 |
| SFT-Full(2 epochs) | 18.4 | -4.5 |
随机 span 保持了切块的数量和长度分布、只挪边界,掉 3.4;随机树连合并选择都打乱,直接掉到 SFT 以下。结构本身是信号,不是"切成小块就有效"。这个对照把最可能的质疑(增益是不是来自数据增强式的切分)堵死了。
Online RLVR(ScienceWorld / WebShop):
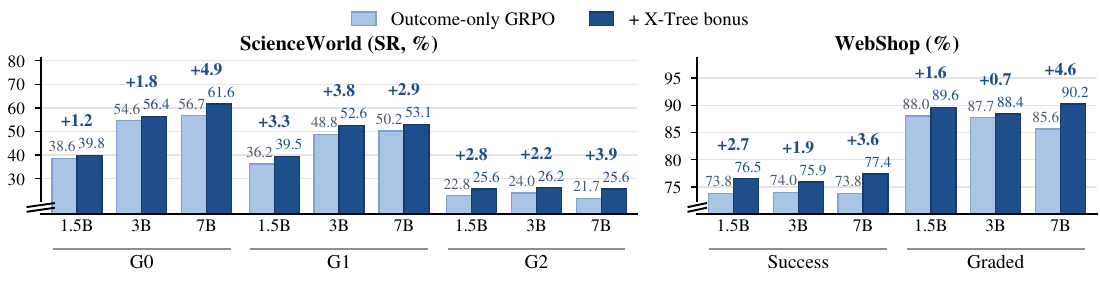
图3:每对柱子只差奖励项。ScienceWorld 三个泛化层级(G0 见过的任务、G1 未见过的变体、G2 未见过的任务类型)上 X-Tree 加成全面领先,最高 +4.9(7B,G0);WebShop 成功率最高 +3.6、graded 分数最高 +4.6,且 7B 的差距最大——规模越大越吃得上这份结构信号。
更有意思的是 rollout 数 \(n\) 的缩放实验(ScienceWorld,1.5B):
| \(n\) | 设置 | G0 | G1 | G2 |
|---|---|---|---|---|
| 2 | outcome-only | 12.9 | 13.7 | 11.8 |
| 2 | + X-Tree | 14.6 | 15.5 | 13.0 |
| 4 | outcome-only | 24.2 | 23.9 | 12.1 |
| 4 | + X-Tree | 28.0 | 27.5 | 16.5 |
| 8 | outcome-only | 38.6 | 36.2 | 22.8 |
| 8 | + X-Tree | 39.8 | 39.5 | 25.6 |
| 16 | outcome-only | 47.5 | 49.0 | 26.6 |
| 16 | + X-Tree | 51.0 | 47.9 | 27.4 |
12 个格子里赢 11 个,增益在 \(n\) 小时最大(\(n{=}4\) 时 3.6 到 4.4 个点),\(n\) 变大后收窄——正好是设计意图:奖励稀疏时加成上岗,verifier 信号变密后它退出去。实测训练后期 \(\lambda_g\) 的实际暴露从 \(n{=}2\) 的 0.50 降到 \(n{=}16\) 的 0.18-0.26,退火行为符合预期。
还有两个排除性实验值得说。一个是资源对齐(WebShop,1.5B):把挖掘语料限制在 SFT 数据本身,500 条样本挖出来的 X-Tree 仍能从 73.8 提到 74.9;用全部 1,824 条则到 77.4。增益不来自多用的那份数据。另一个是挖掘语料规模:100 条轨迹挖 11 个技能就能到 75.2,超过 outcome-only 基线;挖 X-Tree 不需要大语料池。
OPSD(自蒸馏):
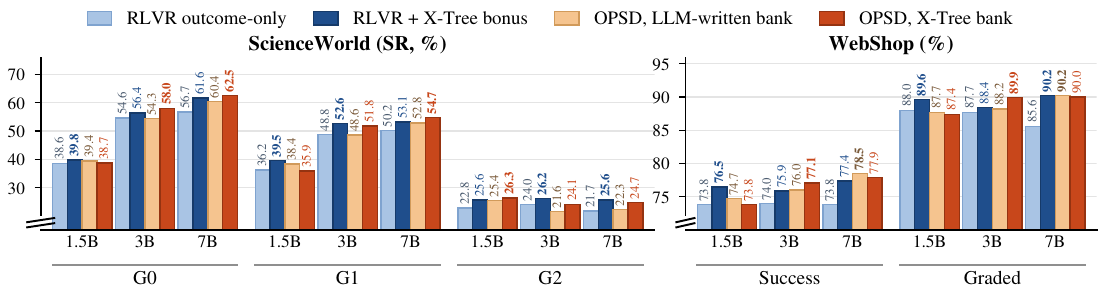
图4:四种设置对比——RLVR outcome-only(浅蓝)、RLVR + X-Tree 加成(深蓝)、OPSD + LLM 撰写技能库(浅橙)、OPSD + X-Tree 技能库(深橙)。重点看两个橙色的差距:X-Tree 技能库与 LLM 写的技能库基本打平,多数格子还略高(ScienceWorld 最高 +3.7,WebShop 最高 +1.7)。
这个结果我读到的时候停了一下。LLM 技能库在 ScienceWorld 上是 gpt-oss-120b 写的、WebShop 上是 GPT-o3 写的——都是不小的模型。X-Tree 纯计数挖出来的东西,当 teacher 的特权上下文居然不输。7B 上 OPSD + X-Tree 比 outcome-only RLVR 高出 5.8 个点的 SR(ScienceWorld)和 4.4 个点的 graded 分数(WebShop)。当然有个前提:OPSD 的收益取决于基座模型"读得懂"技能文本的能力,所以小模型上增益有限,7B 才拉开。
🔬 我的判断
这篇论文最值钱的地方,我觉得不是某个具体数字,而是它把一个一直被忽视的观察变成了可复用的工具:轨迹数据和文本一样,在进训练之前值得先过一次分词。BPE 给文本做的事——从纯计数里长出层级——在动作序列上居然也成立,而且因为多了成功率这只眼睛,合并出来的结构天然偏向"有用的技能"而不是"常见的废话"。
几个我认可的点:
- 消融设计是真的对症下药。随机 span 和随机树两个对照直接把"切块本身有用"这个最方便的解释毙掉了。资源对齐实验堵住了"增益来自挖掘语料"的口子。这种消融密度在同期的 Agent 论文里算少见的。
- 三条集成路线覆盖了主流训练场景,offline/online/蒸馏各一套,工程上拿去就能用。自适应加成的退火设计(\(\lambda_g\) 随组内胜率衰减)体现了对 GRPO 训练动态的准确理解——辅助信号最怕的就是喧宾夺主。
- 零 LLM 调用这个约束不是噱头。跟 GPT-o3 写的技能库打平,说明 LLM 抽象技能的边际价值可能没我们以为的那么高——至少在技能"检索进上下文"这条路上,计数统计已经够用了。
但也有几个地方我保留意见:
- WebArena 上 wiki 站点从 23.8(平铺混合)掉到 14.3(Full),map 从 14.4 掉到 10.4。Full 配方在查询型站点上是退步的。作者解释是步进匹配+完成奖励偏向程序性任务,但这提醒我们:这套奖励不是免费午餐,任务分布偏查询型时可能要回退到平铺混合。
- X-Tree 是从固定语料池一次性挖出来的,挖完就冻住了。作者自己在 limitations 里也承认:从 policy 自己的 rollout 里持续挖掘、让结构和策略共同进化,才是更自然的形态。现在的版本更像一个静态的"经验先验"。
- 三种集成各跑各的,没有组合实验。一个模型同时用 X-Tree 当数据、当奖励、当教师上下文会怎样?增益叠加还是互相干扰?没答案。
- 提升幅度实打实但不爆炸——大部分格子在 1-5 个点之间。对于"同数据同预算"这个前提来说这个幅度是体面的,但别期待它解决 Agent 泛化的根本问题。
工程上的启发很直接:如果你手里有一池轨迹在跑 SFT 或 GRPO,X-Tree 基本是个"白捡"的增强——挖掘是确定性的、秒级的、不烧 LLM 的钱,接入奖励或数据的改动都不大。特别是训练早期全失败组梯度消失的场景,自适应技能加成是个成本极低的续命手段。
更大的图景上,这篇论文和技能库、harness 系工作(Voyager 一路)的关系值得玩味:它证明了经验的层级结构可以被统计性地发现,而不是只能被 LLM 语言化地总结。两条路未必互斥——用 X-Tree 挖出候选技能、再用 LLM 做语义包装,可能是个甜点位。
🔗 资源
- 论文:https://arxiv.org/abs/2609.32993
- 代码:https://github.com/sitaocheng/X-Tree/
- 项目主页:https://sitaocheng.github.io/xtree/
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我