RL 后训练正在悄悄"交税":一道看不见的覆盖率账单,以及一张能少交税的采样处方
上周读到一篇让我停下来想了很久的论文。
事情是这样的。过去一年里,关于"RL 后训练到底有没有教会模型新能力"的争论一直没停过。Yue 等人和 Zhao 等人先后在数学和代码任务上发现:RL 训练后的模型 pass@1 确实涨了,但把采样次数加到几十上百次再看 pass@K,base model 居然反超了。换句话说,RL 更像是在"锐化"base model 已有的行为,而不是拓展边界。
但说实话,这个结论我一直觉得有点虚。数学和代码这两个领域太特殊了——预训练语料里满是数学推导和代码片段,base model 本来就"什么都会一点";而且只看最终答案对错的评估方式,一个推理过程乱七八糟但蒙对答案的 rollout 也算成功。在这种设定下说"RL 没教会新东西",证据没那么硬。
那如果换到 agentic 任务上呢?多轮工具调用、环境交互、长程规划——这些行为在预训练数据里可不多见,按道理应该是后训练才真正教会模型的。如果锐化假设在这里也成立,那才是真正让人不安的结论。
Meta Superintelligence Labs 和 UW-Madison 这篇《Sharpening Tax in Post-Training》(arXiv: 2610.01509)干的就是这件事。结论比我预想的还要激进:给 base model 套上一个轻量的推理 harness,它就是个相当能打的智能体,只要测试时采样预算给够,覆盖率经常反超后训练版本。
核心摘要:这篇论文把"RL 只是锐化已有行为"的假说从数学/代码搬到了 agentic 场景做压力测试。在 14 对 base/post-trained 开源模型(Gemma-4、Ministral-3、Qwen2.5、Qwen3.5 四个家族,3B 到 35B)、三个多轮智能体基准(BFCL v4、WebShop、ACEBench)共 42 个组合上,作者发现后训练普遍用覆盖率换单次准确率——比如在 WebShop 上 gemma-4-31B 的 base 版本 pass@128 超过 85%,而后训练版只有 56%。作者把这个代价量化成一个标量指标 Sharpening Tax,并给出解法 PTGS:按每个 prompt 的估计难度自适应调采样温度,难题加热、易题降温,在 PPO/GRPO 训练中同时提升 pass@1 和 pass@128,交的税明显更少。这是一篇"诊断指标 + 机制分析 + 可落地方法"三件套都齐活的论文,值得细读。
论文信息 - 标题:Sharpening Tax in Post-Training - 作者:Changdae Oh, Qi Zeng, Qi Qi, Andrey Zhmoginov, Deren Lei, Yun He, Hoang Phan, Hangoo Kang, Azalia Mirhoseini, Sharon Li - 机构:Meta Superintelligence Labs、University of Wisconsin–Madison、NYU、Stanford University - 链接:https://arxiv.org/abs/2610.01509 - 项目页:https://changdaeoh.github.io/sharpening-tax/ | 代码:https://github.com/changdaeoh/sharpening-tax

图 1:整篇论文的三段论。(a)后训练把 pass@1 抬上去(效率收益),但压低了 pass@K 的天花板(覆盖率损失);下方柱状图显示任务被推向"永远解不出/永远解得出"两个极端,中间态从 84.6% 塌缩到 40.4%。(b)Sharpening Tax 的定义直觉:base 和 post 两条 pass@K 曲线下的"可扩展性面积"之差。(c)PTGS 的效果预览:PPO 的税从 0.067 降到 0.051,GRPO 从 0.055 降到 0.027,同时 pass@k 曲线整体抬高。
🎯 为什么要在 agentic 任务上重做这个问题
先把评估的尺子讲清楚。论文沿用三个互补指标:对任务 \(x_i\) 采 \(n_i\) 条 rollout、其中 \(c_i\) 条成功,则
- pass@1(准确率):\(\text{pass}@1_i = c_i / n_i\),单次采样的命中率,衡量采样效率;
- pass@k(覆盖率):\(\text{pass}@k_i = 1 - \binom{n_i - c_i}{k} / \binom{n_i}{k}\),\(k\) 次里至少中一次的概率,衡量解空间覆盖;
- pass^k(一致性):\(\text{pass}^k_i = \binom{c_i}{k} / \binom{n_i}{k}\),\(k\) 次全中的概率,衡量稳定性。
基准选了三个需要多轮工具调用的环境:BFCL v4 multi-turn base split、WebShop、ACEBench。跟数学代码不同,这里的中间动作和状态转移都会被校验,不存在"推理错了但答案蒙对"的水分——这一点我觉得选得相当讲究,直接堵住了之前对 pass@K 分析最主要的质疑。
模型侧,作者没有去自己训,而是用了 14 对现成的开源 base/post-trained checkpoint 对(如 gemma-4-31B vs gemma-4-31B-it),覆盖 Gemma-4、Ministral-3、Qwen2.5、Qwen3.5 四个家族。坦白讲这带来一个天然的软肋:这些模型的后训练配方不公开,SFT、DPO、RLVR 的比例都不知道。作者的回应也坦诚——SFT 和 DPO 同样会锐化分布,所以分析不依赖具体配方,"RL 后训练"在这里是所有后训练的统称。这个处理可以接受,但代价是这篇文章的证据是观察性的,不是因果性的,这点后面还会再聊。
另外一个容易忽略的细节:base model 不会天生按格式调工具,所以作者给它配了一个 harness——就是一套与数据集无关的系统提示词加宽松的工具调用解析接口。这个 harness 的效果有多夸张?看数字:在 BFCL 上,8 个 base model 的平均 pass@1 从 5.59 涨到 15.63,pass@32 从 15.19 涨到 49.13;WebShop 的 pass@32 从 39.48 涨到 49.15。而同一个 harness 套在后训练模型上反而会掉点。我的理解是:base model 缺的不是能力而是"接口礼仪",harness 补的正是这一层;后训练模型已经把格式内化了,再套一层反而是干扰。
📊 核心现象:base 模型会追上来,而且模型越大追得越快
图 2 是全文最核心的实验结果,四个家族的最大模型在三个基准上的 pass@K 曲线(每任务最多 128 条 rollout)。
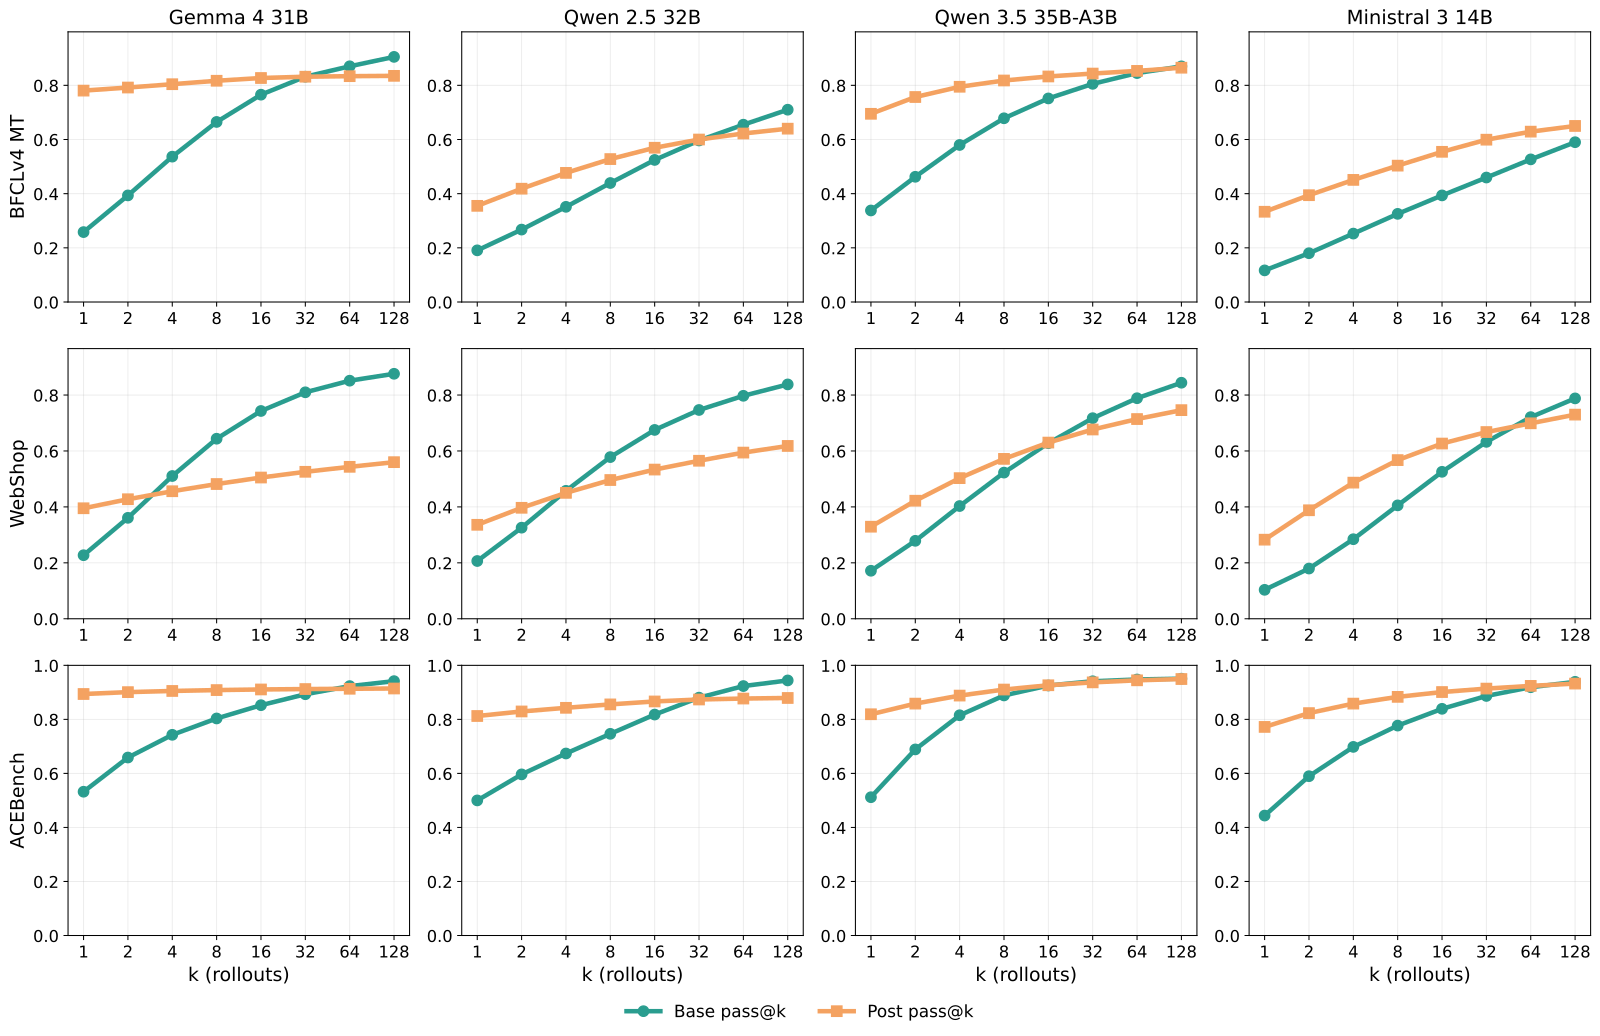
图 2:pass@K 测试时扩展曲线(青色是带 harness 的 base,橙色是 post-trained)。后训练模型在小 K 处领先,但 base 模型的曲线斜率更陡,在多数设定下完成反超。注意 Ministral-3-14B 在 BFCL 上是个例外——128 次采样内没追平。
最扎眼的是 WebShop 那一行。gemma-4-31B 的 base 版 pass@128 超过 85%,而后训练版停在 56% 左右——差了将近 30 个点。你想想看,一个"没训过"的模型,只要多抽几次,能解决的问题比精心后训练的版本还多三成。这个差距不是靠运气能解释的。
更有意思的是模型规模的规律。图 3 把 Gemma-4 家族 4B、12B、26B、31B 四个尺寸摆在一起:
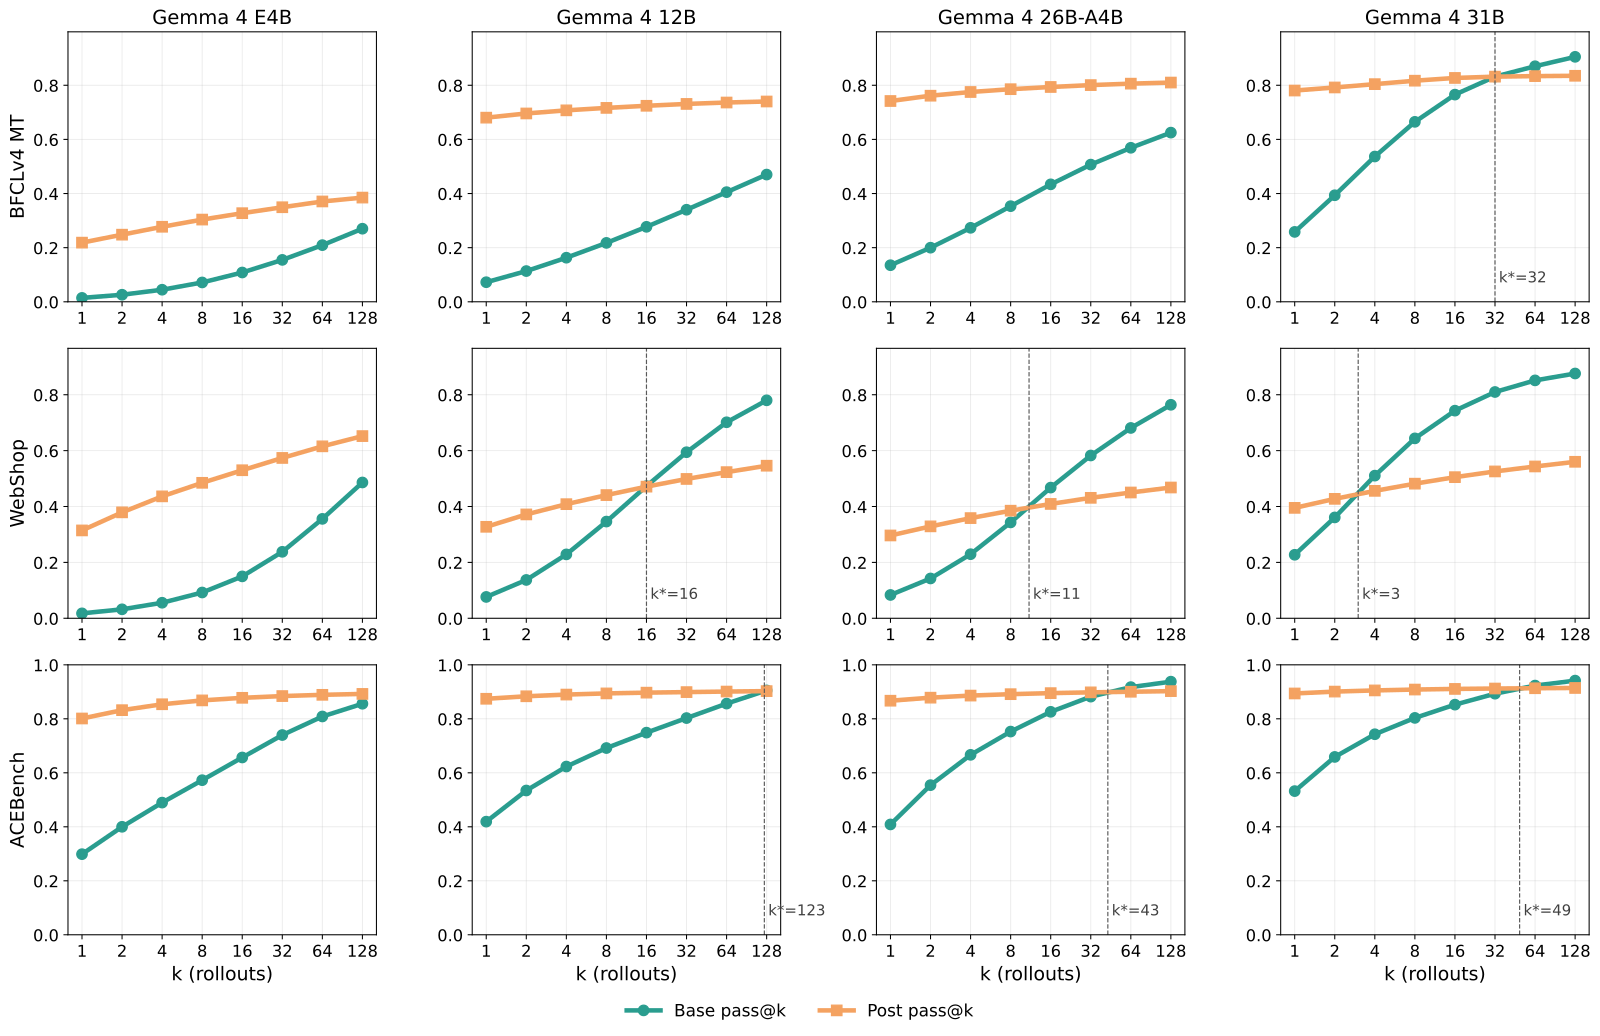
图 3:Gemma-4 家族四个规模的 pass@K 曲线,虚线标出交叉点 k。WebShop 上交叉预算从 12B 的 k=16、26B 的 k=11,一路缩到 31B 的 k=3——31B 的 base 模型第 3 次采样就反超了。E4B 在 WebShop 上 128 次内还没追上(k 大于 128)。*
这个趋势的解读我很认同:大模型存的"行为模式"更多、相互干扰更少,同样的数据里能榨出更结构化的信息,所以小预算内就能撞出解。锐化对小模型是雪中送炭(反正本来也没多少覆盖率可亏,先把 pass@1 抬起来),对大模型则是过早封顶。判断后训练是福是祸,必须跟模型规模、采样预算、应用场景一起看。一个预算充足、只需要"百里挑一"的场景——科学发现、自动化研究这种看重多样性的事——用大 base 模型加重复采样可能比后训练版更划算。
🔬 机制:后训练把任务推向两个极端
曲线交叉只是表象,真正的机制在图 4。作者按 128 条 rollout 的结果把任务分三类:always pass(全中)、pass given compute(中间态,多抽能中)、always fail(全不中)。
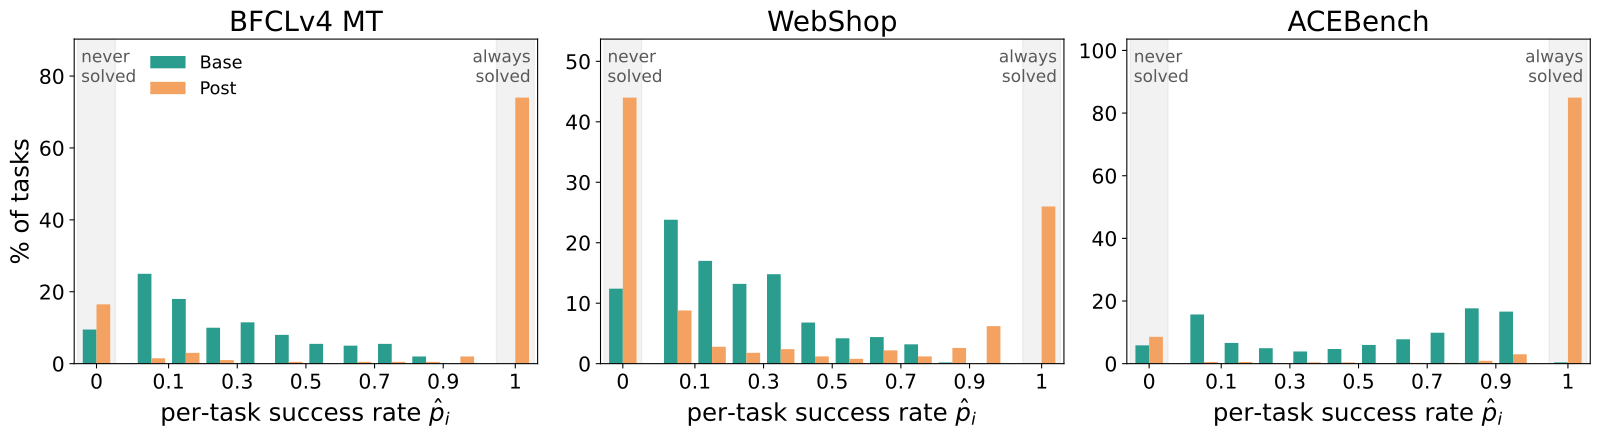
图 4:gemma-4-31B 上 base(青)与 post(橙)的单任务成功率直方图。base 的分布铺得很开,大量任务卡在中间成功率区间;post 则呈双峰形态,质量被推到 0 和 1 两端。注意 WebShop 上 post 在"永远解不出"一侧的柱子明显变高了。
数字很能说明问题。WebShop 上 gemma-4-31B:中间态任务占比从 87.6% 暴跌到 30.0%,always pass 从 0.0% 涨到 26.0%——但 always fail 也从 12.4% 涨到 44.0%。
等等,最后这个数字值得停下来看一眼。后训练不只是把"半会不会"的任务教会了,它还同时把一大批任务彻底推向"永远做不对"。这跟 Shen 等人 2026 年的发现吻合:RL 放大的不只是正确行为模式,base 模型本来就偏好的错误模式一样被放大。锐化是把双刃剑这件事,在这里有了非常具体的分布证据。
双峰化还带来一个副产品:一致性。后训练模型的 pass@K 和 pass^K 两条曲线贴得很近——要么全会要么全不会;而 base 模型的 pass^K 几乎塌到零,pass@K 却一路爬升。一句话总结:后训练用覆盖率换来了采样效率和一致性。这个 trade-off 在所有四个家族上都复现了,其中 Qwen3.5 锐化最温和,Gemma-4 最激进。
📏 Sharpening Tax:把"覆盖率亏了多少"压成一个数
看到这儿你可能会问:每个模型每个数据集都画一遍 pass@K 曲线,这没法规模化诊断啊。作者也是这么想的,于是提出 Sharpening Tax。定义分三层:
原始可扩展性——pass@K 天花板下方的累积面积:
直觉是:多抽几次到底能额外捞回多少性能。
校准可扩展性——用单次失败率归一化,把值域压到 \([0,1]\):
Sharpening Tax——base 与 post 的差:
Tax 为正,说明后训练在收"税":你通过增加测试时算力能买到的覆盖率,变少了。
我尤其喜欢 Proposition 1 给的概率解释:\(A(K)\) 等于"首次成功之前期望的失败次数"(预算 \(K\) 以内)。第一次就中和永远中不了的任务贡献都是零,只有"第 \(h\) 次才中"的任务贡献 \(h-1\)。这个指标量的其实是:一个策略的成功里,有多少是靠重试换来的。 正税说明后训练模型的成功更少依赖重试——要么失败后再也救不回来(覆盖率丢了),要么很快就饱和了(没东西可挖)。
实证上,42 个模型×基准组合里,36 个在 \(K=128\) 时 \(\text{Tax}_S\) 为正。大模型几乎在所有预算下都交税,gemma-4-31B 交得最多;小模型在小预算时税是负的(Ministral-3-3B 最明显)——预算极度受限时锐化确实划算,但随着预算放大,税照样涨上来。

图 5:四个家族最大和最小 backbone 在三个基准上的 Tax_S(k) 曲线,阴影是 95% bootstrap 置信区间。大 backbone 的税几乎处处为正;小 backbone 从小预算的负值逐渐爬向零以上。
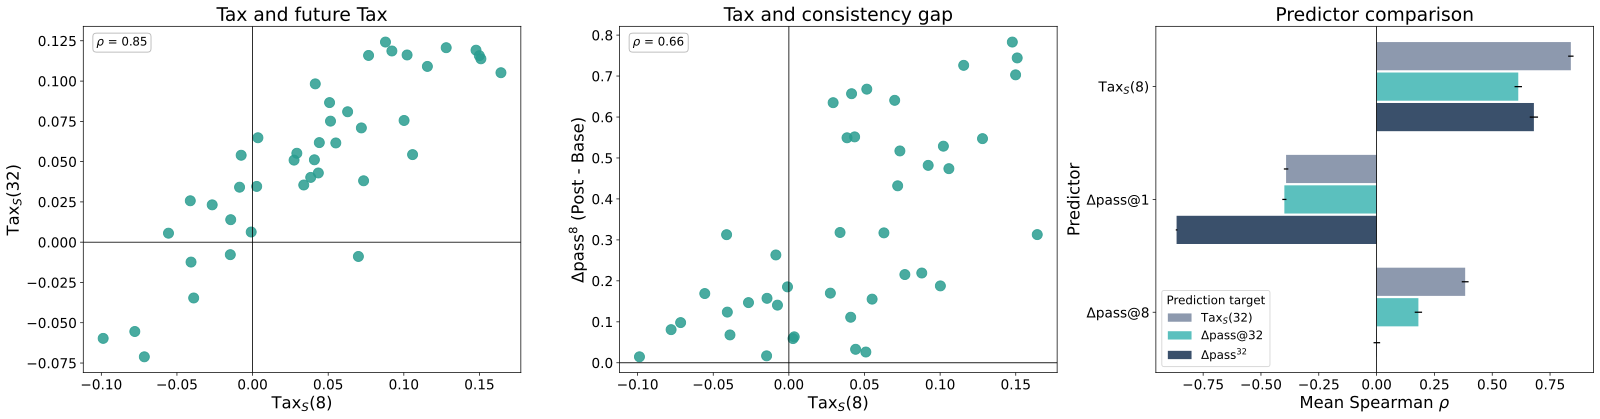
图 6:(左)用一半任务、8 次 rollout 估出的 Tax_S(8) 预测另一半任务上的 Tax_S(32),Spearman 相关系数 0.85;(中)Tax_S(8) 与一致性差距 Δpass^8 正相关,ρ=0.66——后训练策略越一致,交的税越多;(右)只用 8 次 rollout 的候选预测器对比,Tax_S(8) 是唯一能同时强预测三个未来指标的。
这个 0.85 的可预测性是实用性的关键:8 次 rollout 的便宜估计,就能外推 32 次甚至 128 次预算下的税。作者还顺手展示了一个应用:按税的大小在 base 和 post 之间做逐任务路由。诊断指标能做到"便宜且外推",这比很多只能在全量评估后才能算出来的马后炮指标强不少。
🔧 PTGS:按难度调温,让难题保持探索
诊断完了,能不能治病?最朴素的解法是把采样温度全局调高——但附录 C.4 的实验表明这招不行,pass@K 涨的同时 pass@1 掉。全局调温是个零和博弈。
作者的方案是 posterior-tempered group sampling(PTGS),思路一句话讲完:给每个 prompt 单独估一个难度,难题加热鼓励探索,易题降温锁定收益。

图 7:PTGS 的三步流程。左侧用 Beta-Binomial 模型维护每个任务的成功率后验(带折扣因子的累计成败计数);中间按 Thompson 采样抽出的 p̂ 决定温度,低于目标成功率就加热到 τ,高于就冷却到 1/τ;右侧用该温度生成 n 条 rollout,奖励回流更新后验并做 RL 策略更新。
具体做法有点贝叶斯的味道。对每个 prompt \(x\),训练中持续跟踪带遗忘因子 \(\gamma\) 的折扣成败计数 \((\tilde{s}_x, \tilde{f}_x)\),配上目标成功率 \(\tilde{p}\) 构成 Beta 后验,参数 \(a_x = 2\tilde{p} + \tilde{s}_x\)、\(b_x = 2(1-\tilde{p}) + \tilde{f}_x\)。每轮 Thompson 采样抽一个 \(\hat{p}_x \sim \mathrm{Beta}(a_x, b_x)\),然后温度设为
基础温度 \(\tau > 1\) 控制温度范围 \([1/\tau, \tau]\)。难度越低的 prompt(\(\hat{p}_x\) 越小)温度越高,最高到 \(\tau\);掌握越好的温度越低,最低到 \(1/\tau\)。整个东西是 plug-and-play 的——不改 RL 更新规则,不增加计算开销,PPO、GRPO 都能直接套。测试时这个采样器就丢掉了,它只在训练期干预 rollout 的采样分布。
为什么这样能提高学习信号?Theorem 3 给了个干净的解释。对 group 采样(每组 \(n\) 条),两个事件决定一组 rollout 的学习价值:PPO 这类 actor-critic 方法需要组里至少有一个成功才能强化它;GRPO 这类组对比方法则只有"有成功也有失败"的混合组才能产生非零优势。PTGS 加热难题把成功率从 \(p\) 抬到 \(p'\),只要 \(p' > p\),至少一个成功的组变多(对所有难度成立);只要 \(p' \leq 1/2\),混合组也变多。而 \(J_n(q)\) 在 \(q = 1/2\) 处取峰值,这顺便解释了为什么要训练过程中把目标成功率 \(\tilde{p}\) 从 0.25 逐渐升到 0.5。
实验用 RAGEN 框架在 Sokoban 和 FrozenLake 上微调 Qwen2.5-7B-Instruct,PPO 和 GRPO 各跑带不带 PTGS,五个种子取平均。结果:
| 环境 | 方法 | pass@1 ↑ | pass@128 ↑ | Tax_S(128) ↓ |
|---|---|---|---|---|
| Sokoban | Base | 20.7 | 76.6 | - |
| Sokoban | PPO | 46.5 | 55.0 | 0.094 |
| Sokoban | PPO w/ PTGS | 61.1 | 69.7 | 0.081 |
| Sokoban | GRPO | 36.5 | 55.3 | 0.081 |
| Sokoban | GRPO w/ PTGS | 39.1 | 72.5 | 0.025 |
| FrozenLake | Base | 26.3 | 89.1 | - |
| FrozenLake | PPO | 63.7 | 74.1 | 0.039 |
| FrozenLake | PPO w/ PTGS | 65.0 | 80.0 | 0.020 |
| FrozenLake | GRPO | 63.4 | 77.8 | 0.029 |
| FrozenLake | GRPO w/ PTGS | 67.3 | 81.2 | 0.028 |
表:PTGS 在两种环境、两种 RL 算法上同时提升 pass@1 和 pass@128,并降低 Sharpening Tax。
Sokoban 上 PPO 那组数字值得多说两句:加了 PTGS 之后 pass@1 从 46.5 跳到 61.1——涨了 14.6 个点,pass@128 同时从 55.0 涨到 69.7。准确率和覆盖率通常是此消彼长的,这里居然同涨,说明 PTGS 不只是"少亏",是真的把训练信号质量改好了。GRPO + PTGS 在 Sokoban 的税压到 0.025,不到 baseline 的三分之一。

图 8:FrozenLake 上 PPO vs PPO+PTGS 的训练动态。左图验证成功率最终殊途同归(都在 0.76 左右);右图输出熵的走势完全不同——固定温度的 PPO 熵单调下降到接近 0.1,策略收敛到少数动作序列;PTGS 的熵始终维持在高位且反复回升,因为它在不断给"一直失败的 prompt"加热。
图 8 是我觉得全文最有说服力的一张图。两种方法最终验证准确率一样,但熵曲线告诉你它们收敛到了完全不同的策略:一个把行为收窄到几条固定套路,一个保留了探索能力。同样的 pass@1,完全不同的策略——这句话基本就是全文论点的缩影。
🤔 我的判断:诊断扎实,方法优雅,但因果性欠账
先说这篇论文最值钱的地方。
第一,把锐化假说的检验从数学/代码搬到 agentic 场景,这个切入点选得好。agentic 任务的中间步骤可验证、预训练数据里稀缺,之前对 pass@K 分析"评估有水分"的质疑在这里不成立。结论依然成立,这才是让人真正需要认真对待"锐化假说"的原因。
第二,Sharpening Tax 这个指标设计得很讲究。有概率解释(期望重试次数)、有归一化版本、8 次 rollout 就能外推大预算、还能预测一致性差距——诊断指标的实用性要素基本齐了。我预感这东西会被后续做 RL 后训练的论文当成标配汇报项,就像现在大家报 entropy 一样。
第三,PTGS 的思路朴素但有效。不改 RL 算法本身、零额外计算开销、理论上有 Theorem 3 兜底、实验上 PPO/GRPO 两个环境通吃。如果你在做 agentic RL 训练,这个基本可以即插即用地试。
但有几个地方我得泼点冷水。
因果链是断的。 作者自己也承认,开源 checkpoint 的训练配方不公开,整个 §3-§4 的分析是观察性的。base 和 post 之间的差异到底来自 RL、SFT 还是数据混合的变化,无从得知。PTGS 那部分倒是有干预实验,但只在 Qwen2.5-7B 一个模型、两个小型环境上验证过。能不能推广到 30B+ 规模、更复杂的真实 agentic 环境,是未知数。
harness 是个混杂变量。 base 模型的"惊艳表现"高度依赖那套 harness——BFCL 上 harness 把 base 的 pass@32 从 15.19 拉到 49.13。那么问题就来了:覆盖率优势到底该记在"base 模型的潜力"头上,还是"harness 工程"头上?反过来说,如果给后训练模型也精心设计一套适配它的 harness,差距会缩多少?论文展示了 harness 对 post 模型反而有害,但这多少强化了一个隐忧:这个对比里,"推理脚手架"这个变量并没有被完全控制住。
税的理论模型挺理想化。 Theorem 2 假设锐化是把任务以概率 λ 独立地推向 0 或 1 的极端,这是为了好算。现实中的锐化显然更连续、更相关。理论给了直觉,但别指望它精确预测真实税值。
还有一点小的:42 个组合听起来多,但基准只有三个,且都偏"结构化工具调用"类。开放式的长程规划、多智能体协作这类场景,锐化税是否同样收、PTGS 是否同样省,论文没碰。
📝 收尾
回到开头那个争论:RL 后训练到底有没有教出新能力?这篇论文在 agentic 域给出的答案相当不客气:"后训练主要改变的是模型解题的可靠程度,而不是能解哪些题"。
而且作者结尾的提醒我觉得值得每个做后训练的人抄在墙上:base 模型在持续变强,测试时算力在持续变多。这两股趋势都在抬高锐化的价格——更强的 base 藏着更多稀有但高价值的行为,更大的采样预算恰好是把它们兑现的手段。那些我们期待未来系统攻克的难题,可能被"一次不寻常的命中"解决,而不是被"每次都能跑的套路"解决。
所以工程上的建议很直接:下次汇报后训练效果,别只报 pass@1,把 Sharpening Tax 一起报了。可靠性和覆盖面,应该一起涨。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我