RealCompanion:10 段真实人机陪伴关系,戳穿了记忆 benchmark 的集体幻觉
你有没有想过一个问题:那些号称在 LoCoMo、LongMemEval 上刷了 90 多分的"记忆系统",真的懂坐在对面那个人吗?
刷榜用的对话是生成的,问题是照着答案写的,persona 是开场就贴在你脸上的。整个游戏在出题那一刻就已经决定了答案。这就像考驾照只考倒车入库——还是画好了辅助线的那种。这周这篇 RealCompanion(arXiv:2610.01780)做了一件早就该有人做的事:找 10 个真的和 AI 伴侣聊了几个月的人,把他们的完整对话(经过当事人同意、逐句改写脱敏)拿出来,看看真实世界里"记忆"到底长什么样。
结果相当打脸。
核心摘要
这是一篇 benchmark 论文,但它更像一份"行业体检报告"。作者发布了 10 段真实的人与 AI 伴侣的长期关系数据——27,218 条消息、最长 120 天——并且给每段关系配了 profile、persona、聊天测试题和问答测试题四份带证据链的标注。真实数据讲了三件事:其一,人其实很少翻旧账,只有 3.4% 的消息依赖之前说过的内容,而一旦依赖,那条消息平均埋在两三千条之前;其二,现有系统完全判断不了"什么时候该回忆",检测器在真实消息上的 AUROC 只有 0.53 左右,跟抛硬币差不多;其三,三个顶级智能体系统重建用户画像时 F1 都在 0.69 到 0.70,但它们脑补出来的内容比用户实际透露的多得多。我的判断:这篇论文的价值不在于又开了一个榜,而在于它证明了旧榜测的东西和真实使用之间隔着一条鸿沟。做记忆系统、做陪伴类产品的人都值得细读。
📖 论文信息
- 标题:RealCompanion: Benchmarking Human Understanding from Reasoning over Longitudinal Real-World Conversations
- 作者:Arman Behnam、Sunglyoung Kim、Jiayi Yu、Eric Huang(Quis Lab);Liangwei Yang(Independent Researcher)
- 时间:2026 年 10 月 1 日提交,v3 版本 10 月 8 日
- 链接:https://arxiv.org/abs/2610.01780
- 数据:https://huggingface.co/datasets/Quislab/RealCompanion
🎯 问题动机:生成式 benchmark 的三个原罪
先交代一下背景。对话记忆这个赛道这两年很热,LoCoMo(Snap,ACL 2024)用 LLM 生成 300 轮超长对话,LongMemEval(ICLR 2025)把上下文拉到百万 token,mem0、Zep、Letta 这些记忆层厂商都在上面刷分。圈子里其实已经有人抱怨过:Gemini 2.5 Flash 不带任何记忆系统、直接读原始 transcript,在 LoCoMo 上就能拿 72.8 分——基准线的地板太高了,所谓记忆系统的真实增益远没有营销文案写得那么大。
RealCompanion 的作者把这个质疑往前推了一步,直接戳生成数据的三个结构性缺陷:
- 对话是围着要考的那条记忆写的,所以里面几乎每条消息都需要"过去"。真实世界不是这样。
- persona 是提前声明好的,问"这个人是什么样",读声明就行,不用从行为里推。
- 剧本历史从不自我修正,第九个月说的话不会改变第四个月建立的设定。真实关系里人一直在变。
说白了(哦不,换个说法)——你想想看,一个 benchmark 在出题前就把"过去一定有用"和"这个人就是这样"两个答案都写死了,它还能测出什么呢?只能测背诵。
论文里有一张对比表把主流 benchmark 按五个维度排了一遍:是否纵向、探针来源、有无证据链、是否测弃权、标签是否可核查。LoCoMo、LongMemEval、PersonaMem、CUPID、CloneMem、HorizonBench 这些清一色是 authored 探针、不可核查的标签。只有 RealCompanion 一行是五个维度全满:纵向、逐字原文探针、有证据、测弃权、标签可追溯。
| 维度 | LoCoMo / LongMemEval 等生成式 | RealCompanion |
|---|---|---|
| 对话来源 | LLM 生成 | 真实用户,逐字原文 |
| 记忆需求频率 | 构造决定,几乎每题都需要 | 自然发生率 3.4% |
| Persona | 开场声明 | 从对话推导,可被推翻 |
| 标签依据 | 无法核查 | 每条标注指向具体消息 |
| 弃权/克制 | 大多不测 | 434 个冷启动探针专测 |
🏗️ 数据集:10 个人,27,218 条消息,120 天
数据来自一个 AI 伴侣应用的运营库——不是招募志愿者来"做任务",就是真实用户的日常使用。脱敏方式是逐句改写:直接标识符替换成一致的替身,"说了什么、为什么说、回应的上下文"保留,用词换掉。时间戳按每人一个偏移量平移,所以间隔是准的,但具体日期和星期几不携带信息。这个改写代价也不小,30 条聊天测试行因此作废。
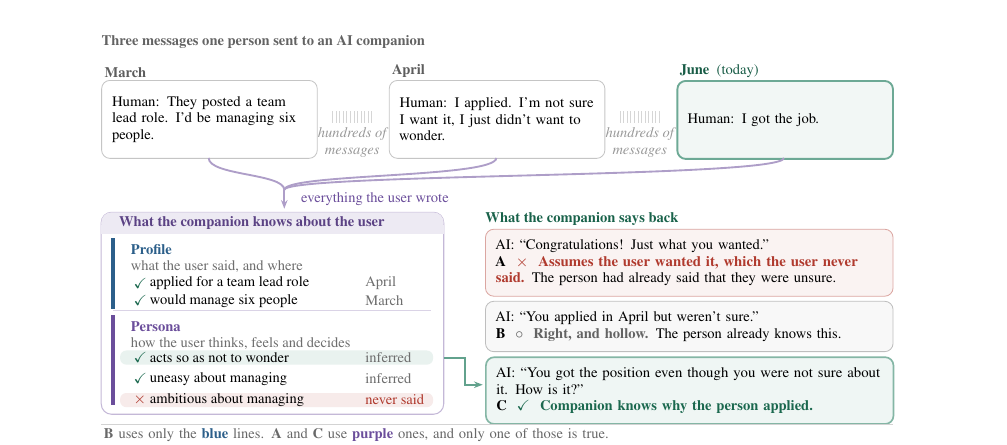
Figure 1 是全文最精髓的一张图。同一个用户:三月说"公司挂了个团队主管的岗位,要管六个人";四月说"我申请了,我不确定我想要它,我只是不想留下悬念";六月(今天)说"我拿到这个职位了"。伴侣对此构建了 Profile(事实层:申请了主管岗、要管六个人)和 Persona(推断层:行事是为了不留悬念、对管理他人感到不安——这两条有依据;"对管理岗位有野心"——用户从没说过)。右边三种回复:A 说"恭喜!正是你想要的",用了那条脑补出来的 persona,错了;B 说"你四月申请了但不确定",只用 profile,对但空洞;C 说"你在不确定的情况下还是拿到了这个职位,感觉如何",用对了 persona 加 profile,才是真正懂这个人的回答。
这张图把整篇论文的两个核心问题讲清楚了:理解一个人 = 知道他是谁(答案跨消息稳定)+ 知道他哪句旧话在此刻重要(答案随每条消息变化)。两个答案都是对一个真人的断言,而断言只能用这个人真正说过的话来检验。
每个参与者是一份自包含的实例,五份文件:source(完整对话)、profile(陈述过的事实,3,580 条 claim、6,784 条消息引用,每条带置信度和生效时间窗)、persona(怎么思考、怎么感受、怎么做决定,每条推断都挂着支撑消息)、chat ground truth(1,533 条可评分的聊天测试项)、question set(3,312 道问答题,覆盖 16 个类别)。
| 用户 | 跨度天数 | 活跃天数 | 消息数 | 聊天题 | 问答题 |
|---|---|---|---|---|---|
| U01 | 36 | 9 | 115 | 28 | 23 |
| U05 | 46 | 23 | 420 | 37 | 47 |
| U06 | 120 | 53 | 1,349 | 81 | 110 |
| U08 | 68 | 50 | 2,918 | 221 | 304 |
| U09 | 111 | 111 | 7,243 | 434 | 991 |
| U10 | 115 | 95 | 12,627 | 482 | 1,257 |
| 合计 | — | 430 | 27,218 | 1,533 | 3,235 |
注意这个分布:U09 和 U10 两段最深的关系占了 73% 的消息量,几乎是其余八段总和的三倍。作者很坦白——深度不会跨人累加,那八个轻度用户恰恰代表了大多数人对陪伴产品的使用方式,系统必须从少得多的材料里理解他们。
🔧 标签是怎么造的:一条五阶段的推导流水线
聊天题的标注不是人拍脑袋写的,也不是模型一口气生成的,而是一条可审计的流水线。这部分我觉得是全文工程含量最高的地方。
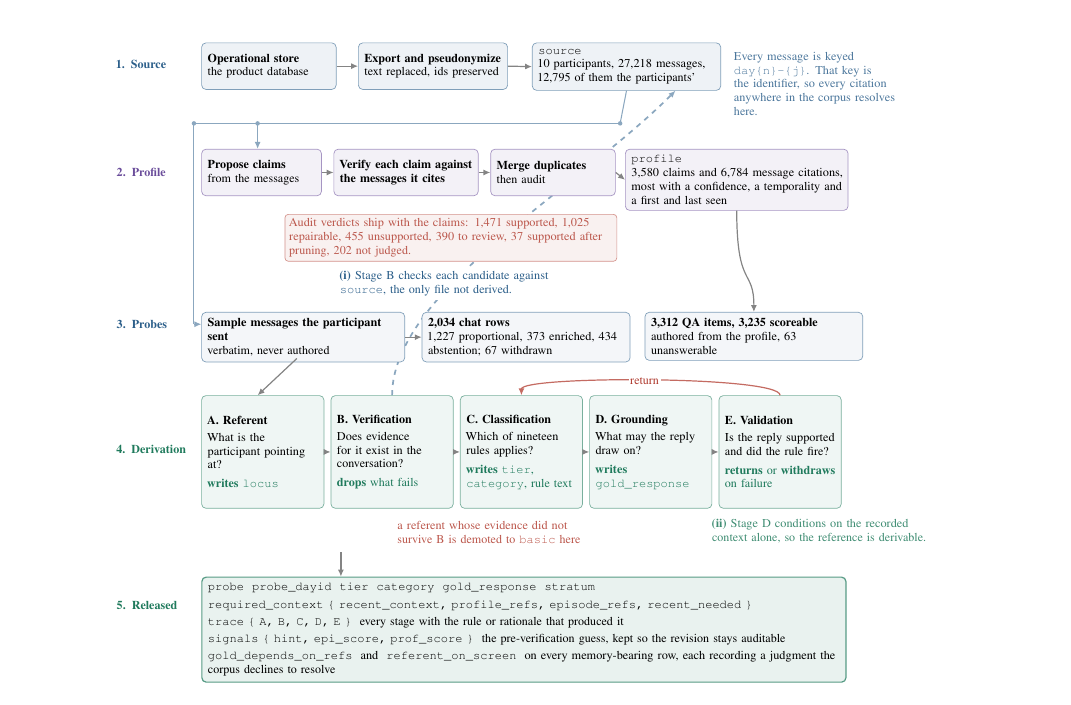
Figure 2 展示了五个层级:Source 层从运营库导出并假名化;Profile 层提出 claim、逐条对照原文验证、去重后审计(审计结论随 claim 一起发布:1,471 条支持、1,025 条可修复、455 条不支持、390 条待复核);Probes 层抽样用户真实发送的消息;Derivation 层五个阶段——A 判定探针指向什么、B 对照 source 验证证据(不过就丢)、C 按 19 条固定规则分类、D 在已记录上下文内写参考答案、E 校验回复是否被证据支撑;Released 层发布的每个 item 带着完整的推理轨迹。
几个设计细节值得单独拎出来:
- 探针分三层:proportional 层是随机抽样(1,169 条),只有它能回答"记忆需求的真实发生率";enriched 层(364 条)专门捞需要深历史的样本;abstention 层是 434 个会话开场白,什么都不需要——专门抓"过度检索"的系统。这最后一层我觉得特别聪明:一个检索永远有收益的 benchmark,永远发现不了检索太多的毛病。
- 推理轨迹和决策在同一次调用里写出,不是事后补的解释。每条标签可以被质疑到具体哪一步。
- 验证只能删不能加,所以验证错误只会让记忆需求率偏低——也就是 3.4% 这个数是下界,真实需求只会更少不会更多。这个单调性论证(论文里叫 Proposition 1)是给批评者预先准备的盾牌。
推导过程扔掉了大量初稿:Stage A 给 806 条消息提出了远距离指代,Stage B 只验证通过 422 条;最终轮次 B 匹配了 1,544 条 profile claim、只留下 752 条。最终标签和"表面信号猜测"在 685/1,533 个 item 上不一致——也就是说,一个便宜的检索门控凭表面特征猜,将近一半的题会猜错。
📊 实验结果:三个耳光,一个比一个响
第一巴掌:人很少翻旧账,翻了也是翻很旧的账
在随机抽样的 proportional 层上,只有 3.4% 的用户消息(置信区间 [2.5, 4.6])携带经过验证的记忆需求,严格口径下只有 1.3%。用另外两套程序在样本外的 11,369 条消息上复核,得到 3.2% 和 1.73%——量级一致。
而且需求极度不均:10 个人里有 3 个(严格口径下 5 个)连一条记忆型探针都贡献不出来。记忆需求是关系深度的属性,不是语言的属性。
更深的是距离。当一条消息真的需要过去时,它需要的最远那条消息,中位数埋在 2,157 条之前,上四分位 5,114 条,最远 12,542 条。就连"最近的必需消息"中位数也在 450 条之前。滑动窗口?早就滑没了。
第二巴掌:检索在真正需要它的地方失灵,而池化分数把这事掩盖了
在那些需要远距离记忆的 item 上,hit@5 的成绩单是这样的:
| 方法 | 全部 item | 按人均 | 依赖型 item |
|---|---|---|---|
| Random | 0.005 | 0.004 | 0.000 |
| Recency(仅用户消息) | 0.015 | 0.014 | 0.006 |
| Recency | 0.022 | 0.029 | 0.024 |
| BM25 | 0.248 | 0.424 | 0.347 |
| Oracle | 1.000 | 1.000 | 1.000 |
Recency——也就是滑动上下文窗口天然施加的顺序——命中率 0.022,只比随机好四倍;BM25 好十一倍,0.248,但四分之三还是找不到。
真正精彩的是池化的陷阱。把 1,477 条带参考集的聊天探针混在一起算(其中 72.6% 其实用当前线程就能回答),recency 的命中率是 0.959,BM25 只有 0.236——排序完全倒过来了。BM25 在两个子群体上的成绩几乎不动,recency 却差了四十倍。一个池化的检索分数,报的是语料的成分,不是系统的能力。
看到这组数的时候我愣了一下。这基本解释了为什么那么多记忆系统论文的 ablation 看起来都"work"——当 96% 的测例根本不需要记忆时,你测的是别的什么东西。
上下文消融把这件事钉死了。同一个生成器,五种输入条件,内容匹配分(0 到 2 分制):
| 条件 | 供给的上下文 | 全部 item | 按人均 |
|---|---|---|---|
| C0 | 无 | 1.431 | 1.286 |
| C1 | 前 3 条消息 | 1.622 | 1.587 |
| C2 | 记录的必需消息(oracle) | 1.763 | 1.736 |
| C3 | BM25 检索的 10 条 | 1.426 | 1.352 |
| C4 | 前 10 条消息 | 1.625 | 1.584 |
把 C1 换成 C2,总分涨 0.140。但把这个增益拆开:\(\pi\gamma_1 = +0.004\),\((1-\pi)\gamma_0 = +0.104\)——96% 的增益落在了根本不需要记忆的探针上。而在 167 条参考答案真的依赖记录消息的 item 上,同样的替换值 0.455。需求稀少的地方,池化的消融差值测的是语料成分;只有拆开才能看到记忆的真实作用。
还有一个更扎心的对照:预算、标题、排序全部对齐之后(C3m 对 C4m),BM25 选出来的 10 条比纯粹的前 10 条还差 0.189 分。给什么消息和给多少消息一样重要——用词面匹配去选,不如直接给最近的。
那直接加大窗口行不行?Figure 4 给了量化答案。
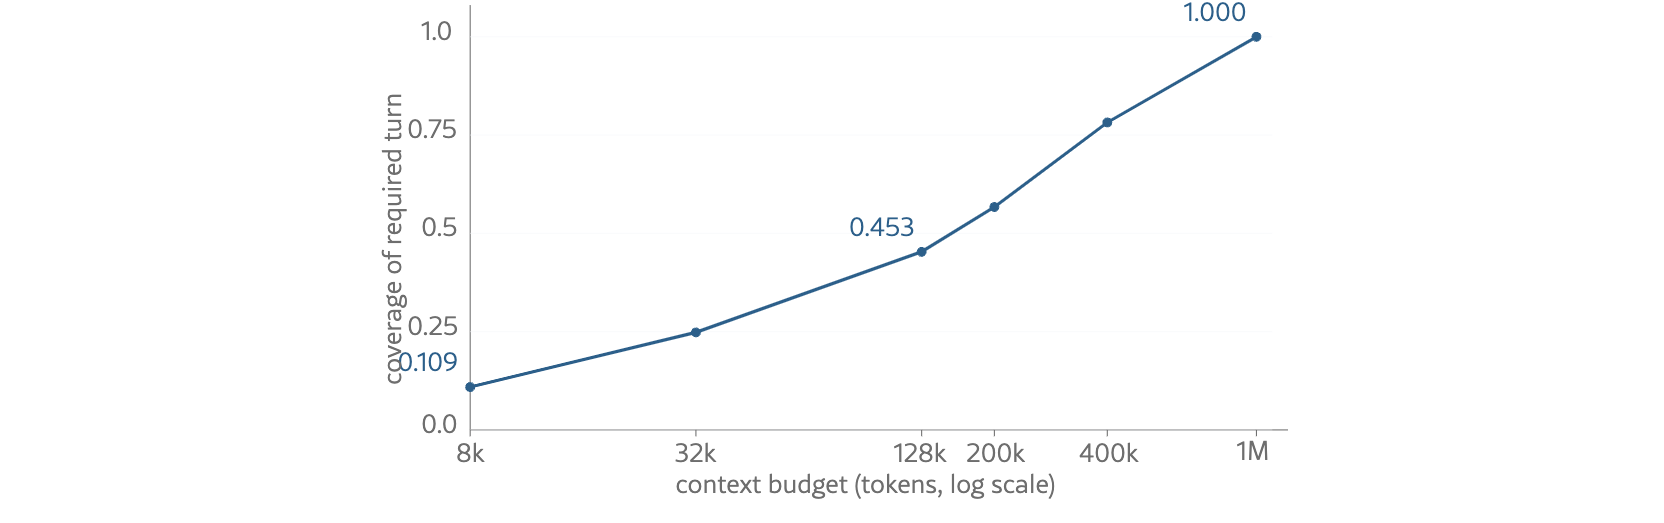
Figure 4:记忆型探针的"必需消息被窗口完整覆盖"比例随上下文预算变化。8k token 覆盖 10.9%,128k 覆盖 45.3%,200k 覆盖 56.7%,要到一百万 token 才到 100%——而一百万 token 恰好就是这个语料里最长单人历史的量级(841,994 token)。按轮数算更直观:保留最近一千轮只对 30.9% 的记忆型探针完备,要 95% 完备得留一万轮——比 10 段关系里 9 段的全部历史还长。
在这个尺度上,长上下文和检索不是二选一的关系。窗口大到让检索失去必要,那这个窗口比大多数关系本身还长。
第三巴掌:系统不知道何时该回忆,还容易被"记忆"两个字忽悠
这是全文我最喜欢的一组实验。一个检测器看着探针和它的前三条消息,判断"这条需不需要翻旧账"——在真实聊天探针上 AUROC 只有 0.530(置信区间 [0.488, 0.572]),对冷启动是 0.548。基本等于瞎猜。就算对着自己的目标调优到 0.601,阈值也只能抓住 40 条需要记忆的探针里的 6 条,同时拉起 40 个误报。
有意思的是,在 authored 的问答题上同一个检测器能到 0.802——因为写出来的问题和它的证据共享更多词。这反过来又是一次对生成式 benchmark 的控诉: authored 题把"何时需要检索"这个最难的判断变容易了。
更麻烦的是误触发。不给上下文时,模型在 434 个冷启动加 120 条无指代探针上的误触发率是零——它从不凭空翻旧账。给了上下文就变了:消息是为探针精选的,误触发率 29.2%;随手给 10 条,60.8%。而最离谱的是框架效应:同样 10 条消息,标成"检索到的记忆"比标成"本聊天的早些时候轮次",模型引用过去的频率高出 10 到 14 个百分点——包括那些根本不需要记忆的探针。换个标签就换了个脑子,这个发现对做记忆层产品的人来说应该后背发凉。
重构 track:三个系统都读懂了人,也都脑补了人
三个智能体系统——Claude Opus 5.5、Codex GPT-5.6-sol、Antigravity 跑 Gemini 3.8 Flash——各自通读每个参与者的完整历史,重建 persona 文件,每人跑三遍:
| 系统 | F1 | Precision | Recall | 处理 token 数 | 自身多次运行一致性 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 0.686 | 0.557 | 0.893 | 546M | 0.935 |
| Codex GPT-5.6-sol | 0.688 | 0.573 | 0.861 | 18M | 0.932 |
| Antigravity Gemini 3.8 Flash | 0.701 | 0.591 | 0.861 | 36M | 0.946 |
三个系统的 F1 挤在 0.69 到 0.70,而处理的 token 量差了约 30 倍。多次运行之间的一致性 0.93 到 0.95,系统之间的一致性 0.86 到 0.88——远高于它们各自和真值文件的一致。 frontier 模型和 flash 档模型之间的差距,并没有拉开成绩差距。
真正值得琢磨的是 precision 和 recall 的裂口:recall 0.86 到 0.89,precision 只有 0.56 到 0.59。翻译成大白话——文件里有的,系统基本都找回来了;但系统每恢复一百个字段,还要再多写七八十个文件里没有的。它们看见了这个人,然后想象了更多。
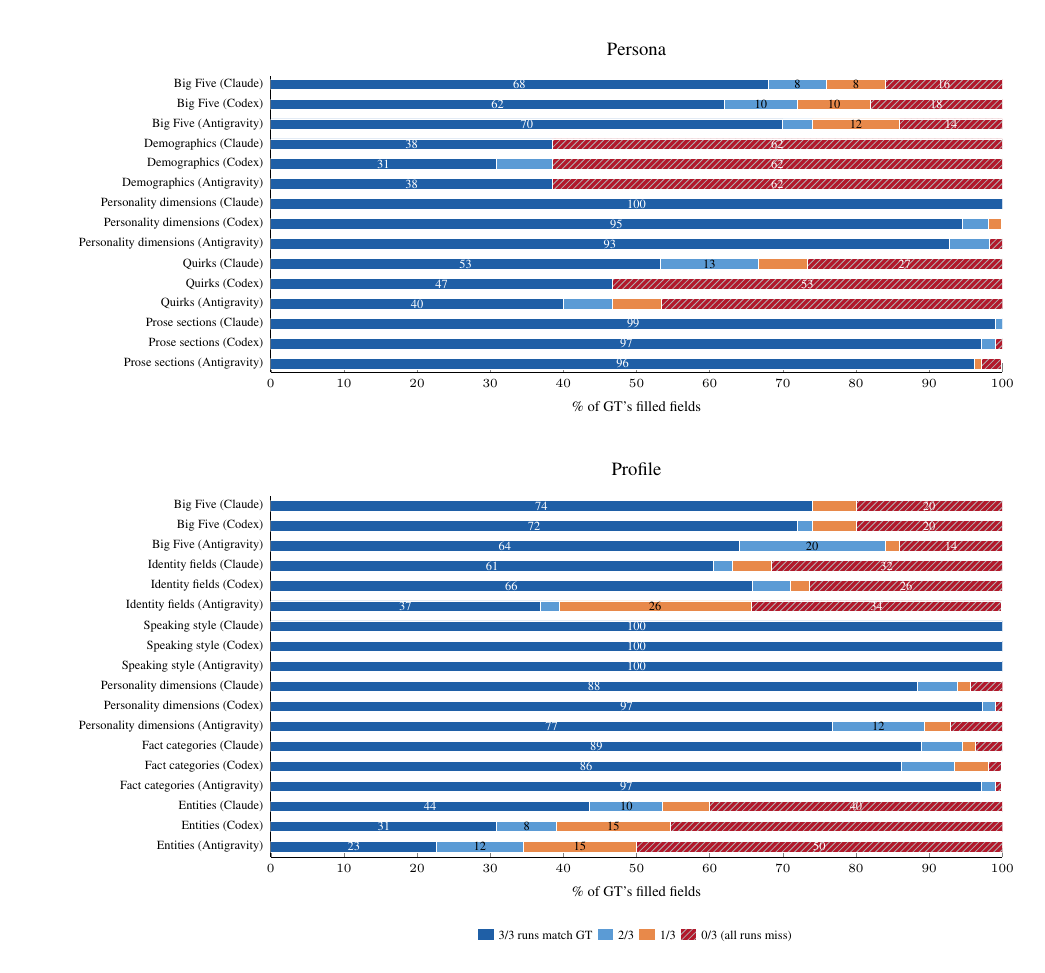
Figure 5:三个系统的三次运行对真值已填字段的投票分布。深蓝是三次全对,红色斜纹是三次全错(系统性偏差)。Persona 侧,prose 段落和 personality 维度几乎全对,但 demographics 有六成左右的字段三次全错、quirks 接近一半;Profile 侧,说话风格、事实类别很稳,命名实体却有大面积全错。那些 0/3 的字段不是噪声,是系统性和真值的偏差。
顺带一提, demographics 三次全错这件事其实和数据本身的性质互为印证:真人几乎从不跟伴侣报户口,人口统计学字段在语料里 91.9% 是空的(160 个槽位空了 156 个),而其余 persona 字段四分之三都有内容。之前 Venkit 等人的工作也发现人口统计学属性只能解释两人回答相似度方差的约 1.5%——拿人口统计学拼出来的合成 persona,描述的几乎是一个无关的人。这篇论文用真实数据又给这个结论补了一刀。
🔬 我的判断
先说亮点。这篇论文最值钱的不是数据本身,是它把"测量陷阱"变成了可以定价的定理。96% 的消融增益落在不需要记忆的探针上——这个数会直接改写很多记忆系统论文的结果解读方式。池化分数报的是语料成分、不是系统能力,这个道理大家嘴上都知道,但把它量化成 recency 在两个子群体间四十倍的落差,是另一回事。还有 abstention 层的设计、标签可争议到具体步骤的推理轨迹、"验证只能删所以 3.4% 是下界"的单调性论证,都是做评测的人可以直接抄的作业。
再说问题,我自己数出来三个。
其一,十个人、一个应用、四个月。作者自己很诚实地承认:这些人是自己选择用这个产品的,既不是陪伴用户的样本,更不是人类的样本;换个产品形态,3.4% 这个数还站不站得住,不知道。我个人觉得 3.4% 的量级大概率是稳的(两套独立程序复核出来的数都在 2% 到 4% 之间),但"中位 2,157 条之前"这种深度数字几乎完全由 U09、U10 两个重度用户贡献,泛化性要打问号。
其二,匿名化改写的代价没有被测量。每条消息都被改写过了,检索和回复评分用的是改写后的文本。BM25 那 0.248 的 hit@5 在原文上会更高还是更低?没人知道。论文只说改写让 30 条聊天行作废,但对分数的影响没有量化。
其三,几个关键判断是单读者做的,没有一致性指标;评分 judge 和人工裁定在 graded 尺度上 κ 只有 0.545,意味着所有分级分数都背着这个上限。问答题那边修完之后还有 3.8% 的内容缺陷率。对一篇主打"标签可审计"的论文来说,这些缺口算是坦荡,但也确实是缺口。
和同期工作比,最接近的是 AlpsBench(从 WildChat 整理了 2,500 条长序列),但那是公开论坛式的聊天记录,不是陪伴关系;CUPID 测"选择哪个先前上下文"但报告没有模型超过 50% 精度;HorizonBench 干脆自我定位成"纵向真人数据到来之前的代用品"。RealCompanion 是第一条真的把"代用品"换掉的路。至于"首个"这种字眼,论文自己倒是没怎么用,这点比很多同行克制。
💡 工程启发
如果你在做记忆层或陪伴类产品,有三件事可以直接拿走:
- 给你的系统加一个"要不要检索"的门控,并且用真实数据训它。这个 corpus 提供了 1,129 个负例对 404 个正例的逐探针监督信号,是目前唯一一份能训练检索门控的数据。现有架构之所以每轮都检索,部分原因就是从没有任何语料告诉过它们什么时候不该检索。
- 别再拿池化分数当北极星。按"是否需要记忆"分层报告,至少把 proportional 层单独拎出来看。否则你优化的可能只是语料成分。
- 小心你给上下文块贴的标题。仅仅"检索到的记忆"这五个字就能让模型多翻 10 到 14 个点的旧账。提示词里的 framing 不是装饰,是行为开关。
还有一个更本质的问题这篇论文没解决:它测的是"系统懂不懂这个人",但懂了之后呢?懂一个人和让这个人感觉被懂,中间隔着整个产品。不过这就是另一个故事了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我