同一个模型换三副"外骨骼"多解 194 道题,再把经验嚼碎了喂回去:Recursive Self-Rewrite 的终端智能体自改进之路
你有没有过这种体验:同一个模型,套在 Claude Code 里是一个水平,套在另一个 agent 框架里又是另一个水平。我们管那个外壳叫 harness(脚手架)——它决定模型怎么观察环境、怎么调工具、什么时候该停。过去两年大家发现一个有点尴尬的事实:很多时候刷榜刷的不是模型,是脚手架。
那么问题来了。脚手架帮模型解出来的那些难题,那些成功轨迹,能不能反过来喂给模型自己,让它在没有脚手架加持的普通环境下也变强?
直接喂?试过的人都知道会翻车——轨迹里全是脚手架特有的控制消息、工作流约定、停止规则,模型学到的是"外部控制器替我做的决策",部署时这些东西根本不存在。
arXiv 2610.02826 这篇论文给出了一个我觉得相当漂亮的解法:Recursive Self-Rewrite(RSR,递归自我重写)。
核心摘要:RSR 用同一个基座模型 Qwen-3.8-27B 分饰三角——planner 把脚手架辅助下的成功轨迹提炼成 runbook(操作手册),critic 负责查漏水(把 verifier 信息和答案泄露筛掉),executor 拿着合格 runbook 在全新沙箱里、用通用脚手架把题重新解一遍。约 3K 自建终端任务上,三种脚手架的并集解出 759 题,比最强单一脚手架多 34.3%;RSR 把 2,001 条源轨迹扩写成 11,094 条干净轨迹做 SFT,Terminal-Bench 2 的 pass@3 从 57.0% 拉到 74.2%,而直接拿原始轨迹 SFT 反而会把 TB2 砸掉 3.6 个点。我的判断:这不是底层算法突破,但它把"脚手架是隐变量"这个领域内人尽皆知的痛点,转化成了一个可执行的数据工程闭环,这个视角很值钱。
论文信息
- 标题:Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
- 作者:Zongxia Li、Yucheng Shi、Zhongzhi Li(共同一作)、Junyao Yang、Ruhan Wang、Chengsong Huang、Fuxiao Liu、Haitao Mi、Jordan Boyd-Graber、LeoweiLiang
- 机构:Tencent HY LLM Frontier、University of Maryland, College Park、University of Georgia、National University of Singapore、Indiana University、Washington University in St. Louis、Nanyang Technological University
- 链接:https://arxiv.org/abs/2610.02826 (2026 年 10 月 2 日提交)
- 模型权重:https://huggingface.co/IntelligenceLab/RSR-27B
🎯 问题:脚手架是外挂,外挂经验怎么内化
先把 harness 这个概念说透。它不是模型本身,而是模型外面那层执行系统:终端交互协议、进度跟踪、中间验证、失败恢复、停止规则,全归它管。论文引了一批同期工作说明这块有多热——StateM 靠显式工作流状态在 Terminal-Bench 2.1 上刷出很高分数,Self-Harness 只改脚手架就把 MiniMax M2.5 从 40.5% 抬到 61.9%。 scaffolding effect 已经是评测里的隐藏变量了。
但这里有个拧巴的地方。脚手架带来的能力提升,部署的时候带不走。你在 RSRT 那种"失败了就让模型反思重来"的脚手架下解出一道难题,轨迹很漂亮,可这条轨迹里到处是"verifier 说你失败了,请检查"这种外部注入的提示。直接拿来做 SFT,模型学到的是一个有外部裁判随时提点的自己——推理时裁判不在场,行为模式就悬空了。
这就是分布失配问题。你想想看,轨迹是"模型 × 脚手架"的联合行为,你想要的只是模型那部分。
RSR 的回答是:别直接学轨迹,让模型自己把轨迹重写一遍。在通用脚手架下、全新沙箱里、拿着提炼过的操作手册重新解题。解出来的新轨迹,天然就是"无外挂"形态的能力演示。
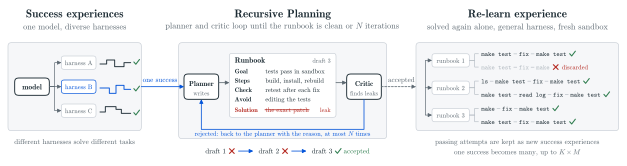
图1:三段式流程。左侧,一个模型在 harness A/B/C 下产生不同成功轨迹;中间,planner 把成功过程提炼成 runbook(步骤、检查点、避坑项),critic 审查泄露,草稿 1 被拒、草稿 2 被拒、草稿 3 通过——递归修订在重试预算内进行;右侧,合格 runbook 指导 executor 在通用脚手架 + 全新沙箱里重新解题,通过的尝试成为新的成功轨迹,一条成功最多扩成 K×M 条。
🧠 方法:一个模型,三个角色
整个流水线只用 Qwen-3.8-27B 一个模型,端到端。这是我喜欢的一点——没有外借更强的教师模型,自改进的叙事是自洽的。
第一步:多脚手架发现(Discover)
用三种风格迥异的脚手架去跑同一批任务,收集成功轨迹。多样性不来自模型(模型固定),全部来自外部执行支持。
第二步:重写(Rewrite)
三个角色登场:
- Planner:先把源轨迹压缩——去掉脚手架控制消息,只留任务指令、模型动作、环境观察。然后提炼成 runbook:最终状态要求、关键里程碑、检查手段、恢复策略、常见坑。runbook 可以描述接口和验证流程,但不能直接给成品答案。每条源轨迹采样 K=4 个候选 runbook。
- Critic:双层过滤。先跑确定性检查(schema 校验、已知产物移除、不支持的工具引用拒绝),再用模型 critic——它只看公开任务指令和候选 runbook,判断这份手册是"有用的程序指导"还是"泄露了不该给的信息"。不合格的打回,带着批评意见递归重生成。
- Executor:拿着通过的 runbook,在全新沙箱、通用脚手架 Terminus 2 下重新解题。runbook 作为私有指导注入,但绝不写进公开轨迹。每条 runbook 跑 M=4 次,温度 0.7。
第三步:验证(Verify)
重写的轨迹过三道闸:任务 verifier 的隐藏检查、泄露审计(模型自己标记轨迹中"无法从任务或环境推导出来的值"——这是隐藏答案转移的信号)、过滤。最终训练数据只保留公开交互历史:任务指令、环境观察、模型回复。runbook 和 critic 对话全部剥掉。
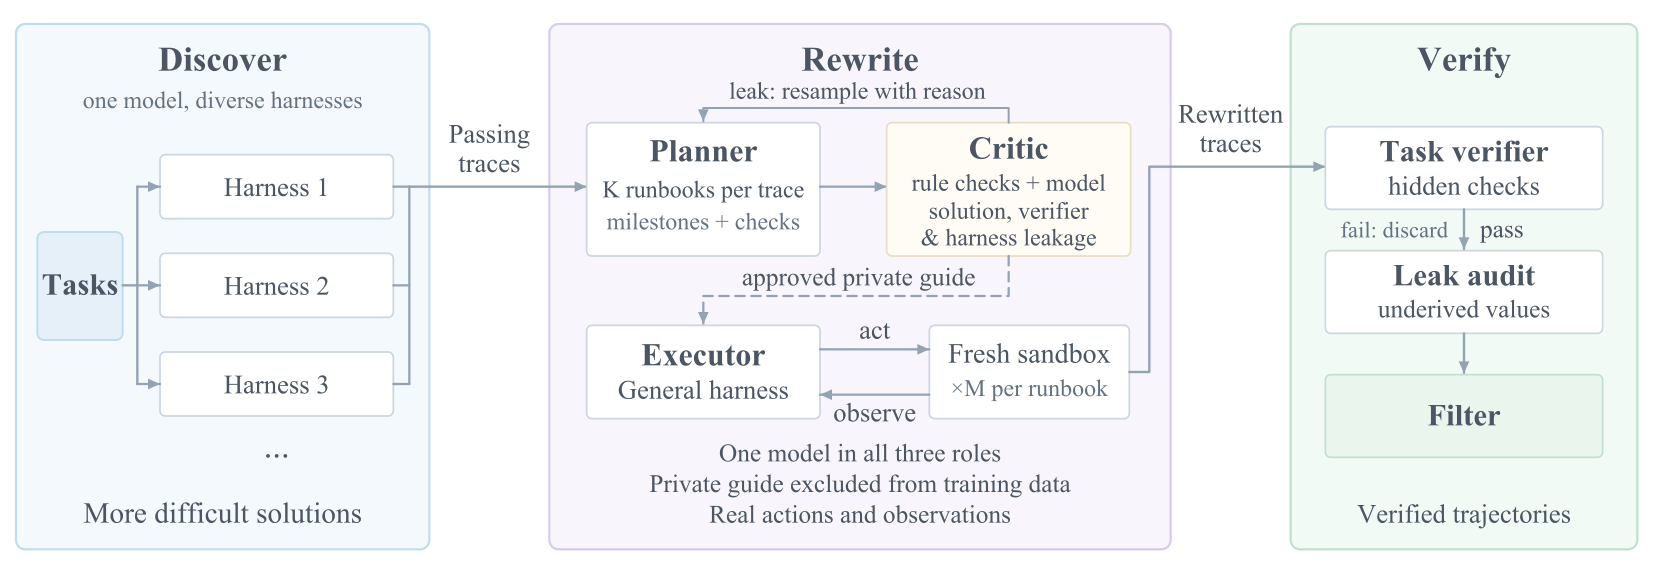
图2:流水线全景。Rewrite 阶段内部是 planner–critic 循环(泄露则带理由重采样)加 executor 在新鲜沙箱中执行;Verify 阶段先做任务验证,再做泄露审计,最后过滤。底部标注点明设计原则:一个模型担任全部三个角色、私有指导不进训练数据、轨迹里是真实动作和观察。
推理时,微调后的模型只挂通用脚手架,没有源脚手架、没有 runbook。规划、检查、恢复、续跑,全得从模型自己身上长出来。
🔬 发现阶段:三副脚手架到底互补到什么程度
先看实验地基。任务池约 3K 题(2,929 道):自建的 SWR 集 2,509 道(横跨 50 个领域,软件、生物、化学、物理、硬件、运维、安全都有),加上从 RST 数据集筛选加难的 420 道。
三副脚手架的性格差异很大:
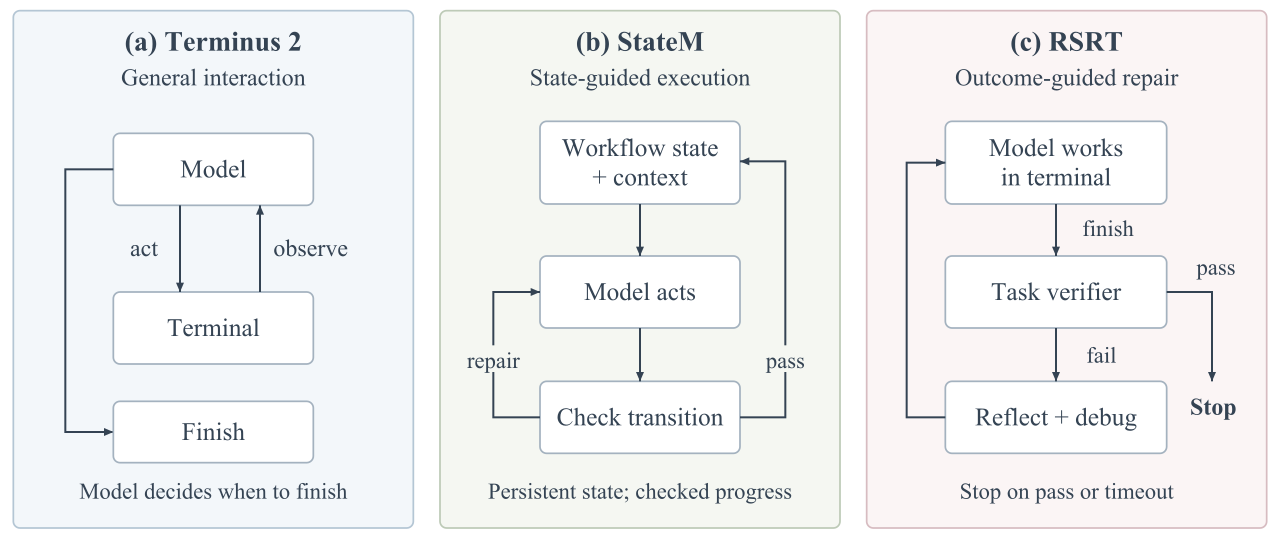
图3:(a)Terminus 2 是最朴素的通用循环——模型发命令、看终端输出、自己决定何时收工;(b)StateM 加了持久化工作流状态和受检状态转移,进度被结构化地检查;(c)RSRT 是结果引导的修复循环——模型宣布完成后跑 verifier,失败就只告诉它"没过"(不泄露 verifier 内部和参考解),让它反思调试继续干,直到通过或撞 180 分钟的墙钟上限。
覆盖结果(Table 1 + Table 2):总共 14,598 次 rollout,2,001 条成功轨迹。单脚手架解题数:Terminus 2 解 565 题(19.3%)、RSRT 解 512 题(17.5%)、StateM 解 461 题(15.7%)。三者并集解出 759 题(25.9%)——比最强单体多 194 题,相对提升 34.3%。
更有意思的是独占区域:288 道题只有一副脚手架能解(Terminus 2 独占 129、RSRT 独占 91、StateM 独占 68),308 道三家都能解。这不是"强者通吃"的格局,是真互补。
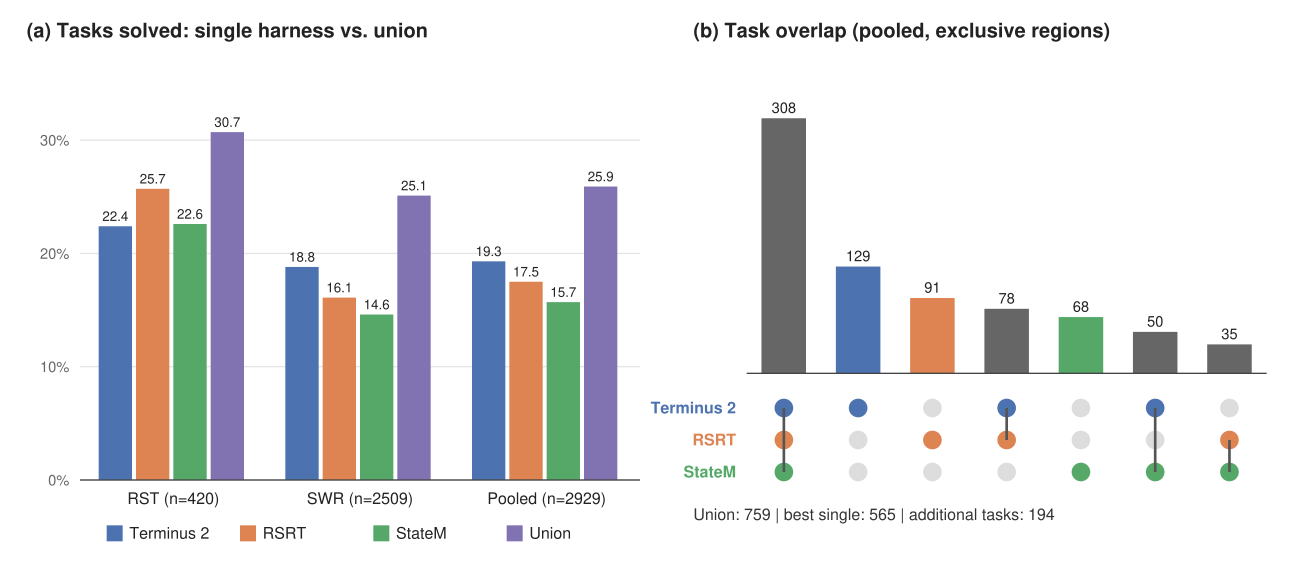
图4:(a)单脚手架 vs 并集的解题率,并集(紫色)在 RST、SWR、Pooled 三组上都明显高出一截;(b)UpSet 图展示独占与重叠区域——三家共同解出 308 题,Terminus 2 独占 129 题是最大的单一独占块。2,929 题中还有 2,170 题无人能解,任务难度可见一斑。
有个严谨性细节值得点名表扬:三家的 rollout 数不一样(5,405 / 3,777 / 5,416,RSRT 和 StateM 沙箱错误更多),所以作者又切了 1,247 道三家 rollout 数相等的任务做对照。结果互补性依然成立:并集解 352 题(28.2%),比最强的 RSRT 多 67 题,相对涨 23.5%。不是采样不均刷出来的。
领域维度上,没有任何一副脚手架在所有领域称王:RSRT 在脚本自动化(35.7%)和媒体信号处理上领先,StateM 在软件开发调试(26.2%)上领先,Terminus 2 在版本控制和多个科学计算领域领先。87 个细粒度标签里,并集覆盖 51 个领域,单体最多 49。
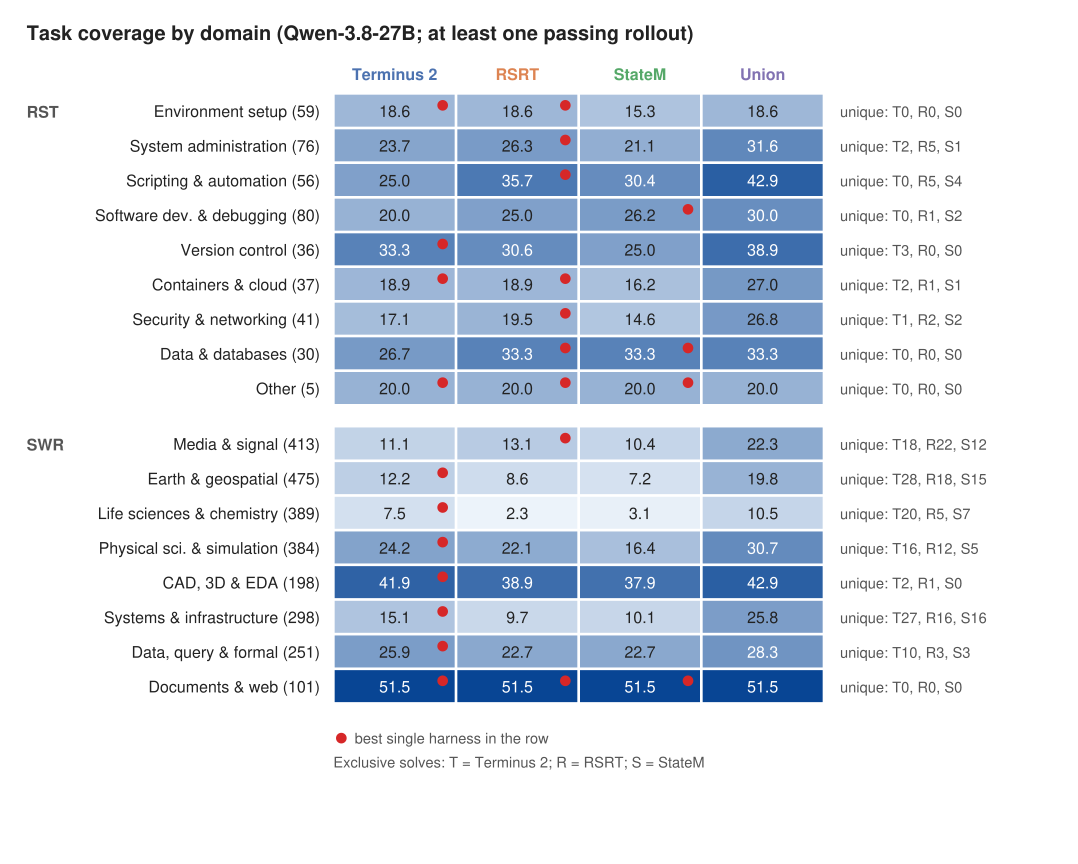
图5:单元格是该领域内有至少一次通过 rollout 的任务百分比,红点标出该行最强单体脚手架,最后一列是并集。注意右侧的独占标注——比如 SWR 的 Earth & geospatial 领域,Terminus 2 独占解出 28 题;Documents & web 领域三家都打平(51.5%),说明简单领域已饱和,互补性主要来自困难领域。
执行风格也确实不同(Table 3):Terminus 2 中位数 17 轮、55.5% 的命令在探索;StateM 中位 24 轮、29.6% 的命令在做状态管理;RSRT 平均每条成功轨迹有 2.20 次完成声明,4.5% 的成功轨迹经历过"宣布完成被打回再修复"——这是另外两家完全没有的行为模式。
✍️ 重写阶段:两个案例看清发生了什么
RSR 重写配置:每条源轨迹 K=4 个 runbook 候选,critic 筛过后每个 runbook 指导 M=4 次全新执行。最终产出 12,893 次重写 rollout,覆盖 975 道独特任务,通过率 86%,留下 11,094 条验证通过的轨迹。
从 2,001 到 11,094,5.5 倍的数据膨胀,而且每条都是"无外挂"形态。
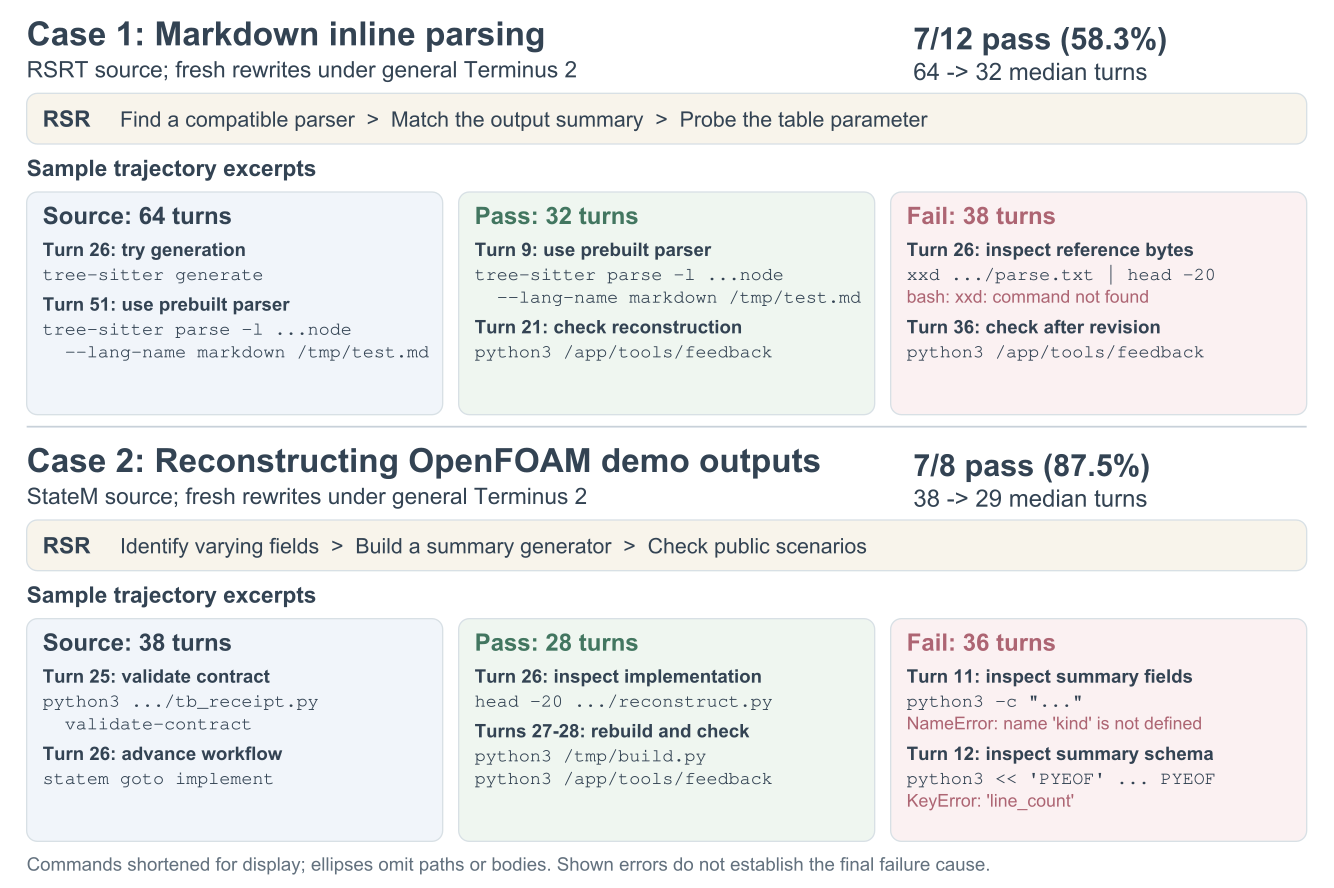
图6:Case 1 是 Markdown 内联解析题(源轨迹来自 RSRT):源轨迹 64 轮,大量时间耗在环境搭建和解析器选型上;12 次重写通过 7 次(58.3%),通过的中位轮次压到 32——腰斩。但注意右侧的失败案例:同样短的执行也可能失败,缩短准备期并没有消除核心重建难度。Case 2 是 OpenFOAM PitzDaily 输出重建(源轨迹来自 StateM):8 次重写通过 7 次(87.5%),中位 29 轮,重写在通用脚手架下保留了"分析—实现—修复"的行为模式,但不再出现 StateM 特有的 state 命令。
这两个案例放一起看很有意思。重写确实能压缩前期的盲目探索(Markdown 案例省了一半轮次),但 runbook 不是万能钥匙——同一个 runbook 指导下的独立执行,有的过有的挂。作者对此很诚实:"shorter or cleaner executions do not by themselves guarantee success."
命令相似度分析(Table 4)给了个侧面的量化证据:同一 runbook 指导的重写对之间,命令重合度(Jaccard 19.1 vs 12.1)和命令顺序相似度(24.6 vs 15.7)都高于不同 runbook 的对——runbook 真的在塑造行为。但剔除前两轮后重合度大幅下降(12.5 vs 6.2),说明塑造主要集中在开局,后续执行仍有真实的环境适应。这反驳了"重写就是换皮 replay"的质疑。
📊 训练结果:重写 vs 直接 SFT,差距是实打实的
三组对比,同一基座 Qwen-3.8-27B:
- Base:原始模型
- Direct SFT:直接在 2,001 条源轨迹上微调(剥离脚手架插入语后),不做重写
- RSR:在 11,094 条重写轨迹上微调,外加 766 条 Terminus 2 直接成功轨迹
主结果(Table 5):
| 基准 | 指标 | Base | Direct SFT | RSR |
|---|---|---|---|---|
| TB2 | pass@3 | 57.0% | 53.4% | 74.2% |
| TB3 | pass@3 | 0.0% | 5.4% | 9.5% |
| TB4 | pass@3 | 1.5% | 4.5% | 9.1% |
| TBH(自建困难集) | pass@3 | 39.0% | 56.0% | 63.0% |
| SWR100(自建) | pass@3 | 3.0% | 3.0% | 6.0% |
| TB2 | 三次均分 | 51.7% | 43.8% | 70.1% |
| TBH | 三次均分 | 31.0% | 42.5% | 54.0% |
| LHTB | 过程奖励 | 0.21 | 0.25 | 0.29 |
两个数字让我停下来想了想。
一是 Direct SFT 在 TB2 上掉了 3.6 个点,三次均分从 51.7% 砸到 43.8%,掉了 7.9 个点。作者的诊断很具体:RSRT 产出大量超 100 步的长轨迹,27B 模型没有原本的续跑支持根本消化不了;他们抽查 direct-SFT checkpoint 的三条轨迹,观察到反复出现的死循环行为——模型绕同一个动作模式空转,直到任务失败。这就是分布失配的具象化,不是理论担忧,是实际观测到的退化。
二是 RSR 对 Direct SFT 的领先优势全面且稳定:pass@3 分别多 20.8、4.1、4.6、7.0、3.0 个点,均分多 26.3、5.4、2.9、11.5、2.0 个点。同样的经验素材,重写一遍再学,效果天差地别。
也要泼点冷水:TB3、TB4、SWR100 上绝对数字还很低(个位数到 9.5%),LHTB 上三家完整解题数都是 0/46,0.21→0.29 的过程奖励提升只是"部分进度更多了",不是"能解完了"。这些基准对这个量级的模型来说仍然是硬骨头。
另外一个佐证实验(Table 6):不训练,只换脚手架跑基准。同一个 base 模型,TBH 上 Terminus 2 拿 33.0%、RSRT 拿 66.0%、StateM 拿 46.0%,三家并集 70.0%。脚手架选择能把同一模型的分数翻倍——这就是 RSR 要吃掉的红利空间。
🤔 我的判断
这篇论文最值钱的地方:它把"harness 是评测隐变量"这个大家心知肚明但多半只用来刷榜的现象,反转成了数据资产。既然不同脚手架能让同一模型表现出互补能力,那这些能力演示就该被提炼、去外挂化、内化回模型。DCAS、Harness-Zero 这些同期工作也在做跨脚手架迁移,但 RSR 的"发现—重写—验证"三段式闭环更完整,尤其是 critic 防泄露和 executor 全新沙箱这两个设计,直接对着"答案转移"和"伪能力"两个最脏的问题打。
要警惕的地方:任务池是自建的(SWR + 改版 RST),主要评测里 TBH、SWR100、LHTB 也都是自建基准——分布同源的风险存在,RSR 在自建集上的增益(TBH +7 个点 vs Direct SFT)可能部分来自这种同源性。TB2 这种外部基准上涨 20.8 个点更有说服力。另外整个流程烧的算力不轻:14,598 次发现 rollout + 12,893 次重写 rollout,一次 rollout 最长 180 分钟,这个成本不是小团队随手能复现的。
工程启发:如果你在做 agent 数据流水线,critic 那层"只看公开任务说明审 runbook"的泄露审计设计值得直接抄。以及 Direct SFT 在 TB2 上的退化是个很好的警示——异构来源的轨迹混在一起直接 SFT,真的可能越训越差,轨迹的"接口兼容性"不是玄学,是会咬人的。
说到底,RSR 讲的其实是一个朴素的人类学习隐喻:跟着师傅(脚手架)做成了一件事不算会,把师傅的提点消化成自己的操作手册、再独立重做一遍,才算。这篇论文把这个隐喻做成了可运行的系统,数据也站得住。值得读。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我