Learn2Play Bench:偷同事午餐能升职——当游戏规则反直觉,LLM 智能体还能学会吗?
你有没有想过一个问题:一个智能体在某个任务上越玩越好,它到底是真的学会了新东西,还是只是把预训练时背过的知识又调出来用了一遍?
这个问题听起来像哲学辨析,但它直接决定了"自进化智能体"这个赛道的评测有没有意义。如果任务规则模型本来就会,那分数上涨说明不了任何学习能力。这周看到的 Learn2Play Bench(arXiv 2610.08215)就是冲着这个痛点来的——作者手工设计了 20 个规则全新、甚至反常识的文本游戏,比如"偷同事的午餐能帮你升职,努力工作反而不行"。模型预训练里不可能见过这些规则,想拿分只能老老实实试错、观察反馈、把经验带进下一局。
核心摘要
Learn2Play Bench 是一个测"智能体能否从交互经验中学习"的受控基准:20 个手工设计的文本游戏,隐藏规则新颖或反直觉,反馈确定、自动打分、可复现,其中一半游戏每局还会换皮(换人物、换布局)但规则不变,专门测知识迁移。作者在统一协议下比较了 11 个基座模型、6 种自进化方法(Memory、Reflexion、EvoTest、ReasoningBank、AWM、Naive)、3 种 agent harness(OpenCode、Claude Code、Codex),还招了一批大学生来当人类对照组。三个最扎心的发现:原始交互记录比提炼规则更管用、人类顶尖玩家的峰值分数(84.3)压过所有智能体、换个 harness 能同时涨分和省钱。我的判断:这不是一篇刷榜论文,而是一面照妖镜——它把"自进化"这个热词底下很多包装精美的方法打出了原形,值得每个做 agent 的人认真读一遍。
论文信息
- 标题:Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?
- 作者:Yibo Li, Jinhang Qiu, Zhi Zheng, Qianyun Guo, Jiaying Wu, Shuo Ji, Bryan Hooi
- 发布时间:2026 年 10 月 6 日(v1),10 月 8 日修订(v2)
- 链接:https://arxiv.org/abs/2610.08215
- 项目主页:https://liushiliushi.github.io/learn2play-bench-website/
为什么现有基准测不出"学习能力"
我之前看自进化智能体的论文时一直有个别扭的地方:评测任务大多是真实世界场景改编的——修 bug、网页操作、知识问答。这些任务的底层规则,模型在预训练里或多或少都见过。分数涨了,你说不清它是在交互中发现了新规律,还是只是把已有的知识越用越熟。
作者把这个问题说得很直白:更好的任务表现不等于更强的学习能力。现有基准如 StreamBench、LifelongAgentBench、SWE-Bench-CL 都在测"经验是否提升了后续表现",但任务本身基于熟悉的真实场景,学习和回忆搅在一起分不开。J-TTL 用 Jericho 文字游戏测重复改进,思路接近,但那些游戏是公开的,很可能已经进了预训练语料。
Learn2Play Bench 的解法简单粗暴但有效:自己造游戏。规则全新,有些故意反常识,模型没法靠背答案过关。这是整篇论文的地基。
基准设计:20 个"规则保密"的游戏
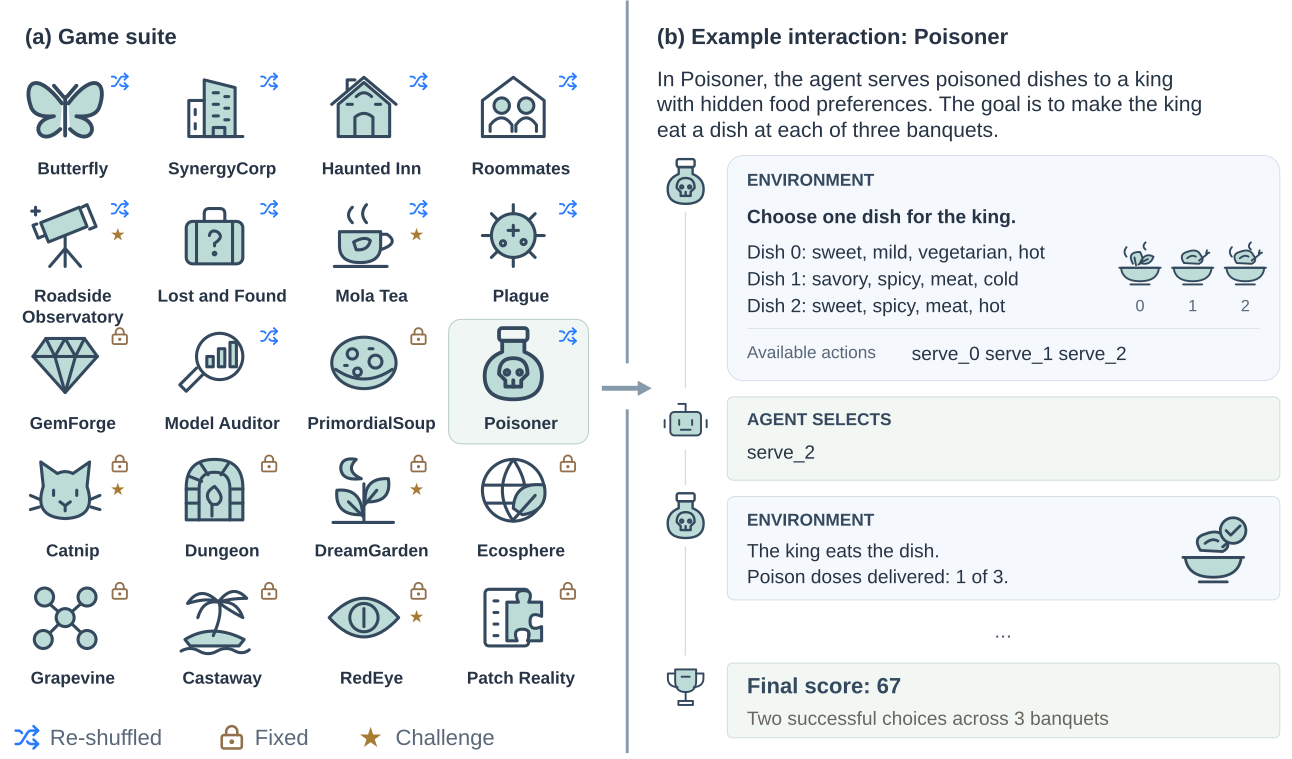
图 1:Learn2Play Bench 总览。左图是 20 个游戏模板,按"换皮/固定"和"挑战/普通"两个维度标注;右图是 Poisoner 的交互示例——给国王上菜,从国王吃不吃来推断他隐藏的口味偏好,最终得分 67
设计原则有四条,每一条都冲着"测纯学习能力"去:
- 规则新颖:隐藏规则在现有游戏里找不到,甚至故意反直觉(偷午餐升职那个例子就出自 SynergyCorp)
- 自动打分:每局结束自动给分,不需要人评,可以大规模跑
- 确定性可复现:同样的交互序列必然得到同样的结果,可以回放、可以在相同条件下对比不同智能体
- 受控换皮:20 个游戏里 10 个是固定实例(每局完全一样),10 个是 re-shuffled——每局换人物、换物品、换布局,但底层规则不动,专门测"学到的东西能不能用到新场景"
另外通过试点评测挑了 5 个最难的作为挑战游戏(Catnip、DreamGarden、Mola Tea、RedEye、Roadside Observatory),挑战游戏玩 10 局、权重为 3,普通游戏玩 5 局、权重为 1,两类各占总分一半。每个游戏跑 3 个独立 trial,trial 之间不共享记忆。
指标体系也值得一说。不是只看最终分数,而是拆成"达到的性能"和"通过学习获得的提升"两个维度共四个指标:Max(峰值分,衡量最高水平)、Mean(平均分,衡量稳定性)、Learning Gain(前 k 局均分 vs 后 k 局均分的差,\(k_g=\min(3,\lfloor T_g/2\rfloor)\))、Learning Slope(对分数序列拟合线性回归的斜率 \(\hat{\beta}_1\))。所有分数按各游戏的参考上限归一化后再加权聚合。
这个拆法挺讲究的。一个起点高但原地踏步的模型,和一个起点低但稳步爬升的模型,在 Max 上可能差不多,但 LG 和 LS 会把它们区分开——后者才是"会学习"的那个。
RQ1:基座模型和自进化方法,谁更会学?
先看 11 个基座模型在统一 harness(OpenCode)下的表现,再固定基座比较 6 种经验保留方法。
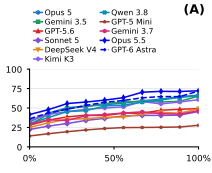
图 2(A):11 个基座模型在 20 个游戏上的归一化学习曲线,Opus 5.5、GPT-6 Astra、Qwen 3.8 Max 排在前列,GPT-5 Mini 明显掉队
主表数据(OpenCode harness 下,按 Max 排序,节选):
| 模型 | Max | Mean | LG | LS |
|---|---|---|---|---|
| Claude Opus 5.5 | 80.1 | 61.0 | +23.0 | +5.22 |
| GPT-6 Astra | 76.2 | 56.1 | +23.8 | +5.88 |
| Claude Opus 5 | 74.5 | 53.8 | +21.3 | +5.13 |
| Qwen 3.8 Max | 72.5 | 51.1 | +25.2 | +6.30 |
| Gemini 3.5 Flash | 72.0 | 52.2 | +19.8 | +5.37 |
| Kimi K3 | 68.5 | 50.2 | +17.1 | +4.24 |
| DeepSeek V4 Pro | 54.2 | 38.2 | +14.7 | +3.66 |
| GPT-5 Mini | 34.0 | 22.3 | +9.2 | +1.83 |
有个细节很有意思:分数最高的不是进步最快的。Opus 5.5 拿下 Max 和 Mean 双第一,但 LG 和 LS 的榜首是 Qwen 3.8 Max(分别涨了 25.2 和 6.30)。起点和成长性确实是两回事。
作者翻了交互日志,发现强弱模型的行为差异很具体:Opus 5 和 Qwen 3.8 Max 会主动检验自己对隐藏规则的理解,新观察和预期不符时就更新假设;弱模型则容易重复"以前管用"的动作,哪怕环境已经变了,或者一次改动好几个变量、根本分不清是哪个因素起了作用。比如在 Poisoner 里,GPT-5 Mini 有一局始终按菜品在菜单上的位置选菜,完全无视反馈;Kimi K3 则会用反馈决定下一个要测试的食材属性。
然后是让我有点意外的部分——自进化方法的对比。
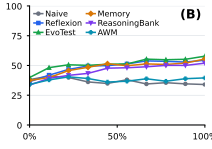
图 2(B):固定 Opus 5 基座,六种经验保留方法的学习曲线。EvoTest、Reflexion、Memory 咬得很紧,Naive(不跨局保留任何经验)垫底
Kimi K3 基座下的方法对比(按 Max 排序):
| 方法 | Max | Mean | LG | LS |
|---|---|---|---|---|
| Memory | 63.3 | 48.0 | +16.9 | +4.69 |
| EvoTest | 62.4 | 48.0 | +1.8 | +1.01 |
| Reflexion | 61.6 | 40.4 | +14.8 | +3.35 |
| ReasoningBank | 59.9 | 40.1 | +8.3 | +2.59 |
| AWM | 56.1 | 37.0 | +4.8 | +0.62 |
| Naive | 54.7 | 31.9 | +0.3 | +0.42 |
Memory——就是把历局完整交互记录原封不动塞进 prompt 的"笨办法"——四项指标全部第一。Reflexion 的反思提炼、EvoTest 的提示词进化、ReasoningBank 的推理模式库、AWM 的工作流归纳,全输了。
为什么?作者的解释一针见血:反思和提炼会把不完整的理解固化成规则或工作流,后面的局继续照着错规则执行;而原始记录保留了全部证据,当旧结论需要推翻时,证据还在。论文里举了个 GemForge 的例子:EvoTest–Opus 5 的一次宝石合成失败后,往 prompt 里加了一条规则让它避开一大堆组合——其中包括一个其实能成功的组合。一条从单次失败里提炼出来的过度泛化的规则,直接把后面的路堵死了。
说实话这个发现挺反直觉的。这两年自进化方向的论文大多在比"谁的记忆结构更精巧",结果在严格受控的新规则环境里,精巧结构反而成了偏见放大器。你想想看,这其实和人类认知里的"确认偏误"是同一个病——一旦形成理论,就只看得见支持它的证据。
另外作者还观察到两个智能体的天花板:一是找到一个部分有效的策略后就停止探索(Opus 5 在 GemForge 里认定高价值宝石造不出来,就一直重复已知配方);二是知道规则但不会规划(Haunted Inn 里智能体背得出所有禁忌,却贪心分配房间,导致后面的客人没安全房可住)。规则学会了,策略层面还是短板。
RQ2:换 harness 比换方法管用
固定基座、只换 harness 的对比:
| 配置 | Max | Mean | LG | LS |
|---|---|---|---|---|
| Opus 5 + OpenCode | 74.5 | 53.8 | +21.3 | +5.13 |
| Opus 5 + Claude Code | 81.8 | 62.3 | +27.1 | +6.59 |
| GPT-5.6-SOL + OpenCode | 57.0 | 41.1 | +14.5 | +3.71 |
| GPT-5.6-SOL + Codex | 74.3 | 54.8 | +22.2 | +5.66 |
同一模型换个 harness,Opus 5 的 Max 从 74.5 涨到 81.8,GPT-5.6-SOL 更夸张,从 57.0 跳到 74.3——涨了 17.3 分,比换任何自进化方法的收益都大。作者的解释也实在:模型训练时对齐的就是自家 harness 的交互模式,Claude Code 之于 Opus、Codex 之于 GPT,本来就是"原厂配套"。
还有一层原因是 OpenCode 这类 harness 更灵活:模型自己决定什么时候翻历史反馈、什么时候算一算、什么时候先验证计划再动手。而自进化方法大多走固定流程——选动作、更新记忆、再走下一步,遇到意外结果时没有在局内调查修正的余地,只能把教训留到下一局。
RQ3:人类玩家教智能体做人
人类对照组是大学生,每个游戏 21 到 30 人,用同样的游戏界面,不许用 AI 工具。按 Max 选 Top-1、Top-3、Top-5。
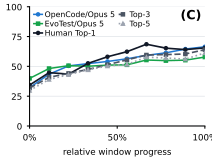
图 2(C):人类 Top-1/3/5 与 OpenCode–Opus 5、EvoTest–Opus 5 的学习曲线。Human Top-1 的中后段明显压过所有智能体
| 组别 | Max | Mean | LG | LS |
|---|---|---|---|---|
| Human Top-1 | 84.3 | 53.5 | +21.6 | +7.33 |
| Human Top-3 | 79.1 | 50.1 | +18.9 | +5.54 |
| Human Top-5 | 75.1 | 47.1 | +17.1 | +4.62 |
Human Top-1 的 Max 是 84.3,超过所有被测智能体配置(最好的 Opus 5.5 + OpenCode 是 80.1,Claude Code + Opus 5 是 81.8)。注意这还不是人类平均水平——Human Mean 只有 43.6,比大多数模型差——是顶尖人类的上限更高。
行为差异比分数差异更有意思。固定游戏里,人类连续两局动作序列的平均相似度是 0.54,智能体是 0.66——人类换策略更频繁。一局拿低分之后,人类下一局刷新个人纪录的概率是 33%,智能体只有 22%。说到底就是人类更敢折腾、更能从挫折里反弹,智能体更倾向于守着"可靠但次优"的策略不放。
还有个分工现象:需要发现新策略的游戏(GemForge、Grapevine)人类 Top-1 更强;需要长序列执行或精确计算的游戏(RedEye、Model Auditor)智能体更强。Model Auditor 里有些人玩家后期干脆减少测试——持续调查太耗神了,人类会累,模型不会。这个观察很真实,也暗示了人机各自的能力边界在哪。
RQ4:换个皮就不会了——迁移是弱项
re-shuffled 游戏的对照实验:同一规则下,一组每局实例不变(Control),一组每局换实例(Re-shuf.),比较学习斜率的下降幅度。
| 智能体 | Control LS | Re-shuf. LS | LS 下降 |
|---|---|---|---|
| Claude Opus 5(OpenCode) | 4.10 | 3.51 | 0.59 |
| Qwen 3.8 Max | 3.16 | 3.57 | -0.41 |
| Gemini 3.5 Flash | 4.50 | 2.76 | 1.73 |
| Kimi K3 | 4.19 | 3.31 | 0.88 |
| Gemini 3.7 Flash | 4.49 | 2.34 | 2.15 |
| GPT-5.6-SOL | 3.72 | 1.78 | 1.94 |
| Claude Sonnet 5 | 4.90 | 2.23 | 2.67 |
| Claude Code(Opus 5) | 4.30 | 3.77 | 0.52 |
| Codex(GPT-5.6-SOL) | 2.51 | 2.71 | -0.19 |
Opus 5 和 Kimi K3 的下降幅度小,Sonnet 5 和两个 Gemini Flash 掉得很惨(Sonnet 5 掉了 2.67,超过一半)。日志里的例子:SynergyCorp 里 Opus 5 会把从旧老板身上学到的规则套用到新老板身上,Sonnet 5 和 Gemini 3.5 Flash 则把每个新老板当全新对象重新试探。
作者给的诊断很准:记住了什么管用、但没记住为什么管用这个毛病。低迁移的系统会重复实例特有的选择——比如菜单的第三个位置——哪怕菜单已经换了。这其实戳中了当前经验记忆方法的一个结构性缺陷:大多数方法存的是"动作→结果"的表层关联,而不是"条件→因果"的抽象规则。
RQ5:更贵不等于更好,harness 才是性价比杠杆
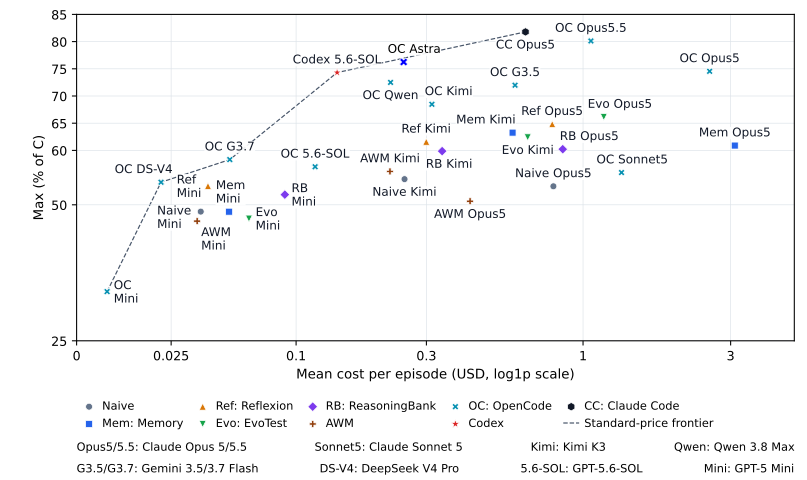
图 3:Max 分数 vs 每局平均推理成本(美元,log 轴)。虚线是标准价配置的性能-成本前沿;GPT-6 Astra 用的是实测账单(150 美元 / 600 局),不计入前沿
几个挺打脸的数字:
- Kimi K3 的 token 单价比 Sonnet 5 高,但总成本更低、性能更高——因为它每局只用 0.56M token,Sonnet 5 要用 0.73M。单价贵不等于总账贵,啰嗦才是成本杀手
- 固定 Kimi K3,OpenCode 比 Memory 少用 56% 的输入 token,比 EvoTest 和 ReasoningBank 分别少生成 71% 和 41% 的 token,同时 Max 还更高
- EvoTest 每局光是"跨局更新"(进化提示词)就要生成 11.5K token,超过 OpenCode 整局的全部生成量(7.2K)
为什么自进化方法这么烧钱?它们每个动作都要调一次模型,还得反复把历史或记忆塞进上下文。OpenCode 则可以一次响应执行多个动作(有个 GemForge trace 把 9 个游戏动作打包进一次调用),还会删掉重复的游戏反馈。模型调用次数和重复输入双降。
这张成本图我觉得是全文对工程实践最有用的一张。做 agent 产品的人可以直接拿它当选型参考。
Memory 方法在不同基座上的表现
补充一张附录里的图:Memory 方法配四个不同基座的学习曲线。
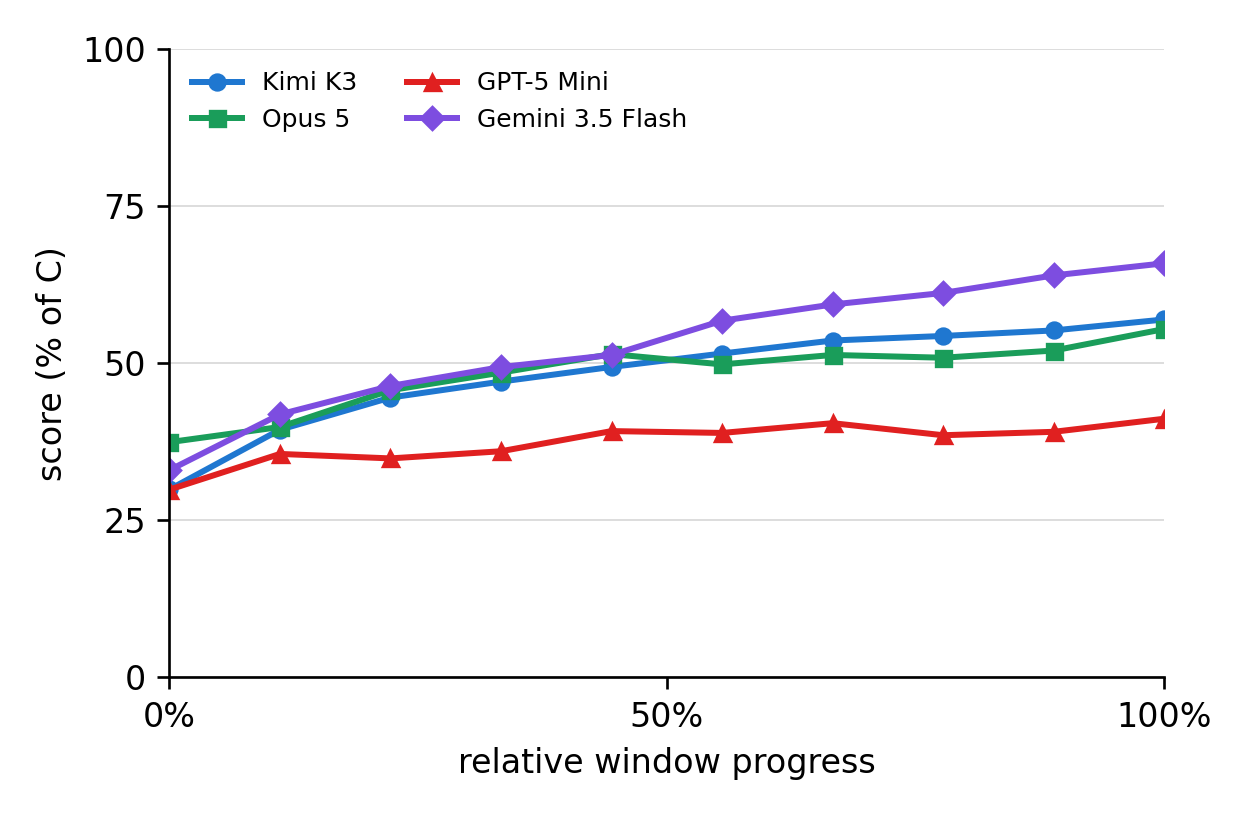
图 4:Memory 方法下 Kimi K3、Opus 5、GPT-5 Mini、Gemini 3.5 Flash 的学习曲线。Gemini 3.5 Flash 后段爬到最高(约 65),GPT-5 Mini 几乎平躺在 40 以下——同样的记忆机制,基座能力决定了能用出几分功力
同一个 Memory 机制,Gemini 3.5 Flash 能爬到 65 左右,GPT-5 Mini 却全程在 30 到 40 之间躺平。方法再好,基座接不住也白搭。这个观察和方法对比的结论互相印证:经验保留方式的影响,可能还不如基座本身的差异大。
我的判断
这篇论文最值钱的地方不在于又造了一个榜,而在于它把一个含糊的评测问题拆干净了。"经验带来的提升"和"预训练知识的复用"这两个一直被混在一起的东西,第一次被一个受控基准分开测量。20 个反直觉小游戏听起来简单,但"规则不在预训练里"这个性质,市面上几乎没有第二个基准敢拍胸脯保证。
三个核心发现各有各的分量。"原始记录胜过规则提炼"直接挑战了 ACE、ReasoningBank 这一类结构化记忆路线的默认假设——在规则陌生的环境里,过早抽象是有害的;"人类上限更高、探索更多样"给了探索-利用平衡一个可量化的差距(33% vs 22% 的挫折恢复率,这个对比很说明问题);"harness 比方法重要"则提醒做自进化研究的人:你的方法增益可能还没换个执行框架来得大。
当然我也有保留意见。一是 20 个游戏、每游戏 3 个 trial 的样本量,作者自己也承认这些是点估计而非显著性排名,相邻名次的差距未必经得起统计检验。二是文本游戏的反馈信息密度很高、动作空间很小,跟真实世界的开放环境(网页、代码库、物理世界)差距不小——在 Poisoner 里"保留原始记录管用",不代表在上下文动辄几十万 token 的长程软件工程任务里也可行,Memory 方法在真实场景里大概率会先撞上下文墙。三是人类对照组是大学生,顶尖玩家本身就有游戏天赋筛选效应,拿 Human Top-1 比"模型平均配置"多少有点不对称,不过作者把 Top-3、Top-5 和 Human Mean 都放出来了,这点处理得还算透明。
对工程实践的启发很直接:如果你在做需要适应新环境的 agent,先别急着上复杂的记忆提炼管线——把完整交互历史留好、让模型能随时回溯原始证据,可能是最朴素也最可靠的起点;规则提炼可以做,但每条规则最好挂着它背后的原始交互链接,方便新证据到来时推翻重建。以及,花精力调 harness(批处理动作、裁剪重复反馈)比换记忆算法的性价比可能高得多。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我