只优化"怎么改"还不够,这篇论文说"改什么"也得跟着进化:ActiveSaddler 给智能体鞍具优化加上了自适应课程
核心摘要
做 Agent 自动优化的人大多盯着同一个问题:怎么从执行反馈里生成更好的 patch(改 prompt、改工具接口、改控制逻辑)。但很少有人问另一个问题——这些反馈是从哪些训练场景里来的?顺序是不是一开始就定死了?ActiveSaddler(arXiv:2610.00906)就抓住了这个盲区:随着 harness(鞍具)不断被修补,最有价值的训练场景也在变,固定顺序的课程会过早放弃没修好的失败、把预算浪费在已经没有油水的场景上。它把"下一轮优化该盯哪类失败"建模成一个非平稳 bandit,用 LLM 从失败轨迹里抽象出可复用的 failure-pattern arm,动态估计每条 arm 的剩余学习价值,并在"回头修已知弱点"和"去探索没见过的场景"之间自适应切换。结果相当能打:同一优化器、同一 rollout 预算下,GAIA2 上 Pass@1 从 55.4% 提到 59.8%(涨 4.4 个点),Terminal-Bench 2.0 上从 72.5% 提到 80.0%(涨 7.5 个点),而且达到同等 dev 准确率花的钱只有 baseline 的零头。这不是又一个大词包装的系统论文,更像是给 harness 优化这个方向补上了一个被所有人忽略的维度——课程表本身也应该是优化对象。
论文信息
- 标题:ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization
- 链接:https://arxiv.org/abs/2610.00906 (2026 年 10 月 1 日,v1)
- 作者:Sungho Park(POSTECH,微软实习期间完成)、Wonjoong Kim(KAIST)、Jue Zhang(Microsoft,通讯)、Wook-Shin Han(POSTECH,通讯)、Pengfei Gao、Chanyoung Park(KAIST)、Yongqiang Yao、Rao Fu、Elsie Nallipogu、Qingwei Lin、Victor Rühle(后五位均来自 Microsoft)
- 项目页:https://aka.ms/ActiveSaddler-website
🎯 问题动机:课程表是死的,鞍具是活的
先交代下背景。所谓 harness,就是套在 LLM 外面的那一圈东西——prompt 怎么写、能用哪些工具、执行循环怎么控制、出错怎么纠。最近一年冒出来一批自动优化 harness 的工作,比如这个团队自己八月份的 AutoSaddler(arXiv:2608.23041),思路是把 harness 优化当成一个离线 mini-batch 学习过程:跑一批训练任务、诊断失败轨迹、生成结构化补丁、在 dev 集上验证、把教训记进 EvoDAG 指导下一轮。这套范式效果确实不错,但所有人的注意力都在怎么改上。
这篇论文问了一个听起来很朴素、细想很扎心的问题:mini-batch 里的任务是哪来的?
答案是——优化开始前就定好的。要么全量训练集轮着跑,要么按某种固定顺序(比如按难度从易到难)排好。问题在于,鞍具每被修一次,"哪些场景还值得跑"这个问题的答案就变一次。没修好的失败模式值得回头再修,修好的就不值得再花 rollout;而当已知的失败都修得差不多了,去探索没见过的场景反而更值钱。固定课程对这两种变化都无动于衷。论文里有个数据很直观:固定顺序优化跑完之后,训练期间观察到的很多失败,最终的鞍具依然没修好——不是修不了,是课程根本没给人家第二次机会。
说实话我第一反应是:这不就是课程学习吗?Graves 2017 年那篇 Automated Curriculum Learning 就用非平稳 bandit + learning progress 干过了。但作者指出的差异很关键:传统课程学习里,任务的效用信号是现成的(loss 下降、TD error);而 harness 优化里,一个训练场景本身不携带任何关于弱点的信息——弱点要执行完才暴露,同一个场景在鞍具演化前后会暴露不同的失败,同一个弱点又会散布在多个场景里。没有现成的信号可用,你得自己造。这就是 ActiveSaddler 要干的事。
🧠 方法:把失败模式当成 bandit 的臂
先给一句话版本:每发现一类反复出现的失败,就实例化一条 bandit 臂;每轮决定是"抽新场景"(Draw)还是"拉旧臂"(Pull);拉哪条臂由 LLM 估计的剩余学习价值决定;优化结果反过来更新臂池和优先级,课程跟鞍具一起演化。
形式化一下。harness 参数记为 \(\theta\),优化目标是在任务分布上的期望表现:
每轮迭代 \(t\),课程策略 \(\pi\) 根据历史信息 \(\mathcal{I}_{<t}\) 选出本批训练场景 \(X_t \sim \pi(\cdot \mid \mathcal{I}_{<t})\),执行后交给固定的优化器 \(\mathcal{O}\) 更新鞍具:\(\theta_{t+1}\sim\mathcal{O}(\theta_t,\mathcal{E}_t,D_{\mathrm{dev}})\)。注意作者刻意把 \(\mathcal{O}\) 冻住不动——他们研究的纯粹是 \(X_t\) 怎么选,这让归因很干净。在固定 rollout 预算下,目标就是找到让最终鞍具期望表现最大的课程策略 \(\pi^{\ast}\in\arg\max_{\pi}\mathbb{E}[J(\hat{\theta}_{\pi})]\)。

图 2(原论文 Figure 2):ActiveSaddler 的迭代闭环。每轮迭代从 Exploration Controller 的二选一决策开始(①):探索未见过场景(②)还是回头拉一条已知失败臂(③,由 Arm Prioritizer 打分后随机采样);选出的场景批次 \(X_t\) 在当前鞍具 \(H_t\) 上执行(④),失败记录交给 Failure-Pattern Extractor 匹配或新建臂(⑤),更新后的状态进入下一轮(⑥)。
这个闭环里有三个组件值得拆开看。
Failure-Pattern Extractor——臂的粒度是全文最关键的设计决策。 为什么不用场景当臂(太碎,同一个弱点被拆到十几个场景里,有限预算下根本轮不到第二次)?为什么不用任务类别当臂(太粗,一个类别里混着好几种不相干的失败,部分场景修好了会掩盖剩下的)?作者选了中间层:让 LLM 独立地把每条失败抽象成一个"症状"候选 \(c_t(e)=g_{\mathrm{ext}}(e,\delta_t(e))\),然后再跟现有臂池对齐归一化 \(\mathcal{A}_{t+1}=g_{\mathrm{norm}}(\mathcal{A}_{t},\{c_t(e)\})\)——能匹配就归并,需要组合就组合,没见过就开新臂。每条臂维护一个模式描述、一组支撑场景和观测证据。这个"先独立抽象、再全局归一"的两阶段设计挺讲究,避免了增量匹配时顺序敏感的问题。
Arm Prioritizer——用 LLM 当 learning progress 的估计器。 理想情况下选臂该看"选了它之后总体性能能涨多少",但这不可观测。作者的解法是让 LLM 综合四个维度打出一个学习进步分 \(\phi_t(a)=g_{\mathrm{select}}(a,\mathcal{I}_{<t})\in[0,1]\):severity(当前鞍具下这个失败模式还活着吗)、fixability(看起来能通过 harness 干预修掉吗)、breadth(修好了能泛化到多大的面)、side-effect risk(动手修会不会引入回归)。然后按 softmax 随机采样:
温度 \(\tau_{\mathrm{sel}}=0.15\)。用随机采样而不是 argmax 是个聪明的选择——分数毕竟是估计值,低分臂的效用会随着鞍具演化翻盘,给它们留点概率,课程才有"回心转意"的能力。
Exploration Controller——Draw 还是 Pull,也交给 LLM 判断。 每轮先做一个二元决策 \(d_t=g_{\mathrm{explore}}(H_t,\mathcal{A}_t,U_t,\mathcal{I}_{<t})\in\{\mathtt{unseen},\mathtt{arm}\}\):已知臂里还有没有值得修的?没有就去未见场景池 \(U_t\) 里无放回采样。另外还有个兜底机制防回归:当所有场景都探索过、每条臂都回访过之后,之前成功过的场景重新进入可探索池——相当于传统离线训练里的"多 epoch",一旦旧成功在新鞍具上翻车,会被正常地抽取出新臂。这个设计省掉了"每次更新后全量回归测试"的开销,挺务实的。
有一点我要坦白:三个组件的核心决策全交给 LLM 判断,论文把 prompt 都放进了附录 K,复现是没问题,但这种"LLM 当控制器"的设计对模型能力的依赖程度有多深,论文没怎么展开。后面会看到消融里拿非 LLM 方案对比,差距还不小——这既说明 LLM 判断值钱,也说明这套方法的成本和稳定性都绑在强模型上。
📊 实验:同一优化器、同一预算,只差课程表
实验设置很克制,我喜欢。底座优化器用 AutoSaddler,benchmark 两个:GAIA2(模拟手机环境里的通用助理任务,按 Universe/persona 做 OOD 划分,train/dev/test = 75/65/300)和 Terminal-Bench 2.0(89 个真实终端任务,随机划分 30/19/40)。任务智能体和优化器都用 gpt-5.5,rollout 预算 \(K=10(|D_{\mathrm{train}}|+|D_{\mathrm{dev}}|)\)(GAIA2 对应 1400 次、TB2 对应 490 次),每轮最多跑 3 个场景。所有方法共享预算,最终报三次测试执行的平均 Pass@1。
主结果如下(原论文 Table 1,GAIA2 测试集 300 题、TB2 测试集 40 题):
| 方法 | GAIA2 Pass@1 | TB2 Pass@1 |
|---|---|---|
| Default Agent / Terminus 2(手工) | 53.6 ± 1.1 | 64.2 ± 2.9 |
| Terminus-KIRA(手工调优) | — | 69.2 ± 3.8 |
| GEPA | 54.2 ± 2.2 | 65.8 ± 5.2 |
| Meta-Harness | 54.2 ± 1.2 | 66.7 ± 5.2 |
| AutoSaddler(固定随机顺序) | 55.4 ± 1.2 | 72.5 ± 0.0 |
| AutoSaddler w/ Category Acc. Order | 55.9 ± 1.3 | 70.8 ± 1.4 |
| AutoSaddler w/ Scenario Acc. Order | 55.7 ± 1.2 | 73.3 ± 1.4 |
| ActiveSaddler | 59.8 ± 1.0 | 80.0 ± 2.5 |
几个数值得停下来看。在 GAIA2 上,ActiveSaddler 比固定顺序的同一优化器高 4.4 个点,比两种按难度排的固定课程高 3.9 和 4.1 个点。在 TB2 上更夸张:比 AutoSaddler 高 7.5 个点,比手工精调的 Terminus-KIRA 高出近 11 个点。要知道 TB2 测试集只有 40 题,方差天然大,但 80.0 ± 2.5 对 72.5 ± 0.0 这个差距还是实打实的。
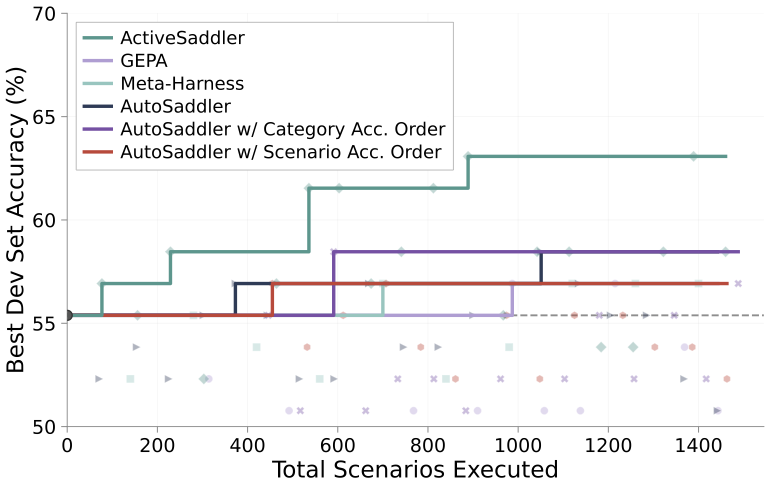
图 1a(原论文 Figure 1a):GAIA2 上 dev 集最优准确率随累计执行场景数的变化。ActiveSaddler(深绿)在约 1000 次执行时就冲到 63% 以上,而 GEPA、Meta-Harness 和固定课程们到 1400 次还压在 55%–58%。
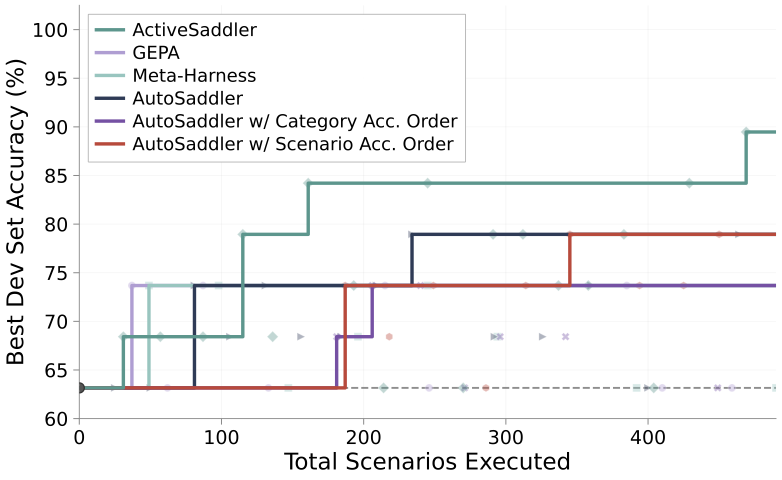
图 1b(原论文 Figure 1b):TB2 上同样的故事。ActiveSaddler 约 200 次执行就到 84% 平台期,AutoSaddler 到 400 次才摸到 79%。
效率维度更能说明问题,因为课程学习的价值说到底就是预算分配。论文把优化器侧的 LLM 开销也算进去做端到端成本对比:GAIA2 上 ActiveSaddler 花 298 美元达到 58.5% dev 准确率,AutoSaddler 要达到同一水平得花 1360 美元——4 倍多的差价。scenario ordering 更惨,花了 1698 美元还只到 56.9%。TB2 上 128 美元对 220 美元。课程层的额外 LLM 调用(GAIA2 上每个 patch 的优化器成本从 7.87 美元涨到 11.44 美元)被任务执行侧的节省完全覆盖了。钱花在刀刃上,这句话在这里有数字支撑。
鲁棒性方面,作者在 GAIA2 上重跑了一次完整优化:ActiveSaddler Run 2 拿到 61.6%,依然压过所有 baseline 的两次运行(55.4–56.6%)。还把课程组件嫁接到 GEPA 上,平均 Pass@1 从 54.2% 提到 57.2%(涨 3.0 个点)——说明这套课程机制不是 AutoSaddler 的专属挂件,对别的优化器也成立。这一点对"课程是独立优化维度"的论点很重要。
🔬 消融:三个组件各自值多少
消融直接做在主表里,拆法很干净——每次只换一个组件:
| 变体 | GAIA2 | TB2 |
|---|---|---|
| ActiveSaddler 完整版 | 59.8 | 80.0 |
| 臂换成类别粒度 | 56.8(降 3.0 个点) | 69.2(降 10.8 个点) |
| 臂换成场景粒度 | 56.2(降 3.6 个点) | 73.3(降 6.7 个点) |
| 去掉 Arm Prioritizer(等分随机) | 55.3(降 4.5 个点) | 72.5(降 7.5 个点) |
| 去掉 Exploration Controller(固定每 5 轮探索一次) | 55.3(降 4.5 个点) | 71.7(降 8.3 个点) |
三个组件缺一不可,而且 TB2 上臂粒度的影响大得惊人——换成类别臂直接掉到比手工 Terminus-KIRA 还低。作者的解释有个量化支撑:failure-pattern 臂采样到的场景中,当前鞍具仍然失败的比例(failure hit rate)比类别臂和场景臂分别高 16.5 和 35.3 个点(GAIA2)、29.9 和 23.8 个点(TB2)。课程喂给优化器的料里"还有油水的失败"浓度更高,就这么直接。
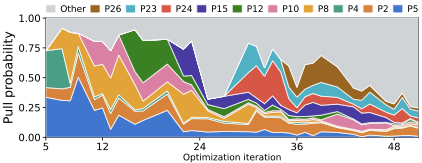
图 3a(原论文 Figure 3a):GAIA2 上各失败臂的 pull 概率随迭代的堆叠面积图。概率质量不断在臂之间迁移——前期集中在 P5、P12 等少数臂上,中后期随旧弱点修复、新臂发现而重新分配,没有固定扎堆。
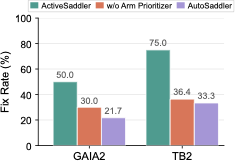
图 3b(原论文 Figure 3b):优化中观察到失败的场景、最终被修复的比例。GAIA2 上 ActiveSaddler 50.0%、去优先级 30.0%、AutoSaddler 21.7%;TB2 上 75.0%、36.4%、33.3%。自适应打分让"修了但没修好"的情况大幅减少。
最有意思的是 RQ3 对探索行为的分析。Figure 4 把 GAIA2 整个优化轨迹画了出来,旁边附了 Exploration Controller 在几个关键迭代的真实决策理由:
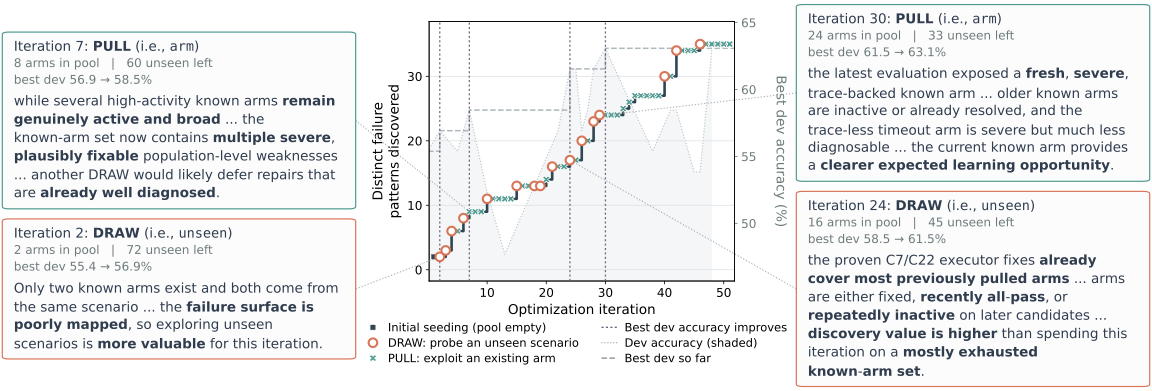
图 4(原论文 Figure 4):累计发现的失败模式数(阶梯线)与 dev 准确率随迭代的变化,红圈是 Draw、绿叉是 Pull。旁边的文本框是控制器决策的原文摘录,比如 Iteration 24 选 Draw 的理由是"已验证的 C7/C22 executor 修复已覆盖大部分已拉过的臂……在基本枯竭的已知臂池上,发现价值更高"。
全局统计也对得上:Draw 比例从前半程的 44% 降到后半程的 20%(臂池大了,已知弱点更值得修);Pull 决策时未解决的臂数平均是 Draw 时的 2.0 倍(GAIA2)和 6.9 倍(TB2),而固定每 5 轮探索的对照组这两个比值是 0.8 和 1.3——基本对"还剩多少没修"无感。控制器确实在看菜下饭。

图 5(原论文 Figure 12):GAIA2 上全部 35 条失败臂的 pull 概率热力图,黄点标记该臂被实际拉起的迭代。可以看到新臂随优化推进不断实例化(对角线式的出现模式),每条臂被拉起后概率通常回落——修好了就降温,修不好就继续热着,课程完全跟着鞍具状态走。
还有一组对"为什么非得用 LLM"的回答:把打分器换成 TSCL 式的 EMA 失败残留分,得 56.7%(比完整版低 3.1 个点);把探索控制器换成 UCB-AIR 的计数规则,得 55.6%(低 4.2 个点,跟固定每 5 轮探索几乎一样)。简单的启发式信号确实能抓住一部分价值(EMA 比不打分高 1.4 个点),但 severity、fixability、breadth 这些需要理解失败语义才能判断的维度,计数器给不出来。
🤔 我的判断
这篇论文真正值钱的不是某个模块,而是把一个被默认冻结的自由度解冻了。harness 优化这个方向过去一年卷的都是"怎么诊断、怎么打补丁、怎么验证",ActiveSaddler 说你们课程表都是优化前排死的——这个观察本身就很尖锐。消融里三个组件各掉 3–10 个点,说明这不是锦上添花,是实打实的预算分配红利。
而且要肯定实验的诚实度:OOD 划分、两次独立运行、换优化器(GEPA)验证迁移性、把 LLM 开销算进端到端成本、甚至主动做了非 LLM 替代方案的对比。这套组合拳在当下的 Agent 优化论文里算严谨的一档。
但几个疑点也得说。第一,三个核心决策全靠 LLM,而 LLM 的判断质量、成本和稳定性论文只给了"比启发式好"的对比,没给敏感性分析——换个弱一点的模型当控制器会怎样?这是个实际的部署问题。第二,TB2 测试集只有 40 题,80.0 ± 2.5 对 72.5 ± 0.0 虽然差距大,但 AutoSaddler 那个 ± 0.0 本身就透着诡异,小样本榜单上的点数我习惯性打个折。第三,这套框架的收益高度依赖"训练集里还有未被发现的失败模式"这个前提——如果训练集很小或失败高度同质化,arm 池很快枯竭,课程自适应的空间就小了。论文 GAIA2 上发现了 35 条臂,算是失败多样性很丰富的场景,换个分布未必如此。
从工程视角看,如果你在做任何形式的 Agent 自动优化(不止 harness,也包括 prompt 优化、RL 的数据选择),这篇论文的 takeaway 是通用的:优化目标的选择应该跟被优化对象协同演化,固定顺序是在烧钱。failure-pattern 臂这个抽象——把失败按"底层缺陷"而不是按场景或类别聚合——也很值得抄,说到底就是给优化器建了一个可维护的"弱点注册表"。
顺带一提,这个工作跟 Graves 2017 的 ACL、Matiisen 的 TSCL 一脉相承,但把 learning progress 从"可观测的 loss 信号"推广到了"需要推断的弱点状态",这个推广是 harness 优化场景下真正的新东西。和同期 Task-CoEvolve、HarnessLens 这些在评估侧做任务选择的工作相比,它动的是训练侧——证据从哪来,而不只是候选怎么挑。位置卡得很准。
📝 收尾
ActiveSaddler 给我的感觉是:harness 优化这个方向开始长出"训练科学"了。当大家把鞍具当成一个要学的东西,那数据怎么喂、课程怎么排,迟早会变成和模型训练一样重要的问题。这篇论文抢先把这个问题形式化掉了,答案也站得住。
下一个更有意思的问题大概是:课程和优化器能不能联合优化?现在 \(\mathcal{O}\) 是冻住的,如果补丁生成方式也能根据课程状态调整,这个循环还能再深一层。另外,LLM 控制器的成本和稳定性,会是这类方法走向实用的真正门槛。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我