让 AI 自己做游戏还不够,这篇论文让它学会"越改越好"——27B 小模型反超 GPT-5.5
核心摘要
你有没有发现一个现象:让大模型一次性生成一个能跑的游戏,现在基本能做到了;但让它把这个游戏持续改好,事情就开始失控——改着改着就原地打转,甚至越改越烂。这篇论文把矛头对准了这个问题:朴素的迭代式优化很容易"过拟合"少数几个测试用例,产出一堆表面能玩、实则到处是 bug 的脆弱游戏。
作者的解法叫 RSIGame:把游戏开发拆成"局部探索-诊断-改进"循环和"全局质量监控"循环,再配一份不断膨胀的开发清单(checklist),让每一轮修改都建立在已验证的证据之上。更狠的是,他们把整个开发过程中积累的成功轨迹拿去微调生成模型,让经验内化进参数。结果相当能打:140 个 GameCraft-Bench 任务、两个引擎、五个生成器上全面涨分;微调后的 Qwen3.8-27B 在 Godot 上拿到 61.38 分,超过 GPT-5.5 单次生成的 50.26 分,生成 token 还省了 11 倍。这不是又一次 prompt 工程的花活,而是一套比较扎实的"开发过程组织学"。
📖 论文信息
- 标题:RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
- arXiv:https://arxiv.org/abs/2609.39045 (2026 年 9 月 30 日提交)
- 作者:Wenyi Wu, Minghao Fu, Jieyu You, Kun Zhou(通讯), Siqi Liu, Aayush Salvi, Yiheng Lin, Ce Zhang, Xiaohan Lan, Jiahui Zhu, Yujie Zhong, Qi She, Biwei Huang
- 代码:https://github.com/WenyiWU0111/RSIGame
- 评测产物:Hugging Face 上开放了 51,644 份打分文件(RSIGame-TableArtifacts)
🎯 问题:能跑 ≠ 能玩,能改 ≠ 改得好
先把背景说清楚。随着长程生成、多模态理解和工具调用能力的进步,让智能体根据一段自然语言描述生成一个完整的游戏项目(代码 + 美术资产 + 配置文件)已经不再是科幻。GameCraft-Bench 这类基准也证明了,VLM 智能体确实能交出"有可识别玩法"的可玩游戏。
但游戏开发说到底是一个多模态工程过程。成熟的人类团队尚且会漏 bug、漏功能、漏边界情况,更何况模型。工程界的标准答案是迭代开发:反复测试当前构建、收集反馈、修改,直到质量达标。这个过程天然就是一种递归自我改进(Recursive Self-improvement, RSI)——每一轮都站在上一轮的肩膀上。
问题在于,朴素的迭代循环会收敛到脆弱的解。智能体很容易盯着少数几个测试用例反复打补丁,表面上满足了目标,实际上大量未测的 bug、缺失的行为、边界情况全留在原地。用论文的话说:开发循环在"过拟合测试",而不是在"改进游戏"。
我自己在做 agentic coding 的时候碰到过一模一样的症状:agent 修了 A 测试就坏了 B 功能,reward 在涨但实际质量肉眼可见在变差。这篇论文给出的诊断很到位——病灶不在"迭代"本身,而在迭代的组织方式。

图 1:论文的三板斧一览。A 部分对比了 baseline(几轮就饱和)与 RSIGame 的阶段式进化;B 部分展示格斗游戏和方块游戏在 Round 0 → 5 → 15 的肉眼可见进化(补上对手、丰富背景特效、打磨 UI);C 部分是核心卖点:Qwen3.8-27B 经过 RSIGame 后 Overall 反超 GPT-5.5。
🏗️ 方法:一个局部循环 + 一个全局循环 + 一次经验内化
RSIGame 的核心思想一句话讲完:把游戏开发当成一个需要被管理的长程项目,而不是一连串孤立的编辑操作。

图 2:框架全貌。左侧是免训练的递归自我改进:全局循环负责质量监控和高层指导,局部循环是 Explore→Diagnose→Improve,四个智能体围绕共享 checklist 协作,底部是不断进化的游戏 checkpoint 序列。右侧是训练侧:把验证过的开发经验(生成/规划/修复轨迹)蒸成训练数据,SFT 出更强的生成模型。
局部循环:探索-诊断-改进
局部循环有四个角色,分工相当清晰:
- Controller(控制器):读游戏规格 \(x\)、当前项目 \(P_t\)、开发清单 \(\mathcal{C}_t\) 和可选的阶段级指导 \(\gamma_s\),决定下一轮探索方向 \(d_t\)。它是项目经理,决定"这轮该测什么"。
- Explorer(探索者):拿着方向去实际玩游戏,产生一条交互轨迹 \(\tau_t\),把 bug、缺失行为、改进机会变成具体证据。
- Editor(编辑器):根据证据提出修改 \(\Delta_t\),得到 \(P_{t+1} = \operatorname{Apply}(P_t, \Delta_t)\)。
- Verifier(验证者):重新跑一遍修改后的游戏,产出验证结论 \(v_t\)——目标问题修没修好?有没有引入回归?
串起这四个角色的是那份进化中的开发清单 \(\mathcal{C}_t\)。每轮结束时按
更新,记录已发现问题、优先级、验证结论。这个设计的妙处在于:清单只会膨胀不会遗忘,持续把开发过程推出"少数测试用例"的舒适区。你想想看,如果每轮都从零开始决定测什么,智能体大概率会去重复测那些它"知道怎么测"的东西——这就是过拟合的来源。清单机制相当于给系统装了长期记忆。
全局循环:别让后面的修改毁了前面的成果
局部循环管"每轮怎么改",全局循环管"整个过程往哪走"。它有两个组件:
游戏质量监控器。在每个全局评估点,把刚产出的 checkpoint 和保留的最佳 checkpoint 比较,执行 \(P_s^{\star} \leftarrow \operatorname{SelectBest}(P_s^{\star}, P_{t+1})\)。注意一个关键细节:这个监控器与基准评测器严格隔离——它看不到 hidden rubric、分数和评测反馈,否则就是作弊了。这一点论文在附录里专门强调,我觉得很必要,因为"用评测信号指导开发"和"用独立监控指导开发"是两种完全不同性质的东西。
饱和与收敛控制。如果连续几次全局评估都没能产出更好的 checkpoint,RSIGame 就判定饱和:要么直接终止、交出历史最佳 \(P_s^{\star}\);要么引入新的高层指导 \(\gamma_{s+1}\)(来自人类或更强模型),从保留的最佳 checkpoint 开启下一个开发阶段。高层指导只给战略方向(比如"下阶段重点做内容深度"),不给具体编辑指令。
这个"保留最佳 + 饱和停止"的组合,工程上的价值非常直接:它把开发从"赌最后一轮的运气"变成"保底历史最优"。做过长程 agent 实验的人都知道,跑 30 轮的系统最后交出的往往不是第 30 轮的产物——但大多数框架根本没意识到这一点。
经验内化:把开发经验蒸进参数
这是我认为这篇论文最有想象力的部分。测试时的自我改进终归是"上下文优化",每次都要从头付学费。RSIGame 更进一步:把成功的开发轨迹收集起来做 SFT,让自我改进从上下文层渗透到参数层。
数据来源有三类:GPT-5.5 在 Godot 和 Phaser 上的生成轨迹、成功生成中的规划轨迹、用 GLM-5.3-Flash 跑 RSIGame 产出的改进轨迹。筛选标准很硬——只保留可执行的生成和"验证通过且没破坏已有功能"的改进。最终从 4,003 个候选里留下 2,213 条生成轨迹、2,108 条规划轨迹、2,013 轮验证过的改进,微调 Qwen3.8-27B。
这样模型学到的不只是"好游戏长什么样",还有中间的规划、工具调用、诊断和修复决策。而且这个循环理论上可以持续滚动:新一代模型产生新的开发经验,再内化,再变强——这才是 RSI 这个名字的完整含义。
📊 实验:140 个任务、两个引擎、五个生成器
实验平台是 GameCraft-Bench——140 个游戏开发任务、覆盖 15 个游戏家族(平台跳跃 19 个、策略 17 个、大亨 16 个、开放世界 15 个等),在 Godot 和 Phaser 两个引擎上各跑一遍。评分沿用基准的协议:每个游戏附带可回放的演示轨迹,评测器回放后用隐藏的任务级 rubric 打分,覆盖 Mechanics、Depth、Visuals、Art 四个维度:
其中 BUILD 是 0/1 闸门——跑不起来的游戏直接零分。judge 用 Qwen3.8-27B,每个游戏独立回放打分三次取平均。对比对象是冻结的初始项目 \(P_0\) 和 Play2Code(一个交替玩游戏-改代码的迭代基线),所有方法从同一份 \(P_0\) 克隆出发,每轮最多 26 次工具调用、最多 30 轮,预算完全对齐。
这个实验设置我得夸一句:同一起点、同一预算、同一 backbone 的对比方式,堵死了"你涨分是因为起点不同/预算更多"这类最常见的质疑。
主表:全面碾压,而且赢在"组织方式"
| 生成器 | 方法 | Mechanics | Depth | Visuals | Art | Overall | Token |
|---|---|---|---|---|---|---|---|
| Godot | |||||||
| Codex+GPT-5.5 | Base | 58.9 | 51.7 | 51.4 | 44.6 | 50.26 | 0.26M |
| +Play2Code | 59.2 | 51.3 | 52.2 | 45.8 | 50.74 | 3.20M | |
| + RSIGame | 72.8 | 60.3 | 65.9 | 64.5 | 64.53 | 3.12M | |
| Codex+Kimi-K2.6 | Base | 40.2 | 30.3 | 35.4 | 21.9 | 29.63 | 3.22M |
| +Play2Code | 44.8 | 35.4 | 40.2 | 28.6 | 35.19 | 7.07M | |
| + RSIGame | 51.7 | 40.1 | 47.1 | 45.4 | 44.77 | 7.39M | |
| Codex+Qwen3.8-27B | Base | 41.2 | 33.4 | 38.6 | 38.3 | 37.07 | 6.41M |
| +Play2Code | 44.6 | 36.1 | 42.1 | 42.5 | 40.53 | 9.92M | |
| + RSIGame | 51.2 | 40.4 | 47.5 | 53.8 | 47.77 | 9.13M | |
| Codex+Qwen3.8-27B (SFT) | Base | 56.1 | 47.5 | 49.8 | 44.8 | 48.22 | 0.57M |
| +Play2Code | 57.4 | 48.1 | 51.6 | 47.2 | 49.71 | 3.74M | |
| + RSIGame | 68.7 | 55.8 | 62.8 | 63.2 | 61.38 | 3.49M | |
| Phaser | |||||||
| OpenGame+GPT-5.5 | Base | 49.1 | 38.6 | 53.6 | 58.6 | 49.44 | 5.36M |
| +Play2Code | 57.1 | 42.0 | 60.0 | 65.2 | 55.10 | 8.34M | |
| + RSIGame | 59.8 | 44.2 | 62.4 | 69.7 | 58.21 | 8.38M | |
| OpenGame+Qwen3.8-27B | Base | 40.6 | 29.5 | 43.7 | 48.7 | 40.03 | 9.03M |
| +Play2Code | 51.0 | 36.4 | 53.2 | 58.0 | 48.70 | 12.99M | |
| + RSIGame | 52.0 | 36.5 | 54.6 | 61.3 | 50.24 | 12.78M | |
| OpenGame+Qwen3.8-27B (SFT) | Base | 47.1 | 35.4 | 48.9 | 52.4 | 45.14 | 5.42M |
| +Play2Code | 55.6 | 41.7 | 57.3 | 61.8 | 53.15 | 9.58M | |
| + RSIGame | 60.4 | 46.2 | 62.3 | 68.4 | 58.53 | 9.31M |
表 1:GameCraft-Bench 主结果(节选核心行,完整含 GLM-5.3-Flash 一组)。加粗为每组最优。
几个值得停下来看的数字:
第一,提升幅度不是边角料级别。 Godot 上 RSIGame 把五个生成器的冻结基线提升了 10.7 到 20.3 个点,对 Play2Code 的优势是 7.2 到 13.8 个点。最刺眼的是 GPT-5.5 那组:Play2Code 在强基线上几乎纹丝不动(50.26 → 50.74),RSIGame 却拉到了 64.53。这说明增益来自"开发过程的组织方式",而不是"迭代"这个动作本身——这个区分非常关键。
第二,经验内化的收益是双倍的。 SFT 把 Qwen3.8-27B 的单次生成从 37.07 拉到 48.22,离 GPT-5.5 的 50.26 只差 2 分,而生成 token 从 6.41M 砍到 0.57M——省了 11 倍。叠上 RSIGame 之后冲到 61.38,总 token 反而比未微调版少 2.6 倍(9.13M → 3.49M)。更强的初始生成,需要修复的轮次就更少,这个飞轮转起来了。
第三,跨引擎结论稳健。 Phaser 上三个生成器也提升 8.8 到 13.4 个点。有趣的是 Play2Code 在 Phaser 上明显比在 Godot 上能打,作者的解释挺合理:Phaser 初始游戏的 Mechanics 和 Depth 偏弱、Visuals 和 Art 偏强,留下更多"低垂的果实",Play2Code 捡这些果子就能回血不少。但即便如此,最终质量的天花板还是 RSIGame 的。
开发时间扩展:加预算 ≠ 变好
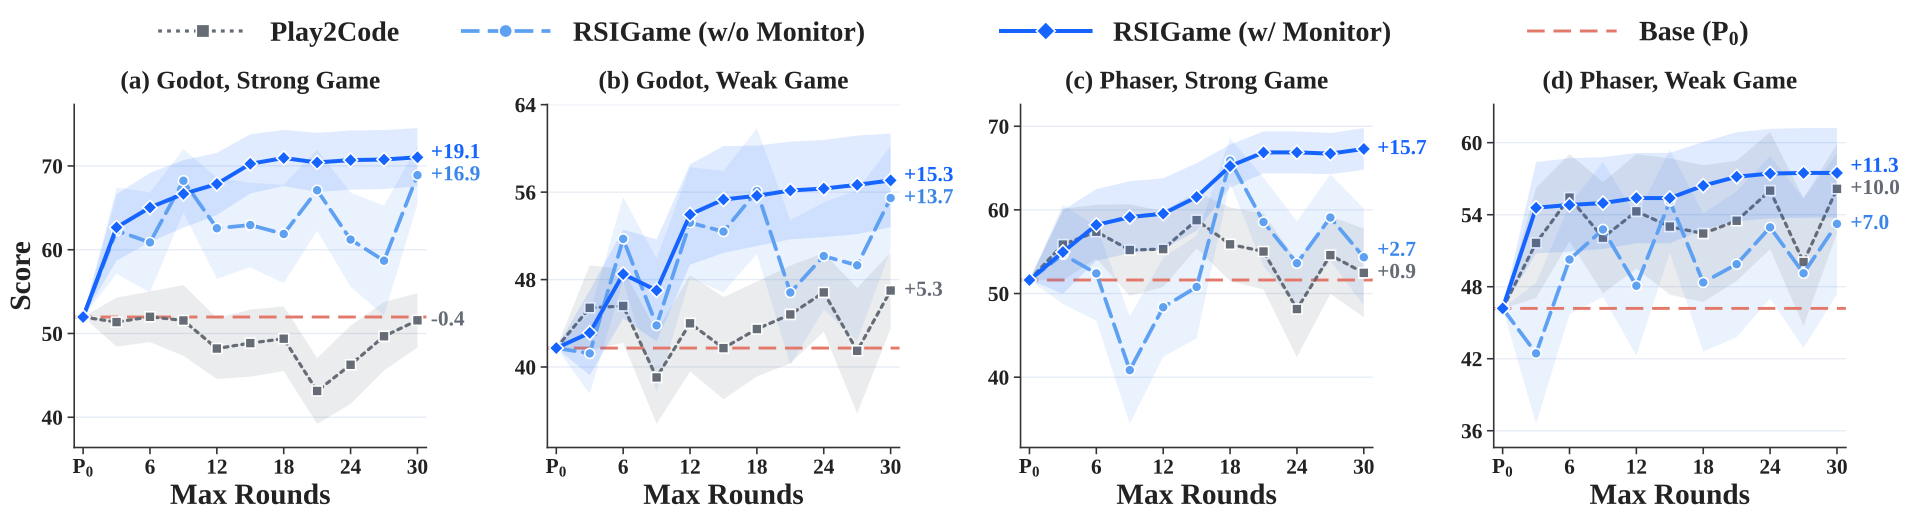
图 3:四个象限(Godot/Phaser × 强/弱初始游戏)的扩展曲线。灰色 Play2Code 很快就平台化甚至回退(强 Godot 上 30 轮后只有 -0.4),而带监控器的 RSIGame(深蓝实线)全程稳步爬升,最多提升 19.1 分。阴影是 ±1 标准误。
这张图是全文我最喜欢的一张。它戳破了一个直觉:给更多开发预算,游戏就会更好。实际数据告诉你,Play2Code 在强初始游戏上 30 轮预算下去反而比起点还差 0.4 分。而 RSIGame 的全局质量监控器把"volatile 的局部改进"变成了"单调向好的保底曲线"。
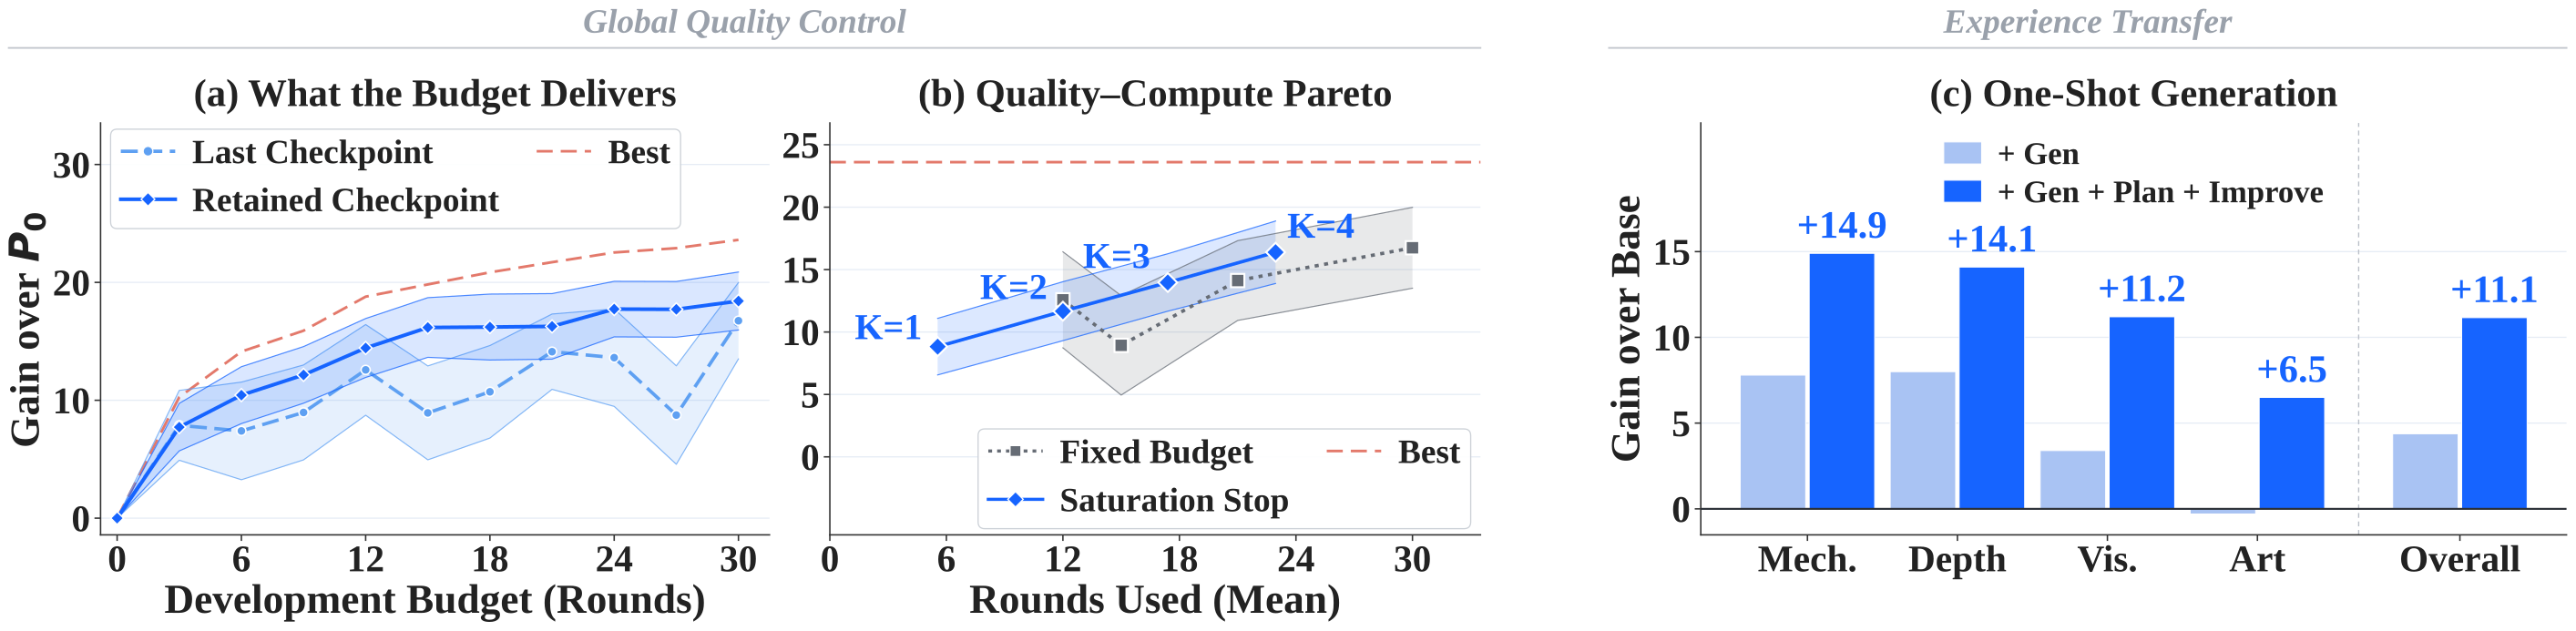
图 4:(a) 保留的 checkpoint 紧贴 oracle 最佳曲线,防止后期编辑抹掉早期成果;(b) 饱和感知停止用更少轮次达到可比质量——K=4 时性价比最优;(c) 经验内化的一次性生成增益:加入规划和改进轨迹后(深蓝),Mechanics 提升 14.9、Depth 提升 14.1,Overall 提升 11.1 分;只用生成轨迹(浅蓝)则各维度增益不均。
图 4(c) 有个细节值得注意:只用生成轨迹训练,Visuals 和 Art 的增益很弱(3.3 和 4.1 左右);加入规划和改进轨迹后才补齐到 11.2 和 6.5。这支持了作者的论点——规划和修复轨迹携带了"怎么把游戏改好"的可复用知识,而不只是"好游戏长什么样"的模仿。不过说实话,Art 维度仍然是增益最小的(+6.5),美术能力的内化看来比功能修复难得多。
自适应进化与智能体验证
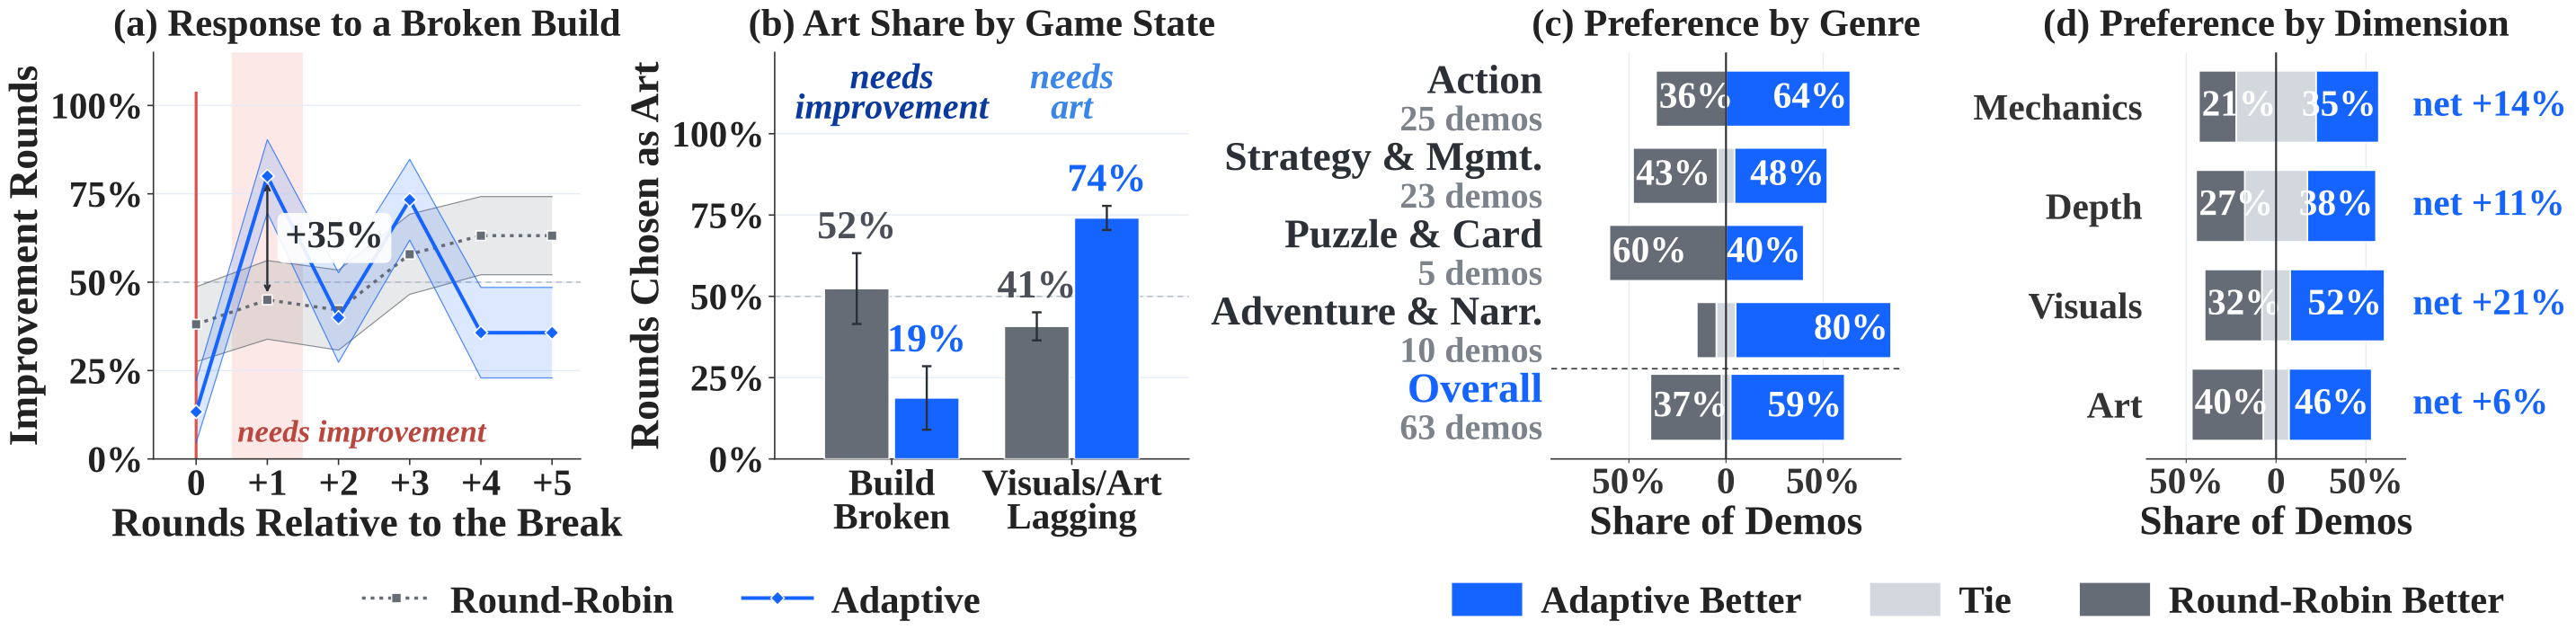
图 5:(a) 构建失败后,自适应调度把改进轮次的占比拉高 35%;(b) 视觉质量成为瓶颈时,74% 的轮次被分配给美术;(c)(d) 盲测 pairwise 对比:自适应在 59% 的比较中胜出(round-robin 只有 37%),四个维度净偏好均为正,Visuals 净胜 21%。
让局部循环自己决定"这轮做什么",而不是按固定课表轮流来——这个消融用盲测 pairwise 评估做得比较干净。59% 对 37% 的偏好率不算压倒性,但四个维度一致为正,可信度还可以。
验证机制的消融(Table 2)更硬核:编辑前,证据驱动的验证把"有依据的改进目标"精度从 58.6% 提到 72.3%,每轮无依据目标从 1.93 个降到 0.50 个;编辑后,回放式验证能查出 76.2% 的失败改进,平衡准确率 84.4%——而只看"能不能编译"的 build-only 检查对行为性失败的检出率是零。零。这组数据对任何做 agentic coding 的人都是一记警钟:编译通过跟功能正确之间隔着一条鸿沟。
🔬 我的判断
亮点很明确。 这篇论文最值钱的地方不是某个精巧的模块,而是把"长程 agentic 开发为什么失败"拆成了三个可治的病:测试过拟合(用进化清单治)、后期回退(用最佳 checkpoint 保底治)、经验浪费(用 SFT 内化治)。三个药方都有对应的消融数据支撑,不是讲故事。91 个数值的主表 + 51,644 份开放的打分文件,可复现性方面的诚意也是足的。
但有几个地方要泼冷水。
其一,全局质量监控器虽然与评测器隔离,但它自己也是个模型裁判。附录里提到用 Qwen3.8-27B 当 judge、Claude Opus 5 做独立审计,跨裁判鲁棒性在附录 D 有量化——但"模型裁判选最佳 checkpoint"这一步本身的偏差,论文没有非常正面地讨论。如果监控器的品味与隐藏 rubric 的品味系统性偏离,保底的可能不是真正最好的版本。
其二,SFT 数据的生成轨迹来自 GPT-5.5、改进轨迹来自 GLM-5.3-Flash——经验内化的上限很大程度上是蒸馏更强模型的上限。"61.38 超过 GPT-5.5 单次生成的 50.26"这个标题级结论成立,但要注意 GPT-5.5 叠上 RSIGame 之后是 64.53,小模型并没有真正反超"满配"的大模型。宣传口径和实际数据之间有个小缝隙,读的时候要清醒。
其三,140 个任务全是 2D 游戏,两个引擎。这套"探索-诊断-改进"循环能不能搬到 3D、多人、长剧情游戏上,论文自己也承认是开放问题(附录 B 的 Limitations)。
跟同期工作比,Play2Code 解决"有没有迭代",VibeGame 解决"多智能体分工",OpenGame 解决"跨项目技能复用"。RSIGame 的位置是解决"迭代如何长程可靠"——它不抢"首创迭代"的名头,这个自我定位是诚实的。在我看来,"最佳 checkpoint 保底 + 饱和停止"这对组合大概率会成为长程 agentic 系统的标配组件,就像 best-of-n 之于采样一样朴素但不可或缺。
💡 工程启发
如果你在做任何长程的 agentic 系统(不限于游戏),这篇论文有三样东西可以直接抄:
- 给系统配一份只增不减的工作清单,让每轮决策基于累积证据而非当下灵感——这是对治"agent 越改越局部"的便宜药方。
- 把"选最佳 checkpoint"和"判断该不该停"从主循环里拆出来,做成独立的、与评测隔离的监控器。长程系统默认就该有保底机制。
- 把成功的开发轨迹存下来做 SFT。测试时自我改进是租来的能力,参数化内化才是买来的。2,000 来条高质量轨迹就能把 27B 模型拉到接近闭源旗舰的水平,这个投入产出比很夸张。
还有一个更本质的问题没被解决:当高层指导 \(\gamma_s\) 来自人类时,这套系统其实是在人机混合进化;来自更强模型时,又变成了变相蒸馏。真正的"纯自我"递归改进——系统自己产生超越自身能力的战略洞察——这篇论文还没摸到边。这大概是下一篇论文的故事了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我