PACT:给"token 信用"下一个唯一的数学定义,然后顺手把 Critic 对齐了
做 LLM 强化学习的人,大概率都被同一个问题折磨过:模型生成了一长串 token,最后只拿到一个标量 reward——对了 1 分,错了 0 分。然后你要把这个 reward 摊回到几千甚至几万个 token 头上去。
摊得合理吗?没人知道。GRPO 直接把 response 级 advantage 广播到每个 token,PPO 靠 GAE 和 value head 慢慢磨,OPD 蒸馏干脆绕开 reward 用 teacher 的 logits。每家的做法都不一样,背后的"信用分配"却从来没有一个公认的数学定义。
这篇论文(arXiv:2609.26355)干了件很基础、但很硬核的事:它提出三条正则条件,证明了满足这三条条件的 token 级信用分配存在且唯一,唯一形式就是条件期望价值的差分——\(C_i = V_i - V_{i-1}\)。然后顺着这个定理一路推,把 OPD、RLOO、GAE 这些现有算法全部放进同一个框架里重新解释了一遍,最后落到一个具体的训练改进方案 PACT 上。
核心摘要:PACT 论文先给出 token 级信用分配的唯一表示定理(Completeness + Prefix Consistency + Neutrality 三个条件唯一确定信用),再用它统一解释了 OPD 的 teacher 其实是隐式 critic、RLOO 的 response 级信号在期望上等价于 token 级信用、GAE 里 \(\lambda=1\) 为什么在长序列上更好。理论指导下提出 Actor-then-Critic 的更新顺序,critic 训练时用重要性采样修正对齐更新后的策略,并用 BCE 替代 MSE 训价值。数学推理四个基准平均 72.87%,比 GRPO 高 8.8 个点;SWE-bench Verified 67.4%,比 PPO/GRPO/SAO 分别高 2.4/2.0/3.8 个点。我的判断:这是少见的"理论真正指导了工程"的 RL 论文,定理不是装饰品,每一条都直接对应了一个设计决策。
📖 论文信息
- 标题:PACT: From Credit Assignment to Critic Alignment
- 作者:Jiayan Fu, Hang Xu, Yong Zhang, Zhaokai Luo, Yao Hu, Dongyan Zhao, Mu Chuan(AllSpark Team)
- arXiv:2609.26355,2026 年 9 月 22 日提交
- 代码:https://github.com/AllSpark-Research/PACT
论文开头引了 Shannon 的一句话:"The real justification of these definitions, however, will reside in their implications."——定义的真正价值在于它的推论。这句话基本就是全文的纲领。
🎯 问题动机:信用分配是个"没有定义"的概念
先建立直觉。自回归语言模型的 RL 可以建模成 token 级 MDP:状态是已经生成的全部历史,动作是下一个 token。轨迹写成 \(Y=(q,T_1,O_1,T_2,O_2,\ldots,T_\tau,O_\tau)\),其中 \(T_i\) 是模型生成的第 \(i\) 个 token,\(O_i\) 是环境返回的观测(工具返回、执行结果等,普通生成场景下就是空的)。
问题在于:最终 reward \(R=\mathcal{R}(Y)\) 是整条轨迹的函数,马尔可夫表示本身并不能告诉你 reward 该怎么摊到各个 token 上。我以前做类似项目的时候,这块基本靠拍脑袋——GAE 的 \(\lambda\) 调一调,reward shaping 加一点,效果好不好全看天意。
作者的思路很干脆:别猜了,先定义"什么样的信用分配才算合理",再看这个定义能推出什么。
三条正则条件
Completeness(完备性):所有 token 的信用加起来,必须正好解释最终 reward 相对初始预期的偏差:
不许多分,也不许少分。
Prefix Consistency(前缀一致性):已经生成的前缀,其累计信用就定死了。未来的 token 怎么采样、环境怎么反馈,都不应该回头改之前 token 的账。你想想看,如果未来的随机性能改过去的信用,那"信用"这个词就没意义了。
Neutrality(中性):站在当前信息的角度,下一个 token 的期望信用应该是零:\(\mathbb{E}[C_i\mid\mathcal{F}_{i-1}]=0\)。信用不能系统性地高估或低估。
唯一表示定理
这三条看起来很"显然该满足"的条件,居然唯一确定了信用分配。定理 1 说:满足三条条件的 token 级信用存在且唯一(几乎处处相等的意义下),形式是
也就是条件期望价值的相邻差分,并且 \(\{C_i\}\) 构成一个鞅差序列。
这个结果漂亮在哪?它把"信用"从一个人工设计的算法量,变成了一个由信息结构(\(\sigma\) 代数流)自然决定的数学对象。token \(i\) 的信用,就是它生成之后"世界对最终结果的预期"变化了多少。附录里还证明了三个条件缺一不可——去掉任何一个都能构造出满足其余条件的替代分配方案。
粗粒度的信用也能从这个表示里推出来:把连续 token 聚成段,段级信用就是段首尾价值的差(Corollary 1),turn 级分配只是特例。
🧠 用这把尺子重新量一遍现有算法
定理本身只是开始,真正有意思的是它能把一批看似无关的算法串起来。
OPD 的 teacher 是个隐式 critic
On-Policy Distillation(OPD)用 teacher 在学生自己生成的轨迹上做 token 级监督。之前有工作指出 OPD 目标可以代数改写为 KL 约束的 RL,teacher-student 的 log 密度比扮演 token 级 advantage。但这只是优化层面的等价,没回答"这个信号和最终 reward 一致吗"。
作者定义了一个理想 teacher:在每个前缀下,teacher 分布是 \(Q_t^\pi\) 期望最大化加上对当前策略的 KL 正则的解(温度 \(\beta\))。定理 2 证明,理想 teacher 下 OPD 诱导的策略梯度方向,恰好等于唯一信用诱导的梯度方向乘上 \(1/\beta\):
也就是说,OPD 虽然没有显式的 value head,但 teacher 通过 KL 目标扮演的角色就是 critic。这个视角解释了 OPD 为什么 work——它不是绕开了价值估计,而是把价值估计藏进了 teacher 里。
RLOO:粒度粗,但期望上不吃亏
GRPO/RLOO 这类组基线方法一直被诟病"粒度太粗"——response 级的 baseline 广播到所有 token,跟 token 级信用对不上。定理 3 给了一个有点反直觉的结论:RLOO 的 token 级策略梯度估计量,在期望上与唯一信用表示诱导的梯度完全相等:
等等,那 GRPO 岂不是在数学上没毛病?注意关键词是"在期望上"。等价不代表统计效率相同——\(V_t\) 是所有 \(\mathcal{F}_t\) 可测预测器里 MSE 最小的,而 RLOO 的 response 级 baseline 保留了有限采样的随机波动。轨迹一长,这些波动相对于局部信用信号就很可观了。这解释了为什么 GRPO 能用但 noisy,也给了"做细粒度信用估计"一个正当理由。
信用是稀疏的,这就是 GAE 的软肋
定理 4 是我觉得全文最值钱的一个结果。把 reward 归一化到 \([0,1]\) 后(正仿射变换不改变最优策略),有
整条轨迹上所有 token 信用的平方和,期望不超过 1/4——与轨迹长度无关。推论是:绝对值超过 \(\epsilon\) 的信用,期望个数不超过 \(1/(4\epsilon^2)\)。
几万个 token 里,真正有分量的信用可能就那么几十上百个。这就是"信用稀疏"。
然后看 GAE。设 critic 估计 \(\widehat{V}_i = V_i + \varepsilon_i\),\(\gamma=1\)、末端 \(\widehat{V}_\tau = R\),TD 残差分解为 \(\widehat{\delta}_i = C_i + \varepsilon_i - \varepsilon_{i-1}\)。GAE 优势展开后:
当 \(\lambda \lt 1\) 时,中间所有 critic 误差都留在这个式子里。而信用是稀疏的——中间这些误差累积起来完全可以跟真实信用信号相当,甚至淹没它。当 \(\lambda=1\) 时,中间误差项整体消失,只剩下前缀误差 \(-\varepsilon_{t-1}\):\(\widehat{A}_t^{1} = R - \widehat{V}_{t-1}\)。
这一下就把两个经验观察解释通了:DeepSeek-R1 报告 PPO 用 \(\lambda=1\) 好过常用的 0.95;SAO 用长度自适应的 GAE 系数,回复越长系数越接近 1。以前大家当经验 trick,现在有了理论根据。实验里 PPO \(\lambda=0.95\) 直接训崩(平均 26.31%,比 base model 还低 15 个点),算是血淋淋的佐证。
🏗️ PACT:让 critic 跟上 actor 的脚步
理论分析指向一个非常具体的工程问题:critic 永远落后 actor 一步。
PPO 的标准流程里,第 \(k\) 轮用 \(\pi_k\) 采样 \(\mathcal{D}_k\),但算 advantage 用的价值是 \(\widehat{V}_{\phi_{k-1}} \approx V^{\pi_{k-1}}\)——这是用上一轮数据训出来的 critic,对应的是旧策略。critic 虽然在 \(\mathcal{D}_k\) 上更新了,但更新后的 critic 并不会用来重算当前 advantage。actor 一更新,critic 又落后了。在信用靠"相邻价值差分"恢复的设定下,这种滞后是致命的:差分会放大任何一处的不对齐。
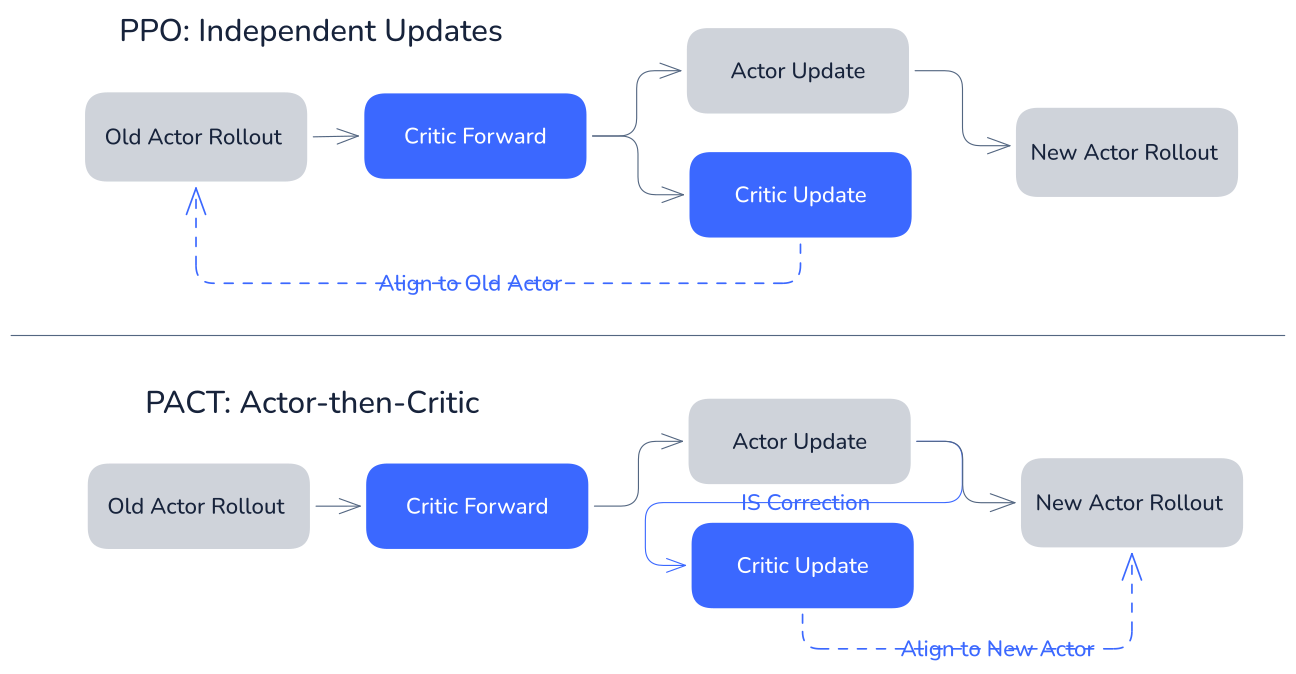
图 2:上半部分是 PPO 的独立更新——actor 和 critic 各自更新,critic 始终对齐旧 actor;下半部分是 PACT 的 Actor-then-Critic 顺序——先完成全部 actor 更新,再用重要性采样修正(IS Correction)训练 critic,让 critic 对齐新 actor。
PACT 的解法分两块。
第一块:Actor-then-Critic 更新顺序 + IS 修正。 先跑完 actor 的全部更新得到 \(\pi_{k+1}\),然后在同一批 rollout 数据上多做一次前向,拿到更新前后的 log-prob 比值。理论上的目标是续接重要性比率 \(I_t = \prod_{k=t}^{\tau}\frac{\pi(T_k|\mathcal{F}_{k-1})}{\mu(T_k|\mathcal{F}_{k-1})}\),换测度后 \(V_{t-1}^{\pi} = \mathbb{E}_\mu[I_t R\mid\mathcal{F}_{t-1}]\),于是用旧数据训新策略的 critic 只需要把 reward 目标换成 \(I_t R\)。实际实现里,精确续接比率在长回复上方差太大,所以用 detach 的当前 token 比率做近似,并把比率落在 \([\rho_{\min}, \rho_{\max}]\) 之外的 token 级 critic loss 直接 mask 掉(实验里用 \([0,6]\))。只需要额外一次前向,不用重新采样,成本很低。
第二块:BCE 替代 MSE 训 critic。 reward 归一化到 \([0,1]\) 后,critic 参数化为 \(\widehat{V}_{\phi,i} = \sigma(z_{\phi,i})\),用软标签 BCE 训练:
关键性质是 BCE 和 MSE 的最优预测完全相同,都是 \(V_i^\pi\),所以换损失不改变估计目标,只改变优化几何。这个做法跟深度 RL 里"用分类目标训价值函数"的思路(如 Farebrother 等人的 stop-regressing 工作)一脉相承。附录里的 logit 空间梯度分析保证了即使 \(I_t R\) 的单次实现落在 \([0,1]\) 之外,条件最小解也不变。
整个算法流程很干净:rollout → critic 前向算信用 → actor 更新 → 新策略再前向一次拿 log-prob 比率 → mask + 加权 BCE 训 critic → 下一轮。没有任何额外的 rollout 开销。
📊 实验:理论兑现成数字
两个任务场景。数学推理用 Qwen3.5-4B,在 DAPO-Math-17k 的 3200 题子集上训练(优先选初始策略 pass@1 做不出来的题),走 OpenCode agentic harness,奖励是最终答案正确性。Agentic 编程用 Qwen3.6-35B-A3B,在 OpenSWE 上通过 Codex agent 训练,奖励来自任务验证器。每轮 rollout 512 条轨迹,上下文窗口 128k,单轮交互最长生成 64k token。
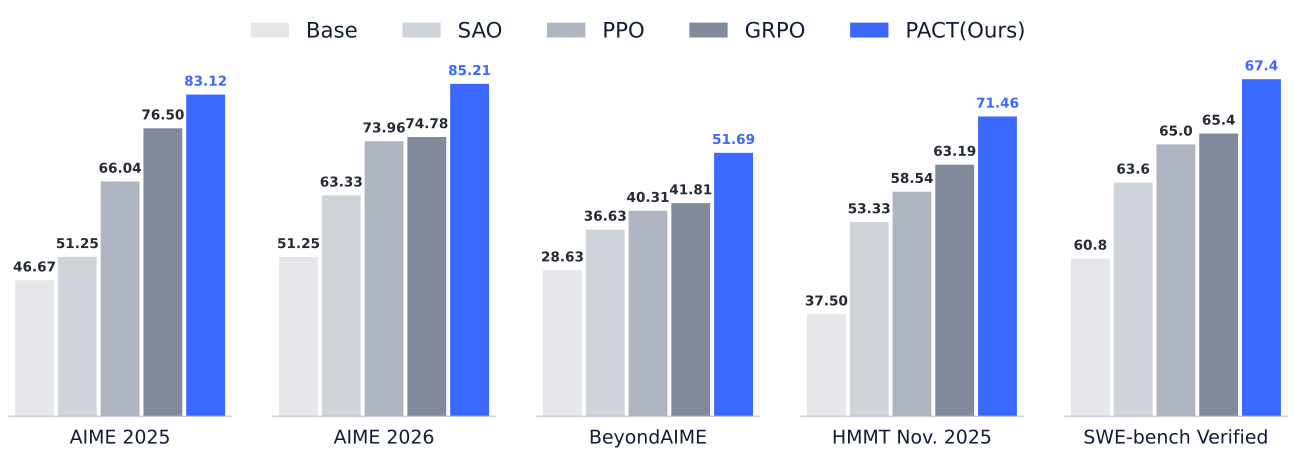
图 1:Base、SAO、PPO、GRPO 与 PACT 在五个基准上的对比。数学部分是 Qwen3.5-4B + OpenCode 的 Avg@16 准确率,编程部分是 Qwen3.6-35B-A3B + Codex 在 SWE-bench Verified 上的 pass@1。PACT 在全部五项上都是最高。
数学推理主表
| 方法 | AIME 2025 | AIME 2026 | BeyondAIME | HMMT Nov. 2025 | 平均 |
|---|---|---|---|---|---|
| Base Model | 46.67 | 51.25 | 28.63 | 37.50 | 41.01 |
| GRPO(Clip-Higher) | 76.50 | 74.78 | 41.81 | 63.19 | 64.07 |
| PPO(\(\lambda=0.95\)) | 32.33 | 29.38 | 17.86 | 25.67 | 26.31 |
| PPO(\(\lambda=1.0\)) | 66.04 | 73.96 | 40.31 | 58.54 | 59.71 |
| SAO | 51.25 | 63.33 | 36.63 | 53.33 | 51.14 |
| PACT w/o IS | 76.04 | 82.50 | 51.38 | 61.04 | 67.74 |
| PACT | 83.12 | 85.21 | 51.69 | 71.46 | 72.87 |
几个值得盯着的点:
- PACT 平均 72.87%,比 GRPO 高 8.8 个点,比 PPO \(\lambda=1\) 高 13.16 个点,比 SAO 高 21.73 个点。在最难的 BeyondAIME 上从 GRPO 的 41.81 拉到 51.69,将近 10 个点。
- PPO \(\lambda=0.95\) 训崩了,平均 26.31%——比没训过的 base model 还低一大截。这正是定理 4 分析的场景:中间 critic 误差淹没稀疏信用。坦率的讲,这个 baseline 低得有点刺眼,但也确实是 GAE 在长序列 outcome-only 设定下的真实风险。
- 去掉 IS 修正的 PACT 掉到 67.74%,IS 一项贡献 5.13 个点,四个基准全面上涨。说明 Actor-then-Critic 顺序本身不够,修正对齐才是核心。
SWE-bench Verified
| 方法 | Base | GRPO | PPO(\(\lambda=1.0\)) | SAO | PACT |
|---|---|---|---|---|---|
| Pass@1 | 60.8 | 65.4 | 65.0 | 63.6 | 67.4 |
PACT 67.4%,比 GRPO、PPO、SAO 分别高 2.0、2.4、3.8 个点。提升幅度比数学任务小,但考虑到 base model 已经有 60.8%,天花板空间本来就有限,2 个点以上的差距不算小了。
消融:BCE critic 确实收敛更快
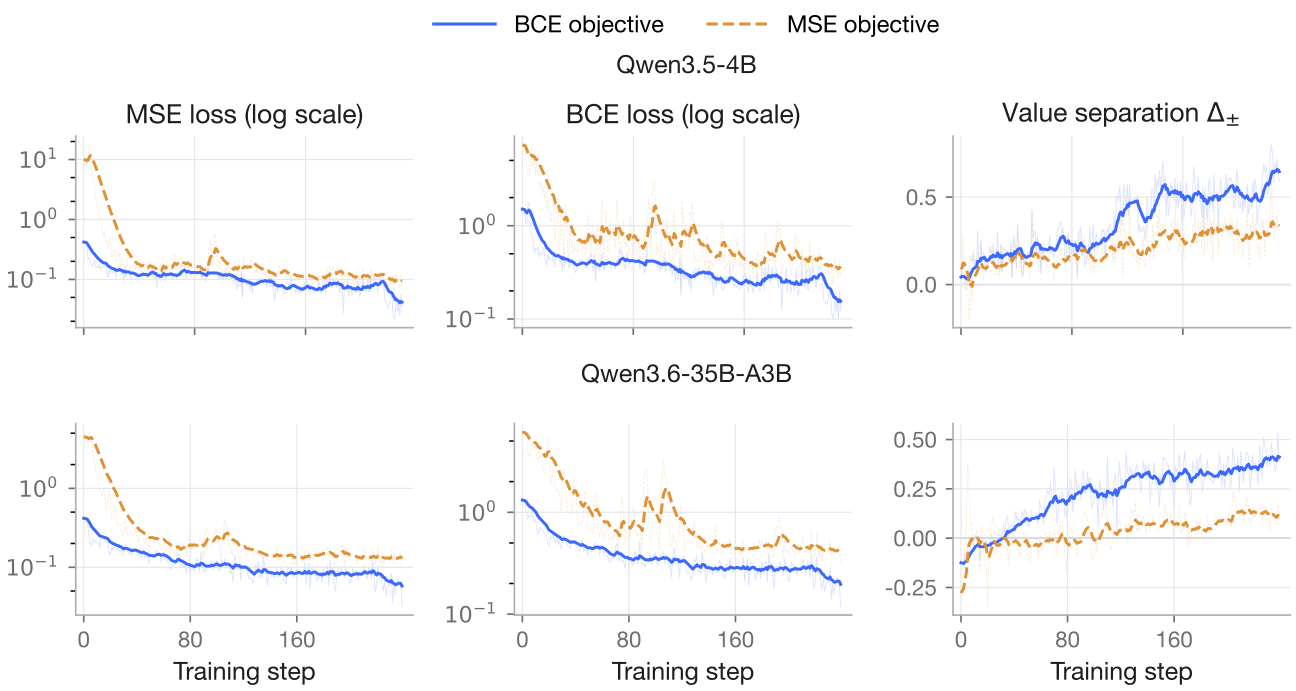
图 3:固定 rollout 策略、相同初始化、相同数据下,BCE 与 MSE 两种 critic 目标的对比(上排 Qwen3.5-4B,下排 Qwen3.6-35B-A3B)。BCE critic 在 BCE loss 和 MSE loss 两个指标上都更低,右列的价值分离度 \(\Delta_{\pm}\)(正样本均值减负样本均值)明显更大——BCE critic 给成功和失败轨迹打出了更开的分数。
这个消融设计得挺克制:不改策略、不改数据,只换 critic 的损失函数。两个模型规模上结论一致,BCE critic 的区分度肉眼可见地更好。
训练动态
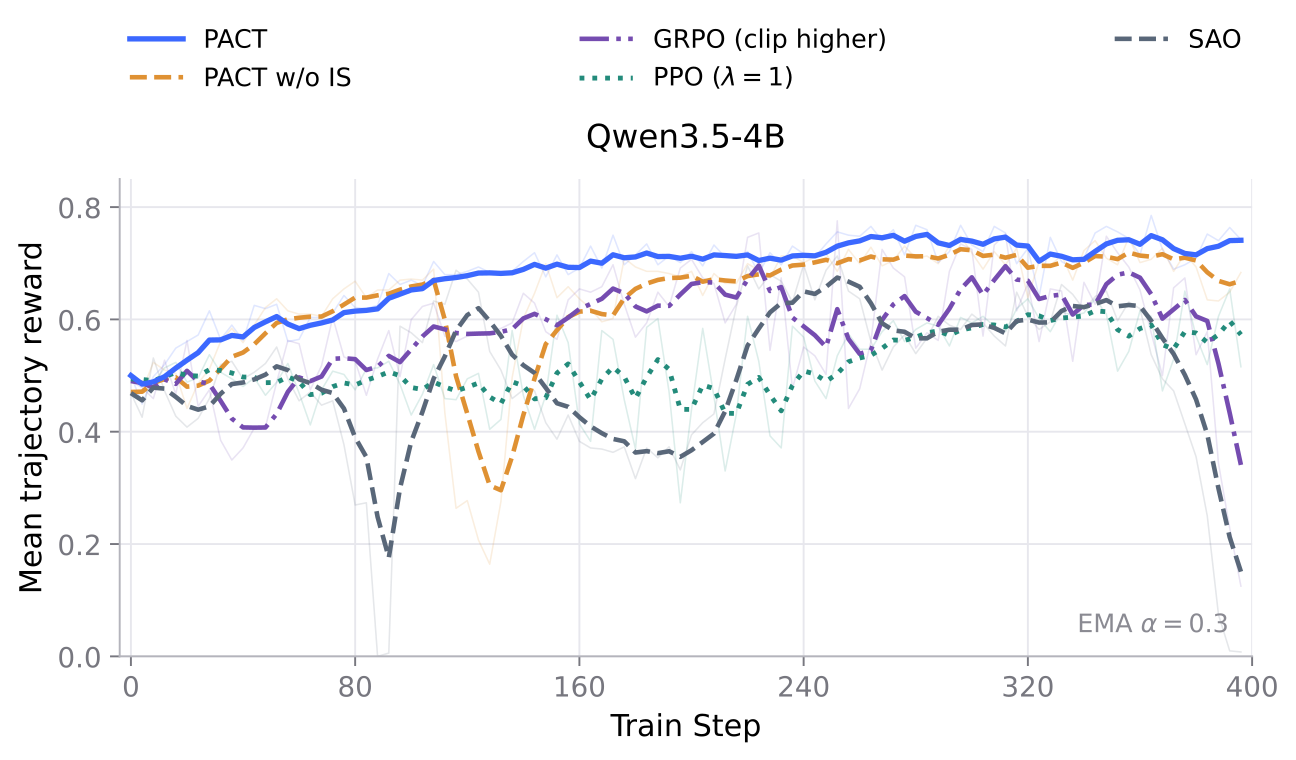
图 5:Qwen3.5-4B 数学推理上的训练 reward(粗线是 EMA 平滑)。PACT 稳定在 0.75 附近,PACT w/o IS 略低;GRPO 和 SAO 在训练后期出现明显的 reward 崩塌,SAO 一度跌到 0.2 以下。
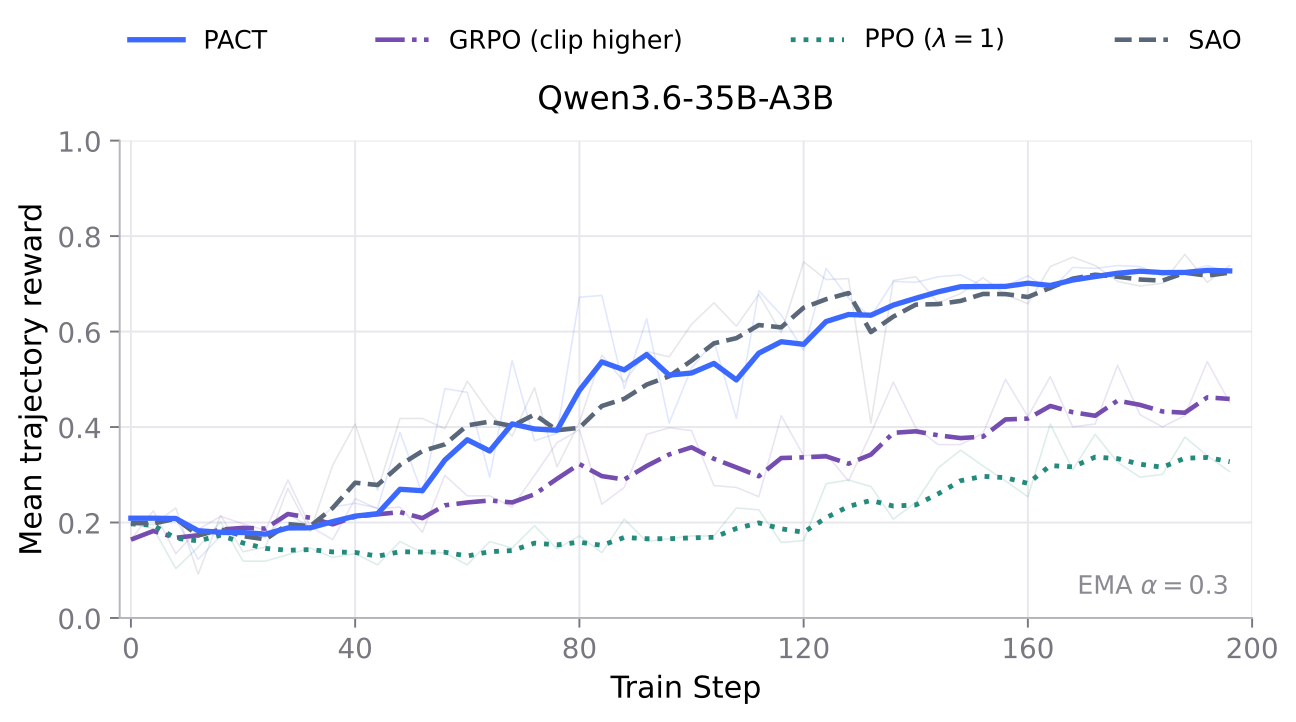
图 6:Qwen3.6-35B-A3B 编程任务上的训练 reward。PACT 与 SAO 最终都到 0.72 附近,但 GRPO 只有 0.45、PPO 只有 0.33 左右。注意编程任务上 PACT 的 actor 侧用的是 PPO clipping 而非 DIS,最终 reward 与 SAO 打平但评测 pass@1 更高——训练 reward 和下游表现并不完全对应。
还有一张附录里的图值得放出来,它是定理 4 的直接经验证据:
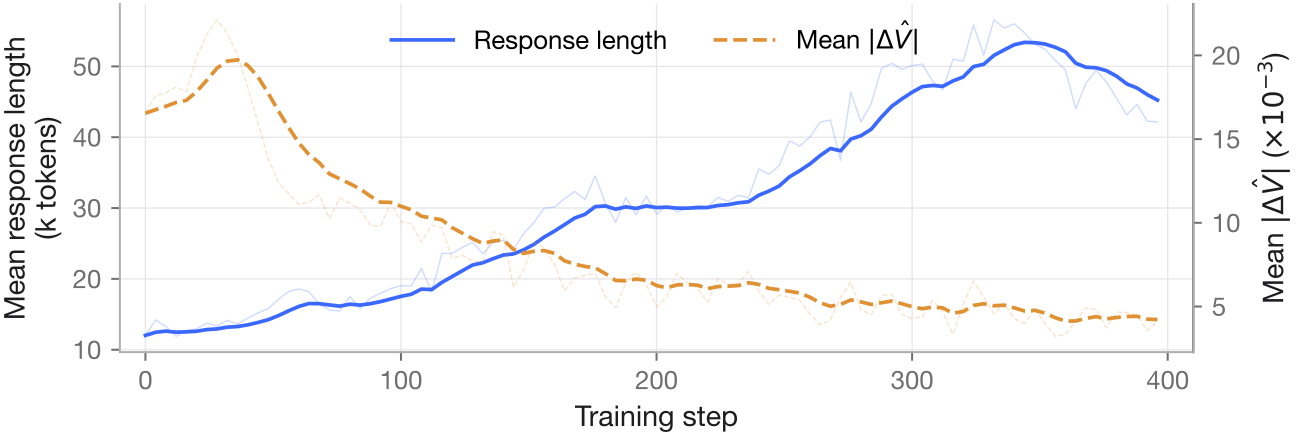
图 4:训练过程中平均回复长度从约 11k token 一路涨到 45k 以上,而相邻价值的平均绝对差 \(|\widehat{V}_t-\widehat{V}_{t-1}|\) 持续下降。序列越长,单个 token 的信用越小——稀疏性不是理论装饰,是实际训练里真实发生的事情。
看到这个图的时候我停顿了一下:回复长度翻四倍,平均信用增量缩到四分之一左右,平方和的界却纹丝不动。定理 4 的那个"与长度无关"在这里变得非常具体。
🤔 我的判断
这篇论文最值钱的地方,是它把"信用分配"从工程玄学拉回了数学对象。三条正则条件看着朴素,但唯一性定理一出,OPD、RLOO、GAE 三个方向的零散经验观察突然都有了统一解释——OPD 的 teacher 是隐式 critic,RLOO 期望无偏方差大,GAE \(\lambda=1\) 消掉中间误差。每条推论都直接变成了 PACT 的一个设计决策。这种"定理→解释→设计"的完整链条,在 LLM RL 论文里不多见。
但也有几个地方要泼点冷水。
第一,唯一性是有条件的。 作者在 Limitations 里自己说得明白:这三条正则条件就像欧几里得的平行公设,换一套公理就得到另一套自洽的"几何"。而且这里的信用是统计性的(条件期望),不是因果性的——它不刻画"换掉这个 token 会怎样"的反事实效果。如果你关心的信用概念带因果含义,这套框架管不着。
第二,定理告诉你信用"是什么",没告诉你"怎么估"。 \(V_i = \mathbb{E}[R\mid\mathcal{F}_i]\) 是真值条件期望,实际训练里只有 \(\widehat{V}\)。IS 修正用的是 detach 的当前 token 比率,是精确续接比率的近似,长序列上的偏差没有严格界。论文也承认"准确高效地估计 token 级信用"还是开放问题。
第三,实验规模有限。 数学任务 3200 题训练集、4B 模型;编程任务单一基准。72.87% 和 67.4% 这些数字放在对应的 setup 下是扎实的,但能不能迁移到更大模型、更多任务,还要观察。另外 SAO 在数学上比 GRPO 低了 13 个点(51.14 vs 64.07),差距大得有点反常,baseline 的实现细节(比如 DIS 区间选择)对结果的影响值得留意。
工程上的启发倒是立竿见影的,如果你在做 LLM 的 actor-critic 训练:
- GAE 直接用 \(\lambda=1\),别犹豫,长序列下中间 critic 误差是真会淹没信号的;
- critic 试试 BCE + sigmoid 参数化,改动一行损失函数的事,消融显示收敛和区分度都更好;
- 检查你的 critic 是不是一直在追 actor 的屁股——如果算 advantage 的价值来自上一轮的 critic,Actor-then-Critic + IS 修正这个模式值得抄。
📝 收尾
信用分配问题在 RL 里存在几十年了,RUDDER、Hindsight Credit Assignment、VinePPO 都从各自角度切过。PACT 这篇的角度最"公理化":不发明新算法概念,先问"合理的信用应该满足什么",然后让定理自己推出答案。 \(C_i = V_i - V_{i-1}\) 这个形式简单到让人怀疑"就这?",但能把 OPD、RLOO、GAE 同时装进来,还在两个 agentic 任务上兑现了 8.8 和 2.0 个点的提升——Shannon 那句引言,作者确实践行了。
剩下的大问题也清晰:怎么把 \(V_i\) 估得又准又便宜。这恐怕才是 token 级信用真正落地的最后一公里。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我