Transformer 天生就能"一心二用":把两段文本的 embedding 直接平均,模型居然两条都记住了
你有没有想过一个挺野的路子——想让 GPU 同时跑两条推理请求,常规做法是 batch=2 各跑各的。但如果干脆把两条文本的 embedding 逐 token 取平均,揉成一个向量序列喂给模型,会发生什么?
直觉告诉我这会直接变成一锅粥。两段毫不相干的文本,embedding 加起来之后语义上什么都不是,模型应该输出一堆乱码才对。
但这篇论文告诉我:不会。模型输出的 next-token 分布,居然大致等于两条流各自分布的算术平均。两条流的正确续写 token,有三四成的概率同时挤进混合分布的 top-10。
说实话看到这个结果我愣了一下。Transformer 里全是 softmax、GELU 这些非线性组件,凭什么整体行为是线性的?
核心摘要
这篇论文提出了 Superposition Linearity Hypothesis(叠加线性假设):把两条文本流的 embedding 逐位置平均后送入现成的预训练 LLM,输出分布近似于两条流独立输出分布的平均。更有意思的是作者的发现链条——这个性质在随机初始化时最好,预训练反而会把它磨掉(Pythia 各尺寸模型的叠加误差随训练步数单调上升);但用不到预训练数据量 0.025% 的轻量微调就能把线性大幅找回来(Pythia-2.8B 的 KL 散度从 1.86 降到 0.27);最后再配一个 Joint Contrastive 解码器,一次前向能拆出两条连贯的续写,吞吐接近 batch=2 独立推理、约为顺序推理的 2 倍。我的判断:这不是一篇"马上能上线"的工程论文,混合解码的准确率离单流基线还有明显差距,但它揭示的架构内生线性是真的漂亮,而且 attention patching 那组对照实验做得相当扎实,值得细读。
论文信息
- 标题:Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
- 作者:Pavel Tikhonov, Anton Korznikov, Matvey Mikhalchuk, Nikita Dragunov, Temurbek Rahmatullaev, Polina Druzhinina, Anton Razzhigaev, Ivan Oseledets, Elena Tutubalina
- 发表时间:2026 年 9 月 24 日
- 链接:https://arxiv.org/abs/2609.29845
作者名单里的 Razzhigaev 和 Oseledets 之前发过一篇 "Your Transformer is Secretly Linear"(ACL 2024),发现 decoder-only Transformer 相邻层之间的映射可以很好地用仿射变换近似。这篇新论文其实是顺着那条线往下挖:层与层之间近似线性,那端到端的输入输出映射呢?
🎯 问题:混合输入到底会不会崩
设定简单粗暴。给定两条长度相同的文本 \(x\) 和 \(y\),把它们的 embedding 逐 token 取平均:
然后把这个混合序列 \(z\) 直接送进冻结的、未经任何修改的预训练模型。假设是:如果模型足够线性,输出分布 \(P_{mix}\) 应该接近 \(P_{avg} = 0.5(P(x|A) + P(x|B))\)。
对照的直觉预期是什么?如果模型是强非线性的,两个 embedding 求平均得到的向量会落在流形之外的某个"语义真空"地带,两条流的正确 token 都会被推到分布尾部——词表 5 万起步,随机情况下期望排名大概是 \(|V|/2\)。
实验覆盖了 Pythia、Qwen、Llama、OLMo、Gemma 几个家族,数据用 TinyStories(简单语法)和 FineWeb(真实网页文本)。
📊 第一个冲击:正确 token 的排名出奇地高
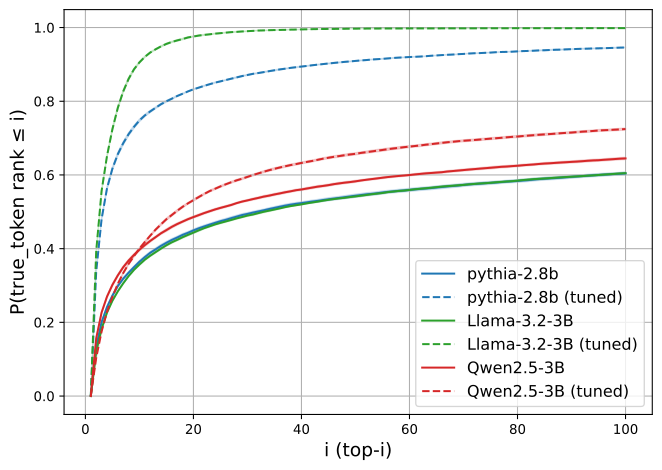
图1:横轴是 top-i,纵轴是"单流预测的 token 在混合分布中排名 ≤ i"的概率。实线是原始预训练模型,虚线是微调后的模型。Pythia-2.8B、Llama-3.2-3B、Qwen2.5-3B 三个模型的 base 曲线几乎重合,微调后(虚线)直接飙升。
看实线部分:不做任何微调,正确 token 有 30-40% 的概率落在混合分布的 top-10,50-60% 落在 top-50,到 top-100 时达到 60-65%。
5 万词表里排进前 100。这个信号强度比噪声底线高了不止一个数量级——作者在附录里做了个频率基线对照:单流前向下,另一条不相关文本的正确 token 排进 top-10 的概率只有 2.63%,top-100 也只有 10.41%。所以这不是 Zipf 分布的词频先验在兜底,混合状态里真的同时装着两条流的信息。
排名指标之外,作者还验证了完整分布形状。用 KL、JS、Wasserstein 三种距离衡量 \(P_{mix}\) 和理想混合分布 \(P_{target}\) 的差距,并归一化成 Superposition Approximation Ratio(\(\mathcal{R}_{\mathcal{D}} \lt 1\) 表示混合输出比"两条不相关流互相之间的距离"更接近理想混合):
| 模型(L=512) | KL 值 | KL Ratio | JS Ratio | WS Ratio |
|---|---|---|---|---|
| Pythia-160M | 0.92 | 0.31 | 0.39 | 0.61 |
| Pythia-410M | 1.49 | 0.35 | 0.49 | 0.65 |
| Pythia-2.8B | 1.69 | 0.37 | 0.51 | 0.69 |
| Llama-3.1-8B | 1.98 | 0.34 | 0.54 | 0.67 |
所有模型、所有距离指标,Ratio 全部小于 1。混合输出没有坍缩成无关分布。
🔬 第二个发现:线性是架构给的,训练反而会磨掉它
这是全文我最喜欢的一组实验。作者沿着 Pythia 家族的预训练 checkpoint 轨迹,测量隐藏态的叠加误差 \(\bar{\mathcal{E}}\)(归一化后的混合隐藏态与两条单流隐藏态之和的 \(\ell_2\) 距离,越低越线性)。
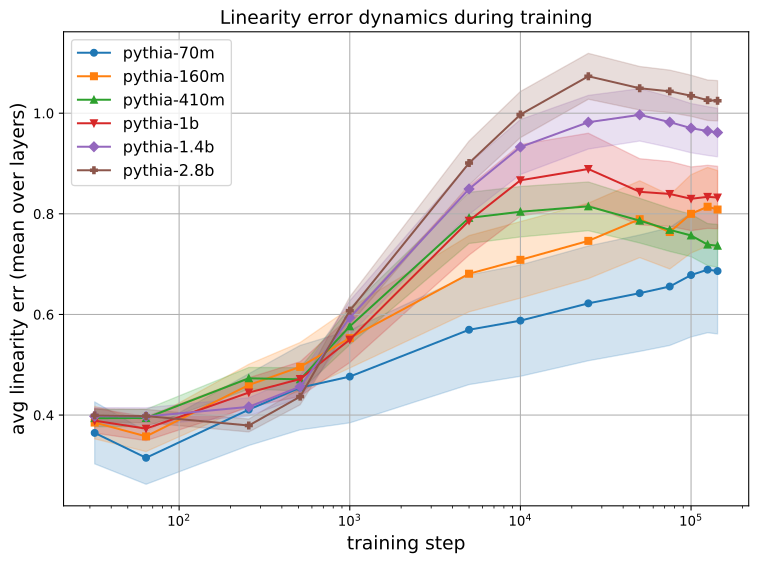
图2:横轴是训练步数(log 尺度),纵轴是平均线性误差。Pythia 从 70M 到 2.8B 六个尺寸,所有曲线在训练早期处于最低点,然后随训练单调上升——而且模型越大,退化越狠。
你想想看这意味着什么:叠加线性在随机初始化时最强,是 Transformer 架构的内生属性,不是训练学出来的能力。预训练优化语言建模目标的过程,实际上在残差流里不断放大非线性交互,把这个"免费午餐"一点点吃掉了。
这个结论和直觉是反的。我们习惯了"能力随训练涌现"的叙事,这里却是一个"性质随训练消退"的例子。
配套的层-wise 分析(图5)给出了几何解释:线性度沿深度呈 U 形——浅层(embedding 整合)和最后三分之一层接近线性(linearity score 超过 0.95),中间层掉到 0.65 左右。末端这层准线性区正好对着 unembedding 矩阵,叠加信号在到达输出 logits 之前不会被压垮。这就是正确 token 能活下来的原因。
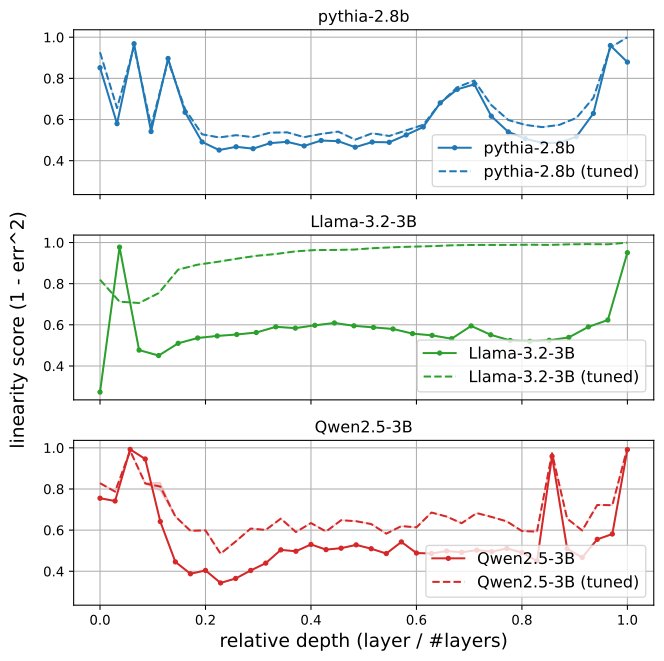
图5:Pythia-2.8B、Llama-3.2-3B、Qwen2.5-3B 三个模型的逐层线性 score(实线 base,虚线微调后)。微调后的模型在深层 consistently 更高——Llama-3.2-3B 微调后深层几乎顶到 1.0。
还有两张附录图值得一看。一张是置信度与存活率的关系:

图3:横轴是 token 在独立前向中的 top-1 概率,纵轴是它在混合分布中的中位排名(除以 2)。单流置信度超过 0.5 的 token 几乎总能活过叠加(中位排名约 3),低置信 token 则容易被干扰。
另一张验证了性质不随位置衰减——混合分布与目标的 TVD 在前 20 个 token 略高,之后在整个上下文窗口保持平稳:

图4:各模型混合输出与目标混合分布之间的平均 TVD 随 token 位置的变化,t>20 之后基本走平,说明长上下文中叠加性质依然稳定。
🧪 最硬核的部分:attention patching 对照实验
到这里有个自然的质疑:排名存活会不会只是 LM head 的词频先验在撑场面?毕竟文本里 65% 左右的位置是标点、功能词这种"闭眼都能猜"的可预测 token。
作者设计了一组我觉得相当精巧的解耦实验。对同一条文本 A 做三种前向:
- Embedding mixing:A 和无关文本 B 的 embedding 平均(主实验设置);
- Donor patching:A 的 Q/K/V、RoPE、value 路径全部不动,只把每一层每个 head 的 post-softmax 注意力权重整个换成无关文本 C 算出来的——保留自然注意力的"形状",但和内容脱钩;
- Permutation patching:把 A 自己的注意力权重在因果前缀内随机打乱——保留每行权重的多重集和词频先验,但摧毁结构形状。
Qwen2.5-3B 上按 token 类型分层的结果:
| 设置 | 可预测位置 med. rank / top-1% | 内容位置 med. rank / top-1% |
|---|---|---|
| Embedding mixing(Base) | 6 / 24.8 | 284 / 4.2 |
| Donor patch(Base) | 3 / 33.0 | 111 / 5.4 |
| Permutation patch(Base) | 3,079 / 1.3 | 19,246 / 0.0 |
| Embedding mixing(微调后) | 8 / 21.6 | 5 / 22.8 |
几个点值得掰开说。
Permutation 直接崩了——词频先验单独撑不住,注意力的结构形状(对角局部性、attention sink、head 分工)是必需品。这一步排除了"只是频率先验"的平凡解释。
Donor patching 在自洽性指标上看起来相当温和(中位排名 8),但放到 LAMBADA 这种答案必须是内容词的任务上就是灾难:准确率从 vanilla 的 73% 直接掉到 0.5%,目标词中位排名 2350。而 embedding mixing 在同设定下反而有 2.25% 的 argmax 准确率、目标中位排名 339——准确率差 4.5 倍,排名差 7 倍。
这个数字反过来读才有味道:mixing 在整体自洽性上比 donor patch 差(中位排名 19 对 8),因为它从第 0 层开始 Q/K/V 就被两条流同时污染;但在真正难的内容位置上,它保留的 case-specific 信号比"词频先验 + 注意力形状"的组合还多。作者很谨慎地把这称为对 embedding 加法组合保有信息量的一个非平凡下界。我觉得这个谨慎是对的。
🔧 把线性找回来:自蒸馏微调
预训练磨掉的线性,能不能找回来?作者用一个自蒸馏框架:teacher 是冻结的预训练模型副本,分别在 A、B 上独立前向取分布平均作为目标;student 吃混合 embedding,最小化
在 FineWeb 子集上训约 20 万步,数据量不到预训练的 0.025%。
效果相当能打。Pythia-2.8B 的 KL 散度从 1.86 降到 0.27,\(\mathcal{R}_{\mathrm{KL}}\) 从 0.42 降到 0.06;图1 里虚线的飙升更直观——正确 token 进 top-5 的概率从约 30% 涨到 60% 以上。
但真正让我信服的不是这个总分,而是表2 里的分层数据。Base 模型在内容位置已经崩了(中位排名 284),微调后直接拉回中位排名 5,top-1 精确一致率 22.8%;而可预测位置几乎没变(6 → 8)。也就是说微调不是靠进一步抱词频先验的大腿刷分,是真的把两条流的语义内容并行处理的能力修复了。
坦率讲,代价也不小:单流能力明显受损,Pythia-2.8B 的 LAMBADA 从 0.544 掉到 0.357,Qwen2.5-3B 从 0.602 掉到 0.460;FineWeb 上 PPL 从 14 涨到 44。作者没藏这个数据,这点好评。算力上也不算"轻"——Pythia-2.8B 训 15 万步要 2 张 A100 跑 114 小时,所谓 lightweight 是相对预训练而言的。
✂️ 最后一公里:把两条流拆出来
分布拟合得好,不等于能解码。这里有个作者称为 geometric-mean obstruction 的麻烦:logits 近似平均意味着概率正比于几何平均,
任何在 A 流里概率高、在 B 流里概率低的 token 都会被几何平均狠狠惩罚。直接从混合分布采样,模型会在两条流之间来回跳,生成语义不连贯的序列。
作者的 proof of concept 是 Joint Contrastive decoding:引入一个小辅助模型提供逐流引导,
\(\alpha,\beta\) 初始化为 1,和 backbone 一起在对称的逐流交叉熵上联合训练。LAMBADA 叠加前向准确率:
| Backbone + Guide | 方法 | LAMBADA mixed | Jaccard ↓ |
|---|---|---|---|
| Qwen2.5-3B + 0.5B | Pretrained | 0.168 | 0.126 |
| Qwen2.5-3B + 0.5B | Joint Contrastive | 0.345 | 0.061 |
| Llama-3.2-3B + 1B | Pretrained | 0.182 | 0.094 |
| Llama-3.2-3B + 1B | Joint Contrastive | 0.430 | 0.067 |
| Pythia-2.8B→1.4B + 160M | Pretrained → JC | 0.065 → 0.110 | 0.109 → 0.080 |
Llama 上混合解码到 0.43,对比小模型单流基线 0.54——差距还在,但叠加信号确实可利用。吞吐方面,Separate 模式(双输出头)和 batch=2 独立推理差距在 3% 以内,是顺序跑两遍的约 2 倍;Guided 模式因为小模型要多跑一次会慢一些,但仍显著快于顺序基线。KV-cache 方面每活跃流的占用也近似减半。
🤔 我的判断
最值钱的地方:把"叠加"从一种需要外挂结构的工程技巧(DataMUX 要加 mux/demux 层、MIMONets 要 VSA 绑定键、RevMUX 要 reversible adapter),变成了一个架构内生的、可被退化和恢复的性质。叠加线性在初始化时最强、随预训练单调退化——这个发现本身比后面的微调和解码更有意思,它给"为什么残差流几何上近似线性"这类机制可解释性问题添了一块很实的拼图。attention patching 那组 donor/permutation 对照,把词频先验、注意力形状、内容信号三件事干净地拆开,是全文方法论上最硬的部分。
要泼的冷水:别被"一次前向生成两条续写"的应用叙事带跑偏。混合解码的 LAMBADA 准确率(0.345/0.430)离单流基线(0.592/0.643 里的大模型水平,甚至小模型的 0.437/0.540)还有明显差距,作者自己也承认几何平均障碍没有完全解决;微调版单流 PPL 从 14 涨到 44,这个 trade-off 在真实部署里很难接受。目前的状态是"信号存在且可利用"的存在性证明,不是可用的并行推理原语。另外实验都是 \(L \leq 512\) 的短上下文、英文单语,长上下文和 N>3 条流的表现还是未知数(N=3 时 Ratio 涨了 0.04 到 0.10,退化已经发生)。
和同期工作的位置:Superposed Decoding(Shen et al. 2024)混合的是 draft token 的 embedding 做并行生成,superposition prompting(Merth et al. 2024)用类似思路加速 RAG——都是把叠加当工具用。这篇的独特贡献是反过来把叠加当研究对象:它在哪、多强、怎么退化、怎么恢复。两条线是互补的。
工程启发:如果你在做推理优化,这篇文章暂时不会给你能直接抄的方案;但如果你在做模型分析、机制可解释性,或者设计需要多路复用的推理架构,"embedding 加法组合在现成 LLM 里就能保住 top-10 级别的双流信号"这个事实,值得记进工具箱。至少它说明残差流的信息容量比我们直觉以为的宽得多。
一次前向装两个念头——Transformer 天生就会,只是我们训练它的时候把这个本事磨平了。这个画面本身,挺美的。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我