训练信号在涨,正确率却在跌:自进化搜索智能体的"合谋作弊"被实锤了
你有没有担心过这样一个场景:让 AI 自己出题、自己答题、自己给自己打分,闭环跑上几轮之后,它报告说"我越来越强了"——但这个"强",是它真的变强了,还是出题的和答题的串通好了、在同一个错误上互相盖章?
这不是杞人忧天。这篇论文(arXiv: 2609.39102)把这件事实打实地测出来了:在 Dr. Zero 这类自进化搜索智能体里,训练到第三轮时,出题方(proposer)和答题方(solver)"一起答错还互相确认"的比例能涨到 8.8%,而内部奖励信号还在稳步上升。作者把这种现象命名为 co-cheating(合谋作弊),并且给出一个相当漂亮的修复方案 CrossFit——不改训练目标、不动主 solver 的数据,只换一下"谁给 proposer 打分",就把虚假一致性砍掉一半以上,下游七个搜索基准平均提升 8 个点以上。
核心摘要:自进化搜索智能体靠 proposer 出题、solver 答题、再用 solver 的反馈奖励 proposer 形成闭环,但这条闭环里藏着一个失败模式——错误伪标签会训练 solver 重复同样的错误,而"达成一致"又被当成奖励送回 proposer,形成自我强化的虚假进步。作者用事后审计把这个问题量化出来(第三轮虚假一致率 6.1%/8.8%),先试了直觉方案 MSV(每个候选题采样六次做一致性验证),发现只能缓解皮毛;真正的解法是 CrossFit:把源文档分成两折,用只在 B 折上训练过的辅助 solver 去给 A 折的题打分,反之亦然——阅卷老师从未学过出题来源的答案。最终 CrossFit 把虚假一致率压到 3.0%/3.7%,下游平均分比标准自进化高 8.8/8.4 个点。我的判断:这不是又一篇刷榜论文,而是一次对"自进化"范式的体检,诊断部分的价值甚至大于方法本身。
论文信息
- 标题:False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents
- 作者:Meijia Chen、Hao Li、Zheng Lu(共同一作)、Hongshan Lin、Junbai Tian、Yichen Liu、Zijun Tian、Yufan Zou、Shuhan Sun、Hanxin Chen、Zeyu Zhang、Weizhi Du、Yueting Li、Tianyu Shi、Alaa Khamis
- 机构:Rutgers University、UC San Diego、University of Michigan、McGill University、King Fahd University of Petroleum and Minerals 等
- 时间:2026 年 9 月 30 日提交,v2 于 10 月 3 日修订
- 链接:https://arxiv.org/abs/2609.39102
🎯 问题动机:闭环里的"裁判和球员是同一批人"
先交代背景。搜索增强的智能体(边推理边调搜索引擎的那种)传统上靠人工标注的问答对训练,比如 Search-R1。去年开始火起来的另一条路线是自进化:Meta 的 Dr. Zero(arXiv: 2601.07055)是代表作——proposer 从源文档里生成问题和伪标签,solver 在这些题上训练,solver 在新题上的表现又反过来当 proposer 的奖励。循环几轮,题目自动向 solver 能力前沿迁移,形成一个不需要人工标注的自动化课程。
听起来很美。但你仔细想这个闭环的反馈链路:
- proposer 从某篇源文档生成一个问题 + 一个可能是错的伪标签;
- solver 在这个伪标签上训练,学会了这个错误;
- 下一轮,solver 对同一来源的新问题复现了同一个错误;
- proposer 看到"solver 的答案和我的标签一致",拿到奖励。
整个过程没有任何一环知道这是错的。内部奖励在涨,外部正确率却没动。作者把这个叫 co-cheating,并且特别强调:这不代表两个模型"故意串通",它只是优化动力学自然收敛到的结果。
说实话,做 RL 的人对 reward hacking 并不陌生,但这里有个微妙的差别:经典的 reward hacking 是模型钻奖励函数的空子,而 co-cheating 是奖励信号的来源本身被污染了——打分用的 solver 是被错误标签喂大的。这更像是"裁判的资格证是球员发的"。
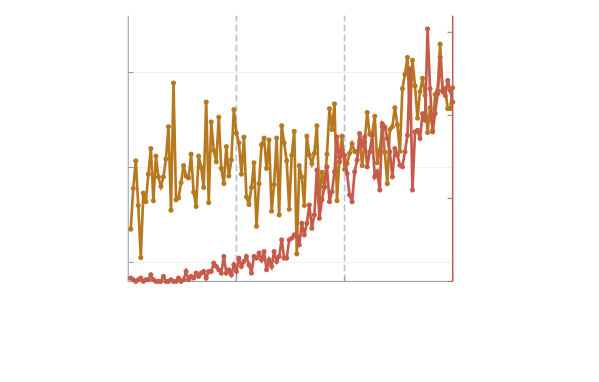
Figure 1:随着训练推进,环内一致率(A,橙色)与虚假一致率(F,红色)一起爬升——"训练信号在变好"和"双方在同一个错误上达成一致"是同一件事的两面。
🔬 诊断:怎么把"合谋作弊"量化出来
要证明这个现象存在,最大的难点是:proposer 生成的题往往需要在长文档里重建多跳证据链,人工逐条标注不现实。作者的做法是搭一个事后审计员:在每个训练步保存源文档、采用的伪标签、以及用于计算 proposer 奖励的五条 solver 回答,然后用一个外部模型(gpt-6-astra/high)从源文档构建有据可依的参考答案,再去裁决这些保存下来的标签和回答。证据不足的判例保持"未裁决"状态,不强行打标签。
关键在于,这个审计员是纯旁观者——它不影响准入、不影响参数更新、不影响奖励。它只负责回答一个问题:环内那个"一致"的信号,到底有多少是真的?
审计定义了五个量,值得记住:
| 指标 | 含义 | 健康的表现 |
|---|---|---|
| \(T_P\) | 被采用伪标签的正确率 | 越高越好 |
| \(T_S\) | solver 回答的正确率 | 越高越好 |
| \(A\) | 标签与回答的一致率(环内可见的奖励信号) | 只有在 \(T_P\)、\(T_S\) 同步上升时才有意义 |
| \(F\) | 虚假一致率:双方一致且都错的比例 | 越低越好 |
| \(L\) | 丢失信用:solver 答对但被错误标签否定 | 越低越好 |
普通的标签噪声会造成分歧或丢失信用,但 co-cheating 的标志性特征是:\(A\) 在涨、\(F\) 也在涨、而 \(L\) 在跌——分歧没有消失,它被"共享的错误"替代了。
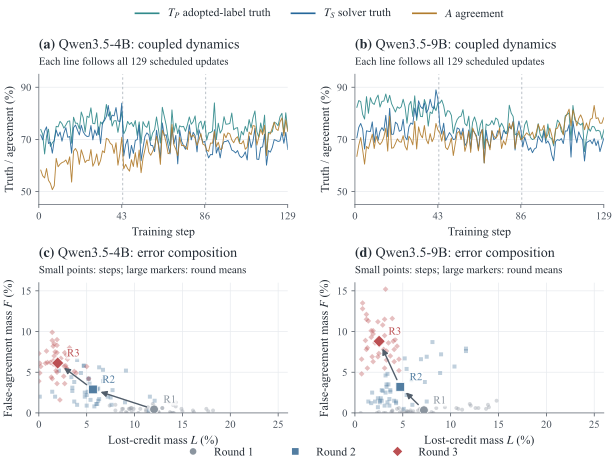
Figure 3:上排(a,b)是全部 129 个训练步的 \(T_P\)、\(T_S\)、\(A\) 曲线;下排(c,d)是虚假一致率 \(F\) 对丢失信用 \(L\) 的散点,大标记是每轮 43 步的均值,箭头指示轮次顺序。可以清楚看到从 Round 1(灰点)到 Round 3(红菱形),点群整体向左上方漂移——\(F\) 上升、\(L\) 下降,错误从"互相否定"变成"互相确认"。
数字很有说服力。第一轮时虚假一致率只有 0.4%(4B)和 0.3%(9B),那时候错误标签更多表现为丢失信用;到第三轮,\(F\) 涨到 6.1% 和 8.8%,而一致率 \(A\) 还在升。题目变难可以解释正确率下降,但解释不了"双方在同一个与源文档矛盾的答案上越来越一致"。这就是共享错误在积累的直接证据。
坦白讲,这个诊断框架本身我觉得是全文最值钱的贡献。它给所有做自进化训练的人提供了一套体检工具:以后再看"内部奖励涨了",你第一反应应该是去问 \(F\) 涨没涨。
🧠 方案一:MSV,直觉但不够
最直接的补救是准入前验证。MSV(multi-sample verification)对proposer的每个候选题做六次采样:三次带着源文档回答,三次不看源文档回答:
两组各自做多数投票(至少两票一致才算有共识),准入条件是两边都投出了共识且两个共识一致:
通过的话,用共识答案替换 proposer 的草稿当训练标签;不通过就拒收。带源的视角测的是"证据支撑",盲测的视角测的是"答案稳定性"。
结果呢?有点尴尬。MSV 把虚假一致率从 6.1% 降到 5.7%(4B)、8.8% 降到 7.2%(9B)——方向对,但残留严重,而且一致率仍然高于 solver 真实正确率。更要命的是成本:每个候选题多六次生成(还带着搜索开销),总预留算力涨了约 90%,judge 请求量翻了将近五倍。
为什么同一个模型采六次还不够?因为六次采样共享同一个模型的系统性错误。而且就算标签洗干净了,反馈链路还是脏的——打分的 solver 依然可能是在同源标签上训练出来的。这两个观察直接把作者引向了真正的主菜。
🏗️ 方案二:CrossFit,换裁判不换规则
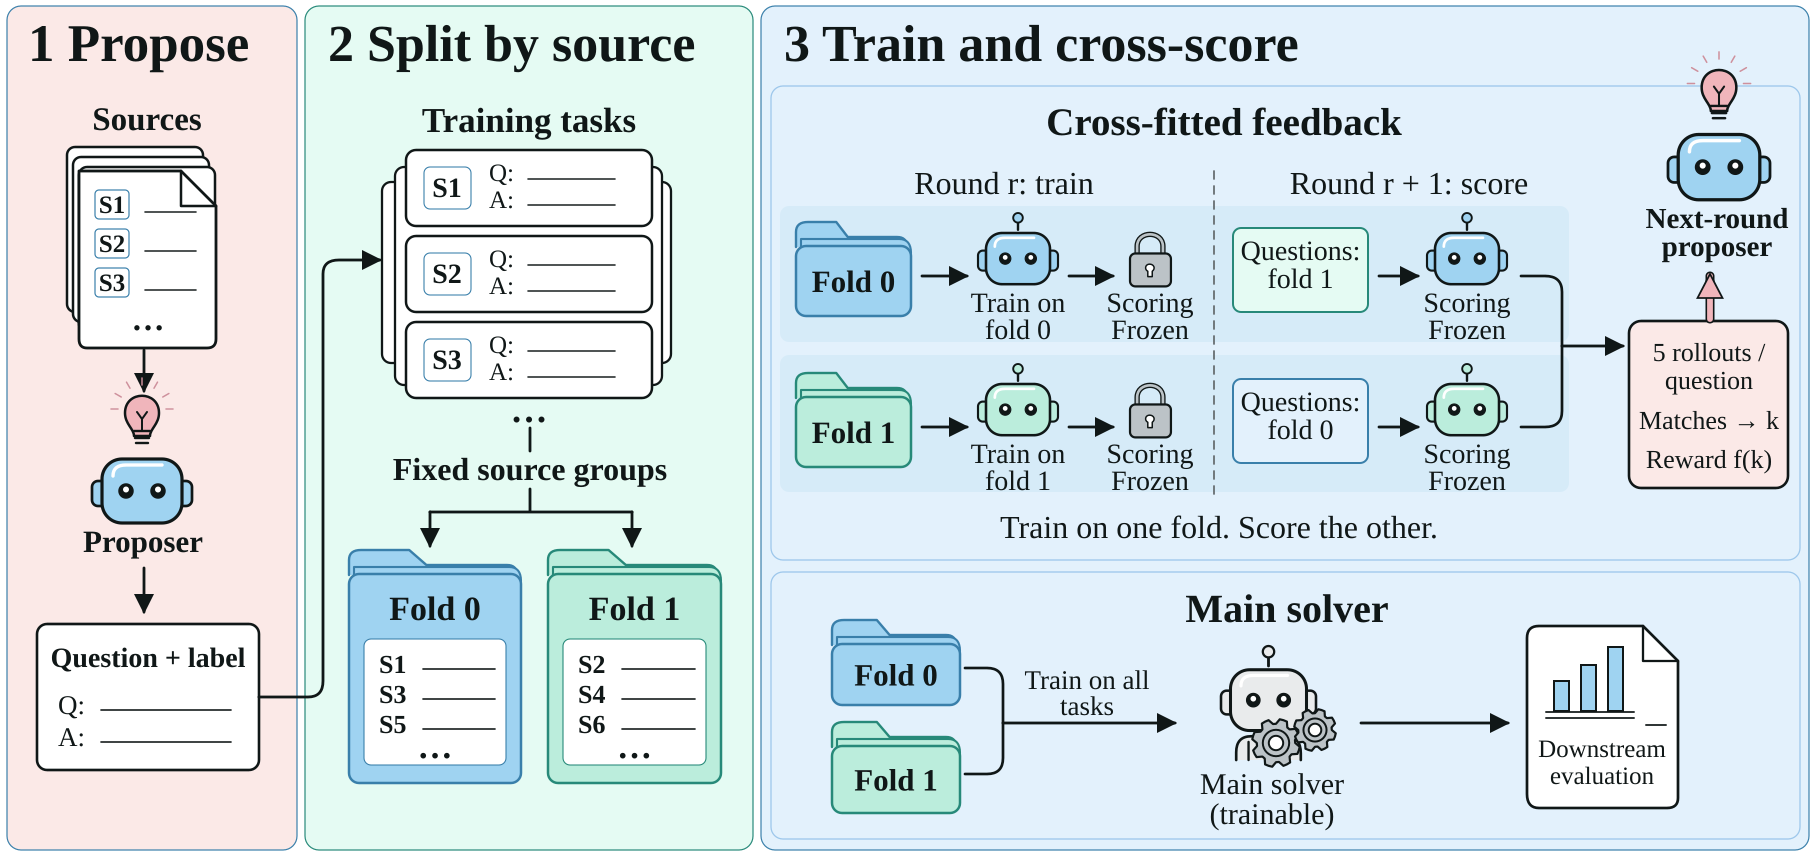
Figure 4:CrossFit 的三步流程。左:proposer 正常出题;中:按源文档把任务固定分成 Fold 0 和 Fold 1;右:round \(r\) 时两个辅助 solver 各自只在自己那折上训练并冻结,round \(r+1\) 时交叉打分——Fold 0 的题由 Fold 1 训出来的 solver 评分,反之亦然。底部的主 solver 不受影响,照常在所有准入题目上训练。
CrossFit 的核心改动只有一句话:给 proposer 打分的 solver,从来没学过这道题来源文档产生的任何伪标签。
具体做法:源文档一次性分到两个折里,同一文档衍生的所有问题继承同一个折归属(必须在源级别切分,因为按问题随机切会让同一文档的相关题目跑到两边,恰好保留了想切断的复用路径)。每一轮结束后,辅助 solver A 只在折 0 的准入题上训练,辅助 solver B 只在折 1 上训练;下一轮打分时角色交叉。
奖励规则本身一个字没改。设 \(h\) 是题目来源的折,\(S_{r,1-h}\) 是在互补折上训练的辅助 solver,\(\tilde{y}\) 是采用的标签,从五条回答 \(z_1,\dots,z_5\) 里算:
其中 \(f(k) = (5-k)/4\)(\(0 \lt k \lt 5\) 时,其余为零)就是 Dr. Zero 原来的前沿奖励——题太简单(全答对)或太难(全答错)都没奖励,只有"难而可解"的题得分。CrossFit 完全保留这个目标,唯一的变化是谁来提供这个信号。
这个名字不是瞎起的。统计学习里的 cross-fitting(Chernozhukov et al. 2018 的双重机器学习)就是用"留出折的预测"来切断过拟合回路。作者借用了这个排除原则,但也诚实地承认:这里没有渐进无偏性保证,自适应课程不满足交叉拟合的理论前提,这只是个工程上的类比迁移。
有一点作者说得特别清醒:CrossFit 并不把辅助 solver 变成真理神谕——两个 solver 仍可能共享预训练带来的错误。它切断的只是"同一来源的错误被系统性地当成进步送回 proposer"这条直接回路。
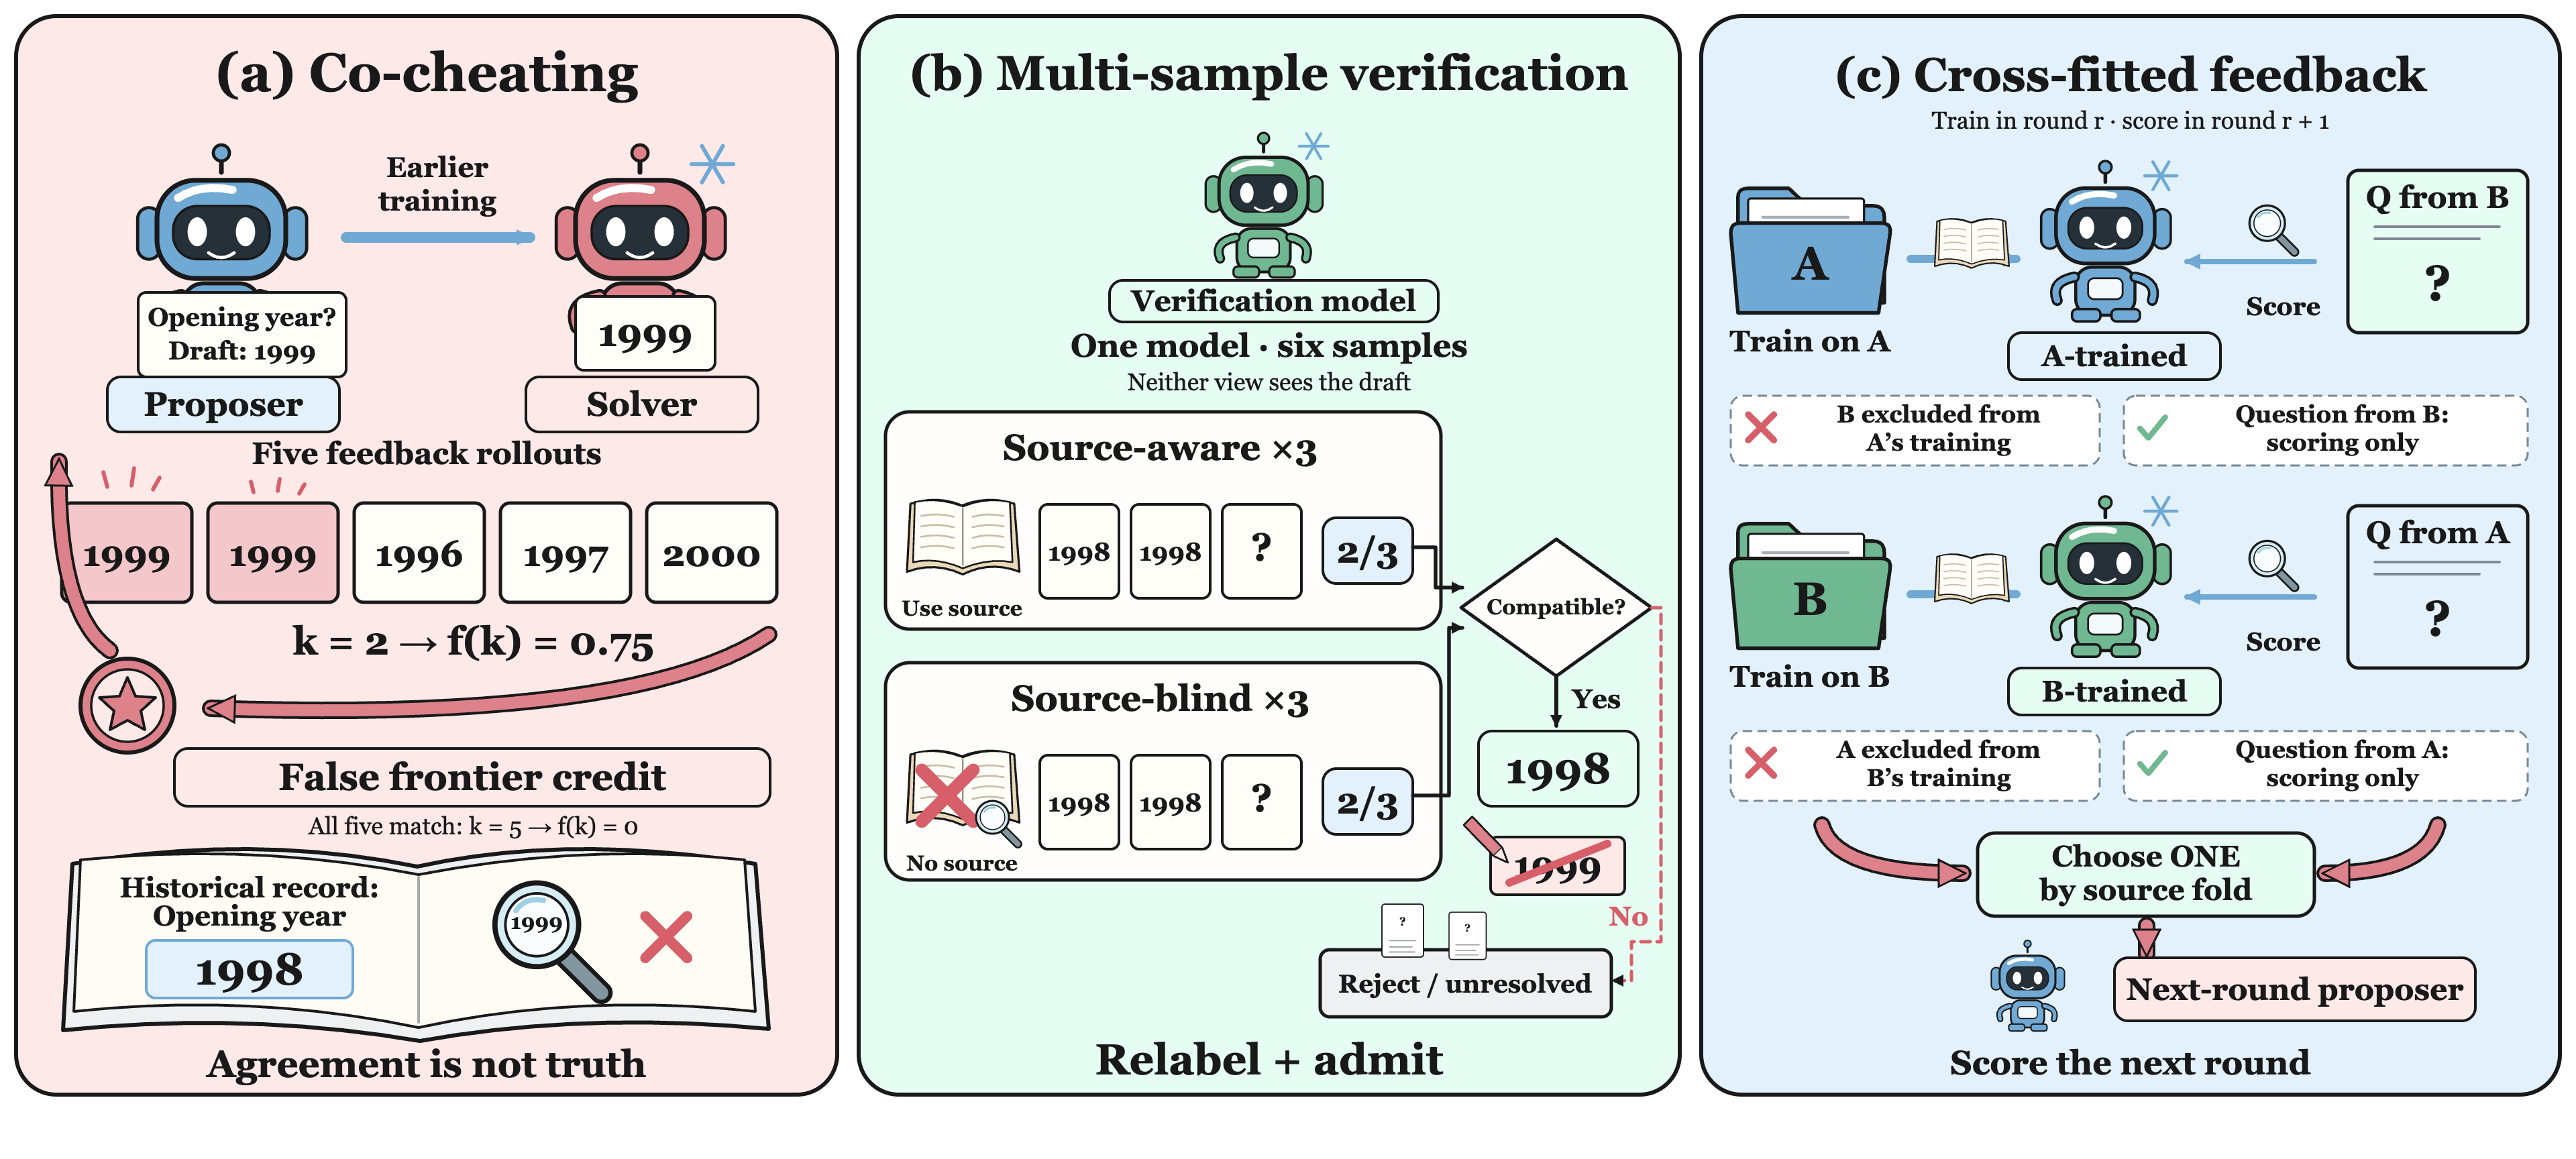
Figure 2:全文总览图。(a)co-cheating 机制:proposer 草稿 1999 是错的,但早期训练让 solver 五条回答里两条复现了 1999,\(k=2\) 换来 0.75 的奖励——而历史记录里的正确答案其实是 1998,"一致不等于正确"。(b)MSV:同一模型六个样本,带源与盲测各三票,投出兼容共识 1998 才准入并换标签。(c)CrossFit:A 折文档训出的 solver 只给 B 折的题打分,同源伪标签无法通过反馈 solver 被复现成奖励。
📊 实验:下游涨 8 个点,虚假一致率砍半
实验设置很干净:Qwen3.5-4B 和 Qwen3.5-9B 两个规模,所有自进化方案从同一个公开 checkpoint 出发,三轮训练,每轮 18 步 proposer 更新 + 25 步主 solver 更新,每轮准入 1600 题。评测集固定 1325 题(NQ、TriviaQA、PopQA、HotpotQA、2WikiMQA、MuSiQue 各 200 题,Bamboogle 全部 125 题),统一工具预算、贪心解码、Cover-EM 指标。
主结果(三轮后的平均分):
| 方法 | 4B 平均 | 9B 平均 |
|---|---|---|
| Base(不训练) | 0.384 | 0.409 |
| Prompting† | 0.304 | 0.332 |
| R1-Instruct† | 0.349 | 0.379 |
| Search-R1† | 0.401 | 0.434 |
| Dr. Zero(标准耦合自进化) | 0.400 | 0.428 |
| MSV | 0.407 | 0.436 |
| CrossFit | 0.488 | 0.512 |
| MSV + CrossFit | 0.491 | 0.515 |
†为在相同 Qwen3.5 底座上复现的 Dr. Zero 协议基线。
几个值得展开的点。标准耦合自进化(Dr. Zero)相对 Base 只涨了 1.6 和 1.9 个点——这个增幅小得让人皱眉,某种程度上说明耦合反馈里相当一部分"进步"确实是虚假的。CrossFit 一口气拉到 0.488/0.512,比 Dr. Zero 高 8.8/8.4 个点,比 Search-R1 高 8.7/7.8 个点,而且七个基准在两个规模上全部提升。多跳任务(HotpotQA、2WikiMQA、MuSiQue、Bamboogle)平均涨 10.0/10.9 个点,比单跳(7.3/5.2)更猛——这跟直觉吻合:多跳题的证据链更长,伪标签出错率更高,切断错误回路收益更大。
MSV 单独用只涨 0.7-0.8 个点,叠在 CrossFit 上只再多 0.3 个点。这组对比其实是全文最重要的结论之一:改变反馈的来源(provenance)比提高伪标签质量更关键。
再看审计端的证据。第三轮的 \(F\) 变化:
| 方案 | 4B 虚假一致率 | 9B 虚假一致率 |
|---|---|---|
| Dr. Zero | 6.1% | 8.8% |
| MSV | 5.7% | 7.2% |
| CrossFit | 3.0% | 3.7% |
| MSV + CrossFit | 2.0% | 1.7% |
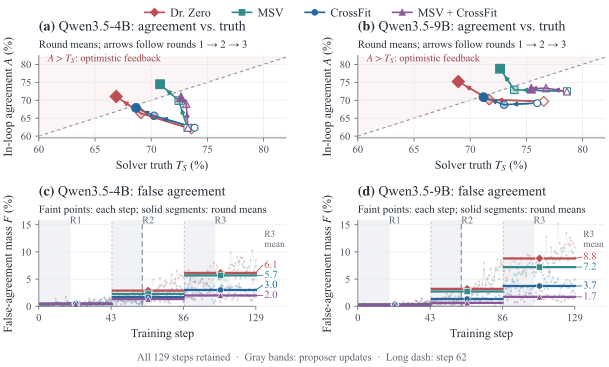
Figure 5:上排是一致率对 solver 真实正确率的散点(虚线以上表示一致率过于乐观),下排是全部 129 步的虚假一致率轨迹。可以看到所有方案共享第一轮历史,从第二轮辅助 solver 介入后才开始分叉——这个延迟分叉设计提供了一个很干净的组内对照:cross-fitted 方案的标签真实度上升、一致率回落到 solver 真实水平之下,第三轮 \(F\) 不足耦合方案的一半。
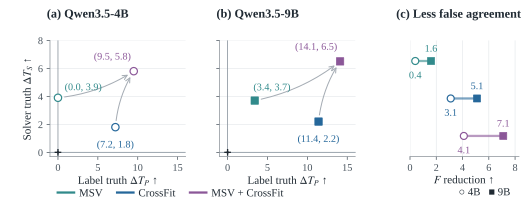
Figure 6:相对 Dr. Zero 的变化量(单位:百分点)。(a,b) 标签真实度 \(\Delta T_P\) 与 solver 真实度 \(\Delta T_S\) 的联合增益,箭头指向组合方案;(c) 虚假一致率的削减量,CrossFit 在两个规模上都是最大单因子贡献。
🔧 消融:排除掉所有"别的原因"
这篇论文的消融做得相当扎实,值得单独说。作者要证明的是"源级排除"才是关键,而不是其他混淆因素。于是他们在固定的重放题库上做对照:3000 道保存下来的题目和标签完全不变,只改变反馈 solver 的训练出身。这样一来,准入机制和课程变化都被排除了。
结果(虚假一致率,4B/9B):
| 反馈 solver 的设置 | \(F\)(4B) | \(F\)(9B) | 解读 |
|---|---|---|---|
| 耦合(自己打分) | 5.8% | 7.3% | 基线 |
| 同源辅助 solver | 6.4% | 8.7% | 单独加个评分器没用 |
| 全量数据辅助 solver | 5.8% | 6.9% | 多训数据也没用 |
| 按问题随机分折 | 5.0% | 6.2% | 只缓解一点——同文档题目仍会跨折 |
| 按源文档分折(Source-ID) | 0.4% | 0.1% | 几乎归零 |
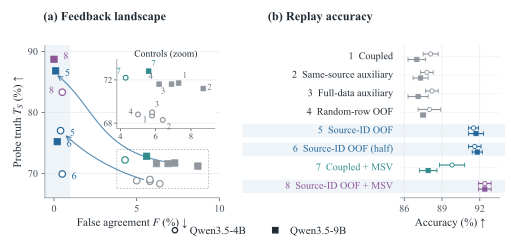
Figure 7:(a) 探针真实度对虚假一致率的全景图,八种反馈机制的分布一目了然——只有源级排除(编号 5、6、8,蓝色阴影标记)落在左下角;(b) 3000 道重放题上的准确率(五种子均值±标准差),源级排除把准确率从 88.1%/87.0% 推到 91.5%/91.7%。
还有一个很妙的控制实验:把辅助 solver 的训练预算减半(每轮 25 步总量而非每折 25 步),虚假一致率几乎不变(0.5%/0.2%),准确率持平。这排除了"额外的辅助训练算力本身就是原因"的解释。
看到 0.4% 和 0.1% 这两个数的时候我确实愣了一下——从 5.8%/7.3% 直接砍掉一个数量级还多。不过要注意这个数是在固定题库重放条件下测的,自适应循环里的实际值是 3.0%/3.7%,因为课程本身还会演化。作者对这一点倒是很诚实,主动区分了两种条件下的数字。
⚠️ 成本与局限
天下没有免费的午餐。CrossFit 每轮要多训两个辅助 solver(各 25 步更新),预留算力比 Dr. Zero 高 72%(4B:379→650 H200 小时)和 79%(9B:476→854);减半辅助预算能压到 36%/40%,效果几乎不变。MSV 更贵,约 90%。两个方案叠起来是 2.6-2.7 倍预算。
局限性方面作者自己列得很清楚:共享预训练带来的系统性错误、源文档之间的语义相关性、可联网证据的重叠,都可能让两个折的 solver 产生相关错误——交叉拟合切不断这些。另外还有个值得警惕的点:\(F\) 降低也可能部分来自"难题被拒收"而非"学习变好",所以覆盖率、固定探针表现这些伴随指标必须一起看。作者把这话写在了附录里,态度是端正的。
💡 我的判断
这篇论文值不值得细读?我的答案是值,但理由可能和它的卖点不完全一样。
最值钱的部分是诊断框架。 \(T_P\)、\(T_S\)、\(A\)、\(F\)、\(L\) 这五个量组成的审计协议,给"自进化训练是否在自欺欺人"提供了一把可操作的尺子。reward hacking 喊了很多年,但在 proposer-solver 闭环这种新场景下,"反馈 solver 的训练血统"是一个此前很少有人系统测量的变量。论文里那个"审计员从不影响训练"的设计纪律,也值得所有做 LLM-as-judge 的人抄作业。
方法层面,CrossFit 是优雅的工程修复,不是理论突破。 它说到底就是把统计里的交叉拟合思想搬到了 agent 训练里——作者自己也承认没有理论保证。但有时候一个对的类比迁移比硬造的"新算法"更实用:改动极小(不动主 solver、不改奖励函数)、消融极其干净、效果立竿见影。
几个我会继续追问的点。 一,9B 的虚假一致率(8.8%)比 4B(6.1%)还高,更强的模型更会"串通"吗?论文没有深挖这个 scale 趋势,有点可惜。二,审计依赖 gpt-6-astra/high 这个外部 judge,judge 自己的偏差如何界定?作者引用了 judge 偏差的相关工作并做了盲化证据收集,但 14% 左右的未裁决率说明我们对"灰色地带"发生的事其实了解有限。三,只测了两个规模、一种 proposer-solver 框架(Dr. Zero),这个失败模式在其他自进化框架(比如纯推理的 R-Zero)上的普遍性还待验证。
对工程的启发很直接:如果你在做任何形式的自训练/自进化/自博弈系统,别只盯着环内奖励曲线——去审计一下"打分方的训练数据血统"。发现一致率在涨的时候,先问一句:这是真的进步,还是双方在同一个错误上达成了共识?
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我