把重要性采样比换成「互补概率比」:BPO 用贝尔曼方程重构 PMD,AIME 平均 50.5%
做 RLVR 的同学大概率都有过这个纠结:GRPO 里的重要性采样比 \(r_t=\pi(y_t|s_t)/\mu(y_t|s_t)\) 到底是在修正分布偏移,还是在制造新的麻烦?比值容易爆炸,clip 一上大梯度就被截断,调 \(\epsilon_{\text{low}}\)、\(\epsilon_{\text{high}}\) 的手感堪比玄学。上周翻到这篇 Bellman Policy Optimization(BPO),我的第一反应是——等等,它居然把这个比值整个换掉,换成一个「互补概率的平滑比值」,而且这个替换不是拍脑袋,是从 Policy Mirror Descent 一路推导下来的。看完推导过程,我承认被说服了一大半。
核心摘要:RLVR 训练里,GRPO 家族的 PPO 式重要性采样比一直是训练稳定性的主要摩擦点。这篇论文从 Policy Mirror Descent(PMD)出发,利用终端奖励场景下贝尔曼方程的伸缩(telescoping)性质,把需要逐状态价值估计的 PMD 重写成只依赖终端奖励和初始价值的轨迹级目标,并证明两者在 rollout 策略可达状态上拥有相同的唯一最优解。实用版 BPO 损失用组内均值估计初始价值、用二元 KL 近似全词表 KL,最终梯度里的权重变成 \(\omega_t=\frac{1+\epsilon-\mu}{1+\epsilon-\pi}\) 这样的互补概率比。在 Qwen3-30B-A3B-Base + DAPO-Math-17k 上,BPO 在 AIME24–26 的 Avg@32 平均准确率达到 50.5%,比最强 baseline CISPO 高 3.1 个点,比 GRPO-ClipHigher 高 11.0 个点。这是一篇理论推导扎实、工程落地干净的论文,值得做 RLVR 的人细读。
论文信息 - 标题:Bellman Policy Optimization - 作者:Zhuoqing Song(Apodex US, Inc. / Princeton University)、Haotian Xu、Xikun Zhang、Lidong Bing(Apodex US, Inc.) - 时间:2026 年 9 月 14 日(arXiv:2609.15987v1,cs.LG) - 链接:https://arxiv.org/abs/2609.15987
🎯 问题动机:GRPO 家族到底在别扭什么
先把背景摆清楚。RLVR 的特点是奖励只在整条回答的末尾给——答案对了给 1,错了给 0,中间步骤没有奖励信号。GRPO 的做法很直接:每个 prompt 采 G 条回答,用组内均值方差把奖励归一化成优势 \(\hat{A}^i\),然后套一个 PPO 式 clip 的目标,token 级权重就是重要性采样比 \(r_t^i\)。
问题出在哪?rollout 策略 \(\mu\) 和训练策略 \(\pi\) 天然有偏差——两次更新之间模型变了,训练和推理引擎的数值实现也不一致(这个 training-inference mismatch 今年被好几篇论文翻来覆去地讨论)。于是 \(r_t^i\) 偏离 1,clip 机制就得出面收拾残局。GSPO 把比值换成序列级的,CISPO 直接 clip 比值本身,DPPO 换了散度度量——说实话,这一大家子都是在围绕「重要性采样比不听话」这件事打补丁。
BPO 的作者换了个角度:与其修补比值,不如回到更本源的目标——Policy Mirror Descent。PMD 的逐状态更新是
理论上很干净,闭式解就是 \(\pi^+(y_t|s_t) \propto \mu(y_t|s_t)\exp(\eta A^\mu(s_t,y_t))\)。但直接用它需要每个中间状态的 advantage 估计,通常就得再训一个 value model——内存翻倍不说,推理任务上学出来的价值还经常不准。GRPO 当年选择绕开 critic,BPO 则是想把 PMD 本身改写成不需要 critic 的形式。
🧠 方法核心:贝尔曼方程的伸缩戏法
BPO 推导里最漂亮的一步,是利用终端奖励 MDP 里的贝尔曼结构。中间奖励全为零时,\(Q^\mu(s_t,y_t)=V^\mu(s_{t+1})\)(转移是确定性的),所以单步 advantage 就是相邻状态的差:
沿一条回答把这个差累加起来,中间项全部抵消——这就是伸缩求和:
你想想看,一整条轨迹上每个 token 的 advantage,加起来居然只剩「终端奖励减去初始价值」两项。\(R(x,y)\) 是 verifier 直接给的,\(V^\mu(x)\) 是 prompt \(x\) 在 rollout 策略下的期望奖励,用组内采样均值就能无偏估计。中间状态的价值函数整个消失了——这就是 critic-free 的来源。
顺着这个恒等式,作者把 PMD 的最优性条件逐 token 写出来、消掉配分函数 \(Z_\mu(s_t)\)(它恰好等于一个反向 KL),再沿轨迹求和,得到轨迹级残差:
新的目标就是在 rollout 分布下最小化 \(\mathbb{E}\big[\phi(x)\,\delta^2/(2\eta)\big]\)。论文的 Theorem 1 证明:这个目标的最小值是 0,且任何最优解在 rollout 可达状态上与 PMD 的解 \(\pi^+\) 诱导出完全相同的补全分布。必要性证明用了个挺巧妙的鞅论证——token 级残差在 rollout 策略下条件期望为零,构成鞅,终端值为零就推出每一步都为零。这个证明我是认真看了一遍的,没毛病。
从理论目标到实用损失:四步近似
理论目标有了,但它含全词表 KL、含平方残差,直接算不现实。作者用四步近似把它搓成能跑的样子:
- 线性化:在 \(\pi=\mu\) 附近对残差线性展开,梯度里的残差因子 \(\delta/\eta\) 被替换成 \(R(x,y^i)-V^\mu(x)\)。
- 组内估计:\(V^\mu(x)\) 用组内奖励均值估计,权重 \(\phi(x)\) 取奖励标准差的倒数——这两项合起来,恰好就是 GRPO 的组归一化优势 \(\hat{A}^i\)。看到这里我有点想笑,GRPO 的 advantage 居然从 PMD 推导里自然掉出来了。
- 二元 KL 近似:把全词表反向 KL 换成二元 KL(把动作空间切成 \(\{y_t\}\) 和它的补集)。附录 A.2 证了个很干净的恒等式:
这个互补概率比 \(\frac{1-\mu}{1-\pi}\) 就是 BPO 权重的原型。注意它和重要性采样比 \(\pi/\mu\) 的方向感完全不同:它度量的是「两个策略给其他所有 token 留的概率之比」。 4. 平滑 + 掩码 + 截断:\(\pi(y_t|s_t)\to 1\) 时分母会炸,于是加性平滑 \(\epsilon\),得到最终的失配修正权重(mismatch-correction weight):
最终 BPO 的 token 级损失长得和 GRPO 几乎一模一样,只是把 \(r_t^i\) 换成了截断后的 \(\omega_t^i\):
其中掩码 \(M_t^i\) 沿用 GRPO 的 clip 规则(\(\omega_t^i\) 超出 \([1-\epsilon_{\text{low}}, 1+\epsilon_{\text{high}}]\) 时置零)。实现上改动量极小——这大概是工程上最讨喜的地方,改一行权重计算就换了个算法。
📊 实验结果:数字说话
实验设置控制得挺严格:Qwen3-30B-A3B-Base,DAPO-Math-17k 英文子集,每批 256 个 prompt × 16 条回答,4096 条回答拆成 8 个 minibatch,训 400 步,最大回答长度 16384 token,所有方法都用 rollout-router replay(R3),只改 policy loss。评测是 AIME24/25/26,Avg@32 估计 Pass@1。
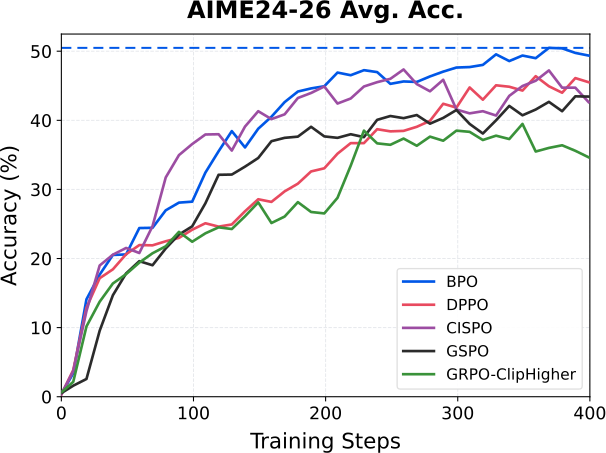
图1:400 步训练过程中 AIME24–26 平均准确率(Avg@32)的变化。蓝色的 BPO 曲线从中段开始持续领先,并在约 350 步处摸到 50.5% 的峰值(水平虚线);CISPO(紫)和 DPPO(红)咬在中游,GRPO-ClipHigher(绿)明显垫底。注意 BPO 后段略有回落,峰值和终点之间有约 1 个点的差距。
表1:AIME Avg@32(%),Qwen3-30B-A3B-Base,各方法取三基准均值最高的 checkpoint
| 方法 | AIME24 | AIME25 | AIME26 | 平均 |
|---|---|---|---|---|
| GRPO-ClipHigher | 45.6 | 34.8 | 38.0 | 39.5 |
| GSPO | 50.3 | 35.5 | 44.6 | 43.5 |
| CISPO | 52.7 | 39.0 | 50.4 | 47.4 |
| DPPO | 55.8 | 39.2 | 44.2 | 46.4 |
| BPO | 57.4 | 41.0 | 53.0 | 50.5 |
BPO 在三个基准上全部第一,平均 50.5%,领先最强 baseline CISPO 3.1 个点,领先 GRPO-ClipHigher 整整 11.0 个点。训练终点(400 步)的平均准确率 BPO 也是最高的 49.4%,对比 DPPO 的 45.5%。
不过我得泼一点冷水:表里报的是「峰值 checkpoint」的成绩,带模型选择的成分。好在这类报告方式在 DAPO 以来的 RLVR 论文里是通行做法,各方法一视同仁,横向对比还是公平的。而且图 1 的曲线显示 BPO 不是某一步运气好 spike 上去的,是持续领先。
超参数敏感度:意外地平
消融在 Qwen3-4B-Base 上做,训 1000 步。\(\epsilon\) 扫 \(\{0.05, 0.1, 0.2, 0.3\}\)、\(C\) 扫 \(\{2.0, 3.0, 4.0\}\):
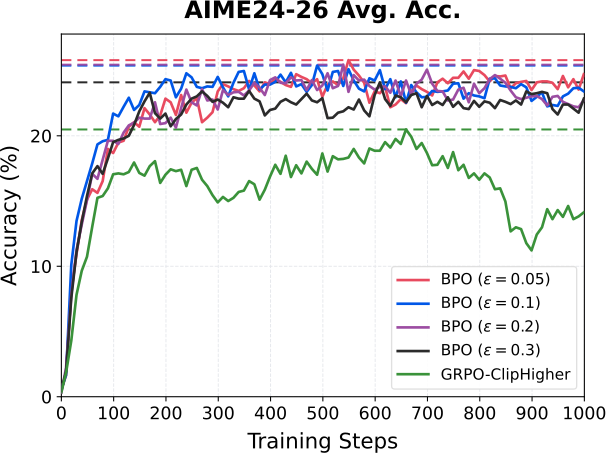
图2:固定 C=3.0 扫 ε。四条 BPO 曲线的峰值(虚线)挤在 24–26% 之间,而 GRPO-ClipHigher(绿)不仅峰值低 4–5 个点,600 步后还出现明显崩塌——准确率从 20% 附近掉到 15% 以下。这个对比其实比峰值数字更能说明问题:BPO 的权重设计对长尾训练更稳。
表2:\(\epsilon\) 消融(C=3.0),AIME Avg@32(%)
| 方法 | AIME24 | AIME25 | AIME26 | 平均 |
|---|---|---|---|---|
| BPO(\(\epsilon=0.05\)) | 31.6 | 23.0 | 22.8 | 25.8 |
| BPO(\(\epsilon=0.1\)) | 27.6 | 26.8 | 21.8 | 25.4 |
| BPO(\(\epsilon=0.2\)) | 29.1 | 24.3 | 23.0 | 25.5 |
| BPO(\(\epsilon=0.3\)) | 26.4 | 25.5 | 20.4 | 24.1 |
| GRPO-ClipHigher | 22.1 | 22.8 | 16.6 | 20.5 |
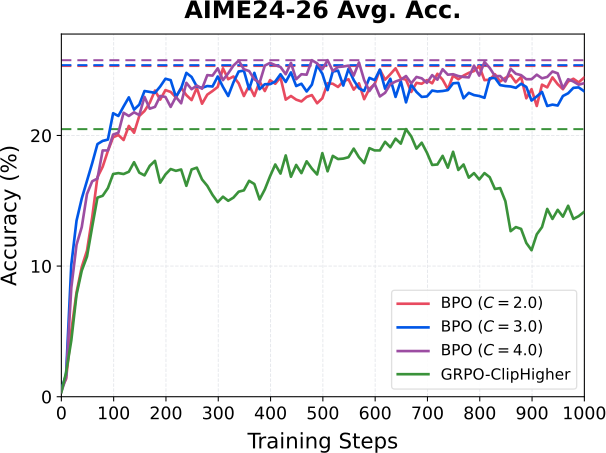
图3:固定 ε=0.1 扫 C。C 取 2.0/3.0/4.0 的三条曲线几乎缠在一起,峰值都在 25% 以上。
表3:\(C\) 消融(\(\epsilon=0.1\)),AIME Avg@32(%)
| 方法 | AIME24 | AIME25 | AIME26 | 平均 |
|---|---|---|---|---|
| BPO(C=2.0) | 26.4 | 26.0 | 23.5 | 25.3 |
| BPO(C=3.0) | 27.6 | 26.8 | 21.8 | 25.4 |
| BPO(C=4.0) | 27.1 | 29.0 | 21.3 | 25.8 |
| GRPO-ClipHigher | 22.1 | 22.8 | 16.6 | 20.5 |
两组消融里 BPO 的最差配置都比 GRPO-ClipHigher 高 3.6 个点以上,\(C\) 的三个取值之间只差 0.5 个点。做工程的人都懂这有多省心——少一个要仔细调的超参,这在实际训练 pipeline 里是真金白银的价值。
🤔 我的判断
这篇论文最值钱的地方,是把「替换重要性采样比」这件大家都在做的事,从启发式补丁升级成了有定理背书的推导。\(\omega_t=\frac{1+\epsilon-\mu}{1+\epsilon-\pi}\) 这个权重不是调出来的,是二元 KL 近似下梯度恒等式的自然产物。顺着今年 DPPO、GSPO、CISPO 这条线看,BPO 给出的理论锚点是最清晰的之一。
但有几个地方要保持清醒。
说实话,理论和实用之间的缝隙不小。Theorem 1 保证等价的是那个轨迹级平方残差目标,而最终上车的损失经历了线性化、二元 KL 近似、加性平滑、clip 四道近似,每一步都打破了严格等价。论文对此很坦诚,没有过度声称,这点我欣赏,但读者自己心里有数:定理是动机和方向感,不是性能保证。
实验范围也偏窄。主结果只有数学推理、只有 AIME 三个基准、只有一个 30B-A3B 模型;消融还缩到了 4B。AIME 本身方差不小(30 道题的竞赛基准,Avg@32 也只是缓解),50.5% 对 47.4% 的差距换算下来大概是多对一两道题的水平——方向肯定是对的,但幅度上没有数字乍看起来那么震撼。代码生成、Agent 任务上能不能复现这个优势,还是未知数。
另外那个互补概率比有个值得玩味的性质:当模型对采样到的 token 越来越自信(\(\pi\to 1\)),\(\omega_t\) 会被推到截断上限 \(C\),相当于给「过度自信」的 token 强行加大梯度权重。这到底是修正 mismatch 还是另一种形式的熵坍缩推手,论文没有展开讨论。从图 1 后段 BPO 曲线的轻微回落看,这个机制可能确实有双刃剑成分——当然这也可能只是我的过度解读,坦诚说这块我没完全想透。
工程建议很直接:如果你在维护一套 GRPO 系的 RLVR 训练,BPO 的改动成本低到几乎没有理由不试——advantage 计算不变、clip 掩码不变,只是把 \(r_t\) 换成 \(\omega_t\),默认 \(\epsilon=0.1\)、\(C=3.0\) 就是论文主实验配置,而且消融显示这两个参数都不敏感。就算最终收益打个对折,这个试错成本也是划算的。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我