Agensh:干掉总调度,1024 个智能体自己组织起来干活
上周刷到一篇让我停下来的论文。做 Agent 系统的人这两年都在卷同一个结构——一个主 Agent 当"包工头",负责拆任务、派活、收结果,下面挂一排工人。Codex 的 sub-agent、Claude Code 的 agent teams、Kimi 的 Agent Swarm,全是这个 orchestrator-worker 套路。
问题来了:包工头一个人盯得过来 1024 个工人吗?
微软研究院这篇 Agensh(arXiv:2609.26781)给出的答案很直接——把包工头撤了。没有中心调度器,1024 个 worker 全部平权,靠一套共享基础设施(Git 仓库 + 聊天频道 + 共享记忆板)自己找活干、自己解决冲突、自己合并代码。结果在 ProgramBench 最难的 5 个任务上,128 个智能体比单智能体平均提升约 49 个百分点的相对幅度;在 pandoc 重建任务上,从 1 个智能体的 33.89% 一路扩到 1024 个智能体的 55.06 个点。
核心摘要
Agensh 是一个无中心 orchestrator 的多智能体组织框架:所有 worker 跑同一个五步协作循环(收集上下文 → 认领子任务 → 干活 → 验证 → 合并),通过共享工作区(Gitea)、消息接口(Mattermost)和共享上下文板三件基础设施异步协调。在 ProgramBench 的 5 个最难任务上(FFmpeg、gromacs、pandoc、PHP-src、ctags,每个都是几十万到几百万行代码的软件重建),智能体数量从 1 扩到 128,平均 test-pass 率从 19.31% 涨到 28.78%;pandoc 上单任务扩到 1024 个智能体达到 55.06%。更有意思的是轨迹分析:随着组织规模增长,点对点协调、多人集成、标准化工作流、角色分工这些协作形式自己涌现出来了,没有人教它们。我的判断:这不是一篇"新算法"论文,而是一篇"组织结构即能力"的实证论文——它证明智能体数量本身就是一个可以 scale 的维度,这个结论对工程实践的影响可能比方法本身更深远。
论文信息
- 标题:Agensh: Scaling Organizational Intelligence to 1,024 Agents
- 作者:Zhihao Zhan、Ting Song(共同一作)、Li Dong、Shaohan Huang、Jianxun Lian、Yan Xia、Furu Wei(通讯)
- 机构:Microsoft Research
- 链接:https://arxiv.org/abs/2609.26781
- 代码:https://github.com/microsoft/Agensh
- 提交日期:2026 年 9 月 22 日(13 页,6 张图)
🎯 为什么需要这篇论文:包工头模式撞墙了
先说清楚现有范式卡在哪。
现在主流的多智能体框架——Codex sub-agent、Claude Code 的 sub-agent 和 agent teams、Copilot fleet、Kimi Agent Swarm——结构上都是一颗星:中间一个主 Agent,周围一圈 worker。主 Agent 负责规划、拆解、分配、汇总。这个结构在十几个 worker 的规模下很好用,但它有两个先天缺陷。
第一, orchestrator 本身就是瓶颈。所有信息路由都要过它,worker 数量上去之后,它的上下文窗口先爆。第二,orchestrator 要会拆任务才行,Kimi Agent Swarm 那篇甚至专门训练了一个 orchestrator 来做任务分解——这等于把整个系统的上限押在一个角色的规划能力上。
说实话我第一反应是:去中心化多智能体又不是新话题,AgentNet、DeLM 这些工作早就做过。但仔细看下来,Agensh 的差异不在"去中心化"这个口号,而在于它把去中心化落到了一套极其工程化的基础设施上,并且真的跑到了 1024 个智能体的规模。之前的工作大多停留在几十个 agent 的玩具实验,没人验证过四位数的组织规模能不能 work。
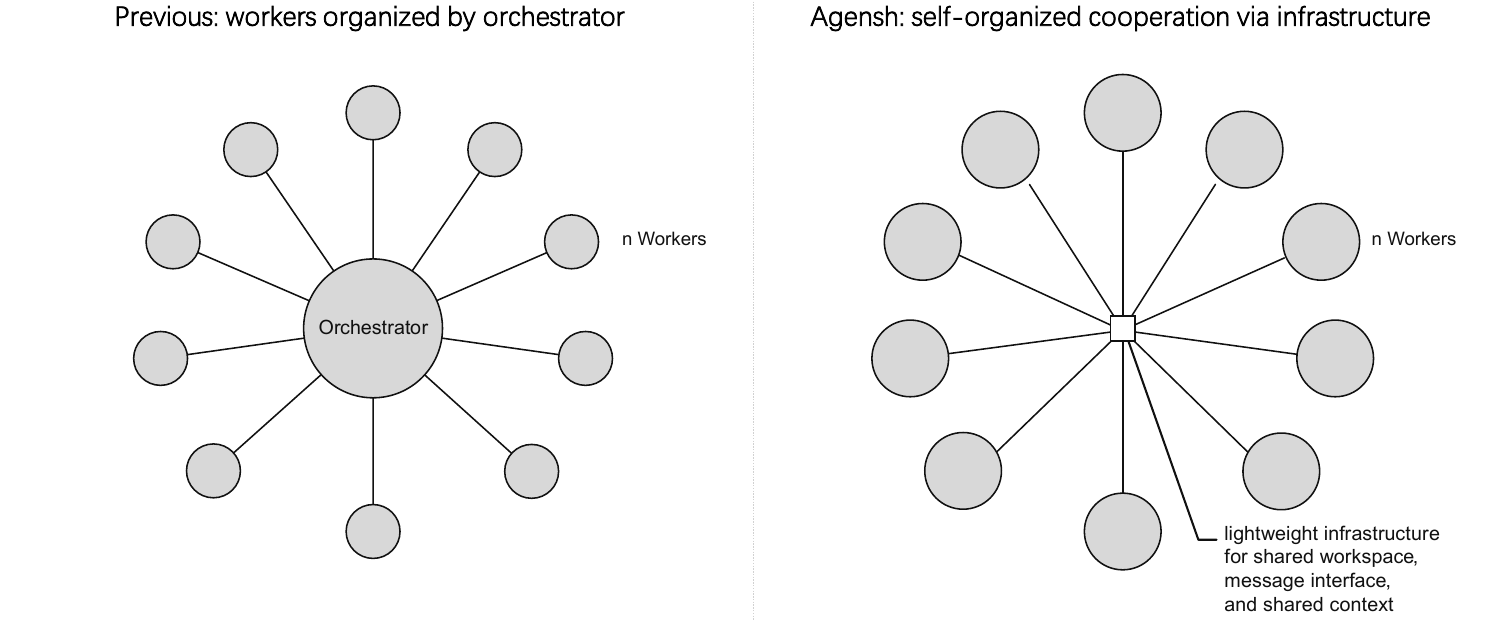
图2:左边是传统的 orchestrator-worker 结构,所有协调都经过中心节点;右边是 Agensh,worker 之间没有层级,全部通过轻量基础设施(共享工作区、消息接口、共享上下文)交换状态。注意右边中心那个小方块不是"调度者",它只是被动的共享设施。
🏗️ 方法:一个循环 + 三件基础设施
Agensh 的设计可以拆成两层:每个 worker 跑的协作循环,以及支撑循环的组织基础设施。
五步协作循环
每个 worker 并发、异步地重复同一个循环,不用等任何人:
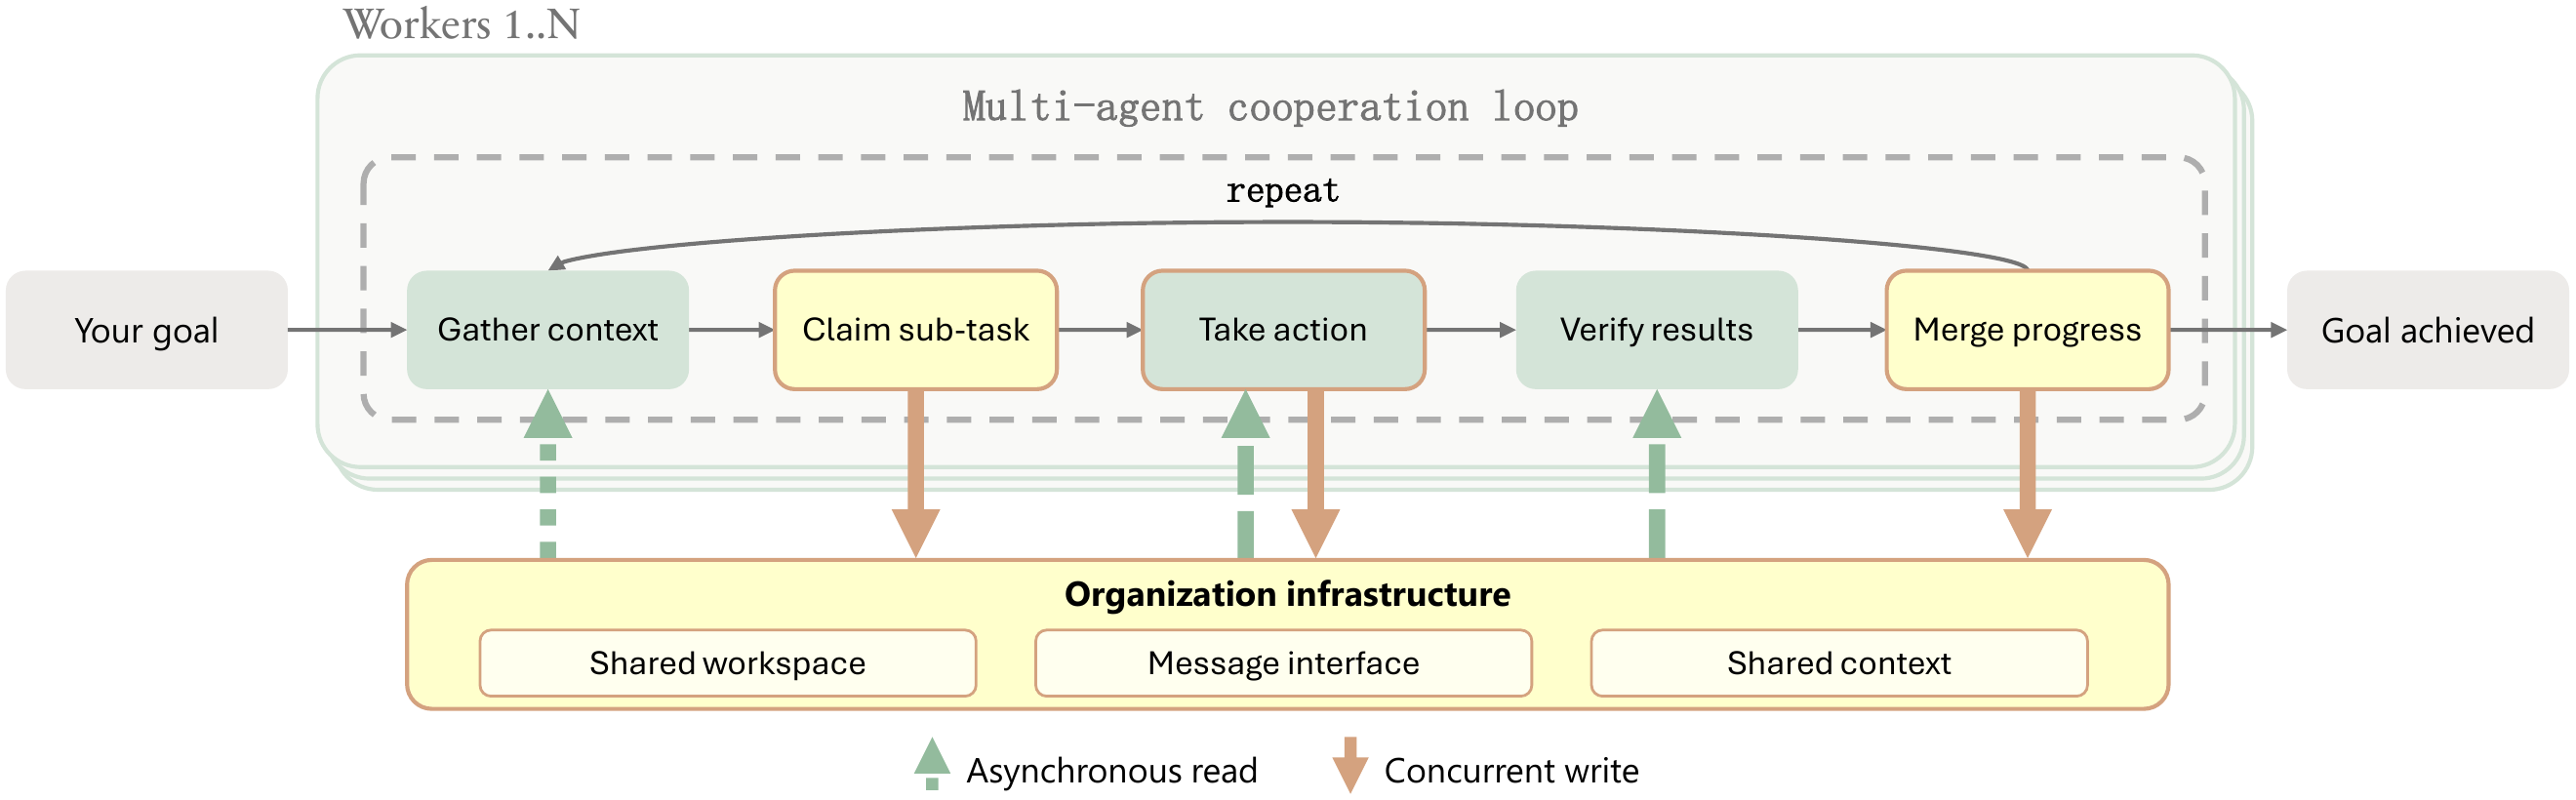
图3:Agensh 的核心循环。Worker 从用户目标出发,依次执行收集上下文、认领子任务、采取行动、验证结果、合并进度五步,然后回到起点。绿色虚线箭头是异步读,橙色实线箭头是并发写——所有读写都打到底下的组织基础设施上。
拆开看每一步:
- 收集上下文(Gather context):读用户目标、当前状态、同伴的进度和消息、积累的发现,搞清楚"已经做完了什么、还剩什么"。
- 认领子任务(Claim sub-task):自己提议一个子任务,把范围以 CLAIM 的形式追加到共享上下文。如果两个人的 claim 撞车,鼓励他们发私信自己解决。
- 采取行动(Take action):本地干活,用工具和环境交互。中途有了对别人有用的发现,立刻写到共享上下文。
- 验证结果(Verify results):拿验收标准检查自己的工作,不达标就改到达标。
- 合并进度(Merge progress):把成果合进共享工作区,发一条更新说明改了什么、思路是什么、验证证据是什么。合并冲突了就把同伴的最新进展合进来、解决冲突、再合一次。
这个循环最妙的地方在于:它不是硬编码在运行时里的,而是写在每个 worker 的 prompt 里。所有 worker 拿到一模一样的 prompt,只差一个 worker ID。这意味着 Agensh 可以套在 Claude Code、Copilot 这些不同的单智能体 harness 上,只换一层薄薄的适配器。这个设计真的很务实——协作协议交给模型的语言能力去执行,基础设施只管事件路由和状态共享。
三件基础设施
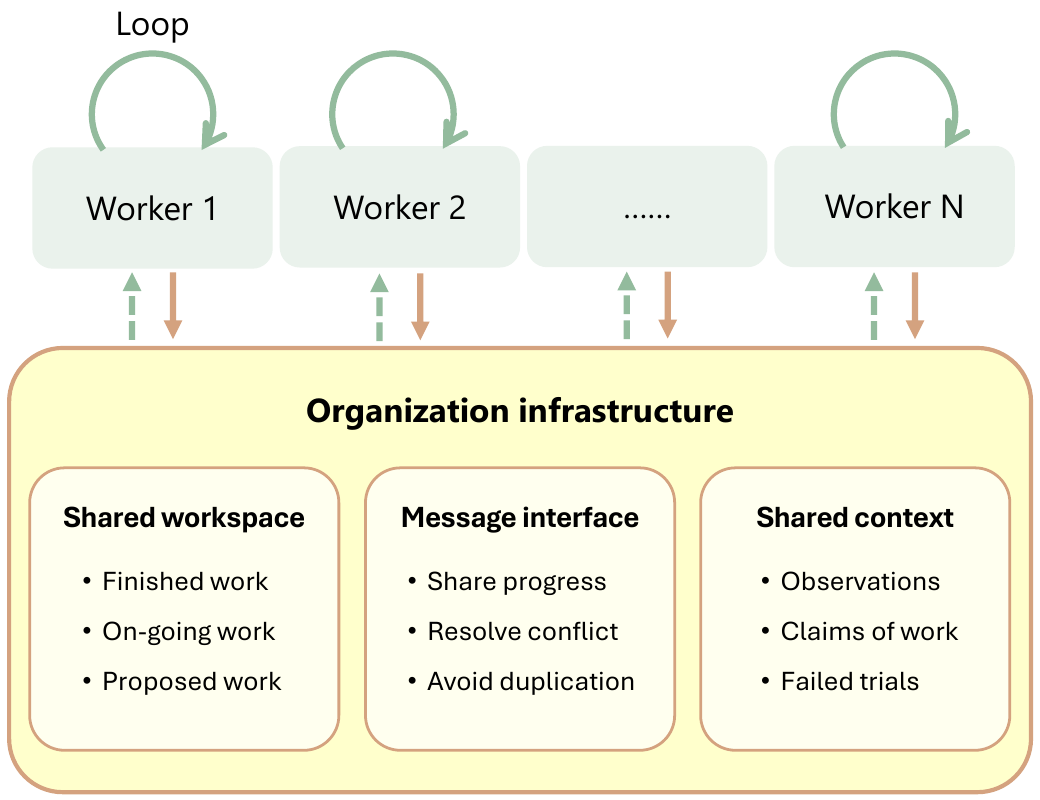
图4:三件基础设施撑起整个自组织结构。共享工作区存放已完成、进行中、已提议的工作;消息接口负责分享进度、解决冲突、避免重复;共享上下文保存观察、工作认领和失败尝试。每个 worker 独立跑自己的循环,读写都落在共享设施上。
| 组件 | 实现 | 干什么用 |
|---|---|---|
| 共享工作区 | Gitea(Git 平台) | 存放组织的全部代码工作;支持并发写、异步读、版本历史、合并冲突检测;issue 和 PR 天然承载任务和贡献 |
| 消息接口 | Mattermost | 共享频道发团队公告(低优先级,每轮循环开始时投递);私信处理紧急冲突(高优先级,能插队到对方当前回合里) |
| 共享上下文 | 借鉴 DeLM 的 append-only 日志 | 五种条目类型:OBSERVED(观察到的行为)、FACT(确认的事实)、FAIL(失败尝试,最有价值——直接阻止别人浪费预算)、CLAIM(正在做的活)、PATCH_SUMMARY(完成的改动) |
共享上下文这个设计值得多说两句。条目有字数上限(普通 100 字符,PATCH_SUMMARY 300 字符),长内容放 detail 里由别人按需展开。板子只保留最近 2000 条在"近记忆"里,但配了一个 board_grep 工具,支持 a&b,c&d 这种 AND/OR 组合搜索全部历史。你想想看,1024 个 agent 同时往一个板子上写东西,没有字数限制和检索工具的话,这个板子几分钟就没法读了。这些约束不是锦上添花,是规模化的必要条件。
实验任务的硬核程度
在讲结果之前,得先说说 ProgramBench 这个基准有多狠。它出自 Meta、斯坦福、哈佛团队,任务是"净室重建":给你一个只能执行不能读的二进制文件,6 小时,断网,从零写出一个行为完全一致的代码库。没有源码、没有方法签名、没有架构提示,连用什么语言都自己定。这个基准目前没有模型能完整通过任何一道题——榜首 Claude Opus 5 的 "almost resolved"(通过 ≥95% 测试)也只有 37%。
Agensh 挑的是 200 个任务里最难的 5 个:
| 任务 | 文件数 | 代码行数 | 代码体积 |
|---|---|---|---|
| FFmpeg | 10,090 | 154.9 万行 | 75.51 MB |
| gromacs | 8,982 | 81.6 万行 | 47.30 MB |
| pandoc | 2,767 | 10.4 万行 | 4.86 MB |
| PHP-src | 26,266 | 281.3 万行 | 119.76 MB |
| ctags | 7,313 | 24.6 万行 | 9.15 MB |
全部实验用同一个模型 GPT-5.6-sol(high reasoning effort),底层 harness 是 Copilot,最大输入 272k token、输出 128k token。变量只有一个:智能体数量。
📊 实验:数量就是力量
主结果:1 → 128,平均分涨约 49%
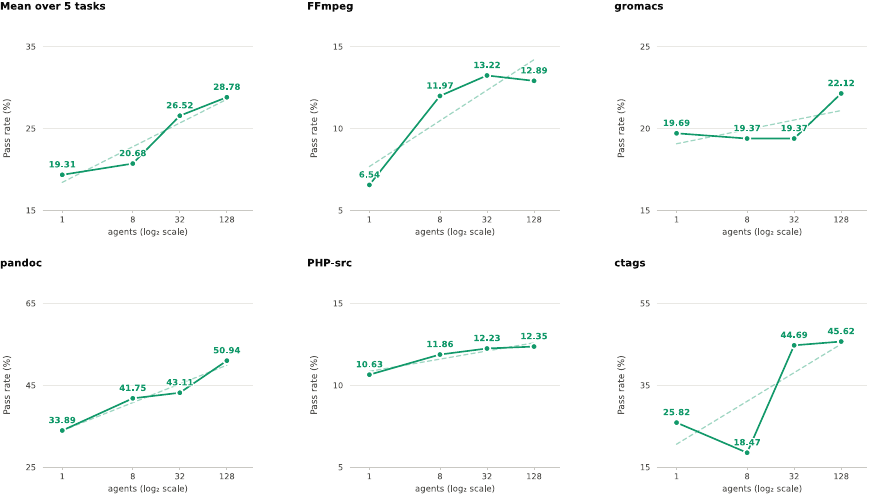
图5:左上为 5 任务平均分,从 1 个智能体的 19.31% 涨到 128 个的 28.78%。其余五个子图是各任务单独曲线。注意 FFmpeg 在 128 时略有回落(13.22 → 12.89),ctags 在 8 个时反而比单智能体差(25.82 → 18.47)——scaling 不是单调的,后面细说。
平均分的完整曲线:19.31%(1 个)→ 20.68%(8 个)→ 26.52%(32 个)→ 28.78%(128 个)。1 到 128 净涨 9.47 个百分点,相对提升约 49%。
但我得说句公道话,分任务看就没那么漂亮了。PHP-src 从 10.63% 爬到 12.35%,几乎平;gromacs 在 32 个之前完全不动;ctags 在 8 个智能体时还跌了一跤。真正的 scaling 红利主要来自 pandoc(33.89 → 50.94)和 ctags 后段的爆发(18.47 → 44.69)。这说明"加人有用"是任务依赖的——对那些能自然分解成大量并行子任务的工作(比如文档转换器这种格式对格式的东西),加人效果显著;对 PHP 解释器这种核心状态高度耦合的系统,加 100 个人也只能在外围打转。
这个观察论文没有展开讲,但我觉得是全文最有工程价值的发现之一。
延迟维度:人多不仅分高,还更快
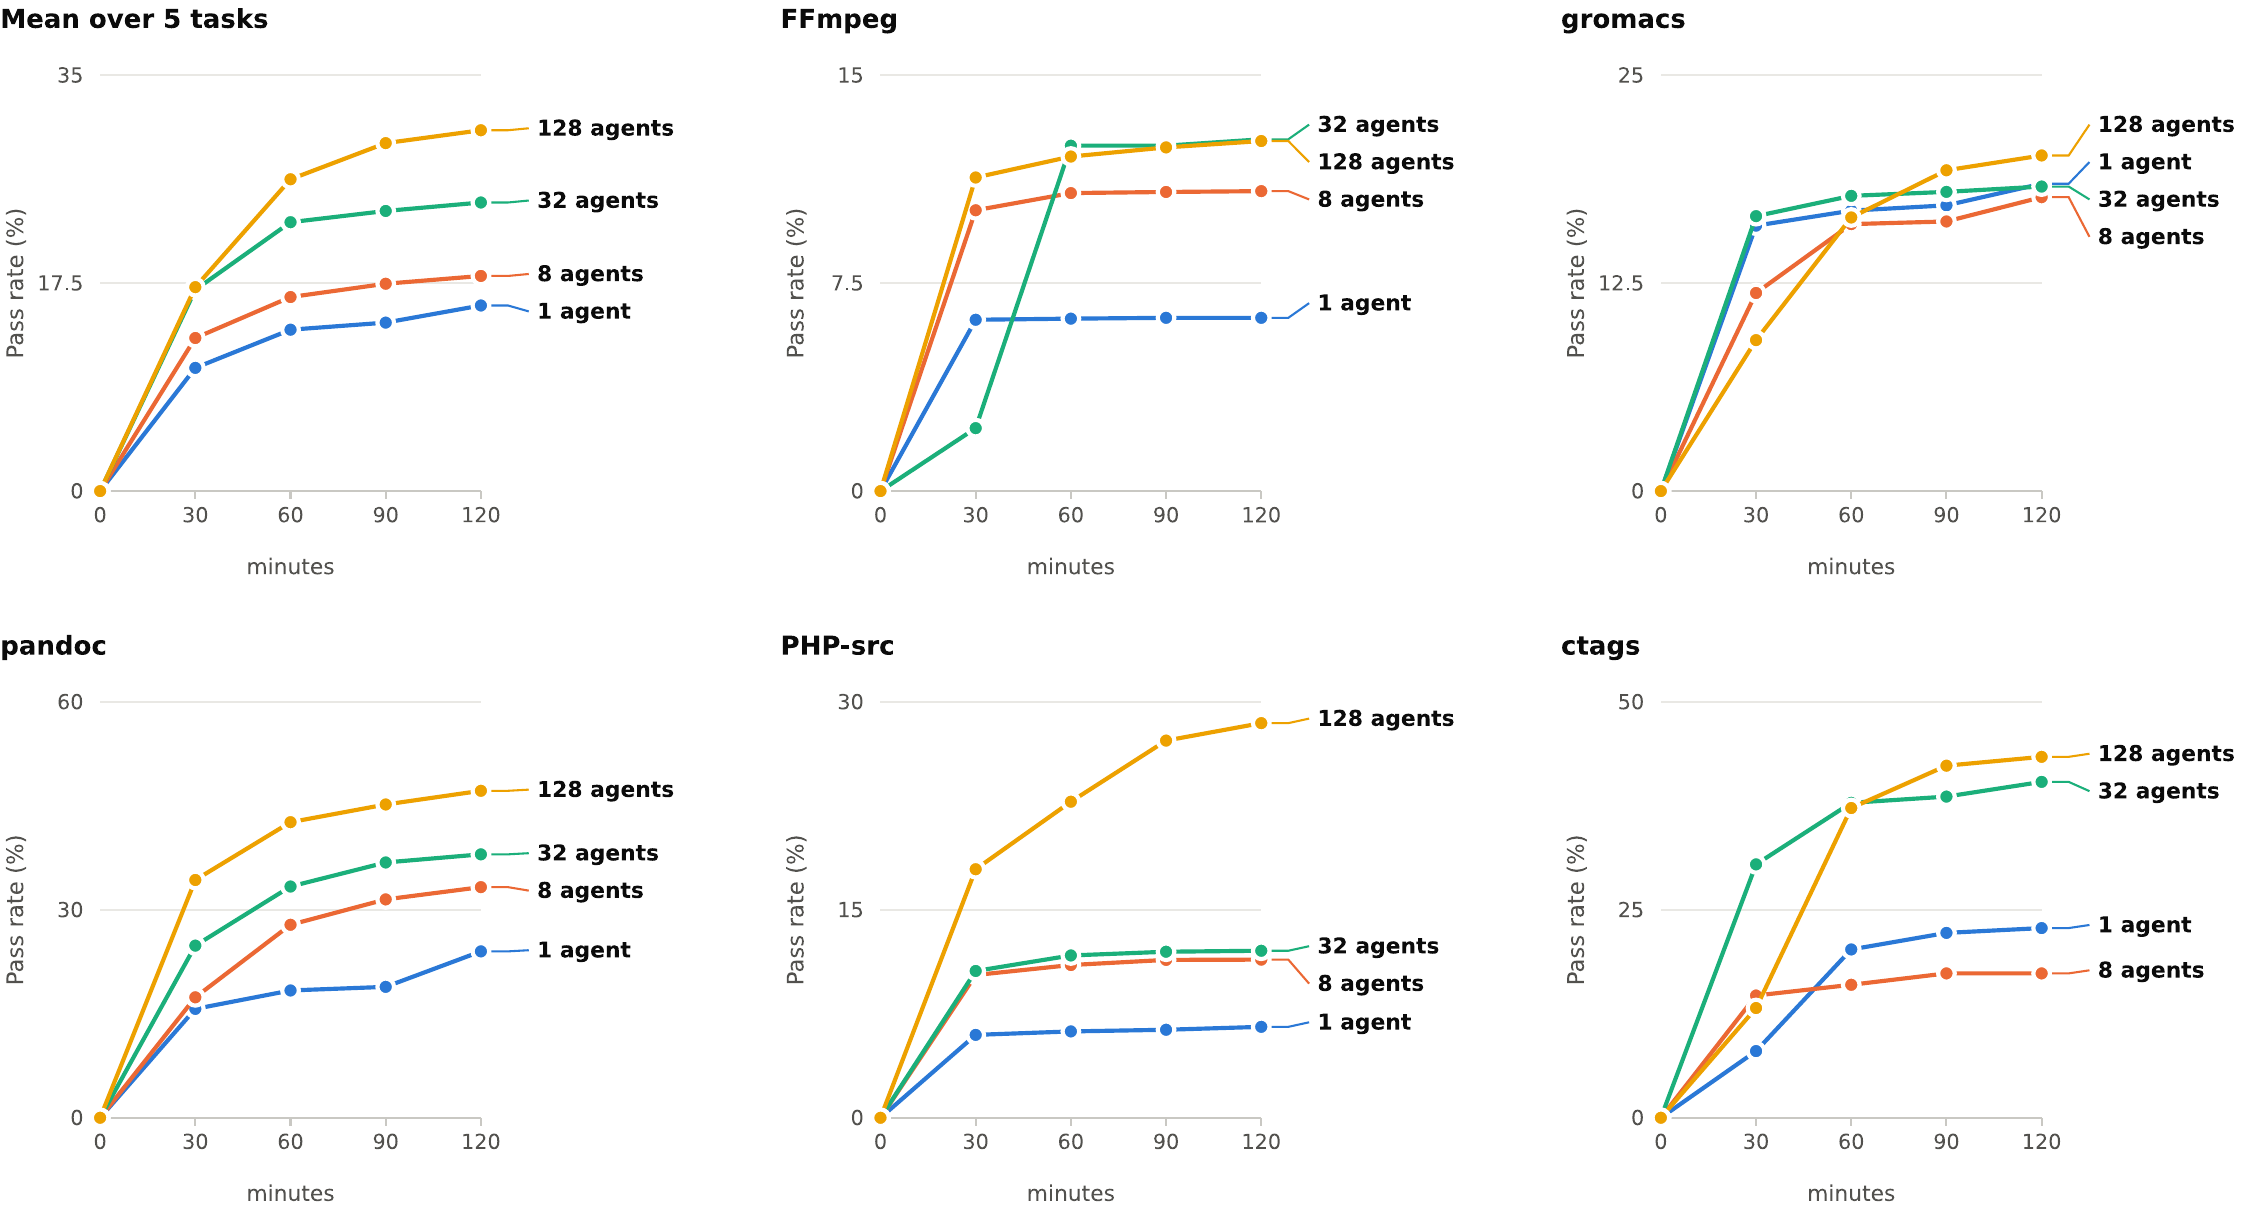
图6:前 120 分钟的通过率曲线。pandoc 上 128 个智能体 30 分钟就过了 30%,32 个要到 60 分钟,8 个要到 90 分钟,单智能体前两小时始终没过 30%。gromacs 子图里甚至出现 1 个智能体中期领先的片段,再次印证任务依赖性。
这个结果对实际部署的意义可能超过最终分数本身。很多时候你要的不是"6 小时后最高多少分",而是"1 小时内能到什么水平"。128 个 agent 在 pandoc 上 30 分钟干到 30% 通过率,单 agent 两小时都没摸到—— latency 敏感场景下,堆 agent 数量等于买时间。
推到极限:1024 个智能体
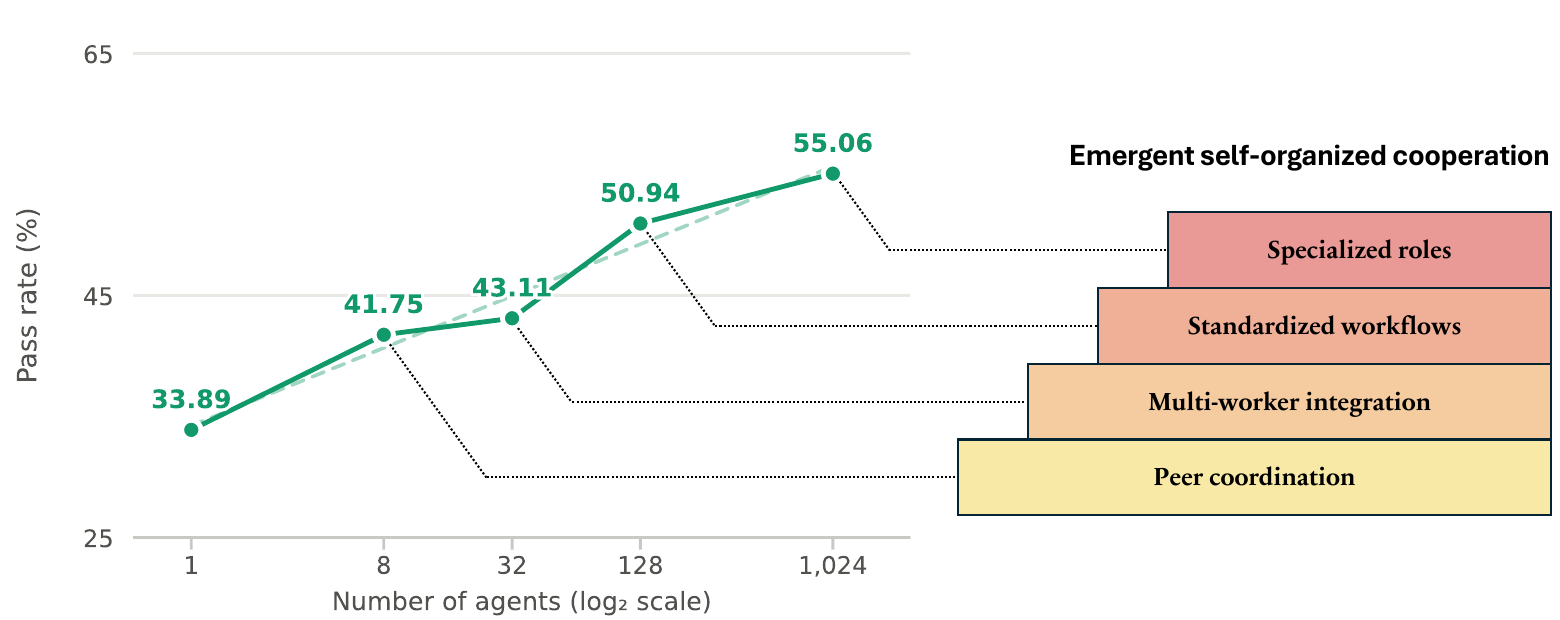
图1:pandoc 单任务,1 → 8 → 32 → 128 → 1024 个智能体,通过率 33.89% → 41.75% → 43.11% → 50.94% → 55.06%。右侧阶梯标注了各规模涌现的协作形态:点对点协调 → 多 worker 集成 → 标准化工作流 → 角色分工。
1024 个智能体分布在 16 台机器上,每台 64 个。从 128 到 1024 又涨了 4.12 个百分点,比单智能体高 21.17 个点。
等等,你可能注意到了——8 到 32 这一段几乎平了(41.75 → 43.11),曲线并不是漂亮的对数线性。说实话,看到 1024 这个数的时候我第一反应是算成本:1024 个 GPT-5.6-sol(high)实例跑 6 小时,这个 token 开销是天文数字。论文没有报成本数据,这是个不小的 omission。"能 scale"和"值得 scale"是两回事,边际收益从曲线上看已经在明显递减。
🔬 最迷人的部分:协作形态自己长出来了
论文 Section 3.2 是我觉得最值钱的部分。所有 worker 拿完全相同的 prompt,没有任何人被指派角色,但随着规模增长,轨迹里出现了分层涌现的协作形态:
- 8 个智能体:点对点协调。gromacs 里 worker 们自己商定了一个模块接口,然后各自独立实现符合接口的命令模块;FFmpeg 里两个 worker 发现 claim 撞车,私信聊完,一方主动改了自己的范围去干互补的活。
- 32 个智能体:多人集成管理。PHP-src 里出现了真实的代码评审流程——几个 peer 先批了一个贡献,另一个 worker 找到具体反例,批准被撤回,作者修好后重新评审、由 peer 合并。
- 128 个智能体:分工与流程标准化。worker 开始按"过往相关经验"挑 reviewer,并长期复用这些评审关系;pandoc 里两个 worker 发明了标准化集成协议(作者更新分支、自测、发 commit hash 给 peer 验证合并),这个协议后来被其他 worker 复用,失败后还迭代出了 2.0 版(授权 peer 完成整个更新-测试-检查-合并循环)。
- 1024 个智能体:组织级角色专业化。多个 worker 同时担任 integrator 角色,提交者会联系多个候选 integrator、选最先响应的、取消其他请求再交接代码。同一技术领域的专家还能在别人的尝试失败后接管工作——组织有了容错性,不再依赖任何单个 worker。
这些行为全部是自组织的,没有人写进 prompt。prompt 里只有中性的规则:"撞车了发私信解决"、"FAIL 条目最有价值"。从简单规则到组织行为,这个涌现链条让人想起蚁群——单个蚂蚁只会跟随信息素,群体却能找到最短路径。
当然,冷静一点看,这些案例是定性观察(selected anecdotes),论文没给量化统计——比如 1024 个 worker 里有多少比例真的承担了 integrator 角色、标准化协议被复用了多少次。这类轨迹分析天然有 cherry-picking 的空间,我希望后续工作能给出协作行为的频率统计。
💡 我的判断
这篇论文的真实定位:它不是方法创新,是规模实证。协作循环的每一步(共享上下文、消息协调、Git 集成)单拎出来都有前作——DeLM 的共享上下文、Carlini 用 16 个 Claude 加 Git 仓库写编译器的实验、STORM 的共享工作区状态管理。Agensh 的贡献是把这套东西组装起来,推到了别人没到过的规模,并用数据回答了一个开放问题:智能体数量是不是一个独立的 scaling 维度?答案看起来是肯定的,但有任务依赖性。
亮点很清楚:无中心架构消除了单点瓶颈、prompt 即协议的即插即用设计、以及 1024 规模的协作涌现证据。问题也明显:没有成本分析(1024 个 agent 的 token 账单是多少?收益递减点在哪里?)、涌现行为的量化缺失、以及只测了单一模型 GPT-5.6-sol——换个弱模型,自组织还能涌现吗?这个我真不确定,组织行为对模型能力的门槛可能不低。
对工程实践的启发倒是很直接:如果你在做多智能体系统且 worker 数量卡在几十的规模,先别急着训练更强的 orchestrator——试试把协调逻辑下沉到基础设施(Git + 消息 + 共享记忆板),让 worker 平权自组织。Agensh 代码已开源,基础设施全是现成组件(Gitea、Mattermost),复现门槛出乎意料地低。
一个更本质的问题还悬着:当组织规模再涨一个数量级到 10000,通信开销和合并冲突会不会反过来吃掉并行红利?人类组织需要管理层级不是没有原因的。智能体组织的"邓巴数"是多少,这篇论文没有回答,但它把这个问题变成了可以实验的问题——这本身就够了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我