RRSI:智能体 Harness 的递归自我进化,也得先学会"踩刹车"
论文:RRSI: Regularized Recursive Self-Improvement of Agent Harnesses arXiv:https://arxiv.org/abs/2609.24972 (Submitted on 21 Sep 2026) 作者:Peng Xia, Rujun Han, Zifeng Wang, Yanfei Chen, Yufan Zhang, Yoonho Lee, Chengsong Huang, Han Yu, Zhongying CuiZhu, Yifei Ming, Huaxiu Yao, Burak Gokturk, Tomas Pfister, Chen-Yu Lee 机构:Google Cloud AI Research、Stanford、Washington University in St. Louis、UNC-Chapel Hill 代码:https://github.com/google-research/rrsi | 项目页:https://regularized-rsi.com/
核心摘要:让 LLM 自动改写自己的 Agent harness(提示词、控制流、工具、记忆、上下文管理)已经成了提升智能体能力的热门路线,这其实就是智能体系统层面的递归自我改进(RSI)。但这篇论文泼了一盆冷水:这种自我进化会严重过拟合——在演化用的基准上刷分刷得很欢,换一套没见过的任务,增益缩水甚至直接归零。RRSI 的思路很直接:把机器学习里正则化的那套直觉搬到 harness 演化上,proposal 侧加退火编辑预算、证据信用分配和结构化探索,selection 侧加泄漏审查、噪声地板、复杂度约束和结构化剪枝。结果很有意思:RRSI 在演化集上的增益是所有方法里最小的,但在五个 OOD 基准上是唯一真正涨分的,还比未正则化的演化省 30% 策略 token。我的判断:这不是一个新优化器,而是给整个 harness 自我进化赛道补上的一块缺失拼图——评估纪律。
🎯 从一个让人警惕的现象说起
假设你搭了一个编码 Agent,最近流行一种玩法:让 LLM 自己看失败轨迹、自己改 prompt、自己调工具链,跑几轮下来基准分数蹭蹭往上涨。听起来很美。
但上周我读到这篇论文的时候,第一反应是:终于有人把这件事的阴暗面量化了。作者做的事很简单——让几个已有的 harness 自我进化方法(Meta-Harness、AHE、TTHE、HarnessX)在自己演化的基准上跑,然后拿到没见过的基准上测。结果:
- 演化集上大家都涨分,最多的涨 4-6 个点;
- 一到 OOD 基准,排名直接反转。演化集最强的 Meta-Harness,OOD 平均只比不演化的 baseline 高 0.9 分;AHE 和 TTHE 甚至比不演化还差,TTHE 低了 1.7 分。
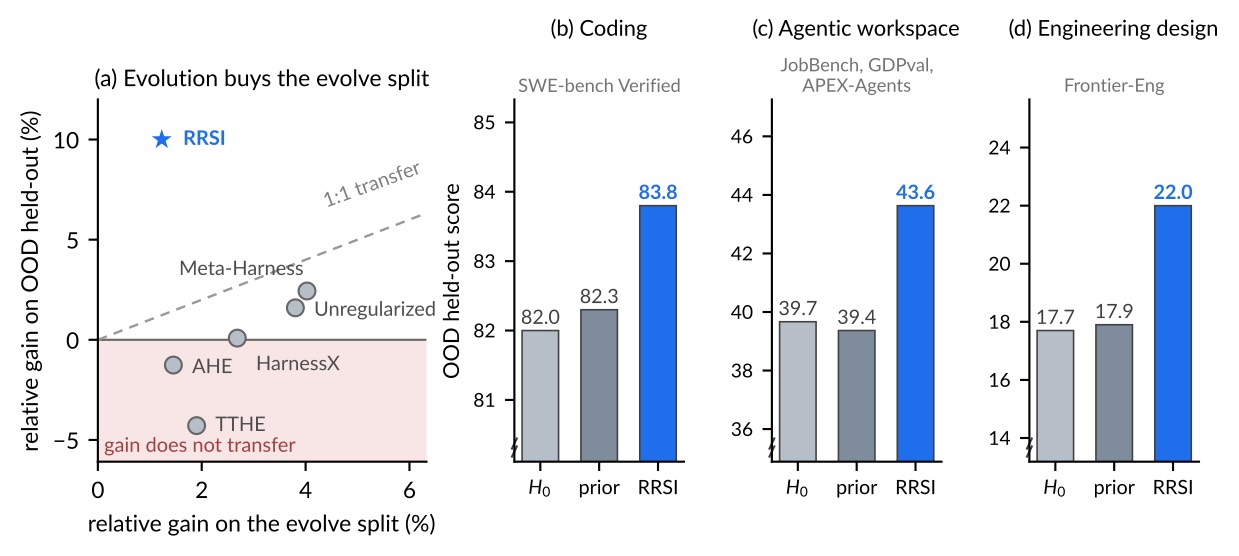
图1:(a) 演化集增益 vs OOD 增益的散点图——虚线是 1:1 理想迁移线,先前方法全部掉在粉色"增益不迁移"区域或紧贴零线,只有 RRSI(蓝色星)站在上方;(b–d) 三个领域的 OOD 留出分数柱状图,RRSI(深蓝)在 SWE-bench Verified、工作区三基准均值、Frontier-Eng 上都明显高于 \(H_0\) 和先前方法均值。
这就是论文说的 evolve-to-transfer gap。问题出在哪?作者归纳了三种耦合在一起的过拟合行为:
- 基准特定拟合:演化过程把基准特有的模式直接编码进了 harness,比如针对某类任务的专用提示话术;
- 追逐噪声:评估本身有随机性,被噪声"偏好"的候选被留了下来;
- 复杂度累积:harness 越改越臃肿,演化集分数涨了,但底层机制并没有变好——token 倒是越烧越多。
说实话,这三种行为单独看都不新鲜,做过 AutoML 或者超参搜索的人都会会心一笑——这不就是 adaptive overfitting 吗?论文也引用了 Dwork 等人 2015 年那篇经典的自适应数据分析理论:同一个数据集被反复自适应地查询,统计有效性会迅速衰减。harness 演化每一轮的候选,都依赖之前轮次在同一批任务上的测量结果,演化集被"自适应复用",过拟合是数学上的必然,不是工程上的意外。
把这件事点破,我觉得是这篇论文最值钱的贡献之一。
🏗️ 方法:不限制能改什么,只限制怎么改
RRSI 的设计哲学我很喜欢,一句话概括:保持编辑空间完全开放,正则化的是穿越这个空间的搜索轨迹。
什么意思?prompts、控制流、配置、上下文管理、工具、技能文件、记忆、子智能体——全都可以改、可以删、可以增。作者没有说"只准改 prompt"或者"工具链冻结",而是把约束放在两个地方:
- proposal 侧:控制搜索容量怎么花(每次候选能打包多少编辑、往哪些方向探索);
- selection 侧:控制哪些测量到的"改进"有资格成为永久状态。

图2:RRSI 总览。中间是正则化的状态转移规则:Proposal 从当前 harness 和反馈历史中采样候选,Selection 从可接受候选中选最优(没有就保持不变)。左侧蓝色是 proposal 侧三件套:退火更新稀疏性(编辑预算随轮次衰减)、证据感知信用分配(利用全部历史得失而非最近一次输赢)、结构化探索(停滞时把预算引向未探索组件)。右侧绿色是 selection 侧四道闸:泄漏筛查、噪声调整性能地板、复杂度感知接受、结构化剪枝。
作者还给每个机制找了个经典正则化的对应物,先声明一下:这些是"类比角色",不是真的在优化带范数惩罚的目标函数。但这个类比框架确实帮助理解:
| RRSI 机制 | 对应经典正则化 | 一句话通俗解释 |
|---|---|---|
| 退火编辑预算 | \(L_0\) 基数约束 | 一次更新别打包太多改动,改多了没法归因 |
| 结构化剪枝 | Lasso / \(L_1\) | 持续没产出的组件整个删掉 |
| 复杂度感知接受 | Ridge / \(L_2\) | 总体资源消耗不许无约束膨胀 |
| 结构化探索 | 多样性/熵正则 | 别老在一个角落打转 |
Proposal 侧:三件套
(a)退火编辑预算。无约束的 proposer 有个坏毛病:把一堆互不相关的修改打包进一个候选。一次改十处,分数涨了,鬼知道是哪一处起作用。RRSI 直接限制单个候选里"独立可归因编辑"的数量上限,而且用余弦调度随时间退火:
早期轮次预算大,允许组合多个协同修改去发现新机制;越到后期越稀疏、越可归因。你想想看,这跟学习率衰减的直觉一模一样:前期大胆探索,后期精调收敛。
(b)证据感知信用分配。每个被评估的候选都留下档案:改了哪些组件、测试什么假设、源码 diff、分数和成本变化、是否被接受。被否决的机制保留为"负证据",成功的保留显式信用,proposer 后续轮次以此为条件。这解决了一个很实际的问题:没有历史记录的 proposer 会反复重试已经被证伪的假设,白白浪费搜索容量。
(c)结构化探索。当过去 \(w\) 轮的进展落在经验噪声带 \(\delta\) 之内,判定搜索停滞。停滞期间把一小部分 proposal 预算保留给本轮还没被碰过的组件。论文里提到一个典型失败模式是 proposer 坍缩到"只改 prompt"的狭窄编辑族——这个停滞检测就是防这个的。
Selection 侧:四道非补偿性闸门
注意"非补偿性"这个词:候选必须同时满足所有标准才能替换现任 harness,不是加权打分能糊弄过去的。
(a)泄漏筛查(critic)。完整评估之前,critic 先读每个候选的 diff,凡是显式编码了任务名、实体名、任务特定值、答案或演化基准特有逻辑的编辑,直接枪毙。关键点在于评估前筛查:泄漏的候选永远不会拿到那个虚高的演化集分数,也就不会吸引后续轮次朝这个方向继续挖。这像是防 data leakage 的 code review,只不过审查对象是 Agent 自己的源代码。
(b)噪声调整性能地板。演化前反复评估未修改的基础 harness,估计出噪声带 \(\delta\)。设 \(S^{\star}\) 为迄今最佳演化集分数,候选必须满足:
防止搜索通过一连串"小到可以被误认为噪声"的退步而慢慢走下坡路。
(c)复杂度感知接受。对候选定义分数增益 \(\Delta S=\hat{S}(H')-\hat{S}(H_t)\) 和相对成本变化 \(\Delta C\),增益超过噪声带的候选必须满足:
翻译成人话:多烧的 token 必须用可测量的性能改进来买单。\(\beta_0\) 是可忽略增益容忍的成本增长,\(\beta_1\) 是随改进幅度放宽的额度。成本用策略 token 数做代理指标,简单但够用。
(d)结构化剪枝(pruner)。退火预算稀疏化的是每次"更新",剪枝稀疏化的是"保留下来的 harness 本体"。RRSI 追踪每个组件在固定剪枝窗口内是否产生严格为正的测量增益,持续无产出的组件会被列为删除目标报给 proposer。机制必须持续"挣得"自己的位置——这个设计很狠,但我觉得是防止 harness 膨胀的关键。
整个流程的形式化也很干净。智能体 \(A = (\pi, H)\),\(\pi\) 是冻结骨干,\(H\) 是 harness。第 \(t\) 轮的演化:
其中 \(\mathcal{L}_t\) 是编辑历史、\(b_t\) 是退火预算、\(\mathcal{E}_t\) 是探索指令、\(\mathcal{B}_t\) 是剪枝目标、\(\mathcal{A}_t\) 是过了所有闸门的可接受候选集。没有可接受候选就保持 \(H_t\) 不变——原地不动也是一个合法选项,这一点很多演化方法反而做不到。
🧪 实验:三个领域、八个基准,配置相当扎实
实验覆盖面在我读过的同类工作里算很全的:
| 领域 | 演化基准 | OOD 迁移基准 |
|---|---|---|
| 编码 | Terminal-Bench 2.1(89 个容器化终端任务) | SWE-bench Verified |
| 智能体工作区 | Harvey LAB(法律工作,120 演化 + 40 纯净 ID 留出) | JobBench、GDPval、APEX-Agents |
| 工程设计 | EngDesign(61 个设计任务,模拟器确定性评分) | Frontier-Eng(Medal Score 评分) |
几个细节值得点赞:冻结策略统一用 Claude Opus 4.8,所有基线从同一个 \(H_0\) 出发、共享演化集和候选预算,对比是公平的。Harvey LAB 还专门留了一个纯净 ID 留出集,区分"同分布但没见过"和"分布外"两种泛化。工程领域的评分由冻结模拟器/测试台完成,确定性评分,排除了 LLM 评审偏好的干扰——这一点很重要,后面还会提到。
主结果:演化集增益最小,OOD 唯一真涨
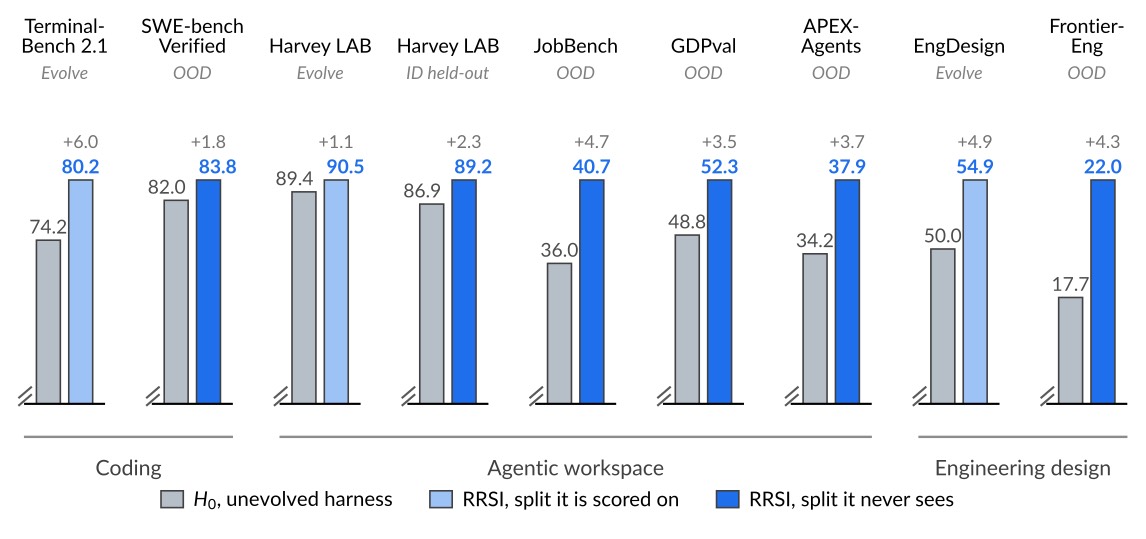
图3:三个领域九个 split 的完整结果。灰色是不演化的 \(H_0\),浅蓝是 RRSI 在它被打分的 split 上,深蓝是 RRSI 在它从未见过的 split 上。注意所有深蓝色柱子都高于灰色柱子——没有一个留出 split 出现回退。
智能体工作区领域的对比表最说明问题:
| 方法 | Harvey LAB 演化集 | ID 留出 | JobBench | GDPval | APEX-Agents |
|---|---|---|---|---|---|
| \(H_0\)(不演化) | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
说实话看到这个表我愣了一下。RRSI 在演化集上是 90.5,基线里倒数第二——Meta-Harness 刷到 93.0。但拉到 OOD 看,RRSI 三个基准全部第一,OOD 平均 43.6 对 \(H_0\) 的 39.7,是唯一比不演化多涨一个点以上的方法。
这恰恰是正则化想要的权衡:主动放弃一部分演化集上的虚高分数,换来真实可迁移的机制改进。演化集分数最低不是缺点,是设计的直接后果。
其他领域的数字:编码领域 Terminal-Bench 2.1 演化集涨 6.0 分,SWE-bench Verified(从未参与评分)涨 1.8 分;工程设计 EngDesign 涨 4.9,Frontier-Eng Medal 分涨 4.3(相对提升 24.3%)。摘要里最亮的数字:演化 split 最高涨 14.1 分(用 Gemini 3.5 Flash 做骨干时),OOD 最高涨 4.7 分,同时比未正则化演化省 30% 策略 token。
消融:拆掉任何一个正则化器,迁移都掉
| 变体 | 演化集 | ID 留出 | OOD 平均 | 每 trial token(百万)↓ |
|---|---|---|---|---|
| \(H_0\) | 89.4 | 86.9 | 39.7 | 1.56 |
| 无正则化演化 | 92.8 | 88.9 | 40.3 | 3.80 |
| 去掉 proposal 正则化器 | 90.7 | 88.8 | 41.9 | 2.69 |
| 去掉 acceptance 正则化器 | 91.5 | 88.7 | 41.0 | 3.59 |
| RRSI 完整版 | 90.5 | 89.2 | 43.6 | 2.42 |
这张表的模式极其一致:拆掉任何一组正则化器,演化集分数都涨,OOD 都掉。全拆掉最惨——演化集 92.8 全场最高,OOD 只剩 40.3,跟不演化几乎没差,token 还烧了 3.80M(RRSI 只要 2.42M)。
两个单侧消融也各有信息量。去掉 acceptance 约束后 token 成本涨了快一半——说明无约束的选择把大量预算花在了噪声和上下文膨胀上,而非机制改进。去掉 proposal 约束后演化集只掉 0.2 但 OOD 掉 1.7——就算没有候选被误接受,搜索方向的引导本身也有价值。
效率:RRSI 产出最轻的 harness
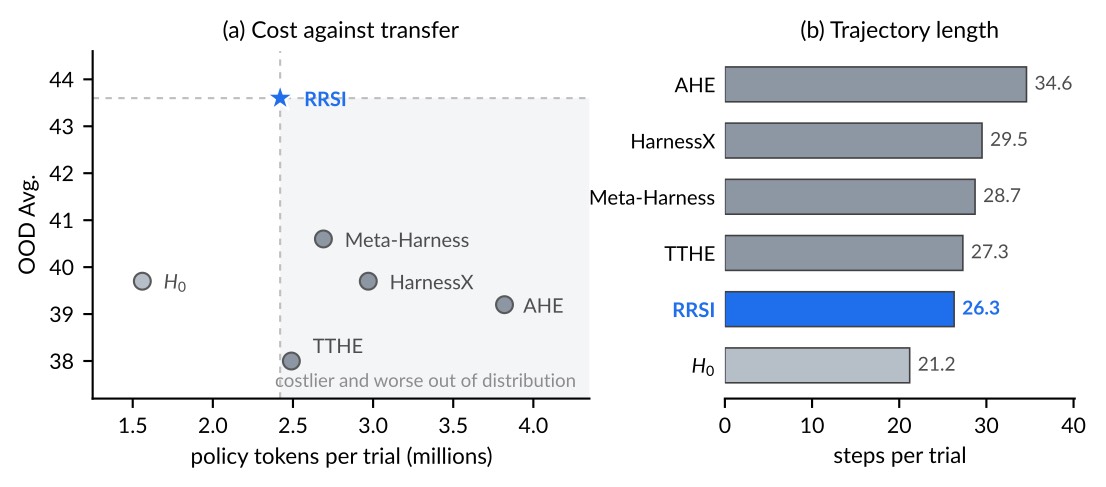
图4:(a) 成本 vs 迁移散点图,阴影区是"RRSI 支配区"(token 更多、OOD 更低),四个先前方法全部落在里面;(b) 轨迹长度对比,RRSI 每 trial 26.3 步,先前方法 27.3–34.6 步,\(H_0\) 为 21.2 步。
极端案例是 AHE:3.82M tokens/trial,比 RRSI 多烧 58%,OOD 反而低 4.4 分。花钱更多,效果更差——这就是复杂度累积不加以约束的下场。
还有两个鲁棒性实验值得一提
跨策略家族:用 Gemini 3.5 Flash 做骨干独立演化,Terminal-Bench 2.1 从 64.6 涨到 78.7(+14.1 分,全文最大单点增益),SWE-bench Verified 也涨 2.2 分。RRSI 不绑定某个特定模型家族。
跨模型迁移:把用 Gemini 3.5 Flash 演化出的 harness 原封不动套到从未参与搜索的弱模型 Gemini 3.1 Flash Lite 上,准确率从 11.2 涨到 14.6,相对增益 30.4%。绝对值小是因为弱骨干本身能触达的任务少,但方向是正的——演化出来的是可复用的机制,不是对特定模型能力的投机。
🤔 我的判断
这篇论文的定位要搞清楚:它没有提出新的演化算法,而是给所有 harness 演化算法加了一层纪律。Meta-Harness、AHE、TTHE 这些方法负责"怎么生成候选",RRSI 负责"哪些候选配得上被留下"。两者是正交的,理论上可以叠加。
亮点很明确。一是把 harness 自我进化的过拟合问题从传闻变成了可测量的现象,三种失败模式的拆解(基准特定拟合、追逐噪声、复杂度累积)给了后续研究一张清晰的靶子图。二是正则化的类比框架虽然作者自己承认只是类比,但 \(L_0\)/\(L_1\)/\(L_2\) 的角色划分让七个机制显得有章法而不是补丁堆叠。三是实验设计干净——统一冻结骨干、统一起点、纯净留出集、确定性模拟器评分交叉验证,该做的都做了。
但也有几个地方我觉得要打个问号。正则化超参数不少(\(b_{\max}\)、\(b_{\min}\)、\(\delta\)、\(\beta_0\)、\(\beta_1\)、剪枝窗口、停滞窗口),论文说在演化集上选定后固定,但这本身又是一次在演化集上的自适应决策——正则化器的元参数会不会也有过拟合风险?论文没有展开。另外所有实验的演化轮数和预算规模有限,更长程的自我改进(比如上百轮)下这些约束会不会过紧,把真正的大改进也挡在门外,是个开放问题。还有一个我自己不太确定的点:泄漏筛查依赖 critic LLM 读 diff 做判断,critic 本身的漏判率会影响整套机制的可靠性,论文用的 critic 和 proposer 是同一个模型(Claude Opus 4.8),自我监督的味道有点浓。
放到更大的图景里看,最近 harness/脚手架层面的自我进化工作密集出现,但多数都在卷"演化集上刷多高"。这篇论文相当于给整个赛道立了个规矩:以后报数字,演化集增益和 OOD 增益得分开报。只报前者,基本等于没报。
工程上的启发也很直接:如果你在做任何形式的 Agent 自动优化(自动调 prompt、自动进化工具链、自动改 workflow),至少要抄三件事——评估前做泄漏审查、给接受阈值加噪声地板、让组件持续证明自己有产出。这三个不需要完整的 RRSI 框架就能落地,成本几乎为零。
最后说句题外话。"自我改进需要正则化"这件事其实挺有哲学味道的:不受约束的自我改进不是智能,是过拟合。人脑也一样——真正有用的学习从来不是记住每一道做过的题。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我