一个拆成三个,三个合回一个:SWE 智能体的类别专家训练法
你有没有遇到过这种训练怪象——RL 跑了几百步,总分曲线稳步爬升,皆大欢喜,结果把分数按任务类型一拆,发现有的类别在涨、有的在偷偷跌,涨的那些把跌的给"平均"掉了?
上周读到的这篇 arXiv 论文(2609.23377)就是在跟这个现象死磕。作者把仓库级软件工程(SWE)任务按语义类别拆开,发现 Pooled RL 训练过程中类别收益像跷跷板一样此起彼伏——他们管这叫 category see-saw。更有意思的是他们的解法:不追求一个大而全的策略,而是先把一个模型拆成三个类别专家分开练,每个专家用一套 Refresh–Repair–Expand 的循环自我进化,最后再用多教师在线蒸馏把三个专家"合回"一个可部署的模型。标题起得很贴切:One to More, More to One。
核心摘要:这篇论文解决的是仓库级 SWE 智能体联合 RL 训练中的类别跷跷板问题——总分涨不代表每个类别都在涨。方案是一条完整链路:用 SWE Labeler 给任务打分层语义标签并路由成三个类别池,每个类别从同一个基座出发跑 Agentic-miniRL,再用 RRE 循环(刷新掌握度 → 用自己的成功轨迹做 Repair SFT → 扩展任务前沿)迭代出强专家,最后用带 ReLU 门控奖励外推的标签路由 MOPD 把专家蒸回单个学生模型。最终模型在 Pro-618 上拿到 58.04 的平均解决率(比基座高 5.39 个点),在 SWE-bench Multilingual 上 59.00(高 2.78 个点),且在两个基准的三个类别上全部跑赢 Pooled RL 和 Balanced RL。我的判断:这不是某个单点算法的突破,而是一套系统工程组合拳,其中"用自己的成功轨迹修复自己"的 RRE 循环和类别级评估方法论,比最终的分数更值得借鉴。
论文信息:One to More, More to One: Category-Aware Iterative Expert Training for Software Engineering Agents。作者:Jie Zhao、Ziyu Jiang(共同一作)、Suhang Zheng、Minghui Shan、Xiaoxiao Xu、Lin Qu,来自 Alibaba Group。2026 年 9 月 20 日挂出,arXiv 链接:https://arxiv.org/abs/2609.23377
问题:总分骗了你
先把问题说清楚。仓库级 SWE 任务——就是 SWE-bench 那一类,给个 issue,让智能体在真实仓库里翻代码、改 bug、跑测试、交补丁——看似是"一个领域",实际内部异构得厉害:修一个服务层的逻辑错误、调一个前端界面、修一个构建脚本、补一个安全漏洞,所需的证据来源、工具交互模式、验证方式完全不同。轨迹长度不一样,奖励方差不一样,数据频率也不一样。
但主流的 SWE 智能体后训练(SWE-RL、SWE-Gym、SWE-Master 这些)都是把任务混在一起做联合训练。这就埋下隐患:一次联合更新可能帮了 A 类任务却伤了 B 类任务,而你盯着的那个总分曲线,根本看不出这种内部的此消彼长。
作者把这件事量化得很漂亮。他们定义了两个指标:G_sim,即所有类别相对基座的最小增益(衡量"最弱的类别涨了多少");以及 SSG(see-saw gap),即整体增益减去最小类别增益(衡量"总分和最弱类别之间差了多少")。然后在 Pro-618(从 SWE-bench Pro 的 731 个实例中剔除有环境缺陷、评分器问题的 113 个后剩下的 618 个审计子集)上盯着 Pooled RL 的训练过程看。
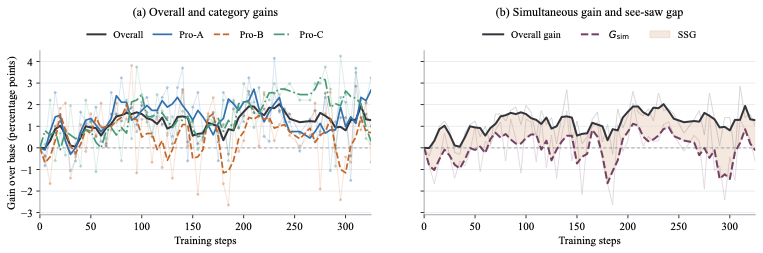
图2:左图是整体与各类别相对基座的增益曲线,可以看到类别间频繁出现反向运动;右图黑色实线是整体增益,紫色虚线是最小类别增益 G_sim——注意它多次跌到零以下,也就是说总分在涨的时候,最弱的类别其实在倒退。阴影部分就是 SSG。
说实话,看到右图 G_sim 反复跌破零轴的时候我愣了一下。这意味着"总分涨了 2 个点"这种汇报方式,可能掩盖了某个类别原地踏步甚至退步的事实。如果你部署的 agent 恰好服务的是那个退步的类别,用户感知就是越更新越蠢。
一个自然的补救是把训练数据按类别均衡采样(Balanced RL,每类 516 条共 1,548 条)。结果呢?整体分数跟用全部 6,723 条的 Pooled RL 打平(55.34 对 55.50),平均最小类别增益略好(0.19 对 0.08),但 SSG 不降反升(1.18 对 1.05),类别间的反向运动依然存在。
均衡数据治不了这个病。这就是"One to More"的动机——与其在一个流里调配比,不如干脆给每个类别单独开一条训练流。
方法总览:拆得开,练得强,合得回
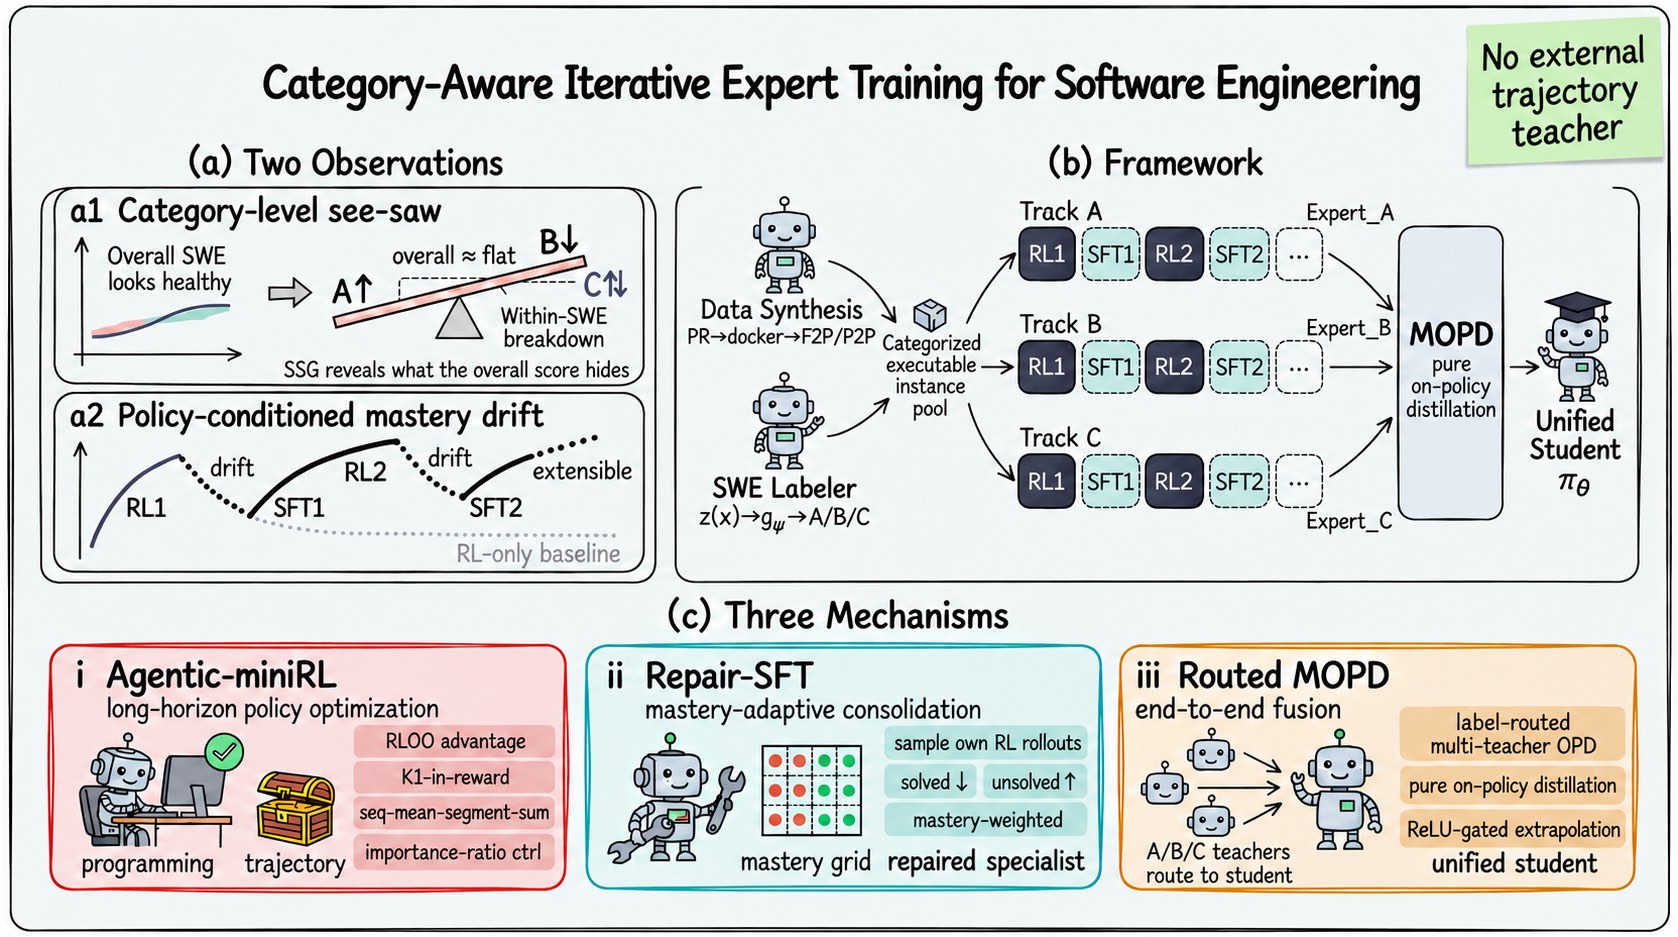
图1:框架全貌。(a) 两个动机观察:类别跷跷板 + 策略更新后实例掌握度会漂移,固定任务池会过时;(b) 框架主体:SWE Labeler 把任务路由到 A/B/C 三个类别池,三条同源的 Track 各自交替跑 RL 和 SFT 产出专家,最后经 MOPD 纯在线蒸馏合成统一的学生模型;(c) 三个核心机制:Agentic-miniRL、Repair SFT、路由 MOPD。右上角强调了一点:全程不需要外部教师模型提供轨迹。
整套框架有四个部件,我按依赖顺序讲。
SWE Labeler:先解决"怎么拆"
拆分类别这件事,最怕拍脑袋。作者的 SWE Labeler 搞了一套证据驱动的分层标签体系:两个语义轴(任务类型 26 个 L1 族 / 119 个 L2 标签;仓库领域 21 个 L1 族 / 108 个 L2 标签)加三个四级序数轴(修改范围、认知复杂度、预估解决时长)。每个细粒度标签都是一条"决策记录"——挂着一个权威来源(ISO/IEC 25010、MITRE CWE、Fowler 重构目录这些)、一个可操作的 SWE 判定规则、可观测的正向信号、以及与相邻标签的边界。
举个例子,bug-fix.logic_error 这个标签锚定在 CWE-682 和 CWE-697 上,覆盖错误的条件、计算或比较;而越界错误归到 off_by_one,意外状态修改归到 state_corruption。边界划在最容易混淆的地方,这个设计挺讲究的。
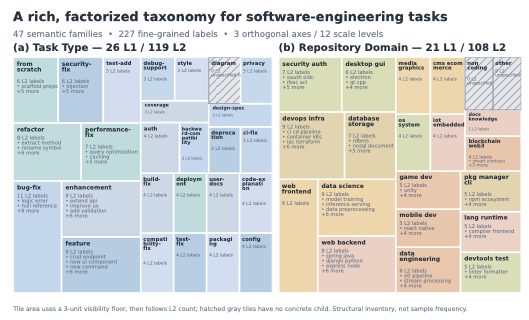
图3:两个语义轴的 L1 族拼图,色块面积正比于声明的 L2 标签数。左面板是 26 个任务类型族(bug-fix、feature、refactor、security-auth 等),右面板是 21 个仓库领域族(web_backend、devops_infra、lang_runtime 等)。
标签体系还有个小亮点:它同时支持静态的 issue–patch 任务记录和完整的智能体交互轨迹,两种证据形式经适配器归一化成同一套实例表示。用这套标签扫了三个基准共 1,531 个实例后,能看出明显的画像差异——SWE-bench Verified 里 87.0% 是 bug-fix、86.2% 是单文件修改,而 SWE-bench Pro 只有 47.3% 是 bug-fix、59.2% 要跨模块改动。这也是作者选 Pro 做主战场的原因:任务结构更多样,类别动态才测得出来。
但 26×21 的标签不能直接拿去训专家——粒度太细,每个专家的 RL 样本和优化预算都会被摊薄。所以最终用确定性的 Domain L1 规则把 18 个可路由领域粗化成三类:A 类(服务/数据/安全)、B 类(用户-facing 应用)、C 类(系统/工具/运行时)。Pro-618 对应切成 Pro-A/B/C = 221/201/196 个任务。
Agentic-miniRL:长程 RL 的四个补丁
RL 配方基于 MiniRL 改造,针对长程多轮 SWE 轨迹解决了四个问题。我觉得最值得讲的是前两个。
一个是 RLOO 留一法基线。可执行验证只给稀疏的 0/1 终局奖励,组内相对学习(GRPO 那类)只有在"有成功也有失败"的混合组里才有信号,而难题恰恰很少产生混合组。GRPO 把当前轨迹也算进自己的组均值里,会把这个本就稀缺的信号再缩小 (G-1)/G 倍。RLOO 把每条轨迹从自己的基线里剔除:
具体到 G=8、只有一条轨迹成功的组:GRPO 给那条独苗成功轨迹的优势是 7/8,RLOO 给到 1。数字不大,但在"成功极其稀缺"的难任务上,这点信号放大是实打实的。而且 RLOO 不用训 critic——每条沙箱轨迹都很贵,这个省法很务实。
另一个是 K1 正则放在奖励路径里。长程训练会让策略漂离参考模型,作者把采样的 K1 log-ratio 当作 stop-gradient 的奖励项、在 return-to-go 之前扣掉,而不是把 K3 估计量当成辅助 loss 直接微分。这里有个挺细的技术点:on-policy 下 K1 和 K3 估计的是同一个 reverse KL,但梯度不等价——K1-in-reward 给出的是 KL 正则目标的 score-function 梯度,K3-in-loss 是有偏的。之前 Shah 等人的受控实验也确实报告 K1-in-reward 更稳。这种"知道公式等价但梯度不等价"的细节,是踩过坑才会写进论文的。
剩下两个补丁:用截断重要性权重修正 rollout 引擎和训练器之间的行为概率失配(MiniRL 的老本行),外加一个符号感知的近端掩码防止单步更新过猛;以及按轮次聚合 token loss——assistant 轮内部求和、轨迹内对轮取平均、再对轨迹取平均,避免长轨迹或工具调用多的轨迹主导外权重。
RRE:让专家自己修复自己
这是全文我最喜欢的部分。
直觉上,类别切分后各自跑 RL 就该出强专家了,对吧?实际不是。初始专家 RL 跑完,训练实例的平均成功率确实涨了(A/B/C 分别涨 7.26、6.76、4.60 个点),但拆开看 2,769 条训练记录:1,108 条变好,839 条(30.3%)变差,822 条不变。平均数在涨,三分之一的实例在退步。
这个观察很扎心,也很真实。RL 更新是全局的,实例级的遗忘在所难免。作者的应对是 RRE 循环,三个阶段:
- Refresh(刷新):每轮 RL 结束后,用 4 次全新 rollout 重新估计每个训练实例的掌握度。关键洞察是:pass rate 不是任务的固有属性,而是"策略–实例"对的属性——策略一变,掌握度地图就过期了,基于旧地图选的课程自然失真。
- Repair(修复):把这一轮 RL 中该专家自己产出的、经 verifier 确认成功的轨迹攒成 buffer,做一轮 SFT。配额按当前掌握度反比分配:4 次尝试只成 0~1 次的实例给 4 条轨迹(最强修复压力),全成的只给 1 条(保持不丢)。低掌握度但有历史成功证据的实例,吃最多的 replay。
- Expand(扩展):下一轮 RL 前,从 32K 大池里随机补采基座模型 pass rate 为 0 或 1 的实例重新探测——曾经做不出的题现在可能做得出了,曾经饱和的题现在可能又忘了。新的 RL 训练集 = 当前信息前沿(pass rate 在 0 和 1 之间)+ 当前为零但有历史成功证据的"可恢复"实例。
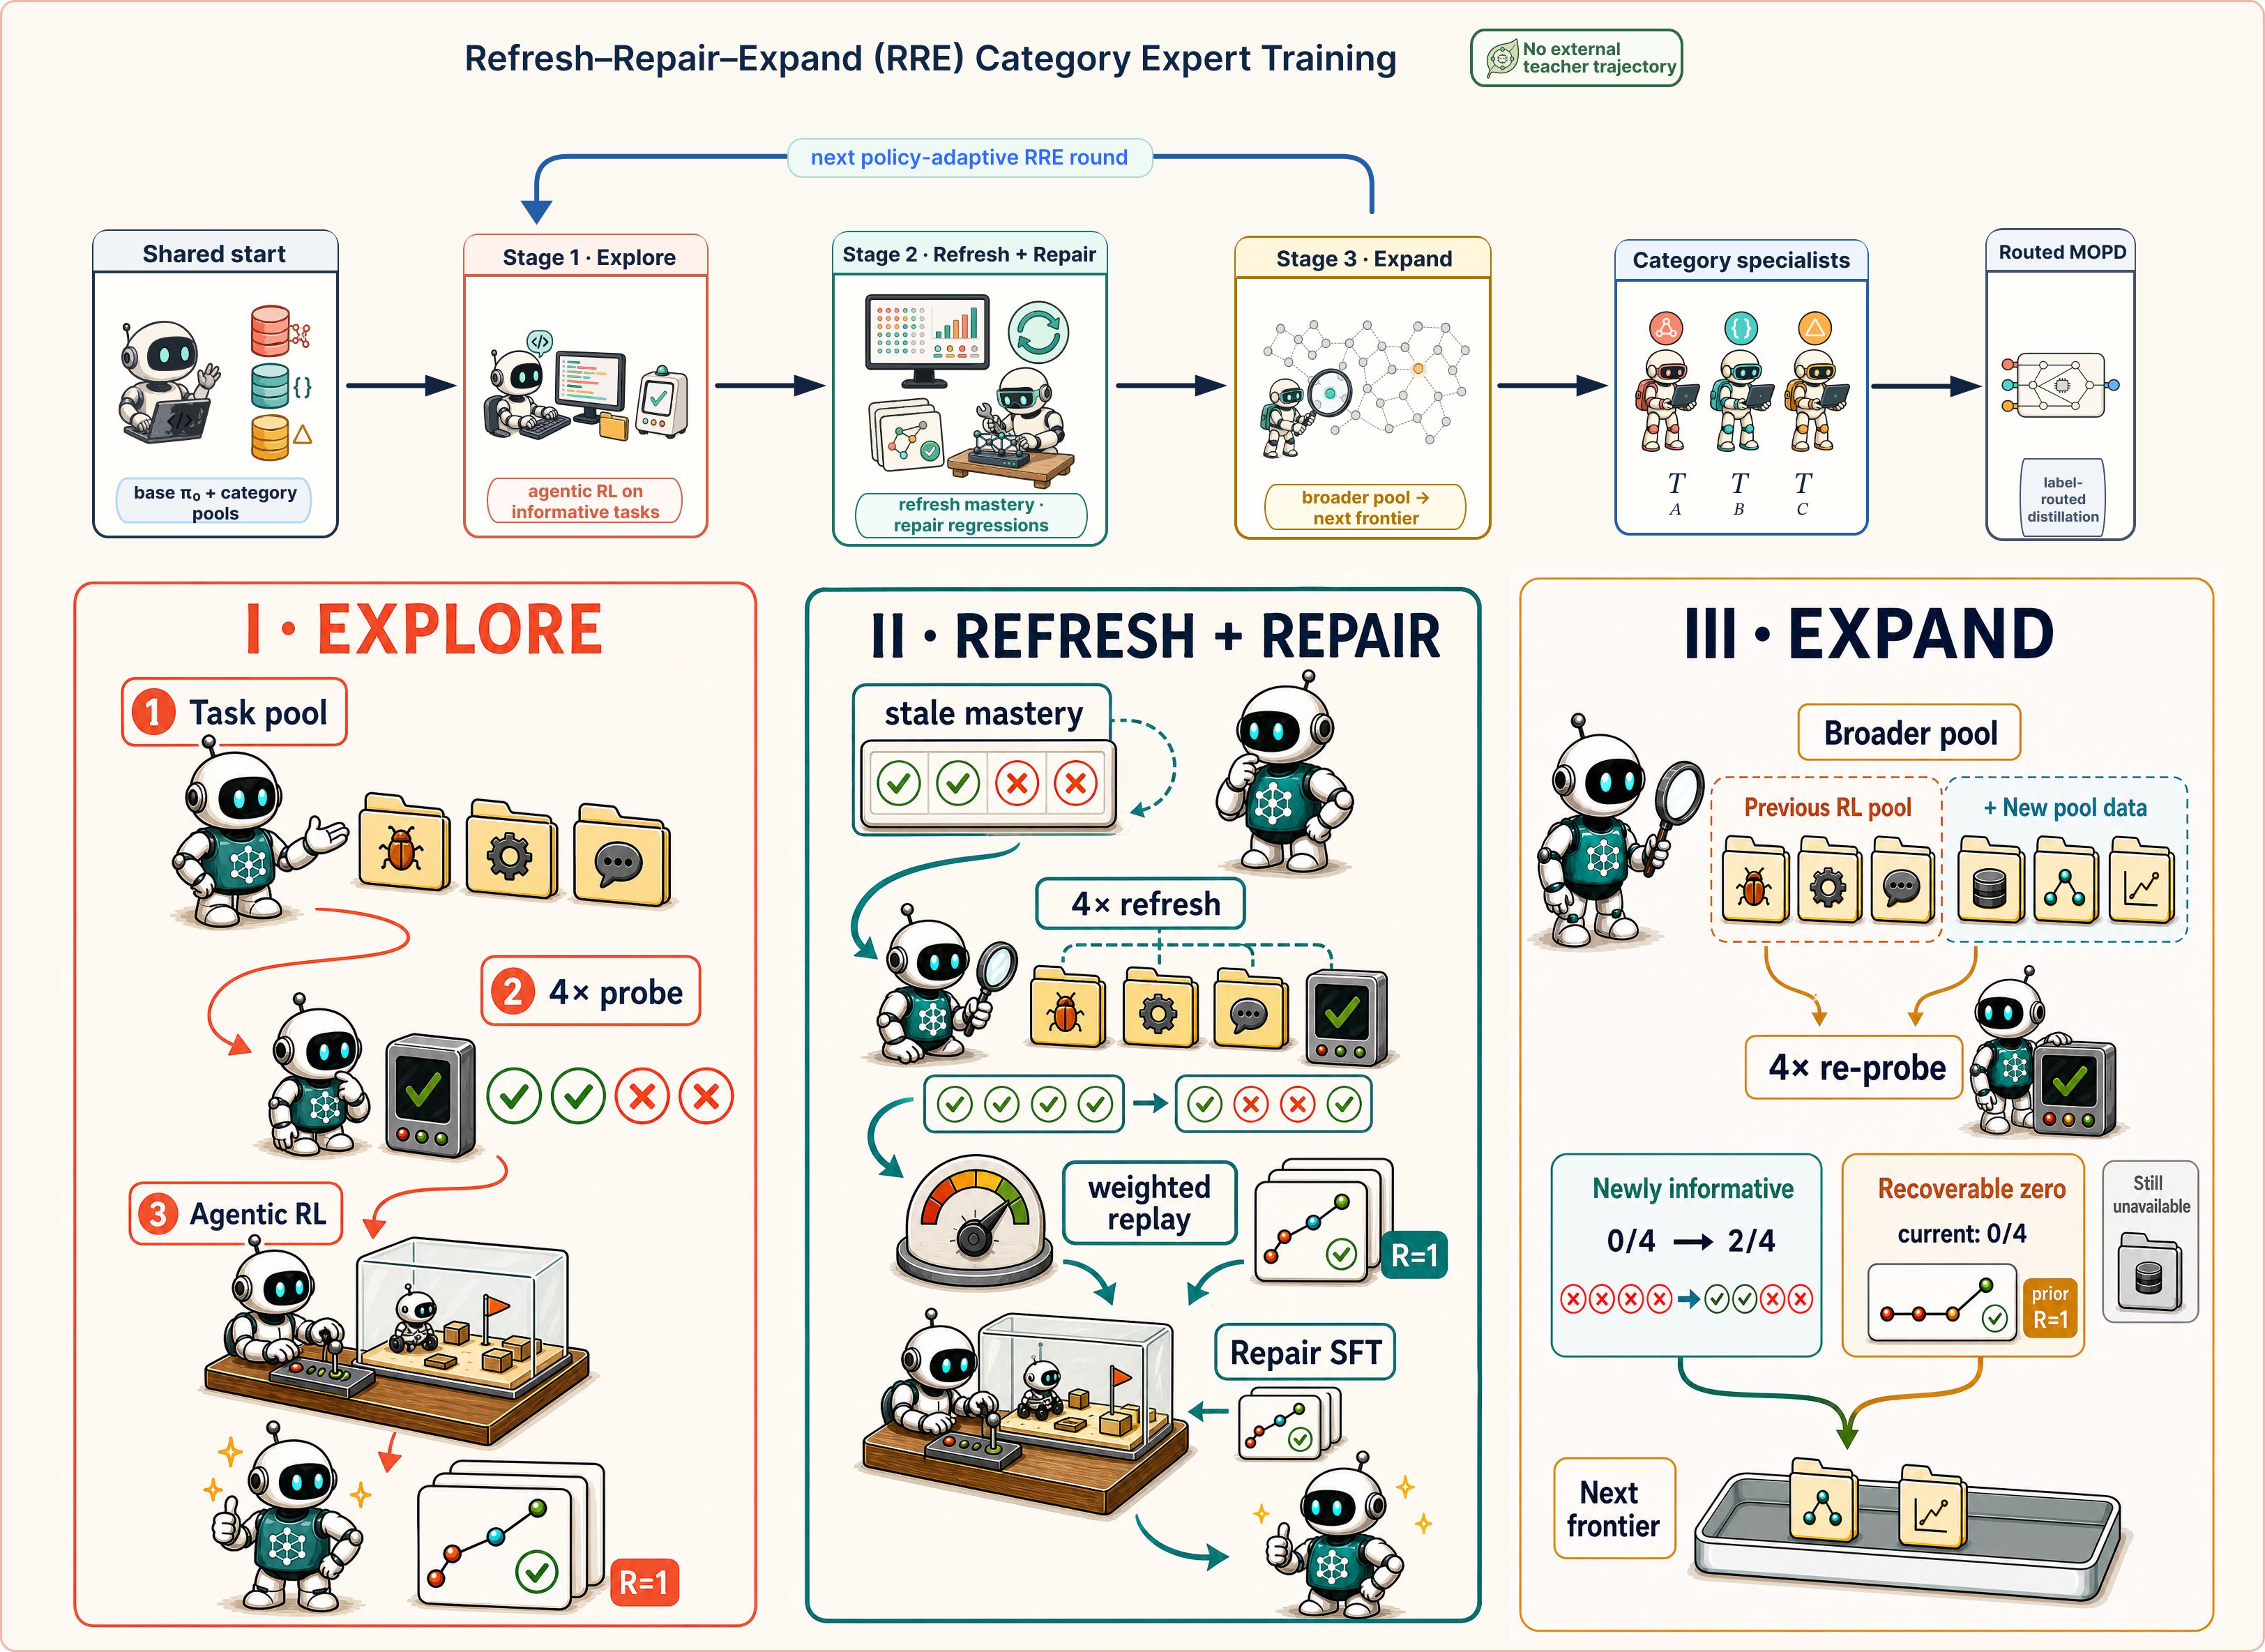
图4:RRE 完整流程。上半部分是全局管线:共享基座 → Stage 1 探索(agentic RL)→ Stage 2 刷新+修复 → Stage 3 扩展 → 产出三个类别专家 → 路由 MOPD。下半部分三个面板分别展开 I.EXPLORE(任务池探测与 RL)、II.REFRESH+REPAIR(4 次刷新探测、按掌握度加权 replay、Repair SFT)、III.EXPAND(更广池子再探测,区分新信息任务、可恢复零分任务和仍不可用任务)。
你想想看,这套循环跟传统的"大教师合成轨迹 → SFT → RL"流水线有个本质区别:修复用的轨迹全部来自专家自己的 on-policy rollout,没有任何外部模型提供示范。作者管 Repair SFT 叫"奖励过滤版的轨迹自蒸馏"。我喜欢这个设计的原因很工程——它把 RL 阶段烧掉的算力产生的成功轨迹二次利用了,而不是像很多 pipeline 那样用完即弃。
MOPD:把三个专家蒸回一个模型
专家练完了,部署总不能挂三个模型加路由器。最后一步是标签路由的多教师在线蒸馏(MOPD):学生从原始基座初始化,在类别均衡的 4,956 条任务记录上自己跑轨迹,每个任务按标签路由到对应专家,教师只在学生实际访问的前缀上给信号。
核心是这个路由优势函数:
其中 \(d_{t,k}\) 是学生(rollout 策略)与教师的 log 概率差,\(e_{t,k}\) 是教师与参考模型的 log 概率差。\(\lambda_k = 1\) 时退化成纯模仿;\(\lambda_k > 1\) 时(实际用 1.25),第二项会在"教师比参考模型更看好的 token"上给予额外推力——这就是 ExOPD 的奖励外推,让学生沿"教师超越基座的方向"走得更远,而不只是贴着教师。
这里有个作者自己发现的小坑:不外推方向的话,\(e_{t,k}\) 有正有负,实测正负分量幅度相当,外推项净效果趋近于零、变成一个有符号的残差。所以他们加了个 ReLU 门控,只保留教师超过参考的正向差。改完之后每个 token 上的外推贡献非负,方向系统性一致。说实话这个改动很小,但没有它外推项就是摆设——这种"把符号残差整流成单向信号"的操作,是典型的实验驱动出来的工程智慧。
另外整个 MOPD 跑的是纯蒸馏模式:环境奖励不进学生 loss,组基线和 K1 惩罚都关掉,参考模型只当外推锚点。教师和学生同源(同一个基座、同一套 tokenization、同一个 agent 接口),避免了跨架构蒸馏的那些脏问题。
实验:数字说话
实验用 Qwen3.6-27B 做基座,R2E-Gym 的 agent 框架,训练时 131K 上下文、最多 150 个动作、每动作最多生成 12,288 token,RL 每个任务采 8 条轨迹。训练在 ROLL 框架上跑,64 张卡(32 训练 + 32 推理)。还有两个值得一提的工程细节:奖励完整性协议做得很扎实——沙箱里删掉未来的 git 历史、reflog、远程分支(因为 pilot 实验里 agent 真的学会了 git log --all 翻未来提交、加 upstream remote 抄上游修复),评测时在全新沙箱里重放补丁再注入测试;以及 Pro-618 这个审计子集本身,剔除了 83 个规格缺陷、26 个评分欠定、3 个参考补丁都过不了的任务——这种对基准水分的警惕态度,值得所有刷榜工作学习。
RRE 专家的成长曲线
| 训练阶段 | Expert A / Pro-A | Expert B / Pro-B | Expert C / Pro-C |
|---|---|---|---|
| 基座 | 51.73 ± 0.43 | 54.39 ± 1.17 | 51.87 ± 1.27 |
| 初始 RL | 53.54 ± 0.77(+1.81) | 55.06 ± 0.62(+0.66) | 52.55 ± 1.10(+0.68) |
| 第一次 Repair SFT | 57.32 ± 0.43(+5.58) | 56.55 ± 0.62(+2.16) | 55.44 ± 0.96(+3.57) |
| 扩展 RL | 58.67 ± 1.19(+6.94) | 58.37 ± 2.00(+3.98) | 56.97 ± 0.96(+5.10) |
| 第二次 Repair SFT | 59.58 ± 1.40(+7.84) | 58.87 ± 1.31(+4.48) | 57.48 ± 0.64(+5.61) |
表:RRE 四阶段的目标类别解决率(三轮均值 ± 标准差,括号内为相对基座的增益)。
这张表藏着几个值得细嚼的点。初始 RL 的增益小得可怜(0.66~1.81 个点),远不如 Pooled RL 端点在对应类别上的表现——类别切分本身并不产生强专家。真正的跃升来自第一次 Repair SFT(A 类一口气涨 3.77 个点)。这说明 RRE 里最有杠杆的环节是"巩固已有成功",而不是继续探索。
训练实例级的诊断也支持这个结论:839 条初始 RL 中退步的记录里,751 条被纳入了 Repair SFT,其中 61.3%~73.0% 恢复到了基座水平以上。修复是真修复,不是数字游戏。
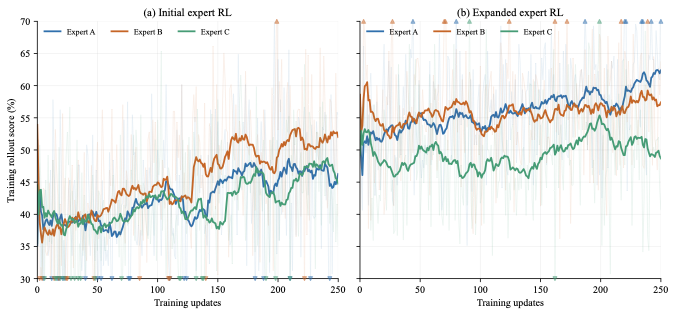
图6:(a) 初始 RL 和 (b) 扩展 RL 阶段三个专家的训练 rollout 分数。初始阶段 A/B/C 分别提升 7.76/12.74/6.58 个点,扩展阶段再提升 9.53/3.65/2.15 个点。曲线波动很大且伴有局部回退——这正是需要 Refresh 机制的直接证据。
终局对比:MOPD 对两个联合 RL 基线
| 策略 | Full | Pro-A | Pro-B | Pro-C |
|---|---|---|---|---|
| 基座 | 52.64 ± 0.28 | 51.73 ± 0.43 | 54.39 ± 1.17 | 51.87 ± 1.27 |
| Pooled RL | 55.50 ± 0.46(+2.86) | 54.75(+3.02) | 56.72(+2.32) | 55.10(+3.23) |
| Balanced RL | 55.34 ± 0.92(+2.70) | 54.45(+2.71) | 57.05(+2.65) | 54.59(+2.72) |
| 类别路由专家(3 个模型) | — | 59.58(+7.84) | 58.87(+4.48) | 57.48(+5.61) |
| MOPD(单模型) | 58.04 ± 0.20(+5.39) | 58.07(+6.33) | 59.37(+4.98) | 56.63(+4.76) |
表12:Pro-618 上的整体与类别解决率(%)。MOPD 在 Full 和全部三个类别上都超过两个联合 RL 基线。
几个关键读数。MOPD 比 Pooled RL 总分高 2.54 个点,三个类别分别高 3.32、2.65、1.53 个点——注意最小类别增益也是正的,这是对 Pooled RL 的类别级 Pareto 改进。对比 Balanced RL 也一样,总增益 5.39 对 2.70,最小类别增益 4.76 对 2.65,几乎翻倍。
蒸馏过程本身也很健康:
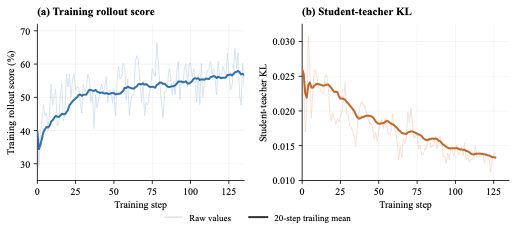
图7:(a) 学生的训练 rollout 分数从 45.51% 爬到 56.91%,涨 11.41 个点;(b) 学生–教师 KL 同步下降 43.0%。对齐和性能同向改善,说明学生确实在吸收路由教师的行为,而不是形式上收敛。
但最有意思的是专家增益的"保留率"问题:
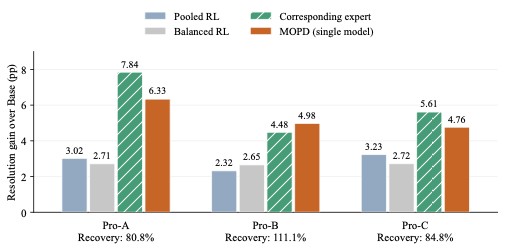
图8:每个类别上 Pooled RL(蓝)、Balanced RL(灰)、对应专家(绿斜纹)、MOPD 学生(橙)相对基座的增益。下方标注保留率:Pro-A 80.8%、Pro-B 111.1%、Pro-C 84.8%。
B 类保留率超过 100%——学生比它的老师还强了 0.50 个点,可能是多教师混合带来的正则化效应。但 A 类只保住了 80.8%,学生比专家低 1.51 个点。作者很诚实地指出:增益最小的类别(C)和保留率最低的类别(A)不是同一个,"哪个类别最难整合"跟"哪个类别最难训练"是两个独立问题。这个区分对后续工作很有指导价值。
泛化到第二个基准
SWE-bench Multilingual(300 实例、9 种语言、换用 SWE-agent 框架)上:MOPD 59.00,基座 56.22,Pooled RL 55.56,Balanced RL 57.00。MOPD 对基座的配对 bootstrap 95% 区间是 [0.33, 5.22],对 Pooled 是 [0.67, 6.22],对 Balanced 是 [-0.78, 4.78]——注意最后一个区间跨零,对 Balanced RL 的优势在这个基准上不算铁。作者没藏着这个数据,好评。
我的判断
这篇论文最值钱的地方,不是 58.04 这个分数,而是两样东西。
一是评估方法论。G_sim 和 SSG 这对指标,把"总分幻觉"变成了可测量的对象。任何做异构任务混合训练的团队——不限于 SWE——都应该把最小类别增益纳入监控面板。只看 aggregate metric 汇报训练进展,在这个时代已经不够诚实了。
二是 RRE 循环体现的训练哲学:掌握度是策略的函数,不是数据的属性。固定课程在长程训练中必然过时,而自己产出的成功轨迹是最便宜的修复材料。这个思路让我想起之前做项目时遇到的类似情况——RL 跑久了模型开始在最简单的题上翻车,当时我们用的土办法是往 batch 里掺简单题,RRE 给了一个更系统的版本:量化漂移、按需修复、动态扩边。
也有几处我持保留态度。类别切到 3 类这个粒度明显是预算约束下的妥协,作者在 limitation 里也承认了硬路由对跨类别任务的处理过于粗暴——一个"给 web 后端修安全漏洞"的任务该归 A 还是 B?没有组件级消融(RRE 三个阶段各自的贡献、ReLU 门控的独立收益都没单独拆出来),对于想复用部分组件的读者不太友好。全程训练成本也不低:三个专家各两轮 RL + 两轮 SFT + 蒸馏,外加每次 4 条 rollout 的刷新探测,这套流程的算力门槛不低。还有,所有教师同源虽然稳定,但同源性也限制了专家间的多样性上限——学生在 B 类上超过老师,很可能只是均衡混合的效应,而非真正的知识合成。
跟同期工作比,跨领域的专家拆分融合(Branch-Train-Merge、MOPD、ExOPD)已有先例,这篇的贡献是把这套范式搬到单一领域内部、用可观测标签构造专家划分,并补齐了 RRE 这个"专家养成"环节。说到底它是一次扎实的工程整合,而非底层算法突破——但整合得确实漂亮,问题定义得也确实精准。
如果你在做 coding agent 或者任何异构任务的 agentic RL,有三件事可以直接拿走:把评估拆到类别粒度并盯住最差类别;把 RL 成功轨迹存下来做掌握度加权的 SFT 修复;蒸馏融合时试试 ReLU 门控的外推项。整套流水线不要求外部教师,27B 量级的基座就能玩转,门槛主要在沙箱基础设施上。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我