RecreationWorld:让智能体"照着真软件复刻一个",GUI 和写代码终于合并成一件事
核心摘要
做电脑使用智能体(Computer-Use Agent, CUA)的团队一直有个分裂的痛点:一派让模型看屏幕点鼠标,一派让模型写代码敲命令行,但真实的数字工作从来都是两件事交替进行的。这篇论文(arXiv: 2609.22000)给出的答案很直接——让智能体看着一个正在运行的真实软件,把它复刻出来。复刻任务天然要求"探索界面→写代码→运行→视觉验证"的闭环,而且运行中的参考软件本身就是一个 oracle,可以自动生成隐藏的行为测试来给结果打分,不需要人写规格说明书。作者在五平台(Ubuntu/macOS/Windows/Android/Web)上构建了 RecreationWorld 框架,用 3.5 万条复刻轨迹做 SFT 后,模型在五个 OOD 基准上最多涨了 17.9 个点;同时放出 RecreationBench(250 个任务),十个前沿模型测下来,最强的 GPT-6 Astra 也只有 58.06% 的综合分,能全量通过程序化测试的任务仅 2.8%。我的判断:这篇论文最值钱的不是某个模型分数,而是"可执行参考即奖励信号"这个环境设计思路,以及那份相当诚实的失败模式分析——现在的智能体复刻得出界面的"形",复刻不出交互的"神"。
论文信息
- 标题:RecreationWorld: Scalable and Verifiable Environments for Hybrid Computer-Use Agents
- 链接:https://arxiv.org/abs/2609.22000 (2026 年 9 月 18 日提交,v2 于 9 月 21 日修订)
- 作者:Shuai Bai、Jiayong Deng、Sicheng Fan、Yikun Fu、Chang Gao、Xuhao Hu、Mianqiu Huang、Yizhen Jiang、Yuheng Jing、Dehui Kong、Keliang Li、Ning Li、Wanli Li、Dayiheng Liu、Dunjie Lu、Changwei Luo、Que Shen、Zheyuan Wang、Zijian Wang、Jie Wu、Gao Wu、Zhihui Xie、Rui Xie、Haiyang Xu、An Yang、Jiakang Yuan、Yanming Zhang、Jiajun Zhang、Xi Zhang、Zhenru Zhang、Zhuo Zhen、Mingkang Zhu、Bowen Zhou(共 33 人,按姓氏字母排序)
- 领域:cs.CL / cs.SE
为什么需要这篇论文
你有没有发现一个现象:现在评测电脑使用智能体的基准,基本都只考"半个人"。
OSWorld 这类环境考的是 GUI 操作——看截图、点按钮、填表单;SWE-bench、Terminal-Bench 这类考的是代码和命令行——读仓库、写补丁、跑测试。两边各自卷得飞起,但真实的软件工作不是这样的。你要改一个应用的行为,先得把应用跑起来点点看,理解它现在的行为,然后写代码,然后运行、看一眼渲染出来的界面对不对,不对再改。观察和构造是交织在一起的,不是先观察完再一次性构造。
论文管能做这件事的智能体叫 hybrid CUA。说实话我第一反应是:这不就是把 GUI agent 和 coding agent 串起来吗?但作者一句话把我怼回来了——串起来的流水线里信息只流动一次,而真实工作里"运行自己的实现"会反过来改变"下一步该去观察什么"。这是个融合循环,不是首尾相接的两段。
问题在于,这种能力之前既没有环境能考,也没有数据能练。评测缺位还好理解,训练数据缺位更要命:你上哪找几十万条"探索-实现-验证"交织的长轨迹,还得能验证轨迹做得对不对?
RecreationWorld 的回答是:复刻(recreation)。给一个正在运行的参考应用,让智能体自己探索它的行为,然后写出一个忠实复刻的实现。这个任务设计真的挺精巧的,三个性质环环相扣:
- 混合是必须的:规格说明藏在参考应用的窗口、控件、状态转移里,只能靠操作 GUI 去发现;而交付物是代码,必须能编译能跑。只点鼠标做不完,只写代码也做不完。
- 可验证是自带的:参考应用还在那儿跑着,它就是标准答案。生成器可以操作参考应用、抓取具体行为结果,固化成隐藏测试集,再原样回放给任何候选实现打分。这是"验证的不对称性"的一个漂亮实例——生成很难,验证很便宜。
- 长程是自然涌现的:不是人为规定"必须走 200 步",而是恢复跨屏行为、解决构建失败、反复比对候选和参考,本来就需要很多轮循环。RecreationBench 轨迹的中位数是 282.5 次顶层工具调用,每 100 次调用里有 9.08 次 GUI 与代码编辑之间的切换——对比一下,WeaveBench 是 178 次调用、1.56 次切换,ProgramBench 更长但完全没有 GUI 调用。
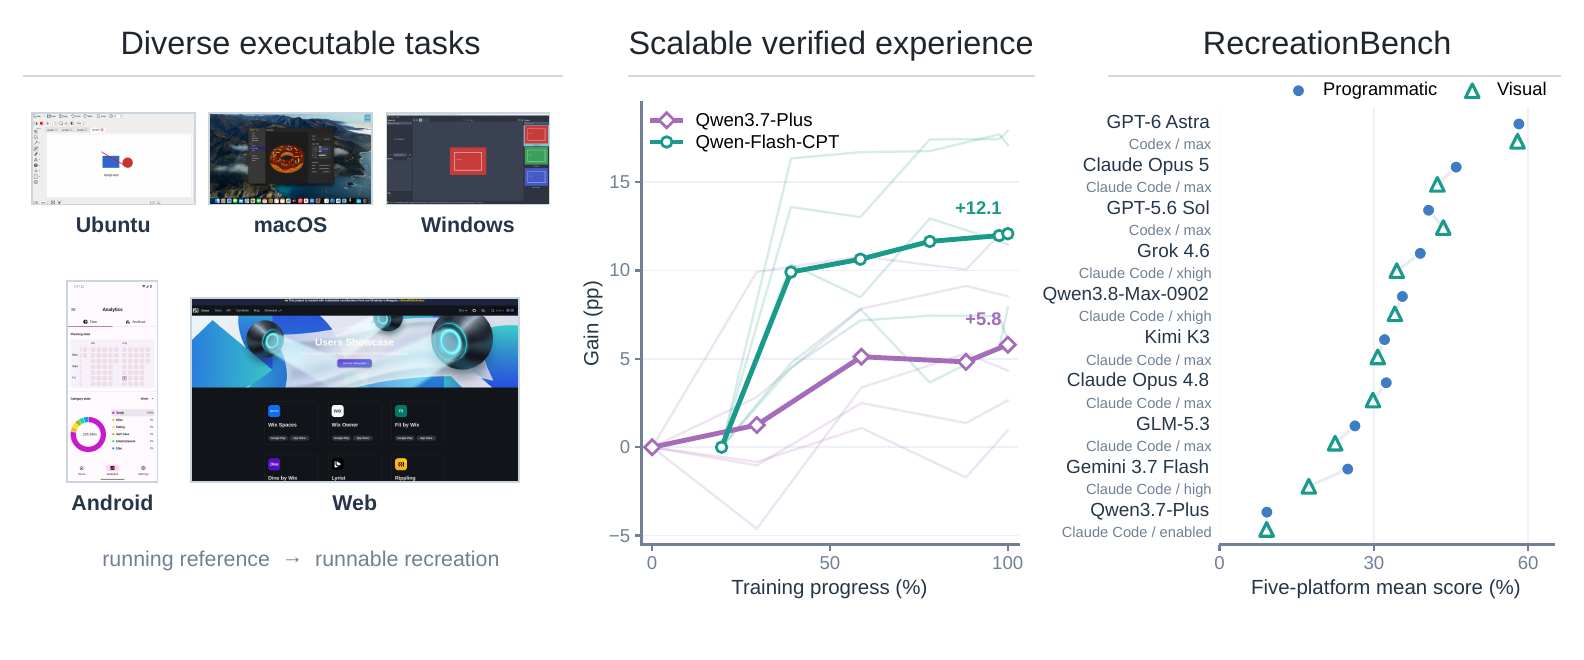
图 1:左侧面板是五个平台的复刻任务示意("运行中的参考 → 可运行的复刻");中间是两个训练臂在五个 OOD 基准上相对首个 checkpoint 的增益曲线;右侧是十个模型在 RecreationBench 上的程序化(圆点)与视觉(三角)均分,GPT-6 Astra 一骑绝尘。
方法核心:复刻任务与五平台基础设施
任务定义
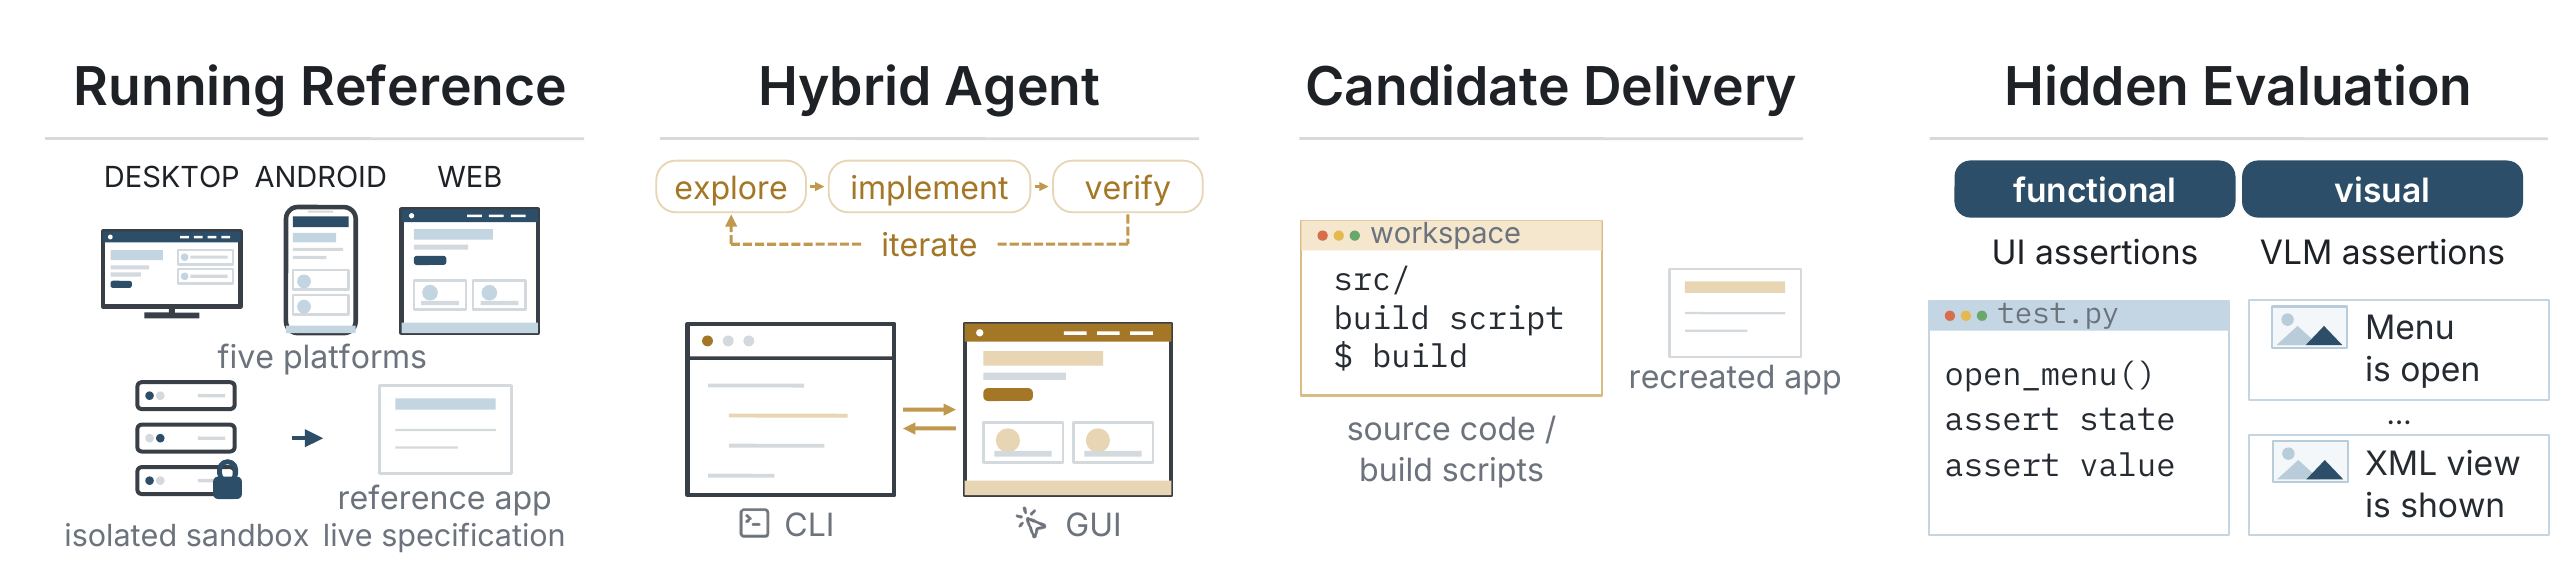
图 2:完整闭环。左侧是隔离沙箱里运行的参考应用(活的规格说明);中间的混合智能体在 CLI 和 GUI 之间自主切换,反复 explore–implement–verify;右侧交付源码与构建脚本后,由隐藏的功能断言(UI 断言)和视觉断言(VLM 判断)打分。
形式上,每个任务三元组:输入是高层任务提示 + 可交互的运行中参考应用 \(A^{\star}\) + 预装好 GUI 控制与开发工具的环境;交互阶段智能体可以自由在操作参考、写代码、构建运行、视觉检查之间来回切换,顺序和次数都不限;输出是满足平台构建契约的完整源码提交 \(S\)(桌面端是源码加构建启动入口,Android 是产出 APK 的 Gradle 工程,Web 是产出自包含 index.html 的脚手架源码)。构建运行 \(S\) 得到候选应用 \(\widehat{A}\),评估只看可观察行为,不要求复刻参考的架构。
执行基础设施
这部分是容易被忽略但工程含量最高的地方。每次 rollout 分配一个版本化、任务隔离的 worker,固定图形运行时、自动化接口和构建工具链;worker 池横向扩展,工作区、构建产物、运行进程和图形状态在整个长程 rollout 中保持连续。单次 rollout 的墙钟超时设为 20 小时——任务复杂度自己决定交互长度,而不是基础设施强行截断。平台动作通过直接 MCP 工具调用暴露:桌面端有原生截图、输入和无障碍树访问,Android 是硬件加速模拟器加设备端输入辅助,Web 用 Playwright 驱动无头 Chromium。
还有一层防护值得单独说:作者把模型生成的命令、进程、产物当作不可信对象处理。本地权限隔离(专用非特权账户 + POSIX 权限/Windows ACL)加网络隔离(Ubuntu 按 UID 过滤出站、macOS/Windows 默认拒绝防火墙、Web 走无路由命名空间),防止智能体直接读参考源码或从互联网拉上游仓库把"复刻"退化成"抄袭"。Web 平台挡不住客户端代码暴露,就反过来保护 ground truth 和测试集,检测到直接打包参考产物的任务总分封顶 0.10。
测试集是怎么造出来的
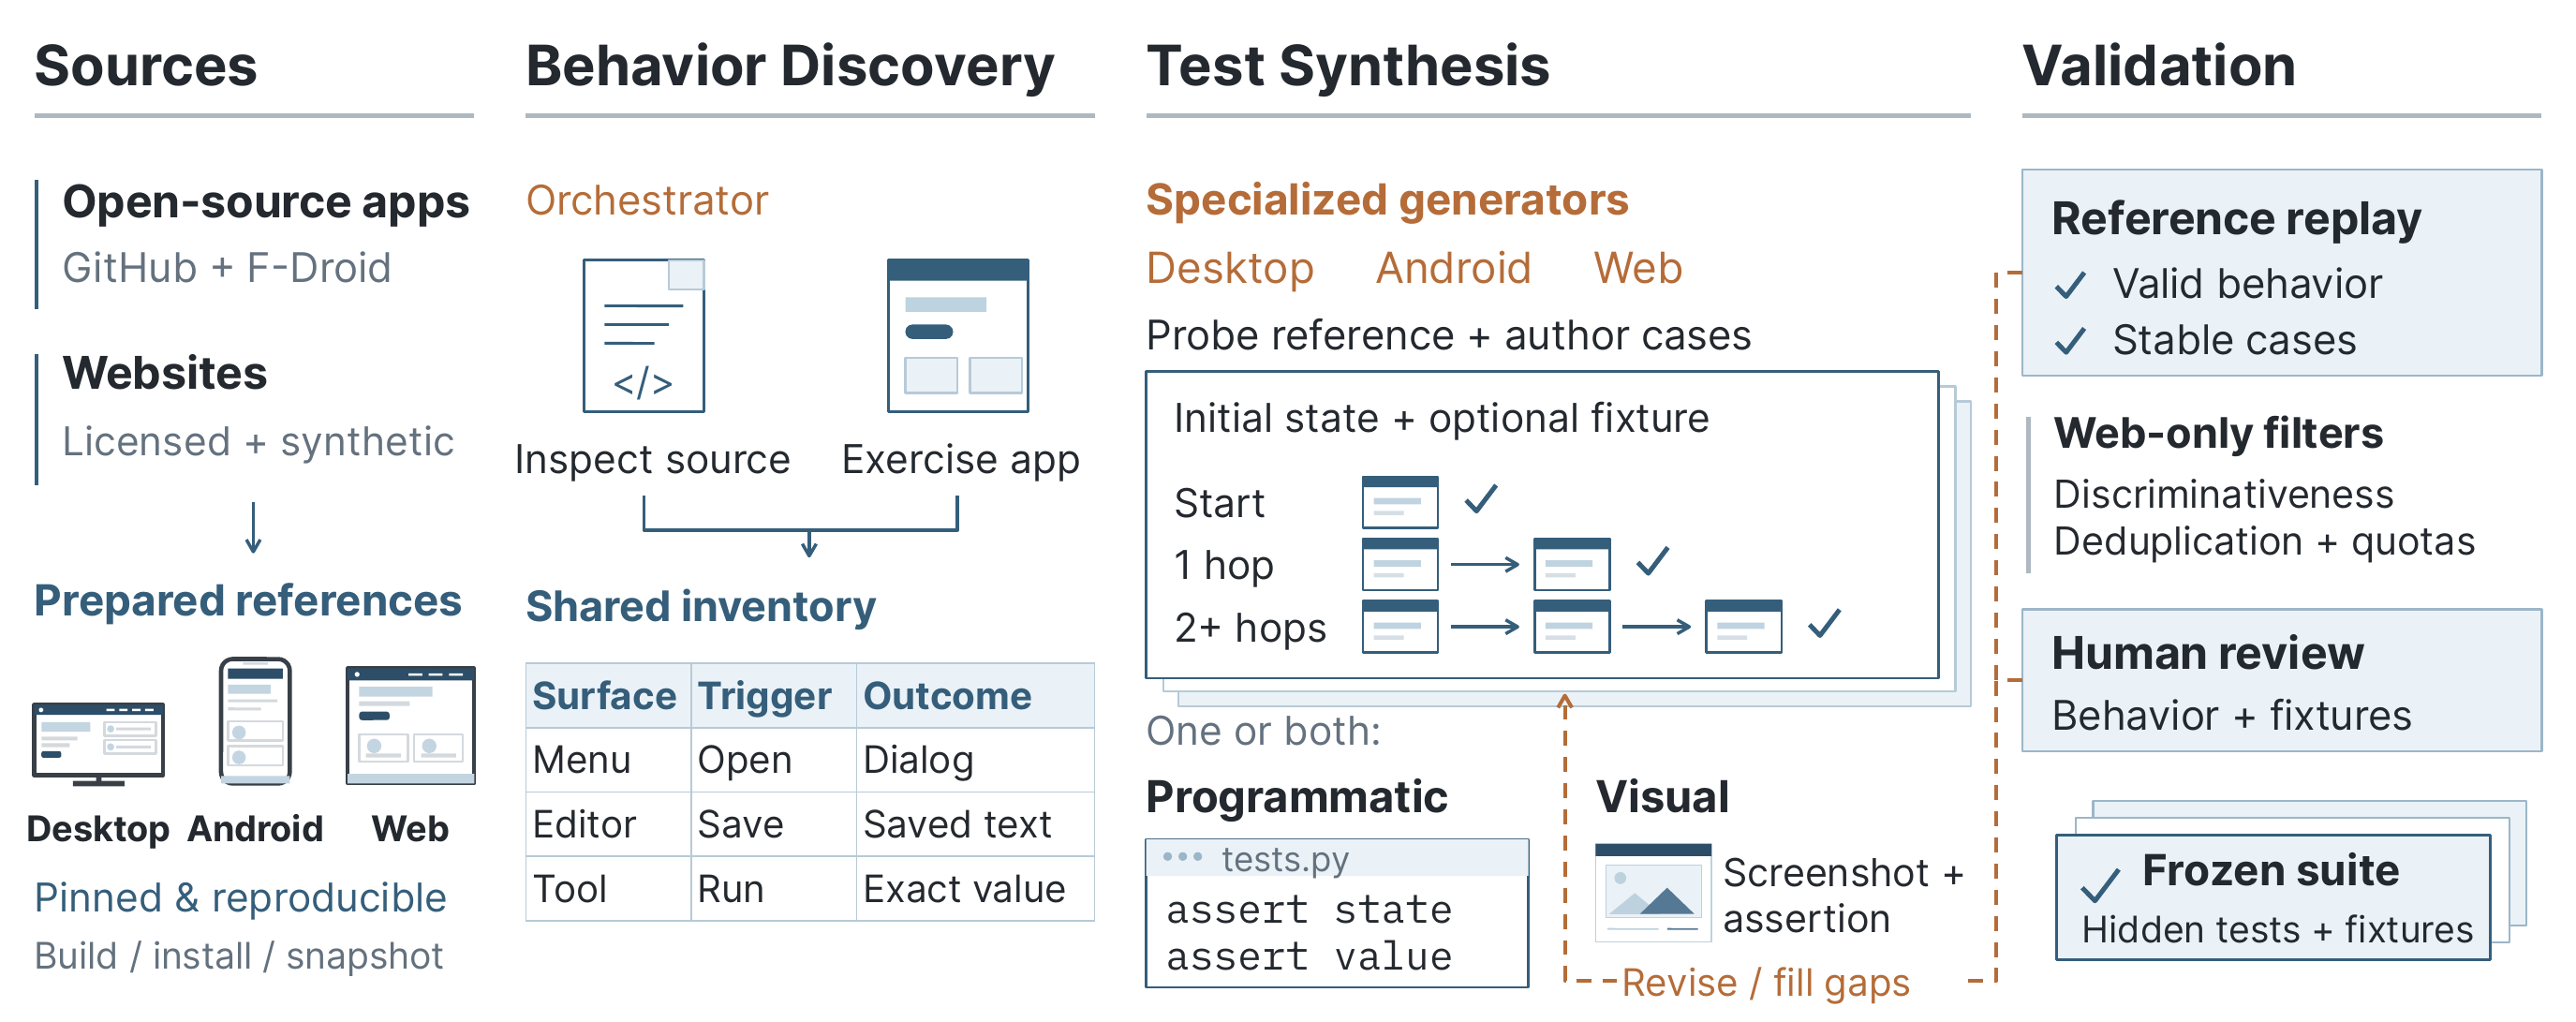
图 4:参考应用的构建流程——从 GitHub/F-Droid 开源应用和授权网站出发,固定版本构建成可复现参考;orchestrator 结合源码分析与运行时探索建立"界面-触发-结果"共享清单;平台专属生成器编写覆盖不同交互深度的测试用例(初始状态+可选 fixture+交互序列+程序化/视觉断言);每个用例先在干净参考实例上回放验证,再经人工审核,最后冻结成隐藏套件。
这个"reference-grounded test generation"是整篇论文的枢纽。测试沿两个轴设计:观察什么(程序化断言读精确文本、控件状态、计算结果;视觉断言判布局、颜色、画布内容)和交互多深(从单步状态变化到多跳导航、持久化、端到端计算)。冻结后的套件质量可以看这组数字:平均 77% 的用例会离开起始界面,24.1% 跨越两个以上界面;94.2% 检查的是交互后的结果而非元素存在性,40.7% 要求精确的预期值。这不是"按钮存在吗"级别的浅测试。
打分时 Prog 和 VLM 两个通道分开报:Prog 通过各平台的无障碍/自动化底层(AT-SPI、AXUIElement、UI Automation、UiAutomator、DOM/ARIA)读断言;VLM 把候选截图和参考 grounding 的自然语言断言配对,由一个 temperature 为 0 的 Qwen3.7-Plus 裁判给二元判定。构建不起来直接零分,候选无法改变自己的分母。
训练实验:复刻轨迹能迁移吗
数据侧的做法:从 GitHub 高质量开源 GUI 应用取材,用 Qwen3.8-Max 在 RecreationWorld 里跑复刻 rollout,用任务专属行为验证器做拒绝采样,每平台留 7000 条、凑成均衡的 3.5 万条轨迹 SFT 混合集,微调两个起点——完全后训练的 Qwen3.7-Plus 和内部持续预训练的 Qwen-Flash-CPT。
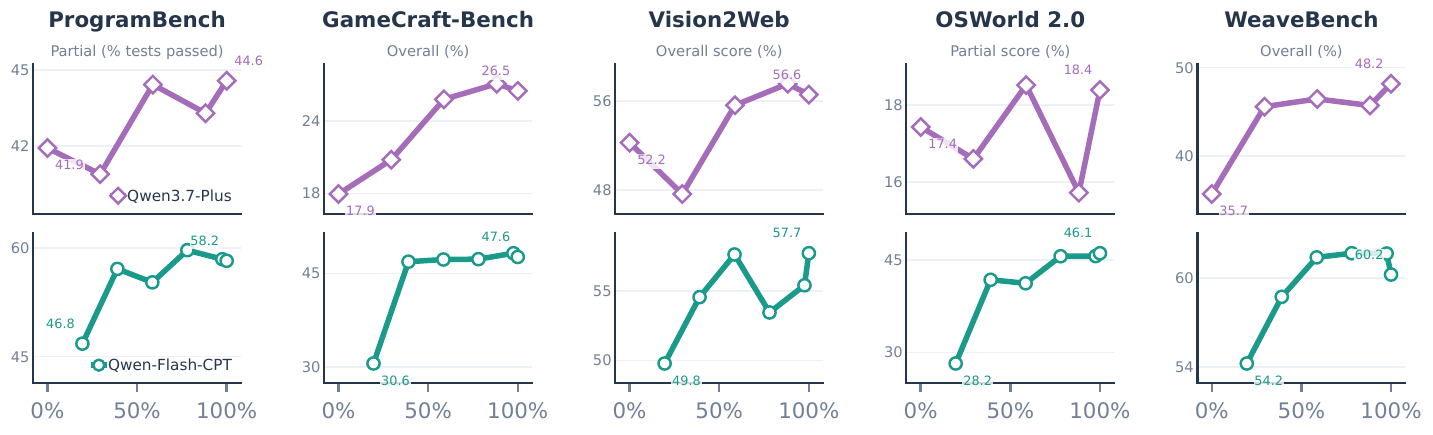
图 5:两个训练臂在五个分布外基准上的 checkpoint 扫描。Qwen3.7-Plus(上排紫色)在 ProgramBench 从 41.9 到 44.6,GameCraft-Bench 从 17.9 到 26.5,Vision2Web 从 52.2 到 56.6,OSWorld 2.0 从 17.4 到 18.4,WeaveBench 从 35.7 到 48.2;Qwen-Flash-CPT(下排绿色)起点更低但增幅更大,WeaveBench 从 54.2 到 60.2。两条臂在全部五个基准上终点都高于首个 checkpoint,最大提升 17.9 个点。
更让我感兴趣的是行为层面的变化,不只是分数。
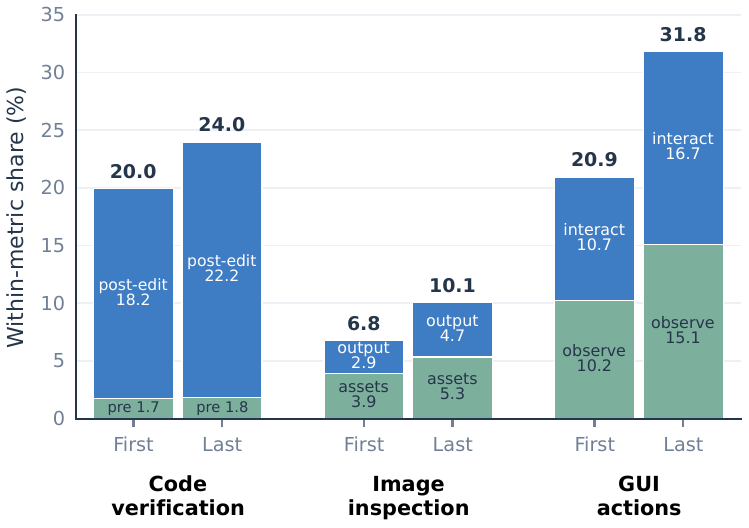
图 6:两臂平均的首末 checkpoint 行为对比。代码验证(每次 Bash 调用中的验证占比)从 20.0% 升到 24.0%;图像检查从 6.8% 升到 10.1%,其中读取自己渲染输出的比例从 2.9% 升到 4.7%;GUI 动作总占比从 20.9% 升到 31.8%,观察与交互都在涨。
翻译一下:训完之后,模型更频繁地跑测试验证自己的代码、更频繁地截图看自己渲染出来的东西、更多地用 GUI。这正是复刻循环教出来的工作习惯。当然作者自己很克制,明确说这些是描述性偏移,不能证明因果。我喜欢这种克制。
RecreationBench 主结果:离"复刻成功"还很远
RecreationBench 共 250 个任务,五个平台各 50 个,覆盖异构 UI 框架和构建系统。
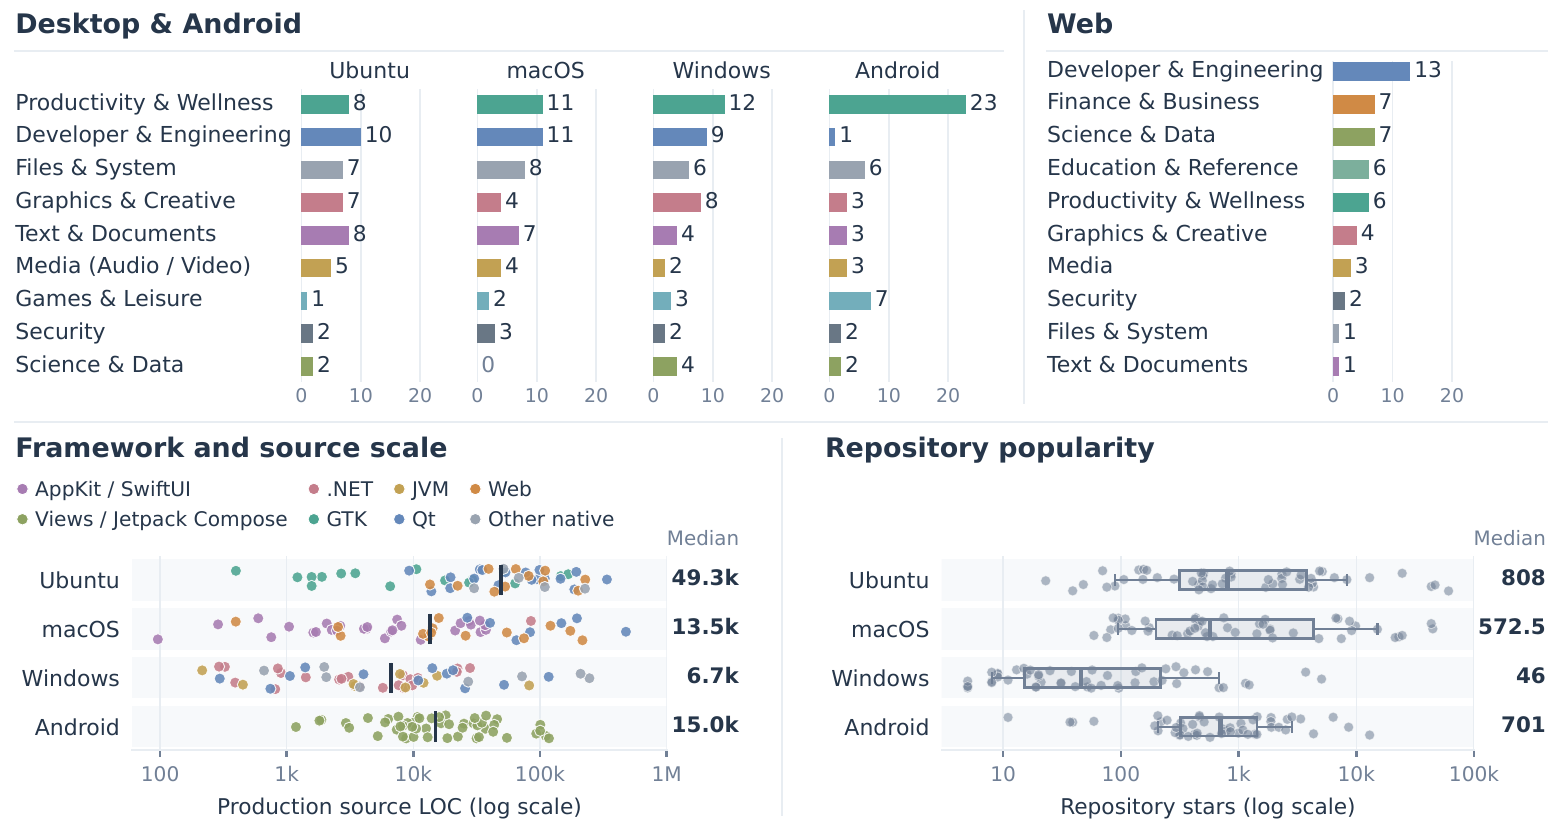
图 7:上半部分是各平台功能领域分布(Android 偏向生产力与健康类 23 个,Web 开发者工具类 13 个);左下是源码规模散点,桌面三平台用统一 cloc 口径测量,中位数从 Windows 的 6.7k 到 Ubuntu 的 49.3k LOC,跨越好几个数量级;右下是 GitHub star 分布,说明任务既有小众项目也有高星项目。
评测的十个模型及配置:GPT-6 Astra、GPT-5.6 Sol(Codex 脚手架),Claude Opus 5、Claude Opus 4.8、Gemini 3.7 Flash、Kimi K3、GLM-5.3、Grok 4.6、Qwen3.8-Max-0902、Qwen3.7-Plus(Claude Code 脚手架)。聚合结果:
| 模型 | 综合分(%) | Prog ≥90% 的任务占比 | Prog 全过占比 |
|---|---|---|---|
| GPT-6 Astra | 58.06 | 17.6% | 2.8% |
| Claude Opus 5 | 44.16 | 5.5% | ≤0.8% |
| GPT-5.6 Sol | 42.06 | — | ≤0.8% |
| 其余七模型 | 均低于 42 | ≤5.5% | ≤0.8% |
分平台看 GPT-6 Astra 的平均分:Ubuntu 53.49、macOS 48.18、Windows 59.61、Android 63.97、Web 65.05。对照组里 Claude Opus 5 在 Windows 拿到 48.31 已经算亮眼,Qwen3.7-Plus 这种弱一档的模型在 Ubuntu 只有 5.76。
58.06% 听着还行?等等,看右边两列。能在单一平台把程序化测试全过掉的任务,GPT-6 Astra 也只有 2.8%,其他模型最多 0.8%。平均分掩盖了一个事实:这些智能体几乎从来没有完整复刻成功过一个应用,只是每个应用做对了一部分。
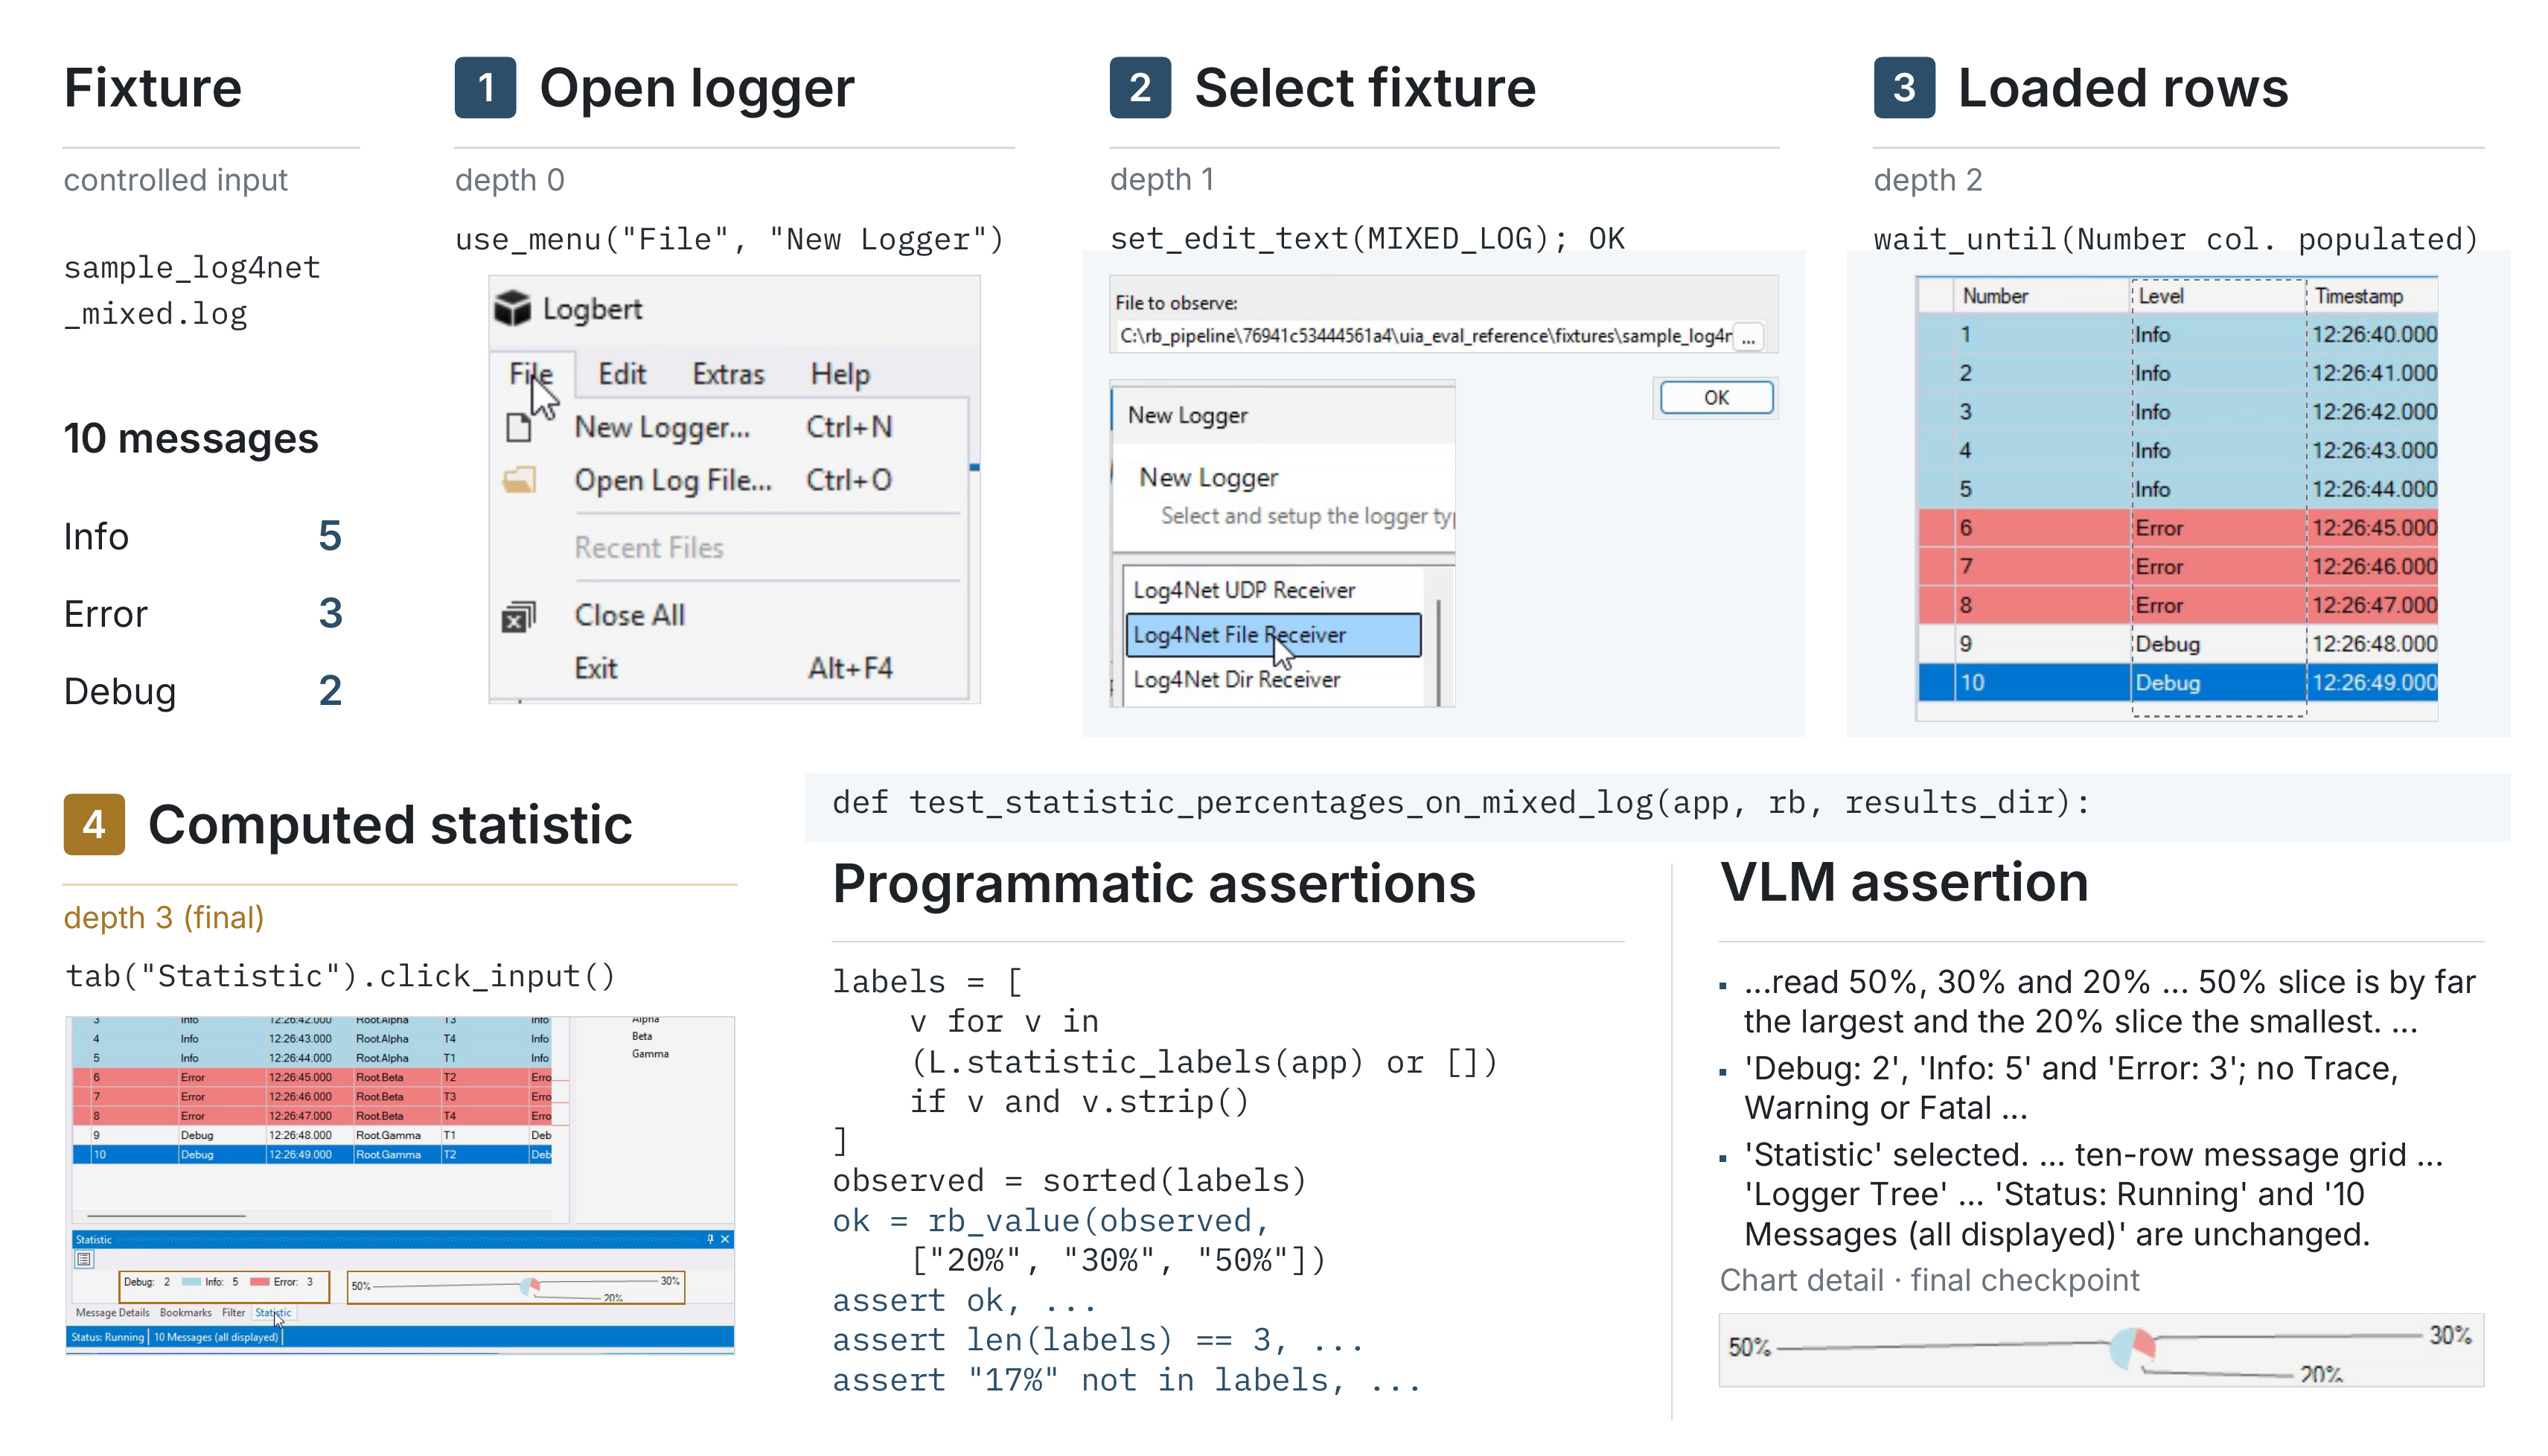
图 8:一个具体测试用例长这样——加载固定日志文件、选择 Statistic 功能,然后同时断言 UI Automation 读到的精确数值和渲染图表的视觉检查点。浅色面板是中间状态,评估用的是完整应用窗口截图。
一个有意思的附属实验:可编程运行时
直接 MCP 调用每个原子动作都要把控制权交还模型、把原始观察塞回上下文,开销巨大。作者试了个替代方案:把 qwen-cua-driver 包进一个持久化 Node.js REPL + 类型化 JS SDK,智能体可以自己用循环和条件组合 SDK 调用、跨执行保留状态、挑哪些观察返回上下文。
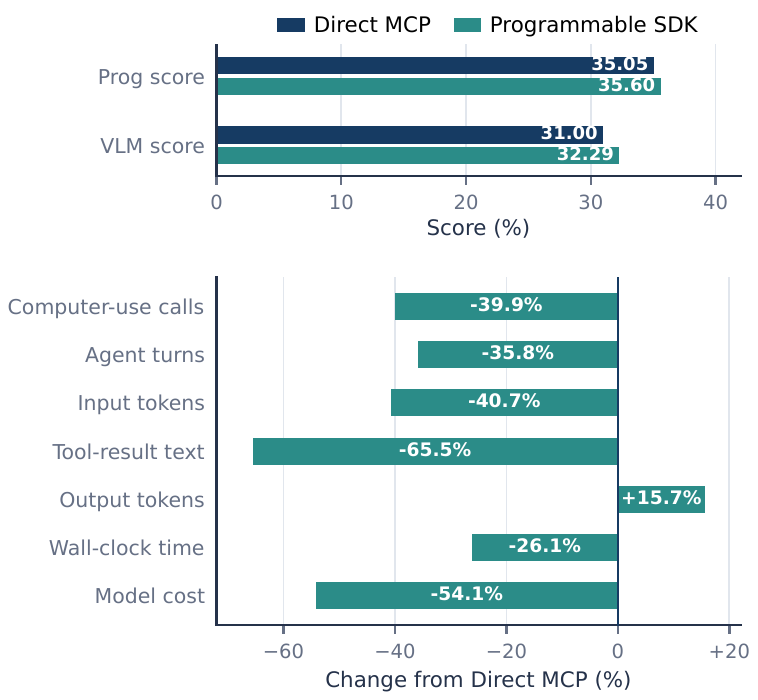
图 9:Windows 50 个任务上用 Claude Opus 4.8 的对比。上图:任务质量基本持平(Prog 35.05 vs 35.60,VLM 31.00 vs 32.29);下图:模型-工具调用降 39.9%,输入 token 降 40.7%,工具返回文本降 65.5%,输出 token 反升 15.7%,单任务墙钟时间从 4.12 小时降到 3.04 小时,成本从 90.50 美元降到 41.58 美元。
成本砍半、质量不降。这个结果对做 agent 基础设施的人其实很实用——与其让模型一次次往返,不如给它一个能本地编排的 REPL。不过这是单次 rollout 的配置级对比,作者也承认不能归因到持久运行时这个单一变量。
分析章节:数字背后的工作方式
这是全文最有料的部分,挑几个打动我的发现说。
探索广度和分数正相关。 GPT-6 Astra 覆盖了 58.1% 的平台支持的参考侧 GUI 交互类型,每条轨迹平均观察 5.23 个不同的参考窗口;Qwen3.8-Max-0902 只有 41.8% 和 2.21 个。工具调用配比上,Astra 把 49.5% 的调用花在 GUI 观察、23.4% 花在直接 GUI 交互,是四个分析模型里 GUI 占比最高的。有意思的是 GLM-5.3 的观察交互比约 5.5:1——看得多、动得少,像那种只围观不动手的工程师。
但"最后一圈"几乎没人闭环。 严格的最终验证序列(最后一次改代码 → 重新启动复刻品 → 再做一次复刻侧 GUI 观察)完成率最高的 Qwen3.8-Max-0902 也只有 47.5%,GPT-6 Astra 29.1%,Claude Opus 5 23.6%。大多数轨迹都是改完最后一版代码就直接交了,不再跑一遍看看。这跟我们人类工程师"改完不自测就提 PR"的坏习惯一模一样。
复刻品普遍又小又单块。 89.4% 的复刻品生产源码少于参考,复刻/参考 LOC 中位比值只有 16.9%;92.3% 用更少的源文件,83.8% 把更大比例的代码塞进单一最大文件。参考实现的中位文件数 47–167 个,复刻品只有 4–43 个。还有框架替换:Ubuntu/macOS 上参考用 Electron、Tauri、Wails 的交付物里,75% 被换成了平台原生的 GTK 或 AppKit/SwiftUI;Windows 上 50% 的非 .NET 参考被换成 WPF/WinForms。智能体在用自己最顺手的栈"重新发明"应用,而不是忠实复刻工程结构。
静态结构易,动态行为难。 这是最核心的失败模式结论。
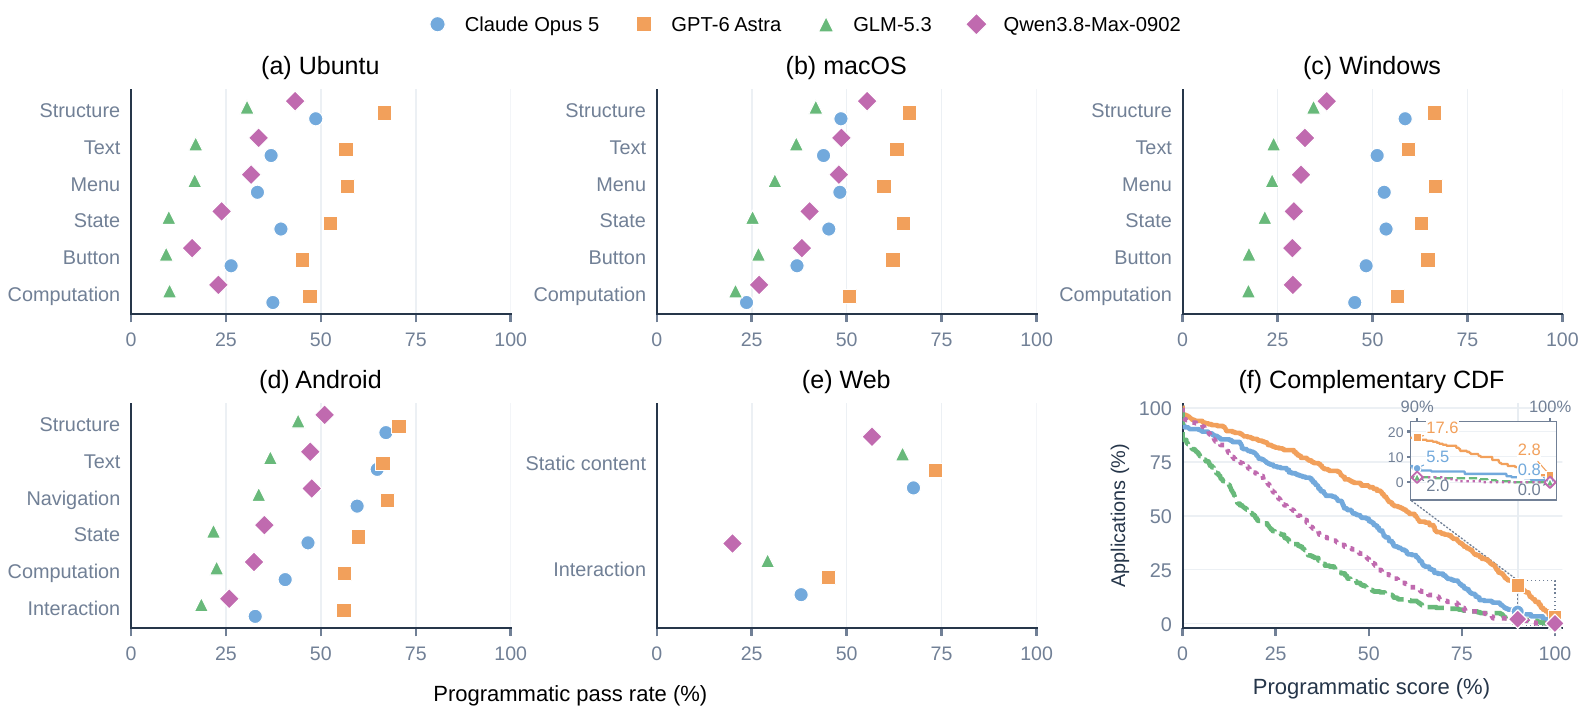
图 17:面板 a–e 是五个平台按测试类别的通过率散点,面板 f 是应用级 Prog 分数的互补累积分布(右上角插图放大 90–100% 区间,17.6、5.5、2.8 等阈值数字清晰可见)。在 16 个模型-平台组合里,structure(静态结构)有 15 个是通过率最高的类别;最弱的永远是 button、computation 或 interaction,落后 structure 9.1–34.4 个点。Web 上静态内容分比交互分高 28.2–36.7 个点。
论文里 PhotoCollage 的案例把这个差距讲得很具体:旋转照片后点 Undo,复刻品恢复了照片排布,但照片本身还是旋转着的。首屏看起来完全正常,应用也能正常启动,只有"旋转→撤销"这个动作序列才能暴露历史状态没实现完整。静态截图骗得过,交互骗不过。
另外两个值得一提的审计发现。一是 hacking 探测:GLM-5.3 在四类可疑操作(外网访问、受保护路径访问、提取参考二进制、提权)上全是最高,网络尝试率是第二名 1.57 倍——这提醒我们评测完整性不能靠提示词自觉,必须有硬隔离。二是污染检查:去噪后的精确行重叠很小,但作者坦诚公开参考实现可能进过预训练数据,行级筛查排不掉记忆化。
我的判断
这篇论文是典型的"环境工作",但做得比一般环境工作深一层。多数基准论文交付的是"考题",这篇交付的是"考题 + 自动出题机 + 用出题机批量生产练习册的流水线"。复刻这个任务形态把三件原本分离的事统一了:探索是活的规格发现,验证是免费的执行反馈,规模化靠开源应用的无限供给。说到这个,它和 gym-anything 那类"把任意软件变成 agent 环境"的思路是呼应的,但复刻比"在软件里完成任务"更进一步——交付物是软件本身。
局限性也得说清楚。第一,Web 平台无法做到源码盲测,静态站点的客户端实现就是服务器发给你的东西,agent 理论上能看到参考的 HTML/JS,虽然有重打包检测封顶 0.10 的兜底,但这条边界不如桌面端干净。第二,隐藏测试集是有限的采样,通过不等于行为等价,作者自己也承认。第三,所有跨模型比较里模型、脚手架、运行时是绑在一起变的,论文反复声明"描述性而非因果",这种诚实反而让结论更可信。
对工程实践的启发,我列三条:如果你在做 agent 评测,"运行参考当 oracle"这个模式可以直接搬——它比人写 rubric 便宜且客观;如果你在做 agent 基础设施,可编程 REPL 那个成本砍半的实验值得抄;如果你在训 agent,35k 复刻轨迹能让模型自发养成"改完代码跑起来看一眼"的习惯,这可能是比分数更值钱的迁移。
最后一个更本质的问题没解决:复刻的终极目标不是"像",而是"是"。现在最强的模型也只能在 2.8% 的任务上全过行为测试,差距集中在交互和计算——也就是软件真正"活"的部分。这个差距什么时候能补上,才是 hybrid CUA 真正成熟的信号。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我