技能写得太长没人看?GraphSkillEvo:把 Agent 技能画成流程图,再用进化算法慢慢磨
上周翻 arXiv 的时候刷到一篇挺对我胃口的论文(arXiv:2609.21749)。它戳中了一个我自己在搭 Agent 时反复碰到的痛点:你给模型写了一大段"技能说明"(skill),洋洋洒洒几千字的 bullet point,结果模型执行的时候根本抓不住重点——尤其是小模型,看到超长指令直接懵圈,该查资料的时候去调计算器,该收尾的时候还在绕圈。
核心摘要:现有的技能优化方法(比如 SkillOpt)把技能当成一坨无结构的纯文本,让 LLM 自己反思、自己打补丁。问题是,纯文本技能又长又冗余,模型执行时找不到当前步骤该看哪条;优化器还得在无穷无尽的文本写法里瞎逛。GraphSkillEvo 的思路是:把技能表示成一张图——节点是执行步骤,边是步骤之间的流转条件——然后用种群进化(变异 + 交叉)在这个结构化空间里搜索。在 5 个 Agent 基准上,它比 SkillOpt 平均提升 4.01%(GPT-5.4-nano)和 1.76%(GPT-5.4),优化花的 token 反而更少(约省 24%-27%)。我的判断:这不是什么颠覆性突破,但"图表示 + 进化搜索"这个组合打得相当扎实,尤其是对小模型和流程型任务,值得工程上借鉴。
📖 论文信息
- 标题:GraphSkillEvo: Evolutionary Optimization of Graph-Structured Agent Skills
- 作者:Rui Sun(香港城市大学)、Zhi Zheng(新加坡国立大学)、Zhenkun Wang(南方科技大学)、Zhichao Lu(香港城市大学),前两位共同一作
- 日期:2026 年 9 月 18 日
- 链接:https://arxiv.org/abs/2609.21749
- 代码:https://github.com/ruisun7/GraphSkillEvo
🎯 问题动机:技能优化卡在"一坨文本"上
先把背景捋清楚。所谓 Agent 技能(skill),其实就是一段给模型看的程序性指导:做这类任务时,第一步干嘛、第二步干嘛、有哪些坑别踩。Claude Skills、各种 skill library 都是这个路子。技能写得好,Agent 表现立竿见影;但手写技能费时费力,于是最近冒出一批自动优化技能的工作——SkillOpt、EvoSkill、Trace2Skill、SkillX 等等。
这些方法的通病在哪?拿 SkillOpt 来说,它的循环是这样的:把当前技能喂给 Agent 跑一遍训练集,收集执行轨迹,让另一个 LLM 分析失败原因、生成补丁,打到技能文本上,然后在验证集上验收,好就保留、不好就丢弃。整个过程,技能就是一份无结构的 Markdown 文档。
这带来两个实打实的麻烦:
执行端。优化几轮之后,技能文档越来越像一份超长的检查清单——几十条 bullet point 堆在一起。模型执行到某一步时,得自己从这一大坨里捞出"现在该遵守哪几条"。大模型勉强能扛,小模型(论文里用 GPT-5.4-nano)直接掉队。
优化端。同一个工作流程,用自然语言可以有一万种写法。优化器在这个空间里搜索,大量算力花在"换个说法但语义没变"的无效探索上。搜索空间又大又虚。
说实话,这两个问题我在实践里都踩过。你给 Agent 的 system prompt 越长,它越不听话——这个几乎是经验定律了。
🧠 核心思路:技能不是文章,是流程图
作者的直觉很朴素:技能说到底就是一步步的操作指引,而人类表达"一步步操作"最自然的形式不是散文,是流程图。既然如此,干嘛不把技能直接表示成图?

图1:上半部分是 SkillOpt 式的单技能迭代——初始技能在训练集上执行,LLM 反思生成补丁,验证集验收,如此往复,技能始终是一坨无结构文本;下半部分是 GraphSkillEvo——技能被组织成"全局指导 + 节点图",一个种群并行进化,变异和交叉算子共同作用。图中 SpreadsheetBench 分数 50.11 vs 60.71 的对比很直白。
一个图结构技能 \(s = \langle h_s, g_s \rangle\) 由三部分组成:
- 全局指导 \(h_s\):任务描述、通用原则,比如"同一个动作不要连续重复超过两次""只能从可选动作列表里选"——这些不隶属于任何具体步骤的共享约束。
- 节点集 \(V_s\):每个节点是一个可复用的执行步骤,自带该步骤的操作指引、规则和约束。比如"探索物体"节点会写明"系统地检查表面和容器,先打开关着的容器再下结论说目标不存在"。
- 边集 \(E_s\):通过若干条工作流(workflow)隐式定义。每条工作流有一个适用条件(Use When)和一条节点序列。比如"Pick & Place"工作流:解析目标 → 探索物体 → 拿取物体 → 找目标容器 → 放置 → 验证完成。不同工作流可以共享节点,但走不同的路。
这个表示的好处,论文总结了三点,我觉得都说在点上:
- 低冗余:多条工作流共用的指引只在一个节点里写一次,不用在文档各处复读。
- 执行路径显式:模型每一步只看当前节点的内容,不用在超长文档里大海捞针。
- 搜索空间结构化:优化器直接在"步骤和依赖关系"上操作,而不是在海量文本变体里打转。
打个比方(这篇我只打算用这一个比喻):无结构技能像把一本菜谱的所有注意事项抄在一张纸上;图结构技能像把菜谱拆成工序卡片,再钉上一张工序流程图。厨师干活的时候,看当前那张卡片就够了。
🏗️ GraphSkillEvo:在图上做进化
有了图表示,优化方法也要跟着换。GraphSkillEvo 用的是经典的种群进化框架,而不是 SkillOpt 那种单点爬山。
整个流程四步走:
Step 0:初始化种群。\(N=4\) 个技能个体,除了一个初始技能,其余由 LLM 根据任务上下文生成,刻意要求多样性。每个个体在完整验证集上打分,作为适应度。
Step 1:训练集执行。每一代从训练集采 15 个实例,种群中每个技能都跑一遍,收集执行轨迹。每个技能最多保留 5 条失败轨迹,作为反思素材。
Step 2:生成新个体。每代生成 \(N\) 个新技能,关键是四个进化算子,轮转调度选择:

图2:四个算子的分工。左下:图结构变异——拿着失败轨迹去改节点和边(精修节点指引、增删节点、调整工作流),保留全局指导;右下:全局指导变异——只改全局指导,图不动;左上:图结构交叉——把两个亲本的节点和边重组(蓝色和橙色的子图拼在一起),保留一方的全局指导;右上:全局指导交叉——只交换全局指导。这个"结构/全局"两两正交的拆分挺干净。
亲本选择用 rank-based:排名 \(r\) 的技能被选中的概率正比于 \(1/(r+N)\),给排名靠后的个体也留了活路,避免种群过早被一两个尖子垄断。
Step 3:种群选择。新个体在完整验证集上打分,然后在新旧 \(2N\) 个技能里选适应度最高的 \(N\) 个进入下一代。标准的精英保留策略。
跑 \(T=5\) 代后,返回适应度最高的技能。
注意一个细节:变异算子吃失败轨迹(轨迹驱动的反思),交叉算子不吃轨迹(纯组件重组)。这个分工是合理的——变异负责"就地修 bug",交叉负责"把两条探索路径上的好东西拼起来"。消融实验也印证了这一点,下面细说。
📊 实验:数据说话
实验配置:5 个基准——SearchQA(事实问答)、SpreadsheetBench(表格操作)、DocVQA(文档视觉问答)、LiveMath(数学多选推理)、ALFWorld(具身交互);两个模型——GPT-5.4 和 GPT-5.4-nano;两种执行方式——无 harness(技能直接塞进模型指令)和 Codex harness(技能放进工作区,Codex 读技能后解题)。所有结果都是三次独立优化跑的平均。
主结果
| 设置 | 方法 | SearchQA | Spreadsheet | DocVQA | LiveMath | ALFWorld | 平均 |
|---|---|---|---|---|---|---|---|
| GPT-5.4 无 harness | No Skill | 77.50 | 39.16 | 79.05 | 33.60 | 73.13 | 60.49 |
| Human skill | 77.71 | 37.85 | 84.04 | 31.72 | 81.84 | 62.63 | |
| LLM skill | 78.19 | 35.59 | 88.23 | 35.21 | 75.86 | 62.62 | |
| SkillOpt | 82.21 | 64.87 | 89.30 | 47.58 | 86.56 | 74.10 | |
| GraphSkillEvo | 83.80 | 69.40 | 90.37 | 48.65 | 87.06 | 75.86 | |
| GPT-5.4-nano 无 harness | No Skill | 58.12 | 35.12 | 36.72 | 23.93 | 41.29 | 39.04 |
| SkillOpt | 69.52 | 50.11 | 77.80 | 29.56 | 57.46 | 56.89 | |
| GraphSkillEvo | 72.93 | 60.71 | 80.92 | 28.76 | 61.19 | 60.90 | |
| GPT-5.4 Codex harness | No Skill | 79.42 | 56.07 | 82.35 | 54.03 | - | 67.97 |
| SkillOpt | 83.02 | 77.14 | 87.43 | 60.21 | - | 76.95 | |
| GraphSkillEvo | 83.26 | 79.28 | 89.30 | 61.29 | - | 78.28 |
几个值得琢磨的点:
小模型收益最大。nano 上比 SkillOpt 高 4.01 个点,GPT-5.4 上只有 1.76 个点。这符合论文的叙事:小模型更扛不住超长无结构指令,图结构的收益更明显。我的第一反应是这个发现对实际部署挺有价值——你恰恰是在便宜的小模型上才最需要技能辅助。
流程型任务涨得最猛。nano 上 SpreadsheetBench 比 SkillOpt 高 10.60 个点,ALFWorld 高 3.73 个点。这两个都是需要一步步按流程操作的任务,workflow 显式化的红利直接兑现。反过来 LiveMath 是唯一一个输给 SkillOpt 的(28.76 vs 29.56,差 0.80 个点)——数学选择题不太吃流程这一套,更像纯推理。这个结果我反而觉得增加了论文的可信度,如果五个基准全赢我才要怀疑。
14 个模型-harness-基准组合里赢了 13 个,相对无技能基线,平均提升 15.37%(GPT-5.4 无 harness)、21.86%(nano)、10.31%(Codex harness)。
还有个有点尴尬的细节:GPT-5.4 Codex 设置下,Human skill 和 LLM skill 的平均分(67.23、67.21)居然比 No Skill(67.97)还低。论文没展开解释,我的猜测是 Codex 本身已经有很强的流程自主性,塞一份平庸的技能反而是干扰。这也侧面说明技能质量比"有没有技能"重要得多。
优化曲线与 token 开销
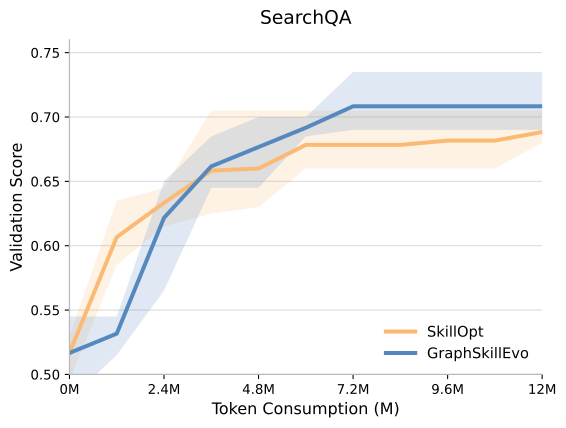
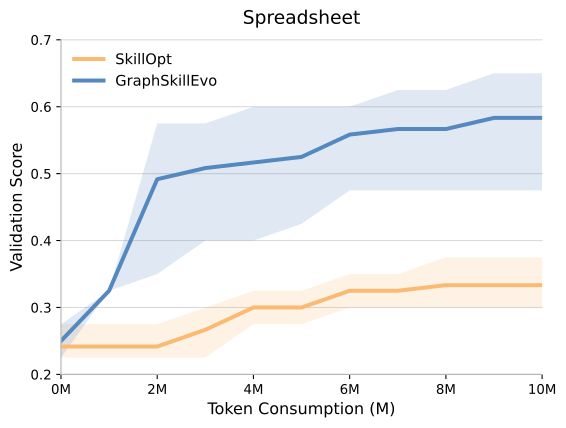
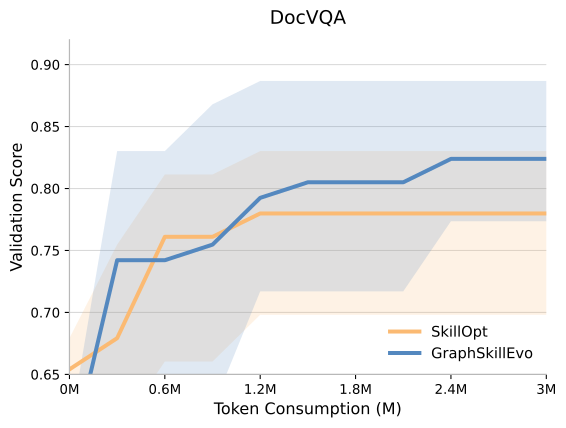
图3:GPT-5.4-nano 无 harness 设置下,验证集分数随优化 token 消耗的变化(三次实验平均,阴影是波动范围)。以 SearchQA 为例,SkillOpt(橙色)起步快但早早收敛到 0.68 左右;GraphSkillEvo(蓝色)前期慢热,后期持续爬升到 0.71 以上。
曲线揭示了一个有趣的现象:SkillOpt 是"早熟型"——前期涨得快,但很快撞上天花板。这正是单点爬山的典型行为。GraphSkillEvo 靠种群多样性持续供能,收敛慢一些,但终点更高。
更实在的是 token 账:总优化开销,GPT-5.4 下 SkillOpt 花 81.08M token,GraphSkillEvo 只花 61.94M;nano 下 103.54M vs 75.94M。性能更高的同时省了约四分之一的开销。等等,这有点反直觉吧?种群方法不是应该更贵吗?细看表格就明白了:SkillOpt 在 SearchQA 上烧了 38-45M token,因为它迭代轮数多、每次都要在完整轨迹上反思;而 GraphSkillEvo 每代只采 15 个训练实例 + 最多 5 条失败轨迹做反思,采样预算卡得很死。说白了,哦不,坦率地讲——这是精打细算的工程预算控制,不是什么免费的午餐。
消融:三个组件各有分工
消融实验都在 GPT-5.4-nano 上跑,三次平均:
| 变体 | SearchQA | Spreadsheet | DocVQA | 平均 |
|---|---|---|---|---|
| GraphSkillEvo 完整版 | 72.93 | 60.71 | 80.92 | 71.52 |
| 去掉图结构(进化无结构技能) | 68.83 | 50.59 | 72.81 | 64.08(降 7.44) |
| 去掉变异 | 57.19 | 35.11 | 71.20 | 54.50(降 17.02) |
| 去掉交叉 | 71.80 | 53.56 | 74.41 | 66.59(降 4.93) |
这组数字信息量很大:
- 去掉图结构,平均分掉 7.44。注意这个变体仍然保留了种群进化框架——说明光有进化搜索不行,搜索空间本身的结构才是根基。
- 去掉变异,直接崩到 54.50,比所有 baseline 都惨。没有轨迹驱动的反思,纯靠交叉重组初始种群的组件,等于完全放弃了从执行反馈中学习。变异是这套系统的信息入口。
- 去掉交叉(相当于四条并行的 SkillOpt 式自改进轨迹),掉 4.93 个点。这个数恰好量化了"跨候选重组"的价值——单独自反思能走到的位置,和允许交换组件能走到的位置,差距就在这里。
另外作者还做了一个"纯执行端"的对照(Table 3):把 GraphSkillEvo 优化好的图技能拆掉 workflow 组织、只保留全局指导和节点内容,五个基准一致掉分(SearchQA 降 4.52、Spreadsheet 降 2.50、DocVQA 降 4.19、LiveMath 降 1.35、ALFWorld 降 0.75)。这排除了"只是内容写得好"的解释——显式的执行路径本身就在帮模型干活。
跨模型迁移:小模型磨刀,大模型用
最后一个实验挺讨巧:用 nano 优化技能,部署到 GPT-5.4 上。结果 SpreadsheetBench 上迁移过来的 GraphSkillEvo 技能拿了 71.78,比直接在 GPT-5.4 上优化的 69.40 还高,更是甩开迁移的 SkillOpt 技能(53.21)一大截。
这个结果我得说有点意外。直觉上,针对弱模型优化的技能搬到强模型上应该损失才对——SpreadsheetBench 上不降反升,可能的解释是:nano 上优化出来的技能被迫把流程写得更显式、更细致,这种"被迫的清晰"对大模型同样是红利。当然也不排除三次平均内的波动。不管怎样,"便宜模型优化、贵模型部署"这条路线如果能站住,成本账会非常好看。
🤔 我的判断:亮点与保留意见
亮点:
一,图表示解决的是真问题。Agent 技能越来越长、越来越冗余是这半年 skill 方向工作普遍暴露的毛病,"节点复用 + 显式 workflow"是个干净利落的回应。
二,消融做得诚实。图结构、变异、交叉三个组件各自的贡献拆得清清楚楚,去掉变异直接崩盘的数字尤其有说服力——说明这套系统不是靠单一 trick 撑起来的。
三,效率叙事站得住。性能更高、token 更省,两条曲线和一张开销表互相印证。
保留意见:
首先,"图结构技能"这个 idea 本身并不算首创。同期已经有一串工作在做类似的事——SkillDAG(带类型的技能图)、HiSkill(层次化技能图)、Graph-of-skills(依赖感知的技能检索)、GRASP(图结构技能组合)。这篇论文的真正增量是把图表示和种群进化优化绑在一起,并给出了系统的实证。论文在附录里讨论了这些相关工作,但正文贡献声明里没太提,读的时候心里有数就好。
其次,规模太小。种群 \(N=4\)、只跑 \(T=5\) 代——这在进化计算里算"迷你局"。作者显然是受 LLM 调用成本所迫,但也留下了一个悬而未决的问题:如果预算放开,种群 16、跑 20 代,曲线还能继续爬吗?还是会更快撞墙?这个 scaling 行为对判断方法天花板很关键。
再者,图的构建和演化完全由 LLM 驱动,没有形式化的正确性约束。交叉算子拼出来的图,节点引用是否完整、workflow 是否会死循环,全靠 LLM 自觉。论文没报告非法图的比例,我赌这块在复杂任务上会成为隐患。
最后,Codex harness 下 Human/LLM skill 跑不过 No Skill 这个异常现象没有解释,让我对 harness 设置的细节有点不放心。
💡 收尾:谁该读这篇
如果你在做 Agent 技能库、prompt 自动优化、或者 LLM-as-optimizer 这类方向,这篇值得细读——它给出的最大启发不是某个具体算子,而是一个视角:优化对象的表示形式,往往比优化算法本身更决定上限。把无结构文本换成图,搜索空间性质就变了,后面的一切都顺了。
至于"进化算法 + LLM"这条线,从 EvoPrompt 到 FunSearch 再到今天这篇,套路越来越成熟:LLM 负责语义层面的变异与重组,进化框架负责维持多样性和选择压力。GraphSkillEvo 是这个套路在技能优化上的一次扎实落地——不是终点,但路标清晰。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我