一个反直觉的实验:给 Agent 团队配个能打回重做的 Manager,报告反而写得更差
你有没有过这种经历:团队里来了个主管,啥也不生产,就负责审你的稿子、批注两句「这里再改改」,然后你改到第三版,发现稿子比第一版还平庸——话越来越圆滑,观点越来越模糊,唯一增长的是字数里的废话。
莱顿大学的这篇论文(arXiv:2609.14767)把这个职场体验搬进了 LLM 多智能体系统里做了一次对照实验。结果相当扎心:让 Manager 拥有「打回重做」的权力后,团队产出的报告在实用性上掉了 0.42 个标准差(\(d=0.42, p=0.009\)),写作清晰度掉了 0.34 个标准差(\(d=0.34, p=0.030\)),同时 token 消耗多了 51.5 个点。监督层纯属花钱买罪受。
核心摘要:多智能体框架(MetaGPT、AutoGen 那一系)的默认编排方式都是层级式的——Manager 审查 worker 产出,不满意就打回。这篇论文做了一件之前没人做干净的事:固定五个 Agent 的角色、提示词、工具、模型、数据,只动一条链路——Manager 能不能拒绝产出并强制返工。43 对产品、86 次运行的配对实验显示,扁平组织在 Utility 和 Writing Clarity 两个维度上都赢了,而且伤害精准地发生在返工循环内部:层级版 Writer 的第一稿和扁平版产出统计上没差别,是 Manager 的返工指令让 Writer 开始疯狂打太极——对冲措辞多了 53%。这不是底层架构之争,是一次设计非常干净的因果实验,做 Agent 编排的人都该看看。
📖 论文信息
- 标题:Loop-Back Authority in LLM Agent Teams: A Paired Experiment on Flat and Hierarchical Coordination
- 作者:Burak Agachan, Max van Duijn, Amirhossein Zohrehvand
- 机构:Leiden Institute of Advanced Computer Science (LIACS), Leiden University
- 链接:https://arxiv.org/abs/2609.14767 (2026 年 9 月 13 日,cs.MA)
🎯 为什么这个问题值得专门做一次实验
说实话,「层级好还是扁平好」在多智能体圈子里已经吵了一阵子了,但证据一直是糊的。
一边,Muralidharan 等人 2025 年的工作发现扁平团队在常识和社会推理任务上胜过层级团队;另一边,OrgAgent 把系统分成治理、执行、合规三层,在阅读理解和多跳问答上报告了相反的结论。你说信谁?
问题在于,这些比较动的是整个框架。提示词不同、角色划分不同、工具链不同,跑出来的差异你根本不知道功劳(或锅)该算在结构头上,还是算在某个 prompt 工程技巧头上。而且它们测的都是有标准答案的基准——那种任务上,一个监督者花很小的成本就能核对候选答案,层级当然占便宜。
可生产环境里 Manager Agent 真正被部署的场景是什么?是开放式知识综合:写分析报告、做调研综述、整合用户反馈。质量是多维的,没有答案键。这个场景恰恰是结构之争最没被干净测过的地方。
理论层面也正好打了个架。经典组织理论(Kocak、Levinthal、Puranam 2022 年发在 Organization Science 上的那套「搜索与协调双重挑战」框架)预测:层级影响结构能让团队更快收敛到果断、高分辨率的产出。而 LLM 圈自己的证据指向反方向——RLHF 训出来的模型面对权威指令会谄媚式顺从(sycophancy),在迭代批评下会丧失发散思维,也就是 Degeneration-of-Thought。两边对同一个操作给出相反的预测,这时候最需要的就是一个干净的实验。
这篇论文的切口很漂亮:别的什么都不动,只动那一条权威链路。
🏗️ 实验设计:五个 Agent,两种组织形式,只差一条边
系统用 LangGraph 实现,所有 Agent 围绕一块共享黑板(blackboard)协作——这是 MAS 里的经典协调构件,每个 Agent 读取累积状态、追加自己的产出。
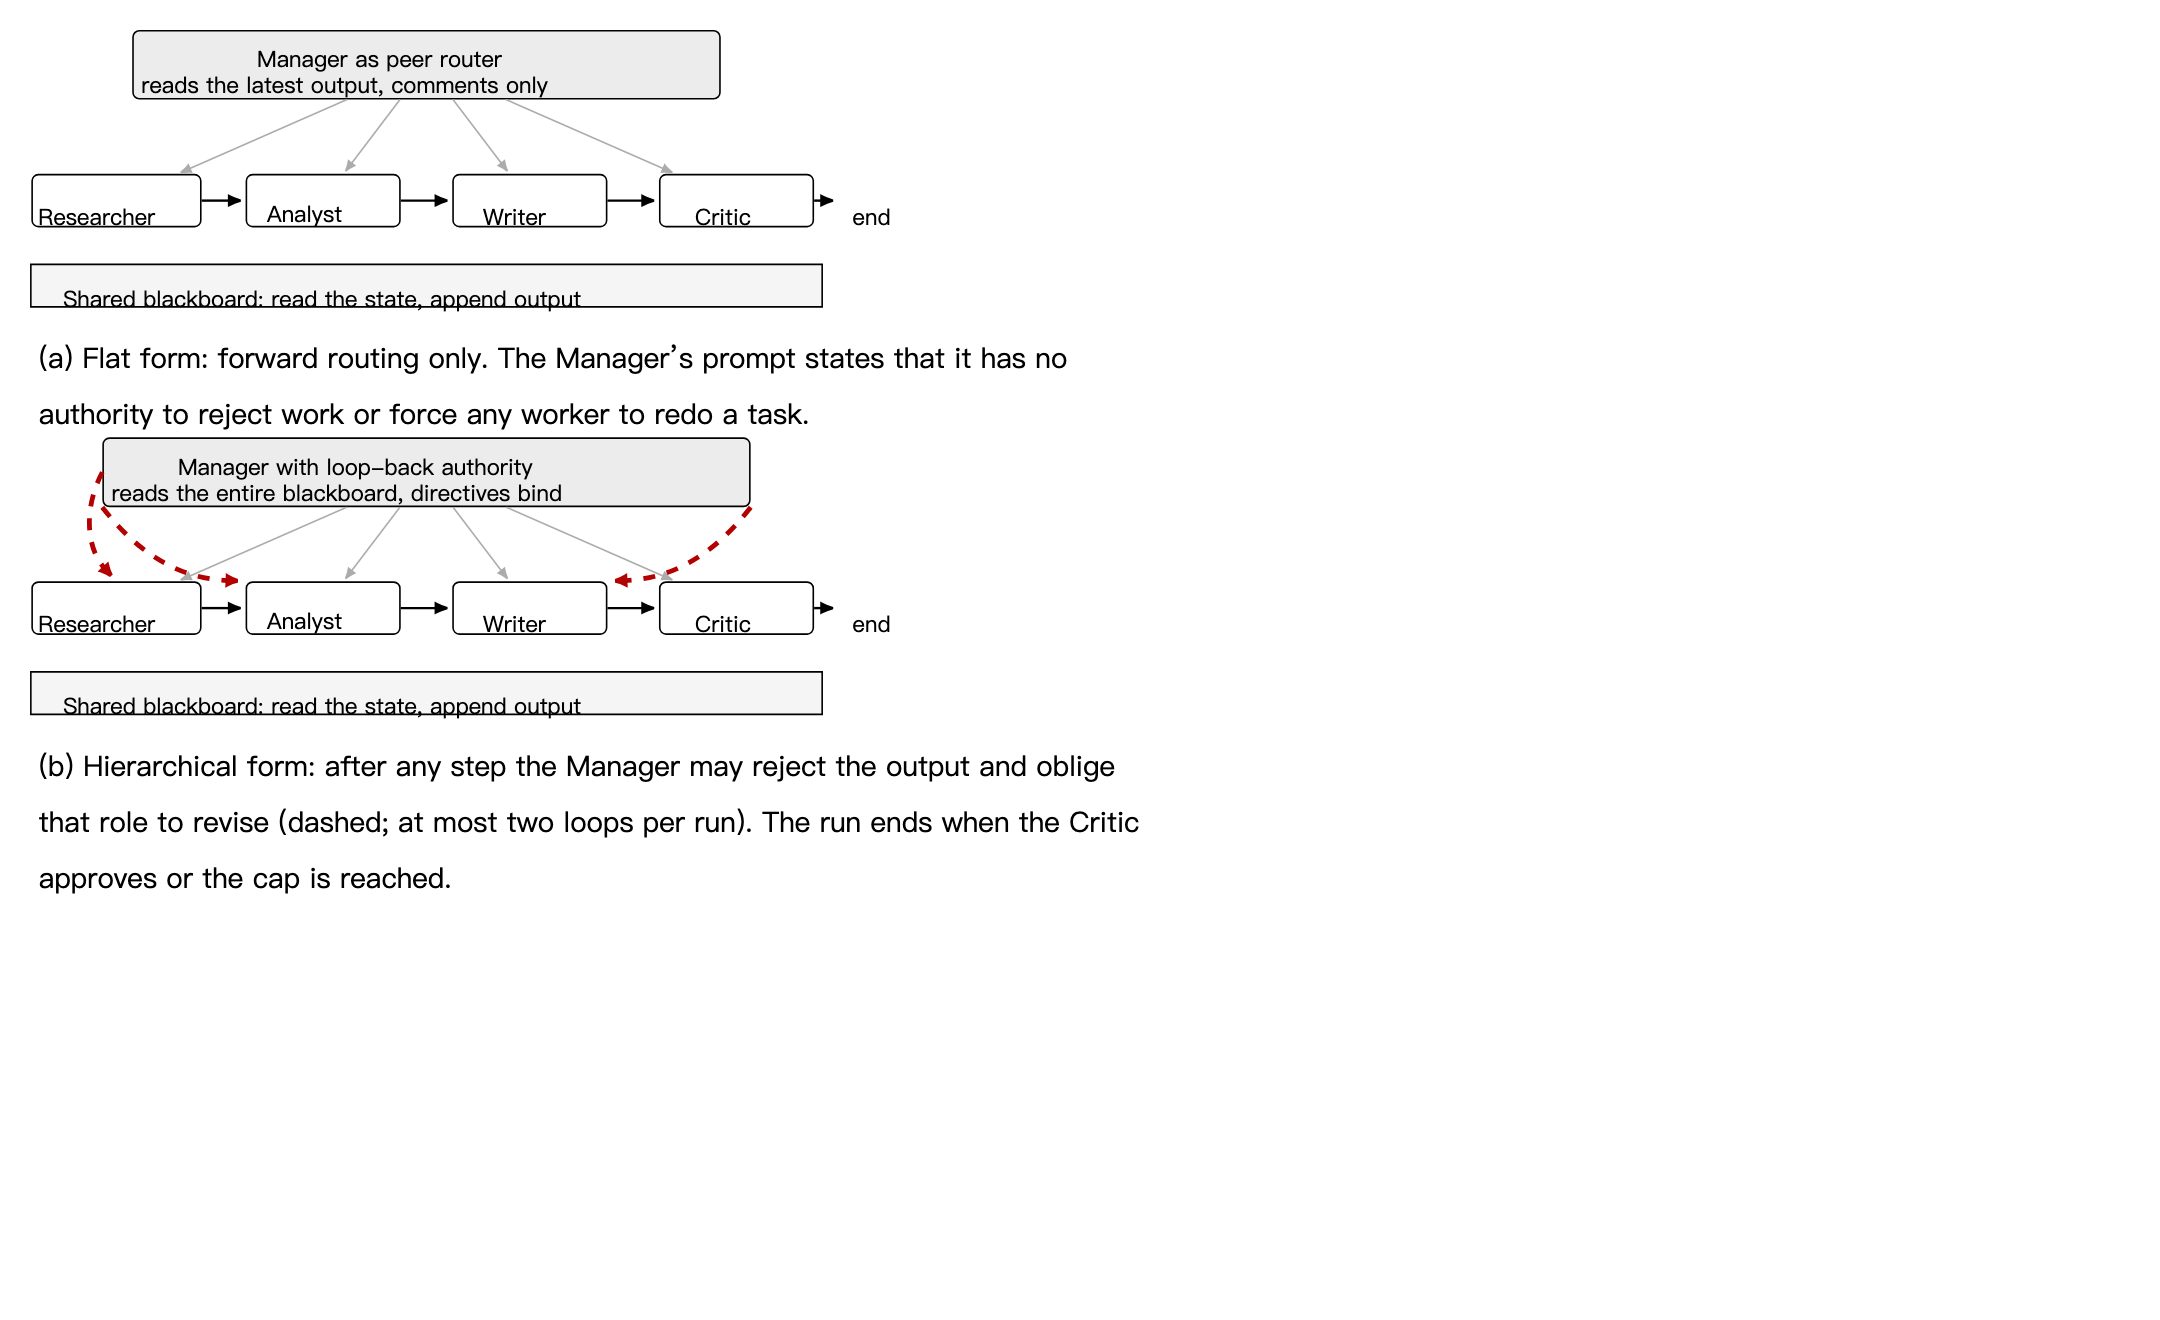
图 1:两种组织形式。角色、prompt、工具、模型、数据、黑板完全一致,唯一区别是 Manager 与 worker 之间的那条权威链路(红色虚线)。
五个角色是 Researcher、Analyst、Writer、Critic、Manager。Researcher 带两个工具(get_product_specs 拉商品元数据、search_reviews 在 ChromaDB 向量库里做带情感过滤的语义检索);Analyst 做模式和根因分析;Writer 写报告;Critic 审稿子并调用 verify_claim,用 embedding 相似度给报告里的断言打 VERIFIED / PARTIAL / UNVERIFIED 标签(阈值 0.7 和 0.5)。Critic 在两种形式里都存在——这个细节很关键,这说明实验操控的不是「有没有批评」,而是「批评绑不绑定强制力」。
两种形式的全部差异,一张表就能讲完:
| 维度 | 扁平(Flat) | 层级(Hierarchical) |
|---|---|---|
| Manager 审查范围 | 只看最新一步的 worker 产出 | 每步之后审查整个黑板 |
| Manager 输出 | 无约束力的评论(一种许可) | 指明要改什么的指令,注入 worker 上下文(一种义务) |
| Prompt 条款 | 「你没有权力拒绝工作或强制 worker 重做」 | 「当当前产出有问题时,你有绝对权力强制 Loop-Back」 |
| 返工循环 | 无(计数器固定为 0) | Manager 自行决定,每次运行最多 2 圈 |
| 运行结束条件 | Critic 审完即结束 | Critic 批准或达到循环上限 |
| 最大步数 | 9 | 15 |
| Worker 角色/prompt/工具/模型/数据 | 完全一致 | 完全一致 |
有个设计细节我很喜欢:这条权威链路不附带任何惩罚。worker 就算无视返工指令也不会有任何损失。所以观察到的任何顺从行为,都是模型对权威语气本身的反应,而不是被激励机制逼出来的。作者这一手把「社会性顺从」这个变量单独暴露了出来。
为避免结果绑死在单一模型家族上,五个角色从五个前沿模型的池子里随机分配:GPT-5.4、Gemini-3.1-Pro、Qwen-3.5-122B、GLM-5、Mistral-Large-3(Manager 池子里去掉了 Qwen,因为它的 thinking 模式输出流和路由用的结构化输出 schema 不兼容)。温度固定为 0,同一产品下两种形式用完全相同的角色-模型分配——模型身份是配对内的常量。
任务是从商品规格和用户评论生成商业情报报告。选了亚马逊美国站上搭载 RTX 4060 的游戏本(单一 GPU 型号控制硬件异质性),去重清洗后 52 个产品、540 条评论,其中评论数不少于 5 条的 43 个产品进入配对分析。每个产品跑两次(两种形式各一次),共 86 次运行。
评分是双轨的:五个模型组成评委团(每篇报告五个模型都评),先写定性分析再打 1-5 分;另外用一个确定性脚本抽取报告中断言的规格(GPU、RAM、CPU、存储)并和商品 listing 元数据核对。Writing Clarity 是 Structure、Coherence、Conciseness 三个维度的均值,Utility 是 Actionability、Root Cause Analysis、Strategic Depth 的均值。
📊 结果:经典预测翻车,而且翻车的方式很具体
86 次运行全部完成,整个实验花了 47.71 美元 API 费、约 5.9 小时。配对比较的主表长这样:
| 指标 | 扁平 M (SD) | 层级 M (SD) | \(d\) | \(p\) |
|---|---|---|---|---|
| Final Score | 4.563 (0.233) | 4.508 (0.217) | 0.262 | 0.097 |
| Writing Clarity | 4.454 (0.137) | 4.360 (0.238) | 0.342 | 0.030 |
| Utility | 4.715 (0.148) | 4.621 (0.208) | 0.417 | 0.009 |
| 规格准确率 | 4.520 (0.615) | 4.543 (0.626) | -0.046 | 0.764 |
扁平版在 43 个产品里赢了 28 个(层级赢 14,平 1)。控制了 writer 模型、评论数、平均评分之后,混合效应模型给出层级形式在 Writing Clarity 和 Utility 上各 降 0.094 分 的估计(\(\beta=-0.094\),\(p\) 分别为 0.025 和 0.006)。
效应量不算惊天动地,但 \(d=0.42\) 在行为科学实验里已经算中等偏上了。更有意思的是差异的构成。
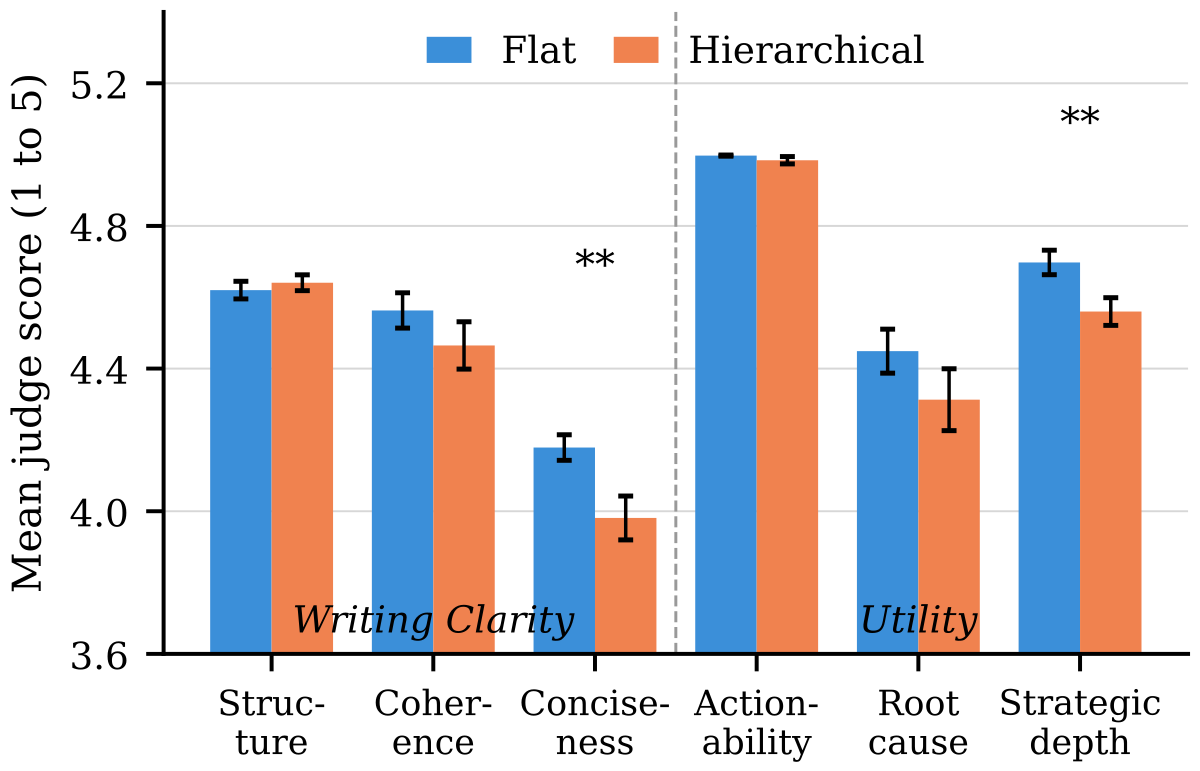
图 2:分维度均分(N=43 对,误差棒为标准误,两颗星表示配对检验 \(p<0.01\))。
Writing Clarity 的差距全部来自 Conciseness(简洁性):扁平 4.18 对层级 3.98,\(d=0.44, p=0.007\)。Structure 和 Coherence 两个维度没差别。报告长度其实一样——层级版没有写更长,只是对冲措辞(possible、may、suggests、could 这类词)密度高了 53%,词汇多样性两边相同(MTLD 186 对 189)。
Utility 这边,扛差距的是 Strategic Depth(战略深度):4.70 对 4.56,\(d=0.48, p=0.003\),而且是六个维度追踪检验里唯一活过 Holm 校正的(Holm \(p=0.021\))。Actionability 两边都顶在天花板上(98% 的分数在 4.9 以上)。
用理论框架读,这正是「探索侧预测」预期的模式:没有强制收敛压力的组织保住了战略深度,有压力的组织收敛到了更浅的内容上——Kocak 他们说的「困在非峰值上」(entrapment on a non-peak)。
而规格准确率呢?两边都在天花板。作者把指标重做了一版更严格的(对每件商品 5-7 项规格做精确变体匹配、同时算 precision 和 recall),结果扁平版 recall 和 precision 都是 1.000,层级版 0.997,86 篇报告里 85 篇完全正确。唯一的错误是某篇层级报告写了一个 listing 里不存在的 CPU 型号。
这个「无差异」本身就是重要信息:在可验证的部分,根本没有东西留给监督者去修。文献里报告层级优势的工作,测的都是带可验证短答案的基准,监督层能便宜地核对答案;报告扁平优势的工作,测的都是开放式任务。这篇论文的结果正好落在那条分界线上——可验证部分结构无影响,开放式部分权威链路带来伤害。
🔬 机制解剖:伤害发生在返工循环内部
这是全文最值钱的部分。权威链路在每个层级运行里都「存在」,但 Manager 只在 43 次里的 32 次真的用了它:11 次零循环、12 次一圈、17 次两圈、3 次想发第三圈被上限挡住。作者用三个视角交叉定位伤害来源。
视角一:剂量反应。Writing Clarity 随循环数单调下降(Spearman \(\rho=-0.40, p=0.008\)),带控制变量的 OLS 估计每多一圈循环掉 0.142 分。
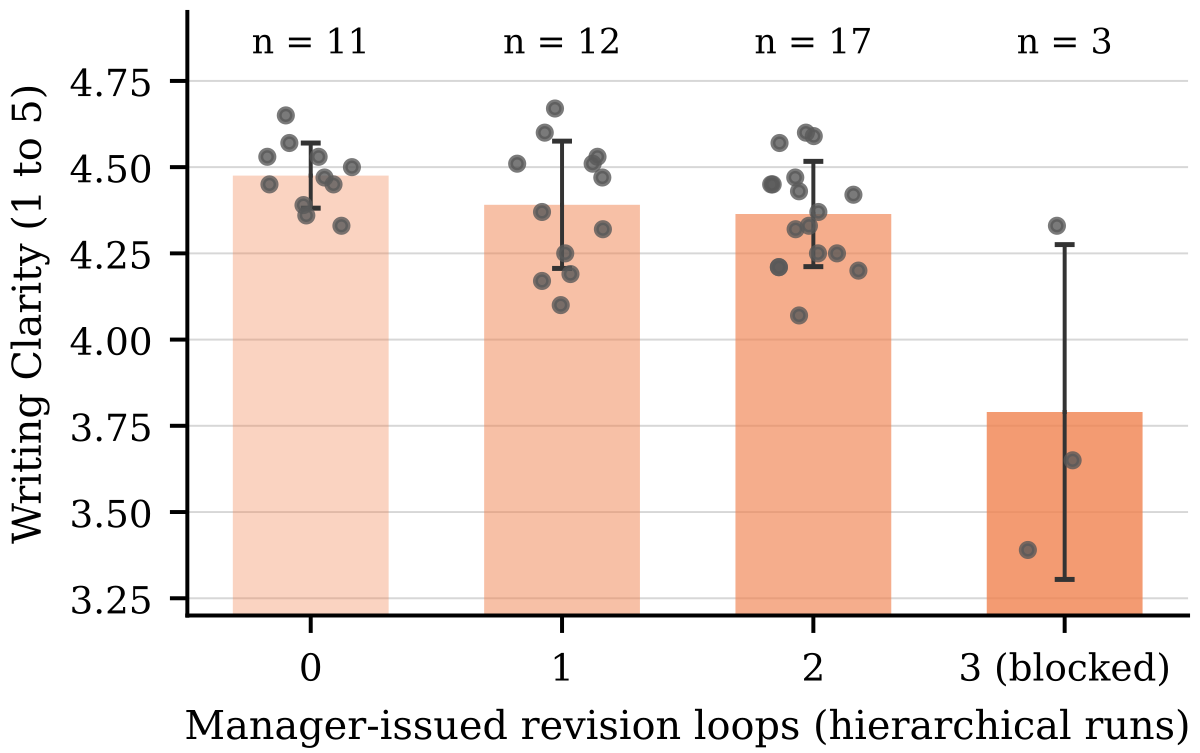
图 3:层级运行中 Writing Clarity 随 Manager 返工循环数的变化。单调下滑,三圈那组虽然只有 3 个样本,但掉到了 3.79。
视角二:零循环子集。在 Manager 全程没干预的 11 对产品里,层级版报告在三个指标上反而数值更高(不显著,n=11 太小)。也就是说,一条从没被行使的权威链路没有造成可测量的伤害。当然,这 11 个产品是 Manager 自己判断「不需要管」的,存在自选择,所以作者说这个视角是三角验证而非检验——这种分寸感挺难得的。
视角三,也是最干净的证据:循环内部的逐稿对比。作者从层级运行日志里抽出了 Writer 的全部 77 份草稿。在 Manager 任何干预发生之前,层级版 Writer 的第一稿和同一产品的扁平版报告在每个文本指标上都统计不可分:对冲密度 \(d_z=0.11\)(\(p=0.46\))、词汇多样性 \(p=0.98\)、长度 \(p=0.20\)。整个差距是在第一稿之后裂开的。31 次发生了返工的运行里,第二稿比第一稿每千词多 1.95 个对冲词(\(d_z=0.83\))。
把三个视角拼起来,机制就很清楚了。Writer 收到返工指令后,并不是重新思考分析——它保留原稿,软化断言,追加限定性材料。评委把这种结果惩罚为「注水」。
这个模式和谄媚式顺从(sycophantic compliance)严丝合缝。但请注意,它和强版本的 Degeneration-of-Thought 其实不吻合——强版本预测内容会逐步漂移劣化,而这里没有漂移、没有词汇坍缩、没有重写。作者那句总结我觉得是全文最精炼的一句:
The loop does not make the agent think worse; it makes the agent commit less. (返工循环没有让智能体想得更差,只是让它更不敢下注。)
⚠️ 评委可靠性与作者的诚实度
用 LLM 评委团打分,绕不开可靠性质疑。五个评委的绝对一致性很低:Writing Clarity 的 Krippendorff's alpha 只有 0.08-0.17,Utility 0.22-0.30——主要被 GPT-5.4 的严厉拖累了(它均分 3.86,其他评委在 4.44-4.68 区间;剔掉它 alpha 升到 0.26 和 0.34)。
但配对设计需要的不是校准一致,而是方向一致。方向一致性是有的:每个评委在至少 68% 的产品对上和 panel 均值方向一致(Utility 上至少 77%)。
更关键的是 leave-one-judge-out 重估:
| 稳健性检查 | Writing Clarity | Utility |
|---|---|---|
| 配对 \(t\) 检验 \(p\)(Holm 校正) | 0.030 (0.030) | 0.009 (0.018) |
| Wilcoxon \(p\) | 0.051 | 0.009 |
| 混合效应 \(\beta\)(\(p\)) | -0.094 (0.025) | -0.094 (0.006) |
| 单独支持扁平的评委数 | 5 个里 4 个 | 5 个全支持 |
| LOJO \(d\) 范围 | 0.27 - 0.40 | 0.38 - 0.43 |
| LOJO \(p\) 范围 | 0.012 - 0.083 | 0.007 - 0.016 |
Utility 的结果非常扎实:五个评委每一个单独看都偏向扁平(\(d\) 从 0.25 到 0.32),随便去掉哪个评委,四人 panel 的 \(d\) 都在 0.38-0.43 之间、\(p \leq 0.016\)。
Writing Clarity 就脆一些:它主要靠 Qwen、GLM、Gemini 三个评委扛,GPT-5.4 单独看反而偏向另一边(\(d=-0.14, p=0.38\));去掉任何一个扛大梁的评委,composite 的 \(p\) 就滑到 0.055-0.083。Wilcoxon 检验下也是 \(p=0.051\) 的擦边球。
作者的处置方式值得点赞:直接把 Utility 和 Strategic Depth 作为主打结果,Writing Clarity 明确标注为「方向真实、显著性脆弱」,而且机制证据(对冲密度、逐稿对比)全部基于确定性文本测量,完全不依赖评委。这种把自家结果的软肋摊开在桌面上的写法,比那些藏局限性的论文可信度高多了。
💰 成本账:51.5% 的纯浪费
层级形式每篇报告消耗 74,781 个 token,扁平版 49,370——多了 51.5 个点。生成成本多 40.5%,含评估的总成本多 20.2%(0.606 美元对 0.504 美元),耗时多 34.3%(282 秒对 210 秒)。而且这些数字方差很大,因为循环次数是 Manager 自己决定的。
花了这一半的溢价,买到的是什么?三个质量指标上零增益。在这个设定下,监督层就是纯成本。
💡 我的判断
这篇论文的价值不在「层级 vs 扁平」的站队,而在它把结论收敛成了一条可执行的设计规则:
监督者能验证东西的时候,监督层才回本;只能发表意见的时候,监督层就是负债。
落到工程上就是三条:短上下文综合任务,扁平顺序流水线应该是默认选项;如果确实需要 Manager 做任务分解和路由,别给它打回重做的权力;返工应该由验证器信号触发(verify_claim 没过、缺了必要章节),而不是由管理者对「质量」的主观判断触发。
顺着这个思路想,其实很多生产框架里的 Supervisor 模式都中枪。LangGraph 官方教程里那个经典的 supervisor 架构、各种「Manager 审查 worker」的模板,默认装的恰恰就是这条论文证明有害的链路。当然,那些场景里很多是可验证任务(代码能跑测试、数学能验算),监督层照样回本——论文自己也承认这个边界,没有过度推广,43 对产品、单一任务域、一代模型,外推到长上下文生成、代码任务都需要重新验证。
我也有个没被完全说服的地方:评委团共享 RLHF 训出来的品味,它们会不会联合起来惩罚一种人类读者其实不反感的「谨慎文风」?对冲措辞多不一定等于坏——在真实的商业情报场景里,把「销量下滑」写成「数据显示可能存在销量压力」有时是专业的审慎而不是注水。作者承认 hedging 词典分不出「校准过的谨慎」和「逃避」,对「对冲即伤害」的解读是压在评委分数上的。这个软肋真实存在,好在 Utility/Strategic Depth 那个主结果不怎么依赖这个解读。
还有个耐人寻味的对照:作者团队之前的工作发现 AI 经理带人类团队时能让绩效翻倍多。同样是管理者角色,带人有用、带 LLM 有害——差别可能就在于,被批评的一方是会真正更新信念的人类,还是只会软化措辞的 RLHF 模型。人类写作者会针对评审者调整表达,语言模型的调整方式是把话说圆。这个不对称性,可能是「组织理论迁移到智能体系统」这件事里最值得继续挖的矿。
如果你正在搭多智能体系统,我的建议很直接:审计一下你的编排图,凡是「主管觉得不行就打回」的边,改成「验证器挂了才打回」。这一篇论文的实验设计本身也值得学——固定一切、只动一条边的配对实验,在 Agent 评估这个玄学遍地的领域里,是稀缺的方法论示范。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我