AutoTuring:把架构语义全部抹掉之后,AI 智能体还剩下多少"架构师"成分?
最近刷到越来越多"AI 设计芯片成功"的论文,我的第一反应不是兴奋,而是一个挺刺挠的问题:这些工作到底证明了什么?
一个智能体把加速器的某个指标调好了,这当然是个结果。但它是在推理这台机器的物理结构,还是只是在一堆它根本不理解语义的旋钮上做了一场合格的搜索?这两件事看起来一样,实则天差地别——只有前者能迁移到下一代架构上,后者换个问题就废了。而现有的评估方法根本分不开这两者,因为它们都是"固定问题的表述方式,换不同的智能体来跑"。语义一直摆在那儿,你永远不知道智能体用没用。
微软研究院这篇 AutoTuring(arXiv:2609.19387)干了一件我很喜欢的事:反过来了。同一个智能体,同一个 15 维加速器设计空间,跑两遍——一遍给它带名字的架构参数和模拟器计数器(SM 数量、缓存容量、MMA tile 尺寸),另一遍把同样的问题包装成 \([0,1]\) 上的匿名变量 \(x_0, \dots, x_{14}\),评估器、合法空间、可达最优解全部保持一致。唯一的变量是:这个问题对智能体来说还有没有意义。
两个条件之间的差值,就是"架构理解"这个东西的操作化测量。
核心摘要
在 9 个 FP16 GEMM 核的负载篮子下,语义是有价的:带架构语义的智能体最终设计比建模的 H200 快 5.4%,比盲搜版本平均好 12.3%,而且模拟器调用次数少了 70.1%。但语义不是唯一的路——给盲搜智能体加一个 Critic 评论循环,它能追回大部分差距;而给架构师加 Critic 却一无所获,两者最终落在彼此 0.8% 以内。换句话说,架构知识和结构化批判表现为替代品而非互补品。作者很坦诚地称之为初步结论:每个条件只有 5-6 次运行、单一建模加速器。说实话,我觉得这篇文章真正值钱的不是那个加速器,而是这个"对照实验的提法"本身——它给"AI 到底懂不懂架构"这个玄学问题一个可以测量的形状。
论文信息 - 标题:Do AI Agents Understand Computer Architecture? - 作者:Ambika Sharan(实习期间完成)、Grigory Chirkov、Soheil Abbasloo - 机构:Microsoft Research - 链接:https://arxiv.org/abs/2609.19387 (2026 年 9 月 16 日,cs.AI)
🎯 问题动机:为什么"跑分赢了"不等于"懂了"
这个领域最近的氛围是这样的:编译器工程、GPU 编程、操作系统、网络配置,到处都有 agentic 自动化的项目,芯片架构设计自然也没落下——LUMINA 用 LLM 生成架构知识做瓶颈分析,MicroEvo 把 LLM 采样和 MCTS 结合起来做微架构 DSE,gem5 Co-Pilot 把 LLM 接上模拟器反馈,ArchEval 干脆做了个 benchmark 衡量智能体当架构师的水平。
但仔细看这些工作的评估逻辑,都是两条路:要么把 AI 产出的架构和手写优化循环的结果比一比,要么观察给智能体更多工具和指导之后输出怎么变。两条路都有一个共同的盲区——没有把"通用搜索能力"和"架构领域知识"剥离开。一个智能体表现好,可能是因为它真的在推理缓存层次和带宽瓶颈,也可能只是因为它是个不错的自适应采样器。
说到这个,我之前看 ArchEval 的结果时就有这个疑问:它发现给智能体结构化的模拟器反馈之后性能大涨,但这个提升到底来自硬件推理还是来自"任何智能体拿到好的反馈信号都会变好"?当时没法回答。AutoTuring 这篇文章直接把这个问题做成了实验设计——这是我给它高评价的原因。
🏗️ 方法核心:同一台机器,两种"看见"方式
AutoTuring 本身是一个加速器设计空间探索(DSE)智能体:给定初始设计、硅片面积预算和目标负载,返回满足预算的最优配置。候选设计由一个内部 GPU 架构模拟器打分(LLMCompass 的深度魔改版)。
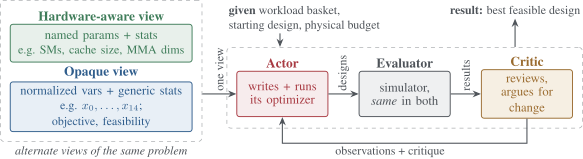
图1:AutoTuring 的整体结构。上方两个框是同一个问题的两种视图——hardware-aware 视图给带名字的参数和统计量(SM 数、缓存容量、MMA 维度),opaque 视图只给归一化变量 \(x_0,\dots,x_{14}\) 和泛化的统计量。两种视图共享同一个 Actor–Critic 循环和同一个评估器:Actor 编写并运行自己的优化器,Evaluator 做模拟,Critic 审查并提出修改意见,观察结果回流给 Actor。
关键的实验设计是个 2×2 矩阵:
| 维度 | 两个取值 |
|---|---|
| 问题表述 | hardware-aware(架构师)vs opaque(盲优化器) |
| 智能体结构 | 单智能体 vs Actor–Critic 双智能体 |
搜索空间是同一个 15 维 GPU 加速器空间:SM 数量(16-256)、tensor core 峰值吞吐(64-8192 MAC/cycle)、MMA tile 的 M/N/K 维度、L1/L2/L3 的容量和带宽、缓存层级数、L2 domain 数量等等。HBM 带宽固定在 4800 GB/s(按 4N 工艺从 A100 的 2048 GB/s 缩放),工艺节点也固定——搜索不能靠堆片外带宽买性能,这是个很重要的约束,不然实验就被带宽变量污染了。
评估目标是 GPU 时间加权的 regret:
其中 \(\ell_i(d)\) 是设计 \(d\) 在 kernel \(i\) 上的建模延迟,\(\ell_i^{\mathrm{ref}}\) 是冻结的参考延迟。越小越好。负载篮子是 9 个 FP16 GEMM 核,从 H200 上真实采集的 154 个 GEMM profile 里挑的,横跨带宽瓶颈(decode 风格的 GEMV、瘦投影)、中等强度和计算瓶颈三个 regime。
两个条件的信息量被严格对齐了——opaque 条件里智能体看到的是同样的逐负载模拟器计数器和约束值,只是全部剥掉领域语义(变成无信息的组件索引 \(c_0,\dots,c_8\))。所以这不是"信息量"的对比,是"意义"的对比。这个控制做得相当干净,我必须承认。
底层模型统一用 Anthropic 的 claude-opus-4.8,greedy decoding,12 轮搜索 horizon,每轮最多 300 次评估。所有条件同模型、同工具、同 prompt 版本(v1),排除了混淆变量。
📊 实验结果:一个故事,不是四个
主表(Table 1)是整篇论文的核心,直接贴:
| 方法 / 参照 | 运行数 | 最优 (\(\mu s\)) | 平均最优 (\(\mu s\)) | 评估次数/轮 | 相对 H200 |
|---|---|---|---|---|---|
| 架构师,单智能体 | 6 | 709.9 | 718.9 | 58 | 低 5.4% |
| 架构师,Actor–Critic | 6 | 713.8 | 744.2 | 128 | 低 4.8% |
| 盲盒,Actor–Critic | 6 | 719.3 | 781.0 | 151 | 低 4.1% |
| 盲盒,单智能体 | 5 | 750.1 | 819.9 | 194 | 打平 |
| H200 参照 | – | 750.1 | – | – | – |
| 建模 A100 基线 | – | 910.3 | – | – | 高 21.4% |
(原文有个挺可爱的脚注:750.1 出现两次不是笔误,两个量四舍五入后恰好一样。)
把这个表当 2×2 读,它讲的是一个故事而不是四个数字:
语义在裸搜时很值钱。架构师单智能体比盲盒单智能体平均最优延迟低 12.3%,评估次数少 70.1%——58 次对 194 次,这个效率差距是实打实的。
Critic 在语义被剥夺时很值钱。给盲盒加 Critic,平均最优改善 4.7%,评估次数降 22.2%。
但两者加在一起反而不值钱。两个带 Critic 的条件最终设计彼此只差 0.8%,而且 Critic 反而把架构师的平均最优拖差了 3.4%(718.9 → 744.2)。等等,Critic 让架构师变差了?这个细节挺耐人寻味的。
作者的解读是:架构知识和辩证式批判提供的是可互相替代的搜索结构——两者都在供给同一种稀缺商品:"下一步往哪儿搜"的假设。在近最优平台足够宽的问题上,一条路就够了。
说实话看到这里我有点警觉。这个"替代品"结论成立的前提是问题足够简单——简单到盲搜+Critic 就能摸到近最优区。作者自己也承认了,而且承认得很痛快,这点后面细说。
🔬 定性证据:转录文本里的"建筑师"和"记账员"
数字只能告诉你架构师搜得更好,转录文本才能告诉你它是不是真的在按架构师的方式搜。这是全文我最喜欢的部分。作者从 hardware-aware 运行的轨迹日志里摘了三段原话(逐字引用):
开局它先按瓶颈给负载篮子分区:"目标同时被带宽瓶颈尾部(gemv_decode)和计算瓶颈尾部(compute_square)卡住,所以面积要花在两头上。"——这是架构师的思维,先分解 workload 再分配预算。
最大的单次改进(0.464 → 0.410)来自读成本模型发现了一个免费旋钮:"所有 tile 形状下面积都平坦在 698.02,因为面积由 tc_macs_per_cycle 决定,而不是 M/N/K 几何。所以扩大 MMA tile 在面积上基本是免费的。"——它不是采样采出来的,是读了模拟器的成本结构推出来的。
更有信息量的是它猜错的假设。第 5 轮它判断缓存容量是富余的,把 L1/L2 砍到底去买 SM;第 6 轮开头就自我打脸:"cache 是承重的,不是富余(v5 假设被证伪)。把 L1/L2 砍到底让大块头变差了:gemv_decode 416 → 455。"另一个"大 L3 能把 HBM 重取变成命中"的假设,在 5 轮之后被它在控制变量的条件下重测,然后证伪——它还意识到自己第一次测试被混淆了。
它甚至会驳回 Critic,因为它读过评估器源码:"Critic 说提高 hbm_bw。hbm_bw 不是旋钮。space.apply_design 从固定常量设置 HBM 带宽,明确忽略任何传入值。"
对比之下,盲盒条件的转录是纯坐标空间记账:"第 11 轮复数收敛:最优均值配置是 \(x_{12}=0.25, x_6=0.108, x_{14}=0.5, x_{11}=0.10\)……我们在噪声平台上(\(\sigma \approx 0.0015\text{–}0.003\)),配置间差距在噪声以内。\(c_0/c_3\) 在多轮冻结轴扫描后确认不可约。"
同样的智能体,同样的问题,有没有语义,写出来的是两种完全不同的东西。这个对比是全文定性层面最硬的证据——语义不是被"展示"的,是被"使用"的。
🧭 为什么 Critic 帮不了架构师:地形太平了
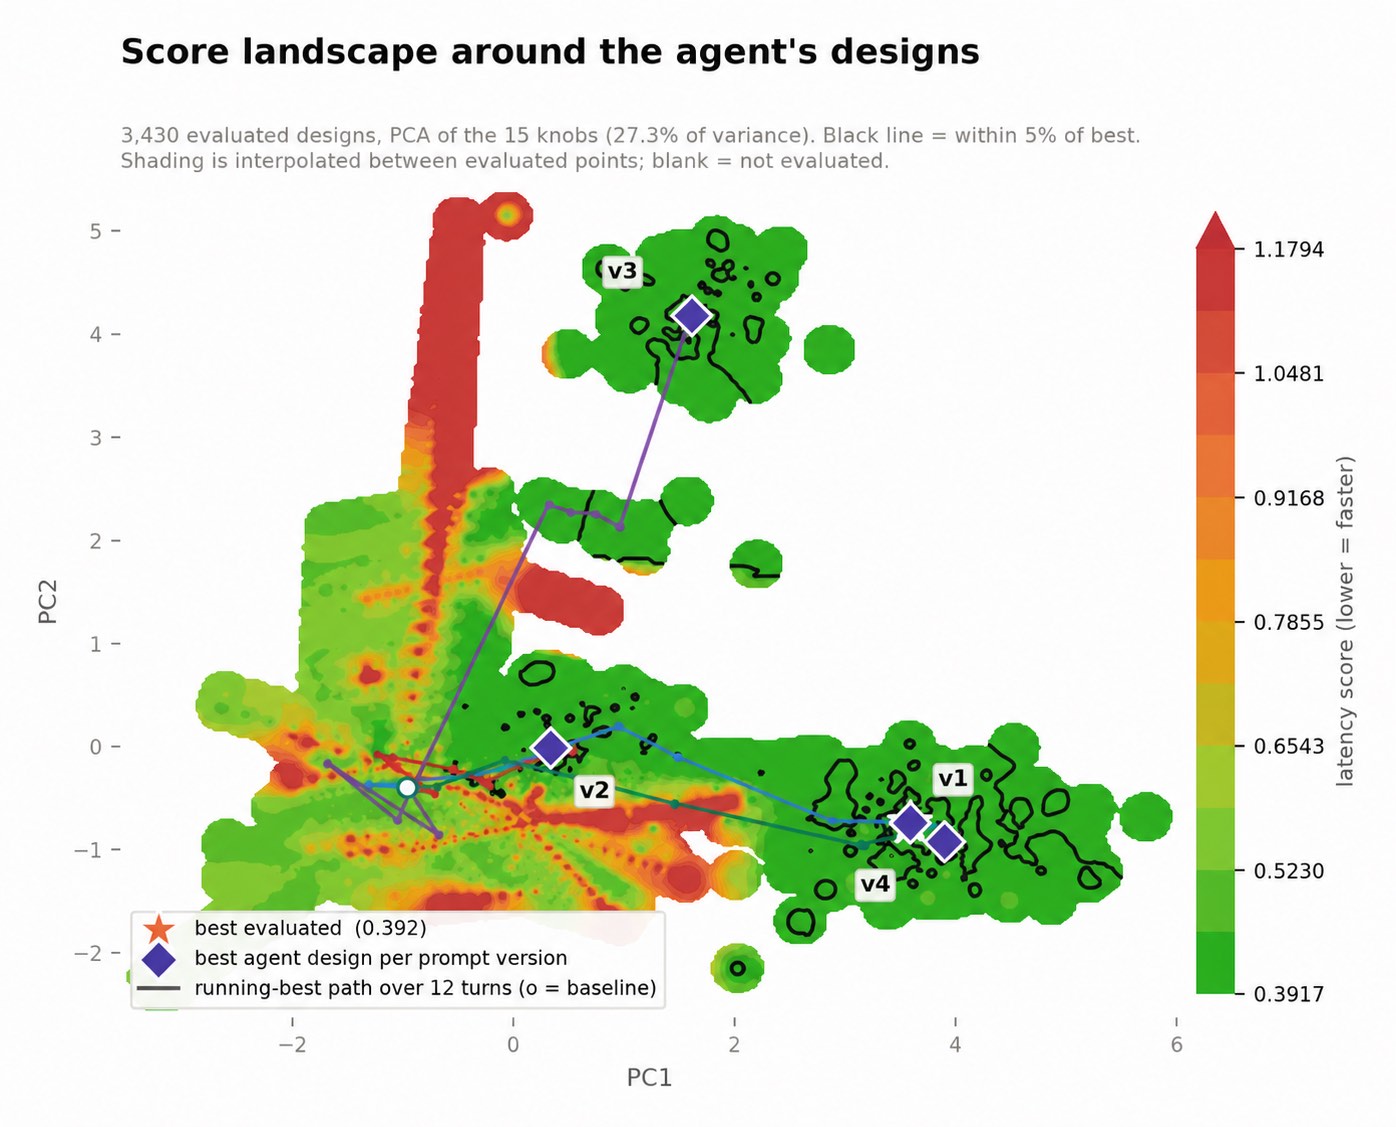
图2:3430 个已评估设计在 15 维旋钮空间上前两个主成分(仅解释 27.3% 方差)的投影。绿色是低延迟(快),红色是高延迟;黑线圈出的是距最优 5% 以内的区域;菱形是不同 prompt 版本下智能体的最优设计,蓝线是 12 轮内 running-best 的路径。关键观察:强设计占据多个分散的宽阔近最优区域(v1-v4 落在不同的绿岛上,都接近最优),所以一旦 Actor 摸到一个好区域,Critic 的额外指导就没有多少余量可挖。
这张图解释了那个反直觉的结果。作者用 Sobol 采样(1683 个可行设计)加局部网格扫描(2413 个模拟点)刻画了整个地形:近最优区域又宽又多。在这种地形上,盲搜策略不需要恢复变量的物理意义也能干得不错——反正到处都是好点子;而 Critic 面对一条已经有竞争力的轨迹,天花板很低。
要提醒一句:两个主成分只解释 27.3% 的方差,所以这个二维投影只能定性看,不能当成真实空间几何。作者自己标注了这个限制,还算老实。
💡 我的判断:这篇论文到底是什么
亮点:
它把一个哲学问题变成了测量问题。"AI 懂不懂架构"以前只能吵架,现在有了一个干净的操作化定义:抹掉语义,看性能掉不掉。这个对照实验的提法(vary the framing, hold everything else fixed)我觉得会被后续的 agent 能力评估工作引用很多次——不止硬件领域。
定性分析做得扎实。不是贴两条好看的轨迹就完事,而是专门挑了猜错的假设来展示——假设、证伪、控制变量重测、再证伪。这才是"推理"和"采样"真正的区别所在。
作者对结论尺度的把握罕见地克制。"我们没有回答标题的问题。我们有的是一种干净地问它的方式,以及第一次读数——答案不会是简单的 yes。"这种自我设限在当下的 agent 论文里太少见了。
问题和保留:
5-6 次运行。每个条件就这么点样本量,12.3% 的差距到底有多少是统计噪声,真不好说。作者自己写了"suggestive rather than conclusive",但表格里的百分比都精确到小数点后一位,读起来比实际置信度硬。
评估次数是观测值不是控制变量。58 对 194 的效率差距很亮眼,但 harness 没有强制对齐预算——如果给盲盒同样的 58 次预算它会怎样?作者把这个问题留给了未来工作,但这其实是"效率优势" claim 的一个洞。
"打赢 H200"要打折看。这是在共享解析模型下对一个小 GEMM 篮子做专门化,反映的是 workload specialization 的建模余量,不是"AI 设计出了比 H200 更好的芯片"。作者明确说了这一点,但标题党和二手转述大概率会丢掉这个限定。
还有一个我自己没完全想通的点:opaque 条件里智能体其实拿到了同样的模拟器计数器(只是改了名字),它理论上可以通过结构分析部分恢复语义——"c0 和 c3 不可约"这种结论其实已经是在做逆向工程了。"意义被完全剥夺"是不是一个渐变而不是开关?这个二分法可能比论文呈现的更模糊。
和同期工作的位置:
相比 LUMINA、MicroEvo 这类"用 LLM 知识加速 DSE"的工作,AutoTuring 的贡献不在加速器而在测量仪器;相比 ArchEval 这种 benchmark,它更进一步——ArchEval 观察"给工具后表现变好",AutoTuring 追问"变好的是哪个成分"。如果说前者们在回答"AI 能不能设计硬件",这篇是在问"我们有没有能力知道 AI 是怎么做到的"。
📝 收尾
如果你在做 agent 能力评估或者 AI-for-hardware,这篇的实验设计思路值得抄:想测什么知识,就把它从问题表述里剥掉,保持其他一切不变,看差值。比堆 benchmark 有信息量得多。
但那个更本质的问题还悬着:现在的 DSE 问题可能太简单了,简单到分不开"会推理的智能体"和"会搜索的智能体"。作者的下一步方向——attention、集合通信、稀疏层等异构算子、更紧的约束、更小的评估预算——恰好是往"假设错了没法靠采样补救"的方向走。如果到时候语义的优势还是不出现,那才是更有意思的结果:说明这些智能体看似在推理机器的时候,实际在做的事情可能和我们以为的不太一样。
研究的对象是那个问题,不是那个加速器。这句话我喜欢。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我