论文解读:双过程语言智能体的认知扩展——交互环境中的记忆与自反思
论文标题:Cognitive Extensions for Dual-Process Language Agents: Memory and Self-Reflection in Interactive Environments arXiv ID:2609.19128(v1,提交于 2026-09-16) 作者:João Meneses dos Santos, Arlindo L. Oliveira(Instituto Superior Técnico, Universidade de Lisboa / INESC-ID) 领域:cs.AI / cs.LG / cs.MA,13 页,1 图
一、一句话总结
本文在双过程智能体 SwiftSage 之上,以"特性开关(feature-flagged)"方式添加两个模块化认知扩展——自适应记忆模块 AMM(显著性门控的情景记忆存储 + 触发式检索)与自反思模块 SRM(执行前有界验证 + 停滞时纠正干预),并在 ScienceWorld 上做了受控消融。结论明确:执行时控制(SRM)是该设定下的主导瓶颈,情景记忆(AMM)只有在运行循环被稳定之后才真正发挥作用。
二、研究动机与问题
LLM 智能体在交互式环境中表现脆弱。交互环境要求:
- 长程状态跟踪(long-horizon state tracking)
- 有效动作的执行与落地
- 将目标分解为可执行子目标
- 从意外观察与失败步骤中恢复
- 避免"局部合理但无产出"的动作循环
典型的失败模式是:高层计划看起来合理,但执行时退化——重复陈旧动作、提出当前状态下不可用的动作、在无进展情况下持续导航。这类失败发生在"语言生成与环境转换的接口"上,无法仅靠更大的提示词或更强的模型解决。
基线系统 SwiftSage(Lin et al., 2024)将 System 1 式快速动作提议器(Swift)与 System 2 式慢速规划器(Sage,输出经 action buffer 执行)分离,但存在两个关键局限:
- 缺乏持久情景记忆:无法跨情节(episode)选择性地重用显著经验;
- 缺乏执行前的系统验证:动作执行前不做即时校验,行为停滞时也没有有界的干预机制。
本文的两个扩展在因果接口上分工清晰:
- AMM(Adaptive Memory Module)是"信息性"模块——改变控制器能记忆和重用的内容,但从不直接选择最终动作;
- SRM(Self-Reflection Module)是"控制导向"模块——决定什么动作能到达环境、何时插入纠正动作。
核心主张:在该设定下,执行时控制是提升交互式语言智能体的主导杠杆;情景记忆在"已受控的运行循环中作为有界证据插入"时最有用。
三、相关工作定位
- 双过程理论(Kahneman, 2011):区分快速自动认知与慢速审慎推理;本文将其作为工程抽象而非认知等价主张。
- 审慎推理:CoT(Wei et al., 2022)、Self-Consistency、Least-to-Most、Decomposed Prompting 等使静态推理更显式,但交互智能体还需决定"何时深思、如何把计划落地到当前状态、如何防止无效动作消耗环境步数"。
- 动作/工具/反馈增强:SayCan(可供性落地)、ReAct(推理-行动交织)、Reflexion(言语反馈)、Self-Refine、CRITIC(工具验证纠正)、Toolformer/ART。Huang et al. (2023) 指出无约束的自我纠正可能增加成本甚至降低性能——因此 SRM 采用"触发门控 + 面向执行"的设计,而非始终开启。
- 记忆系统:AMM 受互补学习系统(CLS,Marr 1971;McClelland et al., 1995)启发,并借鉴 RAG、MemGPT、CoALA、Generative Agents。AMM 的差异化:存储紧凑情景记录、仅在操作性触发点检索,而非持续扩提示或充当替代规划器。
- 最直接前身:SwiftSage。本文完整保留其执行底座,仅添加两个缺失机制。
四、方法
4.1 总体架构
系统保留 SwiftSage 控制循环:每个时间步优先执行缓冲动作;无缓冲动作时查询 Swift;在基线条件下(无效动作、无进展、需审慎规划)升级到 Sage。AMM 可增强选定的 Swift / Sage / Critic 提示;SRM 在执行前验证动作,并可向 Sage 所用的同一 FIFO buffer 注入有界纠正动作。
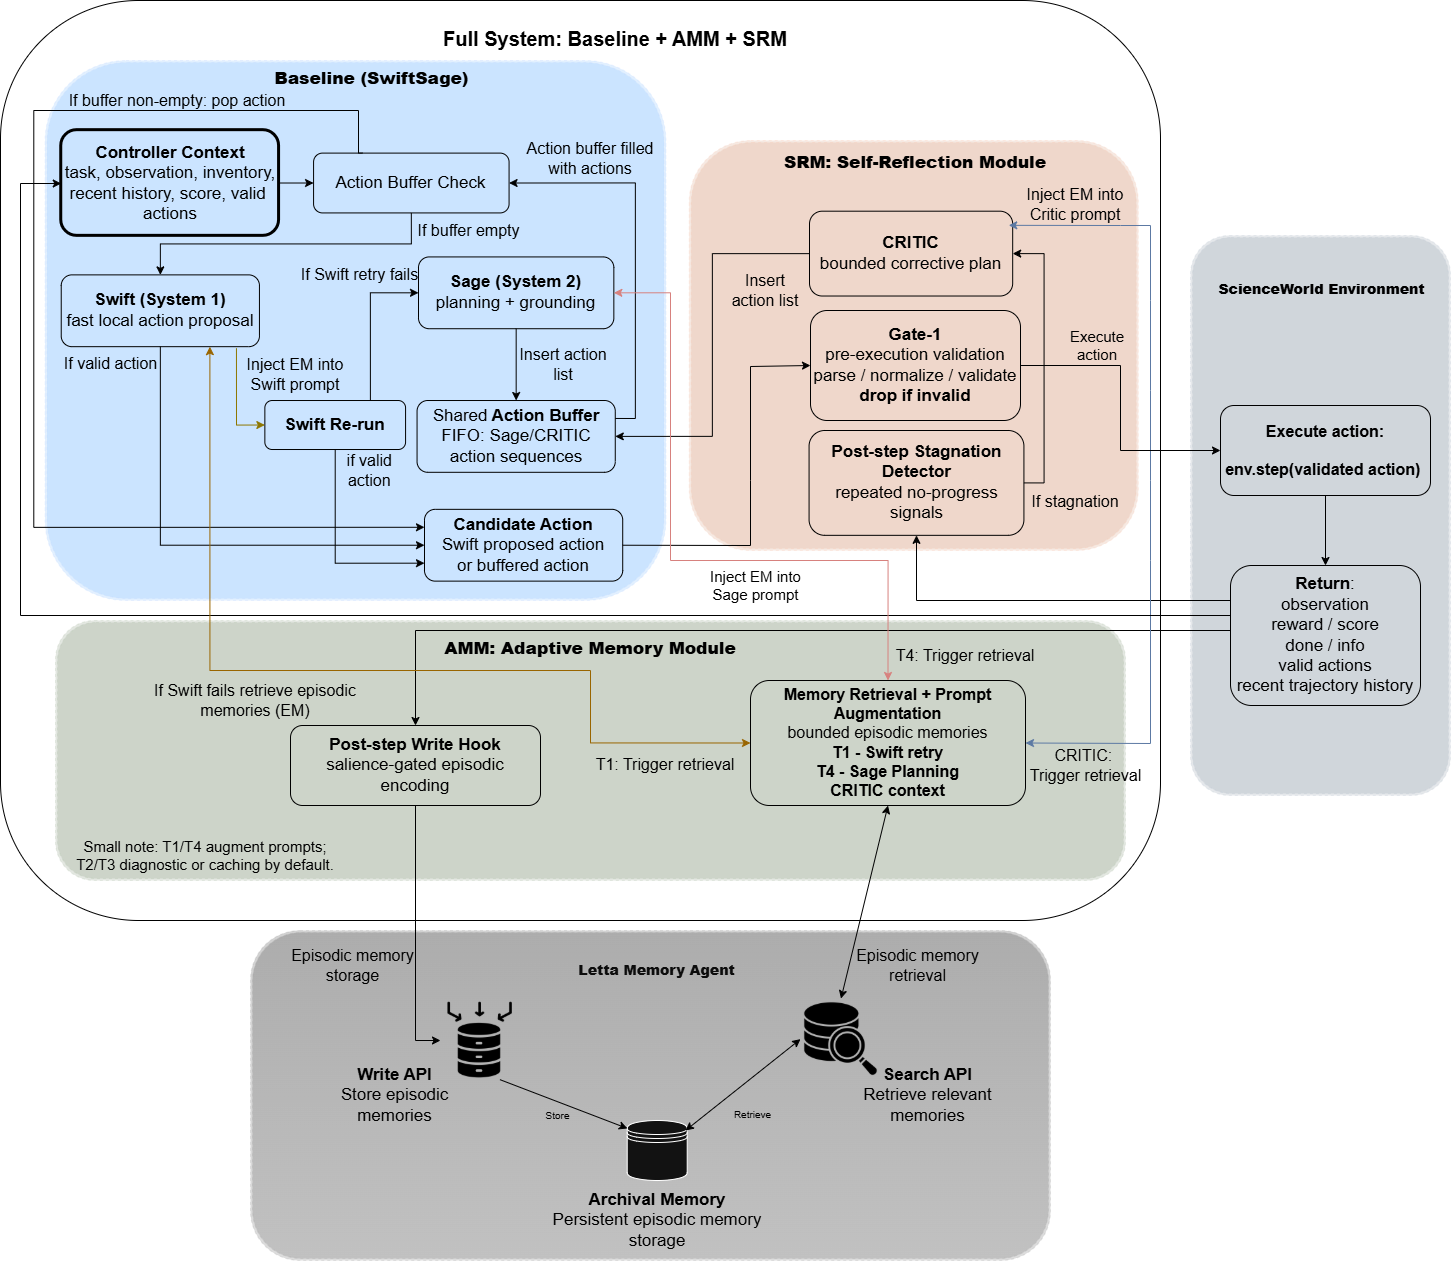
图 1:全系统架构。蓝色为 SwiftSage 基线(Swift 快通道、Sage 慢规划、共享 FIFO 动作缓冲);绿色为 AMM(写钩子 + 触发式检索,底层为 Letta archival memory);橙色为 SRM(Critic、Gate-1 预执行验证、停滞检测器);右侧为 ScienceWorld 环境。
4.2 自适应记忆模块 AMM
显著性门控存储(post-step 写钩子):
- 写钩子在环境返回观察和分数变化后运行,输入:任务、先前状态、执行动作、结果观察、分数变化、近期历史,构建候选情景记录。
- 仅当显著性门检测到信息性转换时才存储,条件包括:终态成功、正向分数变化、near-miss 进展、显式无效动作反馈、值得避免的失败。
- 记忆为紧凑半结构化记录(非原始转录),字段含任务、局部状态、近期上下文、执行动作、结果观察、分数转换、类型标签(success / near-miss / avoidance),便于定向检索与安全注入。
触发式检索(pre-decision 检索钩子):
- T1(Swift 失败):Swift 无法产生有效动作时,检索相关情节,用记忆条件上下文重试 Swift;
- T4(System 2 规划):基线调用 Sage 且记忆规划启用时,检索 success 与 near-miss 情节供审慎规划;
- T2/T3:停滞与重复无效动作的检索/缓存钩子,但在 AMM-only 配置中不直接修改模型输入(避免向快速通道注入弱落地的负面证据)。
有界提示增强:Swift 仅在恢复模式接收小记忆块,Sage 可接收稍大块;提示明确要求模型将记忆视为提示而非权威(当前观察、物品栏、可接纳动作、运行时约束始终优先);检索记忆经过去重、按类型过滤、固定压缩顺序截断;任何检索/格式化/结构检查失败均回退到未修改的基线提示。
4.3 自反思模块 SRM
由三部分组成:
- Gate-1 执行前验证:接收提议动作、当前有效动作集、近期状态描述符、运行时约束;执行规范化 → 可接纳性检查 → 不匹配较小且安全时做确定性修复 → 仍无效则丢弃。源无关:Swift、Sage 缓冲、Critic 生成的动作均经过同一预执行控制面。
- 执行后停滞检测:确定性诊断跟踪重复观察、无效重复动作、无效动作循环、无状态多样性的过度导航、不改变有效状态的动词级循环;超过阈值时生成结构化停滞报告(失败模式、应避免动作、相关运行时约束)。
- 有界 Critic 干预:仅在检测到停滞且安全措施允许时调用;提示含任务、当前状态、近期轨迹、停滞报告、运行时约束及(全系统中)可选 AMM 证据;Critic 必须输出短可执行动作列表,经解析、过滤后插入 Sage 的同一 FIFO buffer,从不直接执行,缓冲动作仍须经 Gate-1;调用受预算与冷却限制。
设计定位:Critic 是"最后一公里"修复机制,Gate-1 才是始终在线的保障。
4.4 全系统组合与优先级
AMM 在环境步骤后写显著记忆、按触发机制检索有界证据;SRM 执行前 Gate-1、执行后停滞监控。两者主要交互发生在反思纠正阶段(SRM 调用 Critic 时 AMM 提供情景证据)。层级明确:
当前有效动作与约束 > 停滞诊断 > 检索记忆(可选证据) > Gate-1(最终保障)
五、实验设置
| 项目 | 设置 |
|---|---|
| 环境 | ScienceWorld(Wang et al., 2022),任务 0–29 |
| 评估规模 | 每任务最多 10 个自然语言变体,每配置最多 271 个评估 episode |
| 运行语义 | 所有配置共享环境接口、有效动作落地、每时间步一个 env.step、Swift/Sage 仲裁、FIFO 动作缓冲 |
| Swift 模型 | Flan-T5-large(SwiftSage 式行为克隆组件) |
| Sage / Critic 模型 | Qwen2.5-7B-Instruct-1M,本地 vLLM 服务 |
| 记忆存储 | Letta archival memory |
| 记忆初始化 | 预热:每任务 2 个变体共 60 个 episode 仅用于填充记忆,不计入指标;AMM 配置以"已填充记忆"评估(经验重用而非冷启动) |
| 记忆消费上限 | Swift T1 恢复检索 3 条;Sage T4 规划检索 5 条;Critic 输出最多 5 个动作的纠正列表 |
| Critic 预算 | 主设置每 episode 最多 3 次调用(6 次为敏感性变体) |
| 指标 | Final score、Success rate、Steps@Succ(仅成功 episode 的平均步数);任务级聚合后宏平均 |
| 任务分组 | Short(0<Len≤20)、Medium(20 |
协议说明:作者明确不追求 ScienceWorld SOTA,重点是在共享本地模型/运行时下的受控消融。
六、实验结果
6.1 聚合性能(表 1)
| 配置 | Final | Succ. | Steps@Succ |
|---|---|---|---|
| Baseline | 51.67 | 23.99% | 24.48 |
| +AMM | 53.83 | 26.94% | 24.03 |
| +SRM | 64.33 | 41.33% | 19.76 |
| Full | 64.62 | 43.17% | 19.33 |
全系统在平均分(64.62)、成功率(43.17%)与成功步数效率(19.33 步)上均为最佳;SRM 是最强的独立贡献者。
6.2 分组 Final Score(表 2,括号内为相对基线变化)
| 组(平均 Len) | Baseline | +AMM | +SRM | Full |
|---|---|---|---|---|
| Short(11.76) | 57.74 | 66.43 (+15.1%) | 81.50 (+41.2%) | 80.06 (+38.7%) |
| Medium(28.58) | 45.20 | 47.16 (+4.3%) | 48.42 (+7.1%) | 49.72 (+10.0%) |
| Long(94.30) | 50.93 | 47.78 (−6.6%) | 61.64 (+21.0%) | 61.69 (+21.1%) |
| Overall(49.26) | 51.67 | 53.83 (+4.1%) | 64.33 (+24.5%) | 64.62 (+25.1%) |
6.3 成功率与效率(表 4:Succ.% / Steps@Succ)
| 组 | Baseline | +AMM | +SRM | Full |
|---|---|---|---|---|
| Short | 32.96 / 11.77 | 46.59 / 10.78 | 64.77 / 8.09 | 73.90 / 9.75 |
| Medium | 11.94 / 20.75 | 11.94 / 44.13 | 11.94 / 31.00 | 8.96 / 26.67 |
| Long | 25.86 / 37.37 | 20.69 / 39.96 | 40.52 / 29.70 | 39.70 / 31.89 |
| Overall | 23.99 / 24.48 | 26.94 / 24.03 | 41.33 / 19.76 | 43.17 / 19.33 |
6.4 机制活动日志
AMM 机制活动(表 5,每 episode,Overall 行):
| 配置 | 写入 | Success | Near-miss | Avoid | T1 | T4 | Swift 注入 | Sage 注入 |
|---|---|---|---|---|---|---|---|---|
| AMM | 4.48 | 0.95 | 2.71 | 0.82 | 17.13 | 19.13 | 30.81 | 19.13 |
| Full | 4.89 | 1.14 | 2.99 | 0.78 | 12.15 | 11.77 | 23.03 | 11.77 |
SRM 机制活动(表 6,每 episode,Overall 行):
| 配置 | 停滞报告 | Critic 调用 | Not valid | NOOP | Target unseen | Gate DROP |
|---|---|---|---|---|---|---|
| SRM | 9.77 | 1.35 | 17.57 | 1.54 | 1.52 | 20.03 |
| Full | 9.35 | 1.29 | 15.98 | 2.12 | 0.97 | 17.48 |
系统使用与成本代理(表 7):
| 配置 | Swift 直执 % | Buffer % | S1 calls | S2 calls |
|---|---|---|---|---|
| Baseline | 44.08 | 55.92 | 40.8 | 24.6 |
| AMM | 49.16 | 50.84 | 60.9 | 19.1 |
| SRM | 57.13 | 42.87 | 29.4 | 15.7 |
| Full | 62.01 | 37.99 | 54.4 | 14.1 |
6.5 敏感性分析(表 8,分组 Final Score)
| 变体 | Overall | Short | Medium | Long |
|---|---|---|---|---|
| AMM 弱记忆 | 51.47 | 60.45 | 45.69 | 47.85 |
| AMM 填充记忆(主比较) | 53.83 | 66.43 | 47.16 | 47.78 |
| SRM Critic max=6 | 52.95 | 62.70 | 42.10 | 52.05 |
| SRM Critic max=3(主比较) | 64.33 | 81.50 | 48.42 | 61.64 |
| Full 去掉 Swift T1 注入 | 63.33 | 79.23 | 53.88 | 56.36 |
| Full 完整系统 | 64.62 | 80.06 | 49.72 | 61.69 |
七、核心结论
- 执行时控制是主导瓶颈:SRM 单独贡献绝大部分提升(+24.5% vs 全系统 +25.1%),成功率从 23.99% 跃升至 41.33%,Steps@Succ 从 24.48 降至 19.76。机制上,SRM 的收益主要来自 Gate-1 的持续过滤(每 episode 丢弃 17–20 个动作,主因是动作不在当前有效集中),而非频繁的 Critic 重规划(仅约 1.3 次/episode)。
- 记忆有用但有条件:AMM 单独仅 +4.1%,且在 Long 任务上单独使用反而 −6.6%;但全系统写入更多记忆(4.89 vs 4.48)的同时检索/注入更少(T1 17.13→12.15,T4 19.13→11.77),说明 SRM 稳定执行后减少了需要记忆干预的不稳定状态,记忆被更选择性地使用。near-miss 记录占写入主体。
- 更多反思并非更好:Critic 预算从 3 增至 6 导致所有分组性能下降(Overall 64.33→52.95),验证"有界反思"设计——Gate-1 作廉价常开保障,Critic 仅用于显式停滞。
- 更强性能 ≠ 更多深思:全系统 Swift 直执比例升至 62.01%,System 2 调用降至 14.1 次/episode——收益来自"让快路径更安全、慢路径更有针对性"。
- 记忆的边际贡献:去掉 Swift T1 注入使全系统从 64.62 降至 63.33,对 Long 任务影响最大(61.69→56.36);填充记忆优于弱记忆(53.83 vs 51.47)。
八、局限性与未来工作
- 记忆表示与利用较简单:AMM 依赖紧凑半结构化记录 + 有界提示注入,检索排序、重排序、跨轨迹巩固、向具体动作改进的转换均较弱。
- 缺乏语义巩固层:AMM 目前仅是情景记忆,未实现将重复经验抽象为可重用技能/程序/任务通用规律的语义层——从 CLS 视角看只覆盖了"快速情景侧",这解释了 AMM 单独收益有限的原因。
- SRM 手工组件多:停滞阈值、动作过滤规则、焦点约束、固定 Critic 预算、确定性修复策略均为人工设计;Gate-1 修复能力浅(无法干净规范化时只能丢弃)。未来可探索学习型验证器、置信度感知升级、自适应反思预算。
- 评估范围有限:仅 ScienceWorld 单一文本环境 + 单一模型骨干,结论未必迁移至多模态、机器人动作空间或其他模型;填充记忆协议未刻画冷启动、预热动态、记忆老化/压缩/遗忘。
- 因果解释不充分:机制日志记录了何时写入/检索/注入、何时丢弃/调用 Critic,但无法完全隔离单次成败背后的提示级因果因素;未来需更细粒度因果追踪、反事实重放、受控提示消融。
伦理说明:研究限于模拟教育科学环境,无人类受试者或隐私数据;主要风险为能力外溢,故模块设计强调有界干预、显式动作验证、日志与环境落地约束,不应在未加额外安全评估前部署于开放真实环境。
九、个人点评
- 工程启示大于性能数字:本文最有价值的不是 ScienceWorld 上的分数(作者也明说不追 SOTA),而是用受控消融证明了一个反直觉结论——给智能体加"记忆"之前,先给它加"刹车"。Gate-1 这种廉价的、确定性的执行前过滤贡献了绝大部分收益,这与 Huang et al. (2023) 关于无约束自我纠正的警告互相印证。
- "有界"是贯穿全文的设计哲学:记忆注入有界(条数上限、提示降级)、Critic 有界(预算+冷却+只写 buffer 不直接执行)、提示有界(记忆仅作提示而非权威)。在 agent 系统里,模块失效时回退到基线行为的降级设计值得借鉴。
- 记忆的负收益现象值得注意:AMM 单独在 Long 任务上 −6.6%,说明在不稳定的执行循环上注入记忆证据反而可能加剧干扰;稳定控制是记忆发挥作用的前提条件。
- 局限较诚实:手工阈值多、单环境单骨干、无语义巩固层——AMM 离 CLS 启发的完整记忆系统还很远,后续工作空间明确。