一个 token 只花 890 字节:DeepSeek-V4.1-Flash 把 KV 缓存压到了什么程度
核心摘要:长程 Agent 让模型负载越来越"输入重"——prefill 贵、KV cache 占显存又占 SSD,这已经成了部署成本的头号瓶颈。DeepSeek 这篇技术报告(arXiv:2609.19969)给出的答案相当激进:用 Causal Encoder-Decoder 架构把 prefill 激活参数砍半(8B vs decode 的 16B),用跨层复用的 CSA2 注意力加 FP4 KV cache,把全局 KV cache 压到每 token 890 字节——是上一代 V4-Flash 的约 1/4,V1 的 1/437。更狠的是 SWA Bounded Replay,干脆不持久化滑窗 KV,miss 了就重放最近 128 个 token 近似重建,持久化 KV 再缩到 V4-Flash 的约 1/8。关键是性能不降反升:DeepSWE v1.1 拿 74.2%,超过 Opus-5 的 74.0%。这不是单点创新,是一整套"架构 × 精度 × 部署"的联合压缩方案,做 Agent 基础设施的人值得细读。
论文信息 - 标题:DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression - 作者:DeepSeek-AI(Anyi Xu、B. Li、Bangcai Lin 等 500+ 人) - 机构:DeepSeek-AI - 时间:2026 年 9 月 17 日 - 链接:https://arxiv.org/abs/2609.19969 | 模型权重:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
🎯 为什么 KV cache 成了新的拦路虎
做 Agent 部署的人最近应该都有体感:模型负载的重心在往输入侧移。一次 Agent 会话,工具返回、网页内容、代码库上下文疯狂往 prompt 里塞,动辄几十万 token;而输出往往没多少。这个负载形态下,两件事最烧钱:
一是 prefill。KV cache miss 一次,整个 prompt 就得完整跑一遍前向。二是 KV cache 本身。长上下文下它要吃 HBM 容量、吃 SSD 容量、还吃两者之间的搬运带宽。DeepSeek 从 V2 的 MLA 开始一路在压长上下文计算成本,算力这块确实压下去不少——结果就是,存储和带宽的相对占比反而凸显出来了。
看看 DeepSeek 自家几代模型每 token 全局 KV cache 的字节数变化,这条曲线挺震撼的:
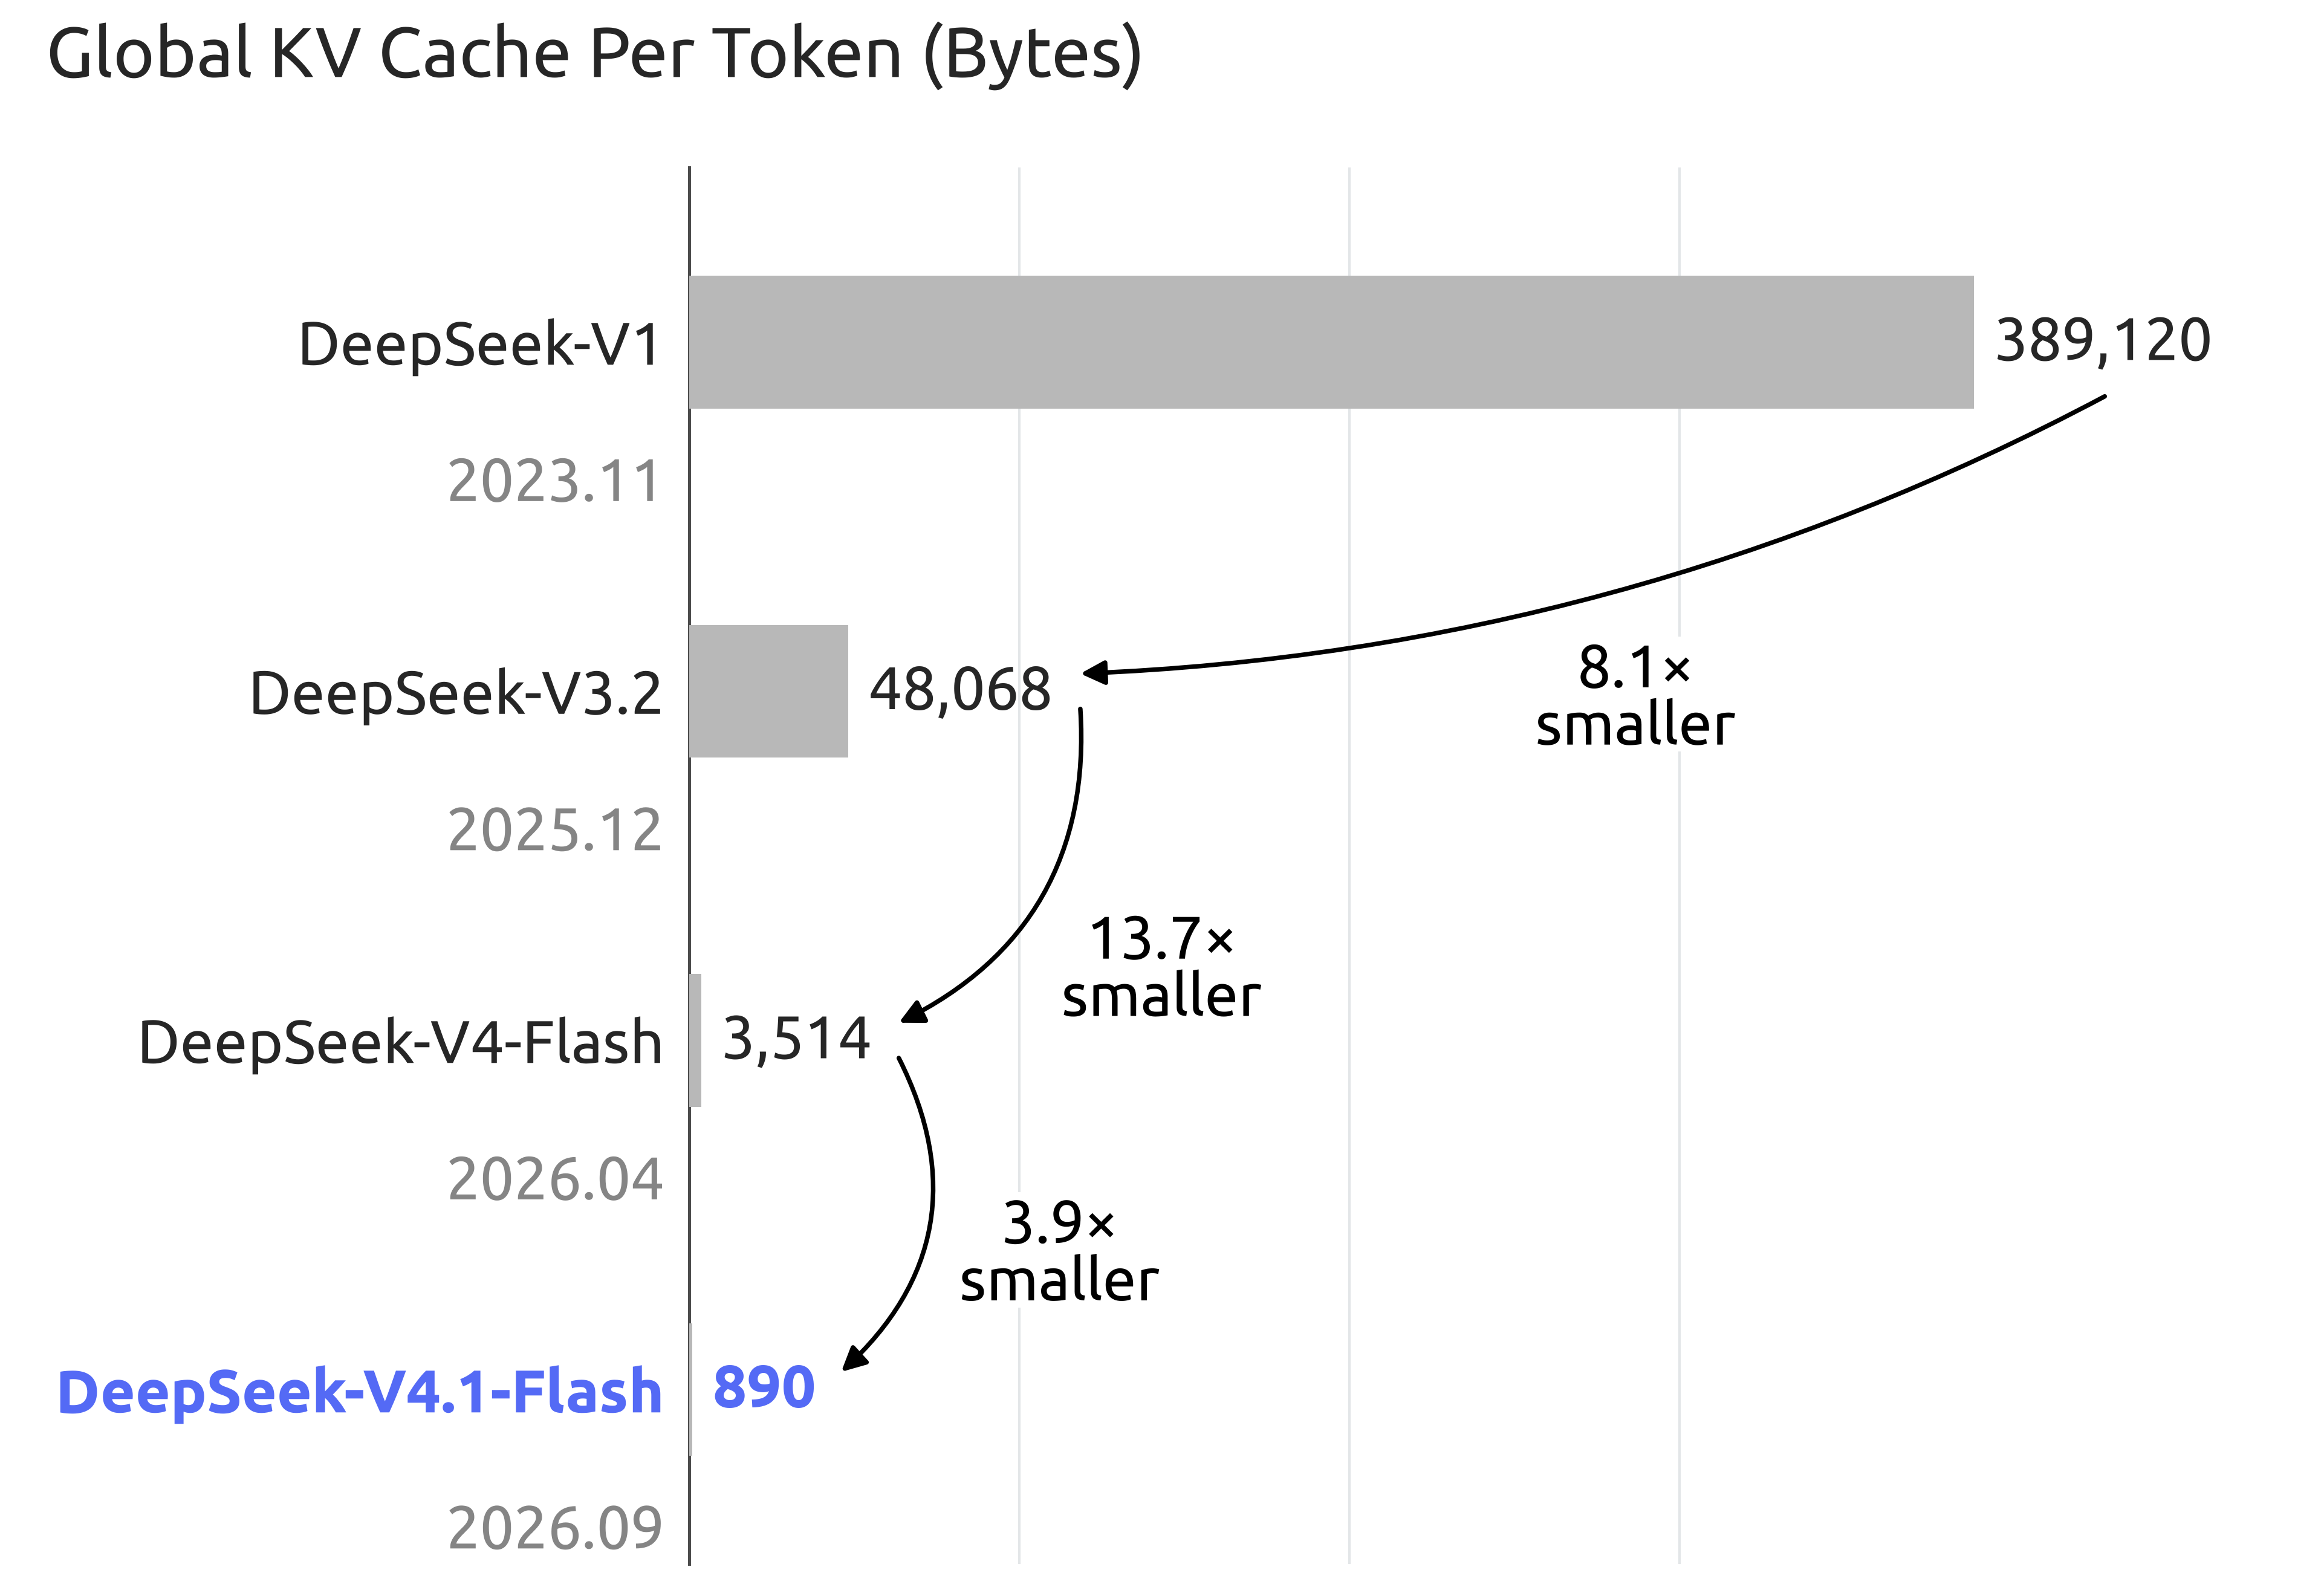
图 1b:每 token 全局 KV cache 从 V1 的 389,120 字节,到 V3.2 的 48,068,V4-Flash 的 3,514,再到 V4.1-Flash 的 890 字节。相对 V1 缩了 437 倍。
890 字节是什么概念?大致相当于在 HBM 里给一个 token 存一条几百字的短消息。V4-Flash 时代这个数字是 3,514 字节,V4.1 直接打到约 1/4。而性能呢,看下面这张 agentic benchmark 对比:
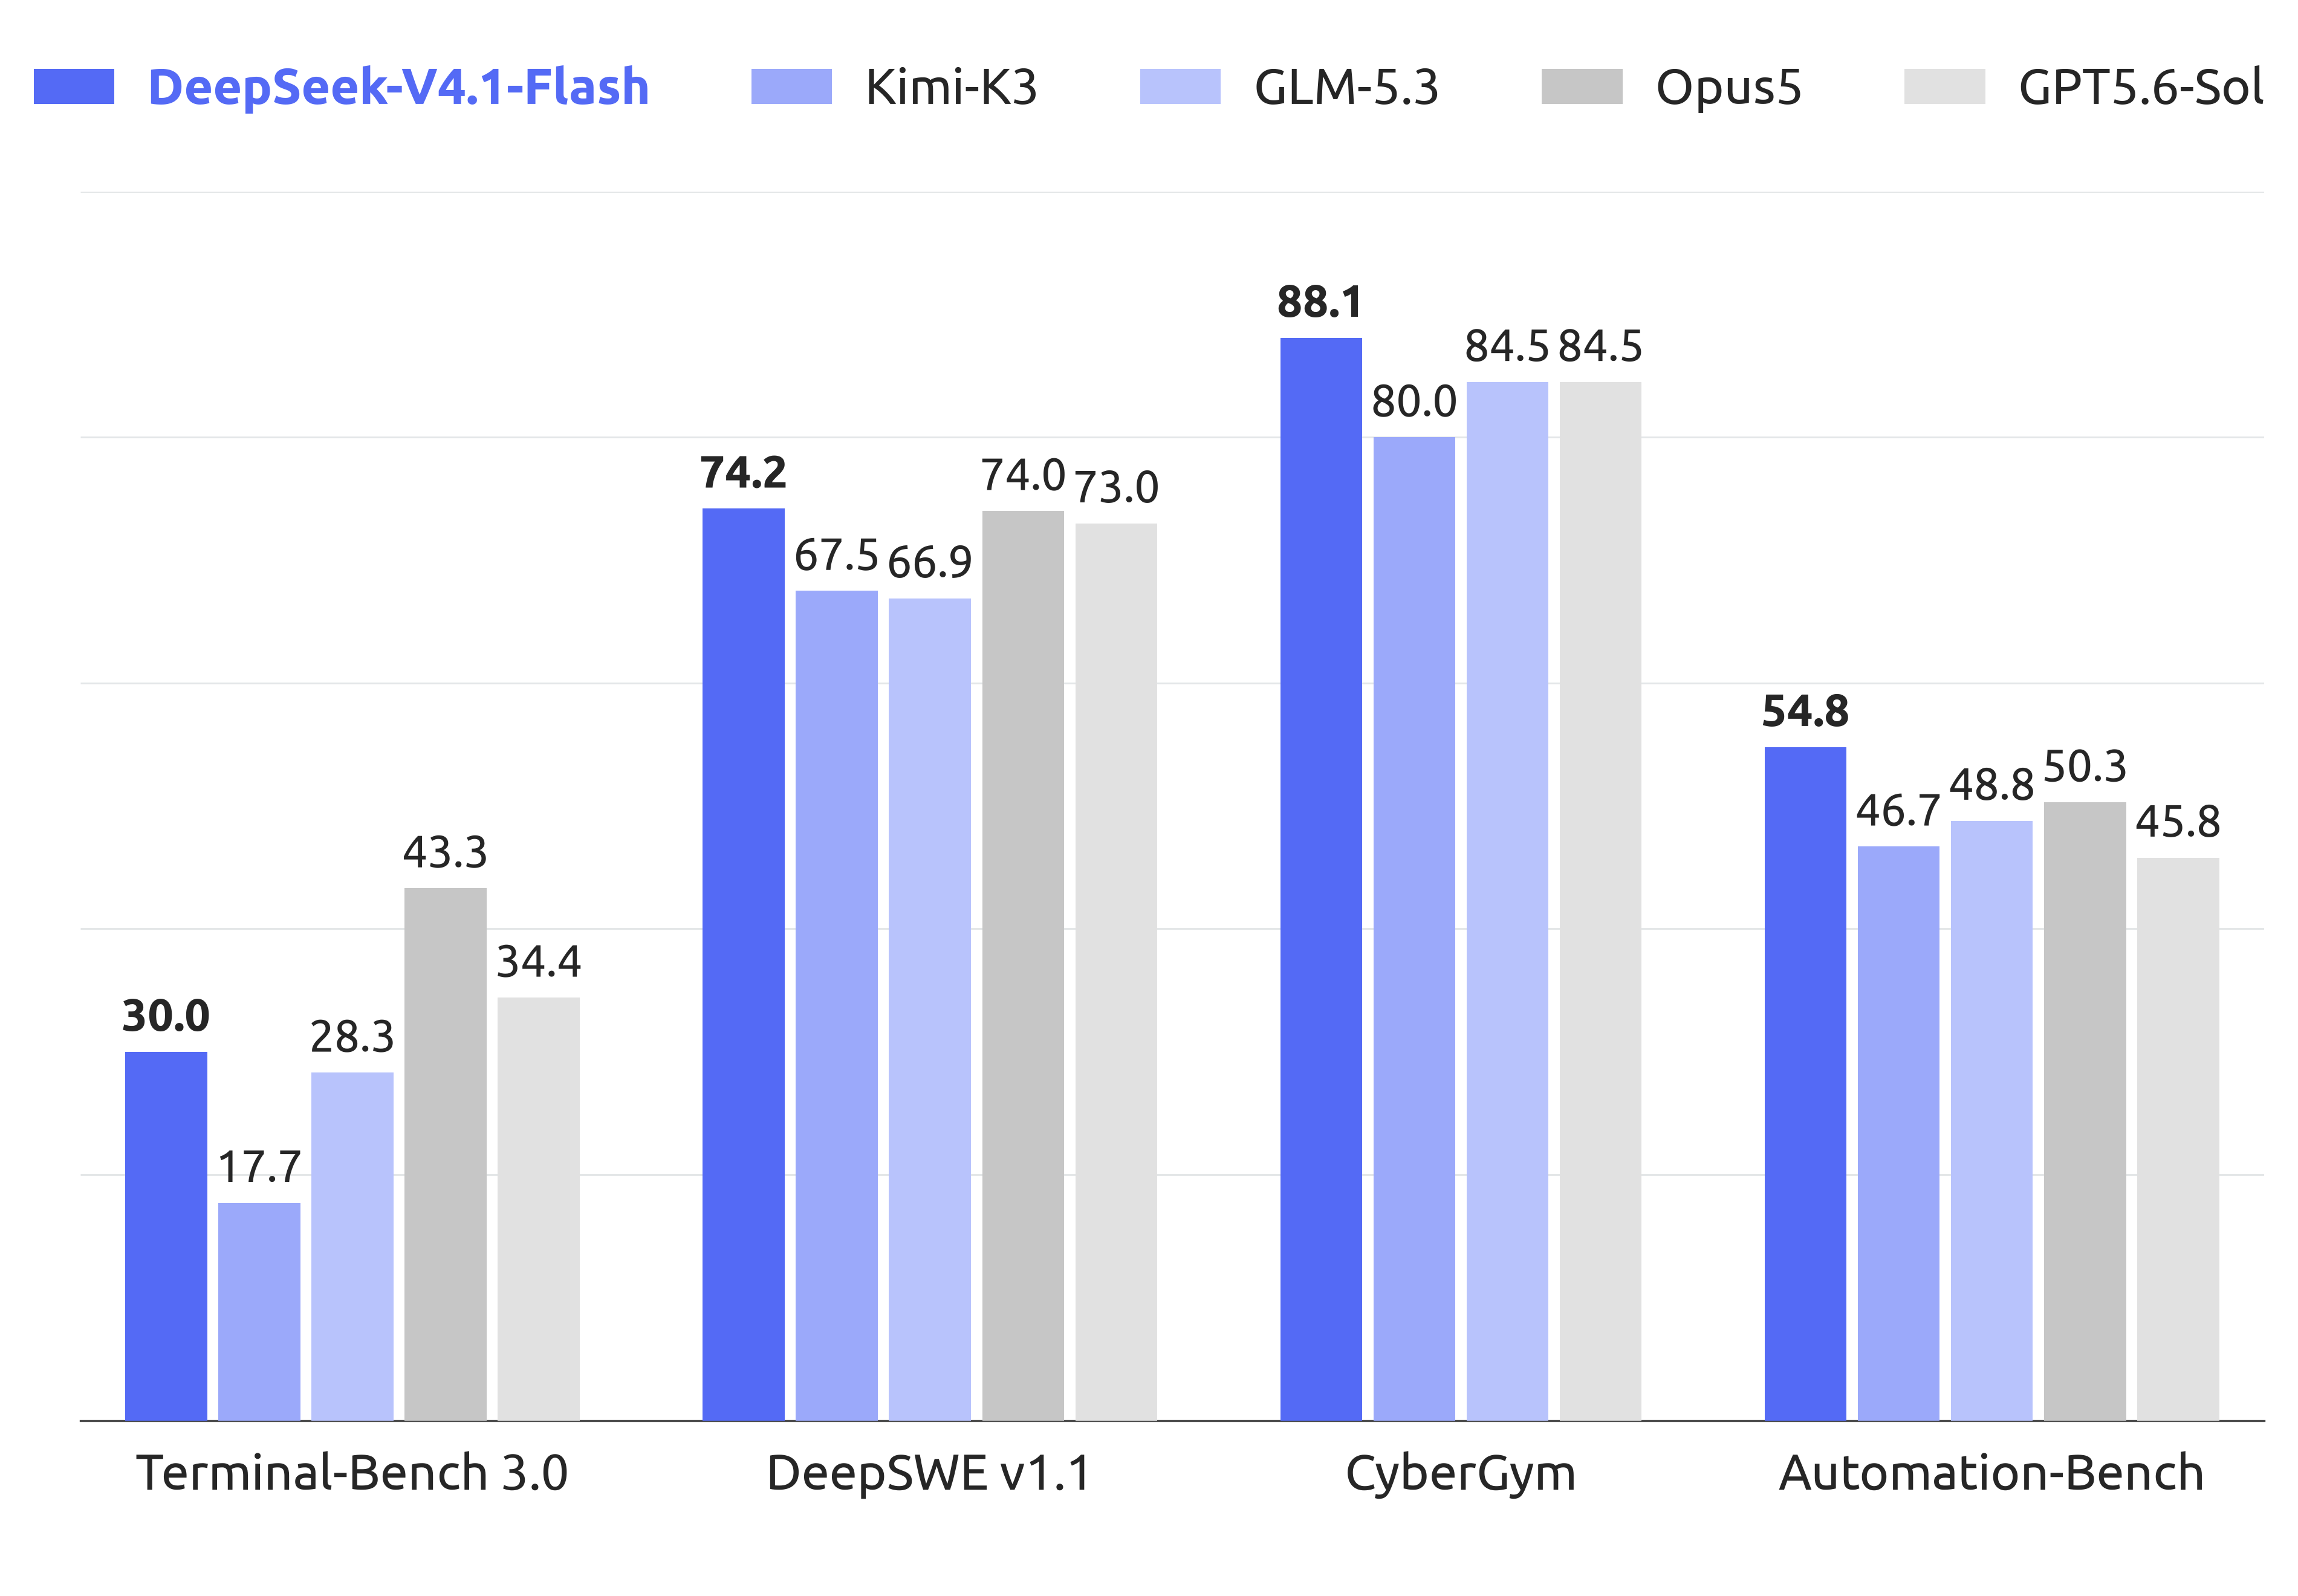
图 1a:DeepSeek-V4.1-Flash 与 Kimi-K3、GLM-5.3、Opus-5、GPT-5.6-Sol 在四个 agentic benchmark 上的对比。DeepSWE v1.1 上 74.2% 全场最高,CyberGym 88.1% 领先,Automation-Bench 54.8% 领先。
说实话,我盯着 Terminal-Bench 3.0 这组看了一会儿——V4.1-Flash 拿 30.0,Opus-5 是 43.3,差距摆在那儿,作者也没藏着,直接画在 teaser 里。这种坦诚我喜欢,后面细聊。
压缩是怎么做到的?一句话版本:架构上跨层共享,精度上 FP4 量化,部署上有损重放。三层各砍一刀,叠起来就是 4 倍(运行时)加 8 倍(持久化)。下面逐个拆。
🧠 模型总览:552B 参数,prefill 只激活 8B
先把基本盘摆出来。DeepSeek-V4.1-Flash 是原生多模态 MoE:552B backbone 参数,外加 196B Engram 条件记忆参数;40 层 Transformer,20 层因果编码器 + 20 层解码器;hidden dimension 5120;支持最长 100 万 token 上下文。最特别的数字是这个——prefill 每 token 只激活 8B 参数,decode 激活 16B。输入重的 Agent 负载下,prefill 占大头,这个不对称设计就是冲着成本去的。
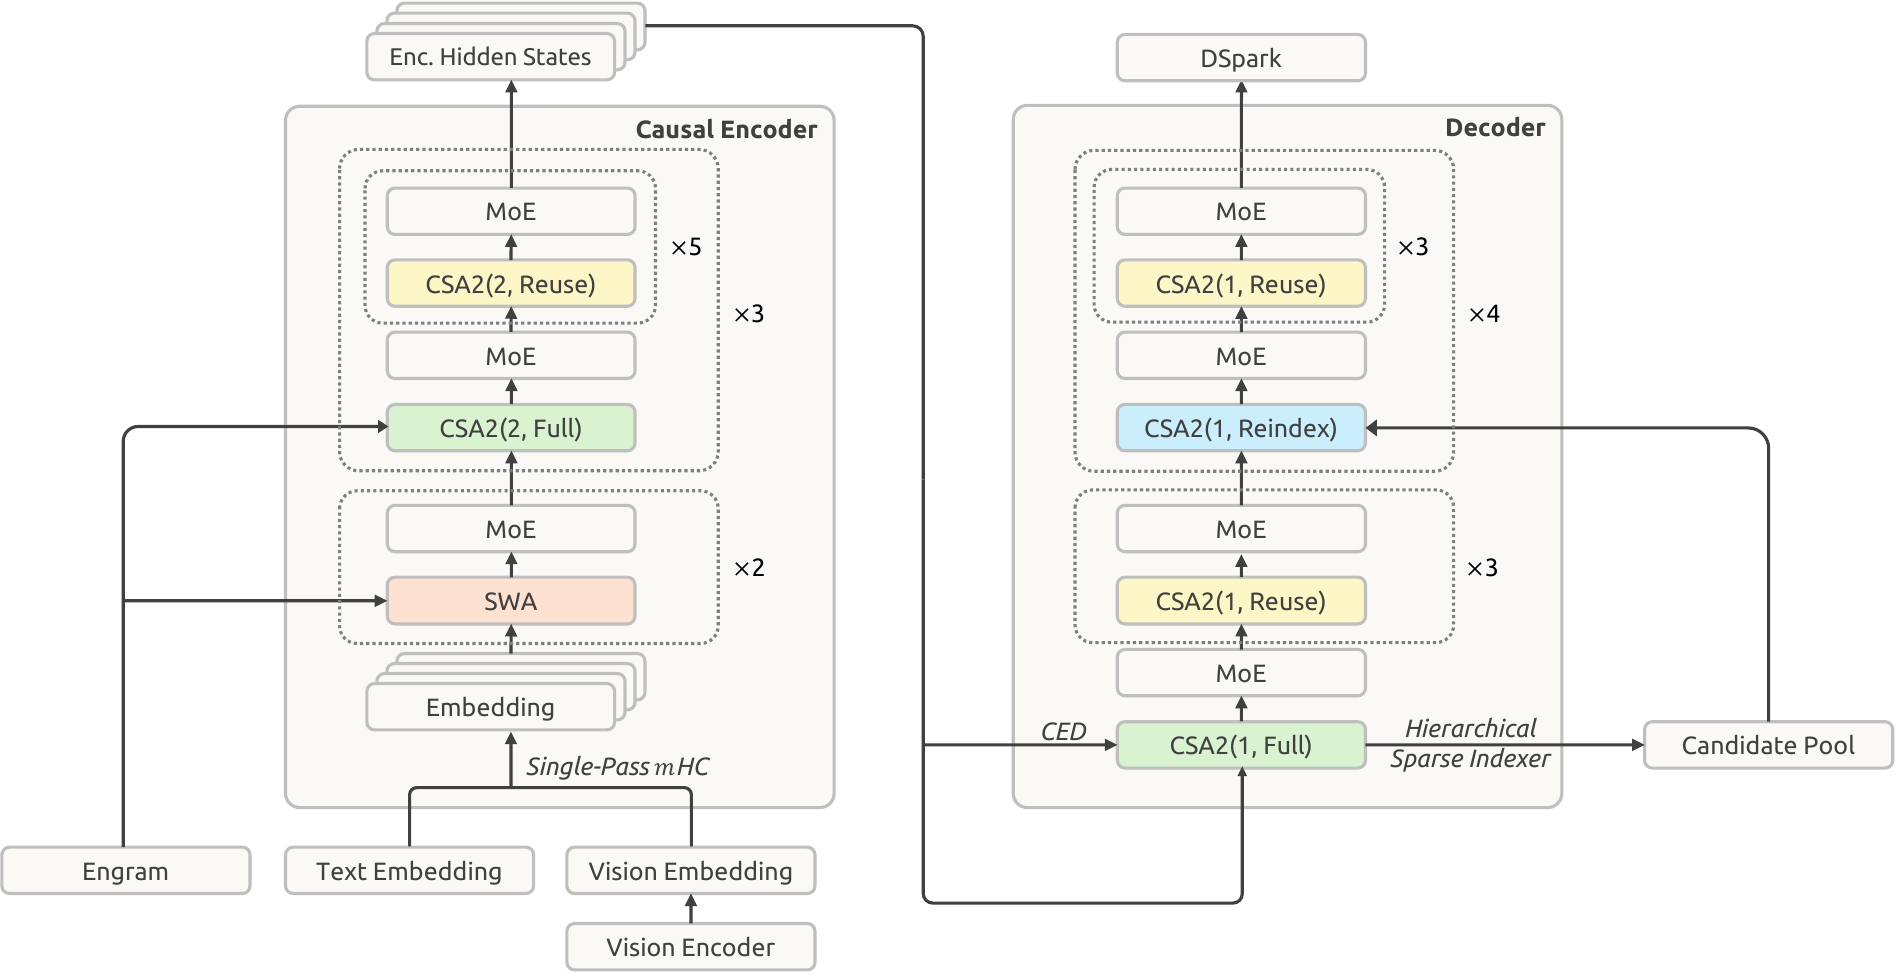
图 3:整体架构。左侧因果编码器 20 层(前 2 层纯 SWA,其余 CSA2),右侧解码器 20 层(CSA2 m=1)。解码器的全局 KV 由编码器最终 hidden states 投影而来;分层稀疏索引器为后续层维护共享候选池。
除了主干,图上还有几个值得记住的模块:Single-Pass mHC(改进的残差流混合,方便 kernel 融合)、Engram(稀疏条件记忆)、DSpark(投机解码,替代原来的 MTP)、分层稀疏索引器。这些后面挑重点说。
先看效率账。单 token decode FLOPs 随上下文长度的变化:
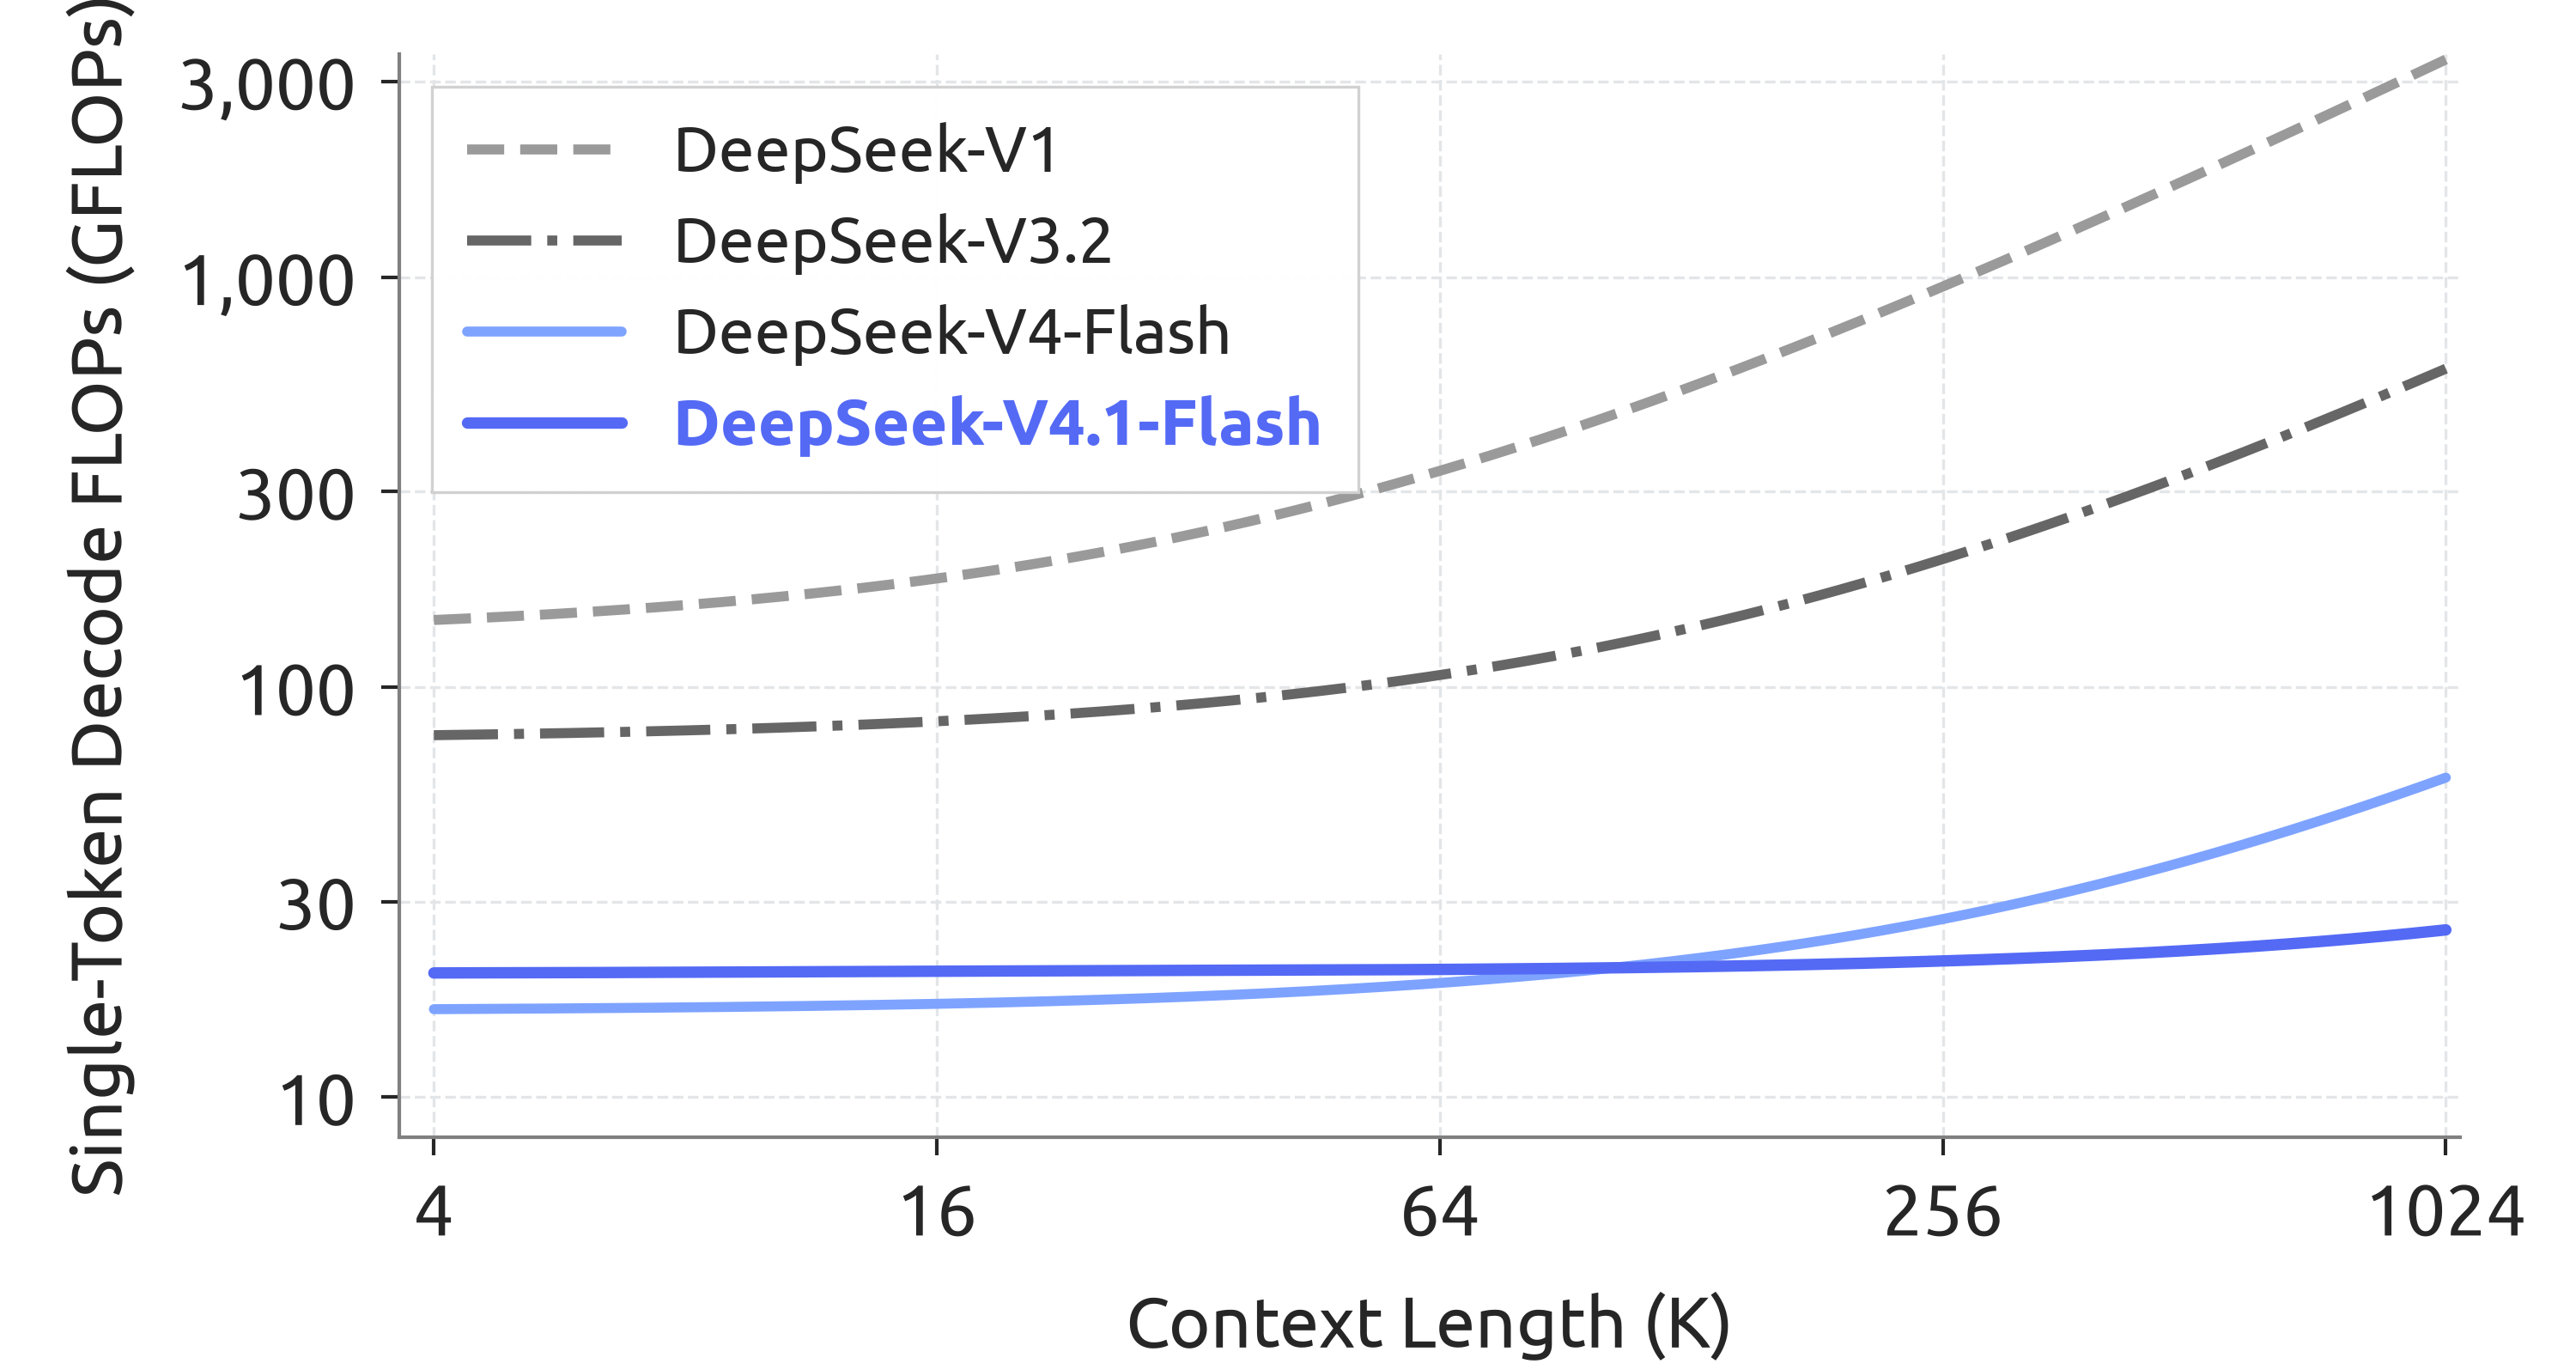
图 2:历代 DeepSeek 模型的单 token decode FLOPs(对数轴,BF16/FP8/FP4 按精度加权)。V1 和 V3.2 随上下文线性飙升,V4-Flash 已经压平了不少,V4.1-Flash 在 1M 上下文下也只有约 25 GFLOPs,几乎是一条平线。
1M 上下文下 decode 一个 token 的算力和 4K 上下文几乎一样。这条平线就是稀疏注意力 + 跨层复用的直接体现。
🏗️ 三个核心设计
CED:让 prefill 只跑半个模型
Causal Encoder-Decoder 这个思路,血统上可以追到 YOCO——上半层直接共享下半层产出的 KV cache,省掉重复计算。CED 在此基础上做了结构化改进:全局注意力上,解码器的全局 KV 不再由解码器自己一层层算出来,而是直接从编码器最终 hidden states 投影得到。
带来的效果很直接:prefill 阶段只需要跑编码器这 20 层,解码器的全局 KV 几乎是"免费"拿到的。论文给出的复杂度结论是 prefill 计算量接近减半。
等等,解码器的 SWA KV 怎么办?它依赖解码器各层自己的 hidden states,投影不出来。这个问题先记着,后面 SWA Bounded Replay 就是来解决它的。
CSA2:跨层复用,能借就不自己算
Compressed Sparse Attention 2 是这次压缩的主力。和 V4 的 CSA 一样,每个 CSA2 层有一个轻量 indexer,用 indexer Q/K 给全局 main KV 打分,选出 Top-K(512 条)做稀疏注意力,再加上本层滑窗 KV。但 CSA2 想明白了一件事:不是每一层都配拥有自己的 KV 和索引。
它把每一层静态指派为三种模式之一:
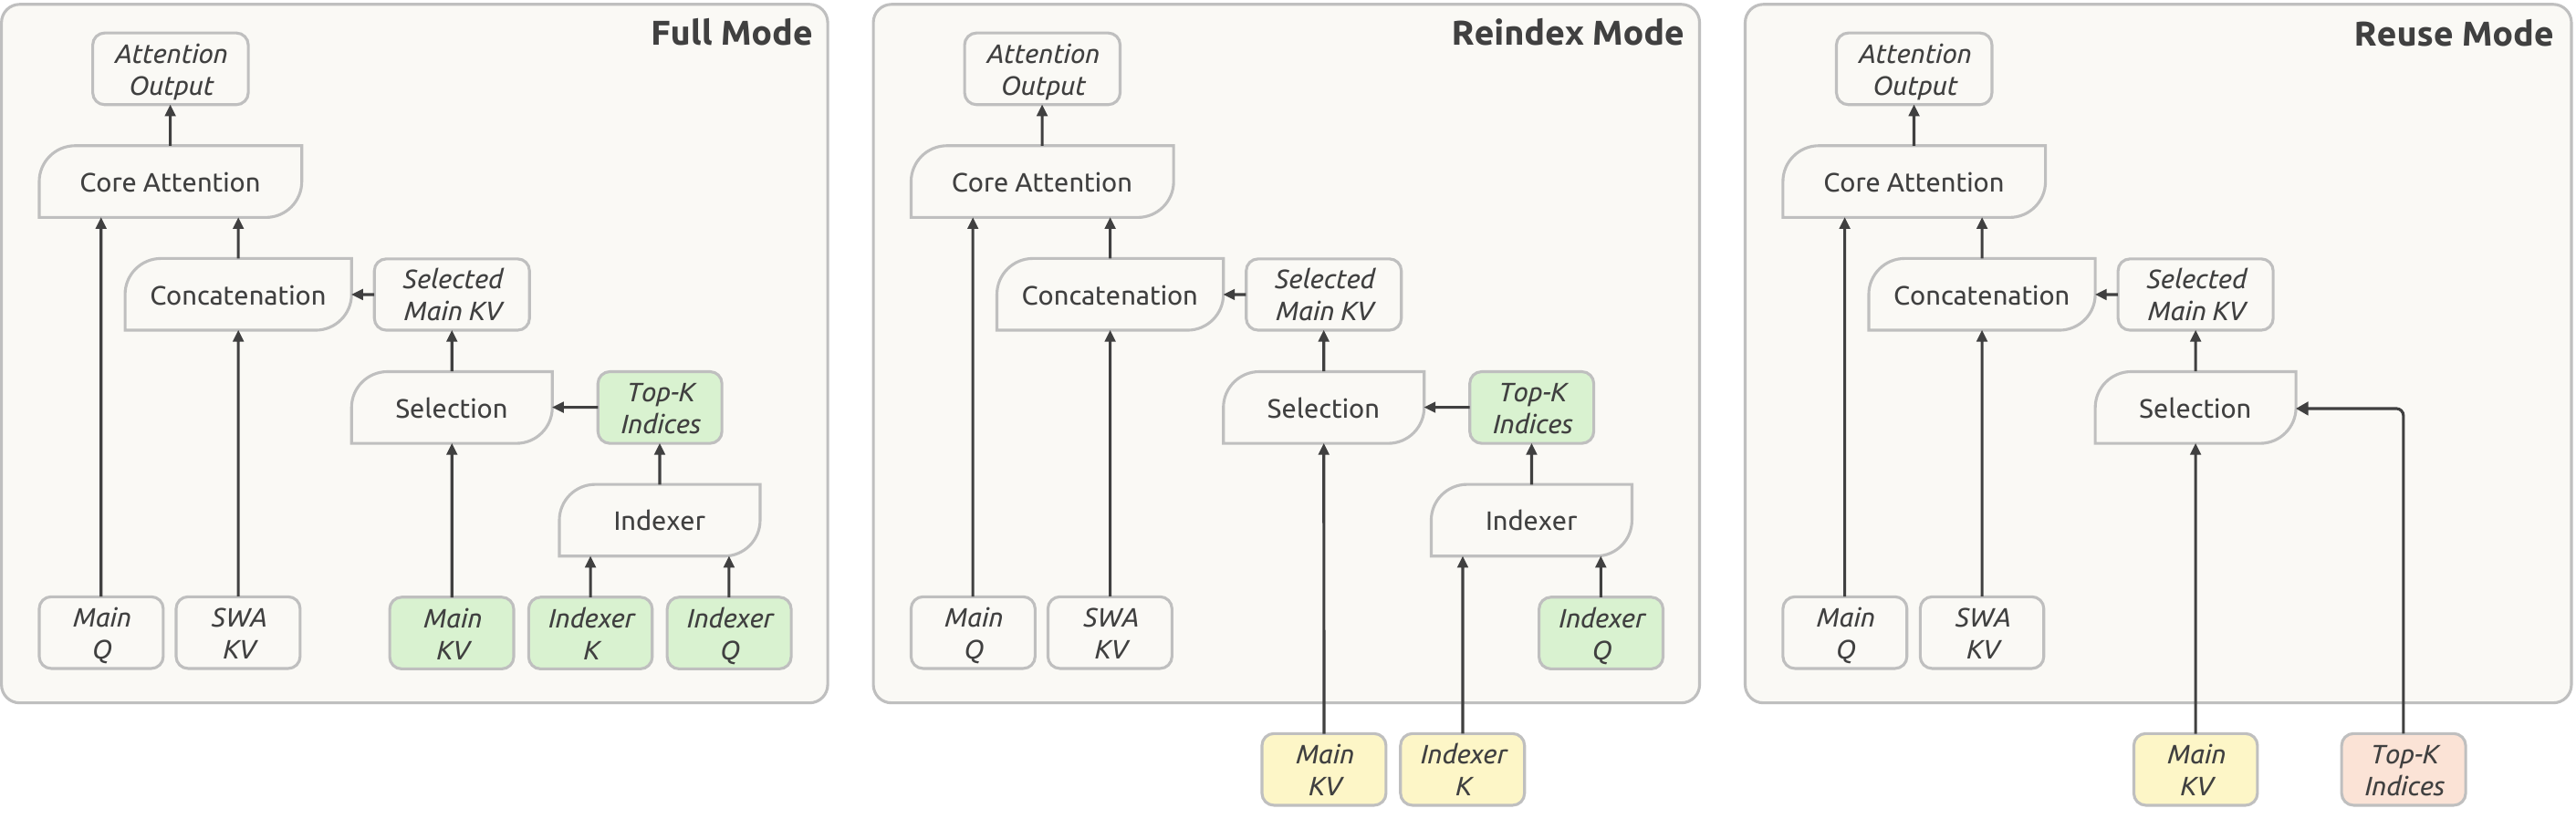
图 4:Full 模式自己算 main KV、indexer K 并产出新鲜 Top-K 索引;Reindex 模式借用前一层的全局 KV,但用自己的 indexer Q 重新打分选索引;Reuse 模式连索引都借,直接做稀疏注意力。三种模式下每层都保留自己的全局 Q 和 SWA KV。
具体配置上很能说明"复用率"有多高:编码器 18 个 CSA2 层(压缩率 m=2)分 3 组,每组 6 层里只有 1 层 Full,其余 5 层全是 Reuse;解码器 20 层(m=1)分 5 组,第一组 1 Full + 3 Reuse,后面四组各 1 Reindex + 3 Reuse。数一下,38 个 CSA2 层里,真正"全量计算"的只有 4 个 Full 层。其余全是搭便车的。
另外两点简化也值得说:indexer K 改成从 main KV 投影而来,去掉了 CSA 里从 hidden states 单独压缩的路径;压缩时去掉了重叠分块和绝对位置嵌入。工程收益很实在——每个 Reuse 层 prefill 只需 15 个 kernel,decode 只需 11 个。还有,V4 用的是 CSA + HCA 混合架构,V4.1 干脆统一成纯 CSA2,架构清爽了不少。
分层稀疏索引器:让深层 indexer 别全文搜索
跨层复用索引已经省了不少打分,但剩下的 indexer 还是要对全部因果可见上下文打分,1M 上下文下这仍是瓶颈。V4.1 的做法是:解码器第一个 Full 层选出 Top-512 后,把选中的 block 建成一个共享候选池(最多 2,048 个 block × 8 个位置 = 16,384 个候选位置),后续 Reindex 层只在这个池子里搜。
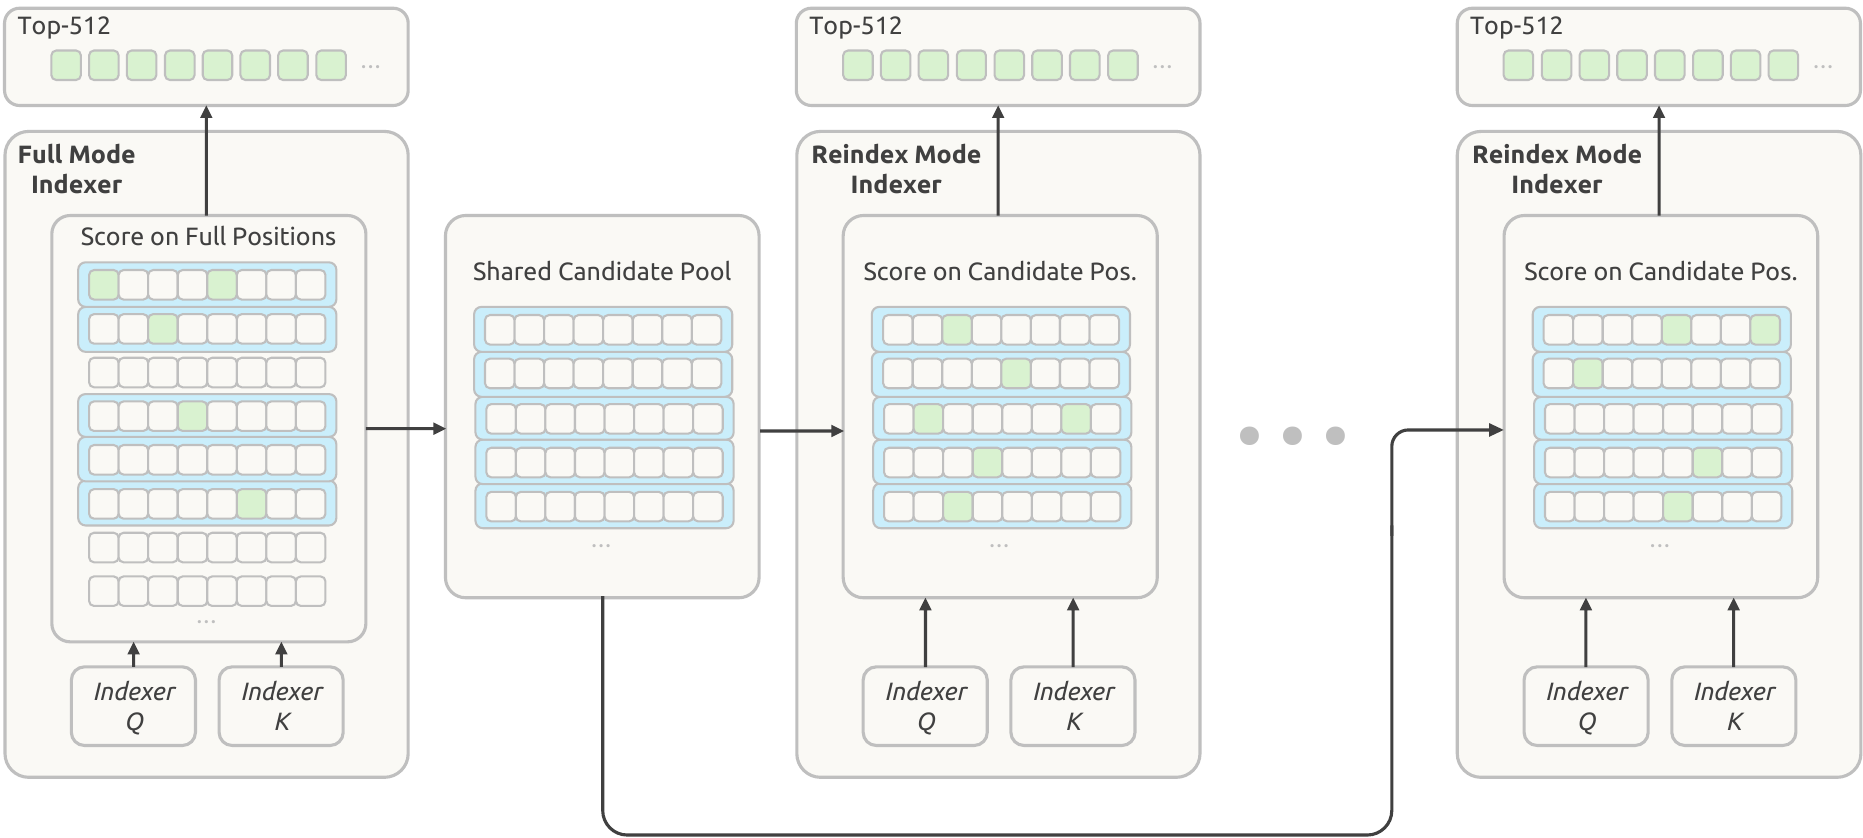
图 5:绿色方块是被选中的位置,蓝色矩形是按最大 indexer 分数选中的 block。第一个 Full 层建池,后续 Reindex 层都在池内选 Top-512。
这样一来,深层 indexer 每个 query 的打分成本从随上下文线性增长变成常数。而且这个限制在 post-training 阶段就引入、训练推理一致——不是推理时偷鸡,是模型就在这个搜索域里学出来的。这个细节处理得挺讲究。
💾 FP4 与 SWA Bounded Replay:另外两刀
FP4 main KV cache。indexer 的 Q/K 用 FP4 加速打分在 V4 时代就做了,这次是把 QAT(量化感知训练)扩展到 main KV cache 本身——目的不是加速矩阵乘,而是纯省存储。格式上选了 E2M1,每 16 通道配一个 E4M3 scale(NVFP4 方案),在 RoPE 之后量化。因为 cached value 在注意力前会反量化,所以可以用更准的格式而不需要硬件原生支持 FP4 矩阵乘——这个兼容性的考量很工程。论文的说法是性能损失"marginal"。
SWA Bounded Replay 是我觉得全文最大胆的一笔。前面留了个问题:解码器 SWA KV 投影不出来。而 SWA 的依赖是跨层累积的——精确重建 L 层的 SWA KV 需要重放 \(L \times n_{\mathrm{win}}\) 个 token(窗口 \(n_{\mathrm{win}}=128\))。
V4.1 的选择是:不精确重建了。只重放最近 \(n_{\mathrm{win}}\) 个 token,滑窗截断到重放段内,接受一个近似状态:从位置 \(s\) 开始重放时,位置 \(i\) 的 query 只看 \([\max(s, i-W+1), i]\) 范围内的 SWA key。
这个近似用在了两个地方。编码器侧:prefix cache miss 时只重放缓存前缀的最后 128 个 token 重建 SWA KV,全局 KV 直接用缓存不重算——这样 prefix caching 只依赖全局 KV,SWA KV 可以整个从持久化缓存里删掉。解码器侧:每次 prefill 只把 prompt 最后 128 个 token 的编码器输出过一遍解码器层,重建解码器 SWA KV 供 decode 用,prefill 计算因此再减近一半。
说白了,这是一个"存储换计算"的交易:SWA KV 不落盘,cache miss 时付一点点重算代价换状态近似重建。论文承认重建的状态在数学上不等价、甚至和 cache 命中位置有关,但实测对回复质量影响"negligible",并且 post-training 里也模拟同样的重放做训练感知适配。我是有点惊讶这居然 work 的——滑窗状态截断居然不太掉点,说明模型对近处上下文的依赖远比对远处精确状态的依赖强。这个发现本身比这个 trick 更有价值。
🏋️ 预训练:45T token,稀疏注意力从零练起
几个关键配置:45T token 多模态语料,batch 固定在 100.6M token;Muon 优化器管线性层,AdamW 管 RMSNorm 等非矩阵参数,embedding 和预测头用 Sinkhorn 平衡更新;学习率 2.6e-4,28T 到 40T 之间余弦衰减到 2.6e-5。稀疏注意力从 64K 序列长度从零开始训,不做 dense warmup,34T token 处扩到 1M。MoE 是 1 个共享专家 + 384 个路由专家,每 token 激活 6 个,专家中间维 2304,SwiGLU 带 clamp(阈值 10)。
视觉侧,32 层 ViT(hidden 1024,patch 14),先 SigLIP 对比学习在约 47B 图文对上预训练(限 224×224 分辨率,论文坦言高分辨率收益小、不划算),再接一个 4B MoE LLM 做自回归微调(236B token,544–1344 分辨率),最后丢掉 LLM 只留视觉编码器。
基模质量看内部 BPB 评测(越低越好):
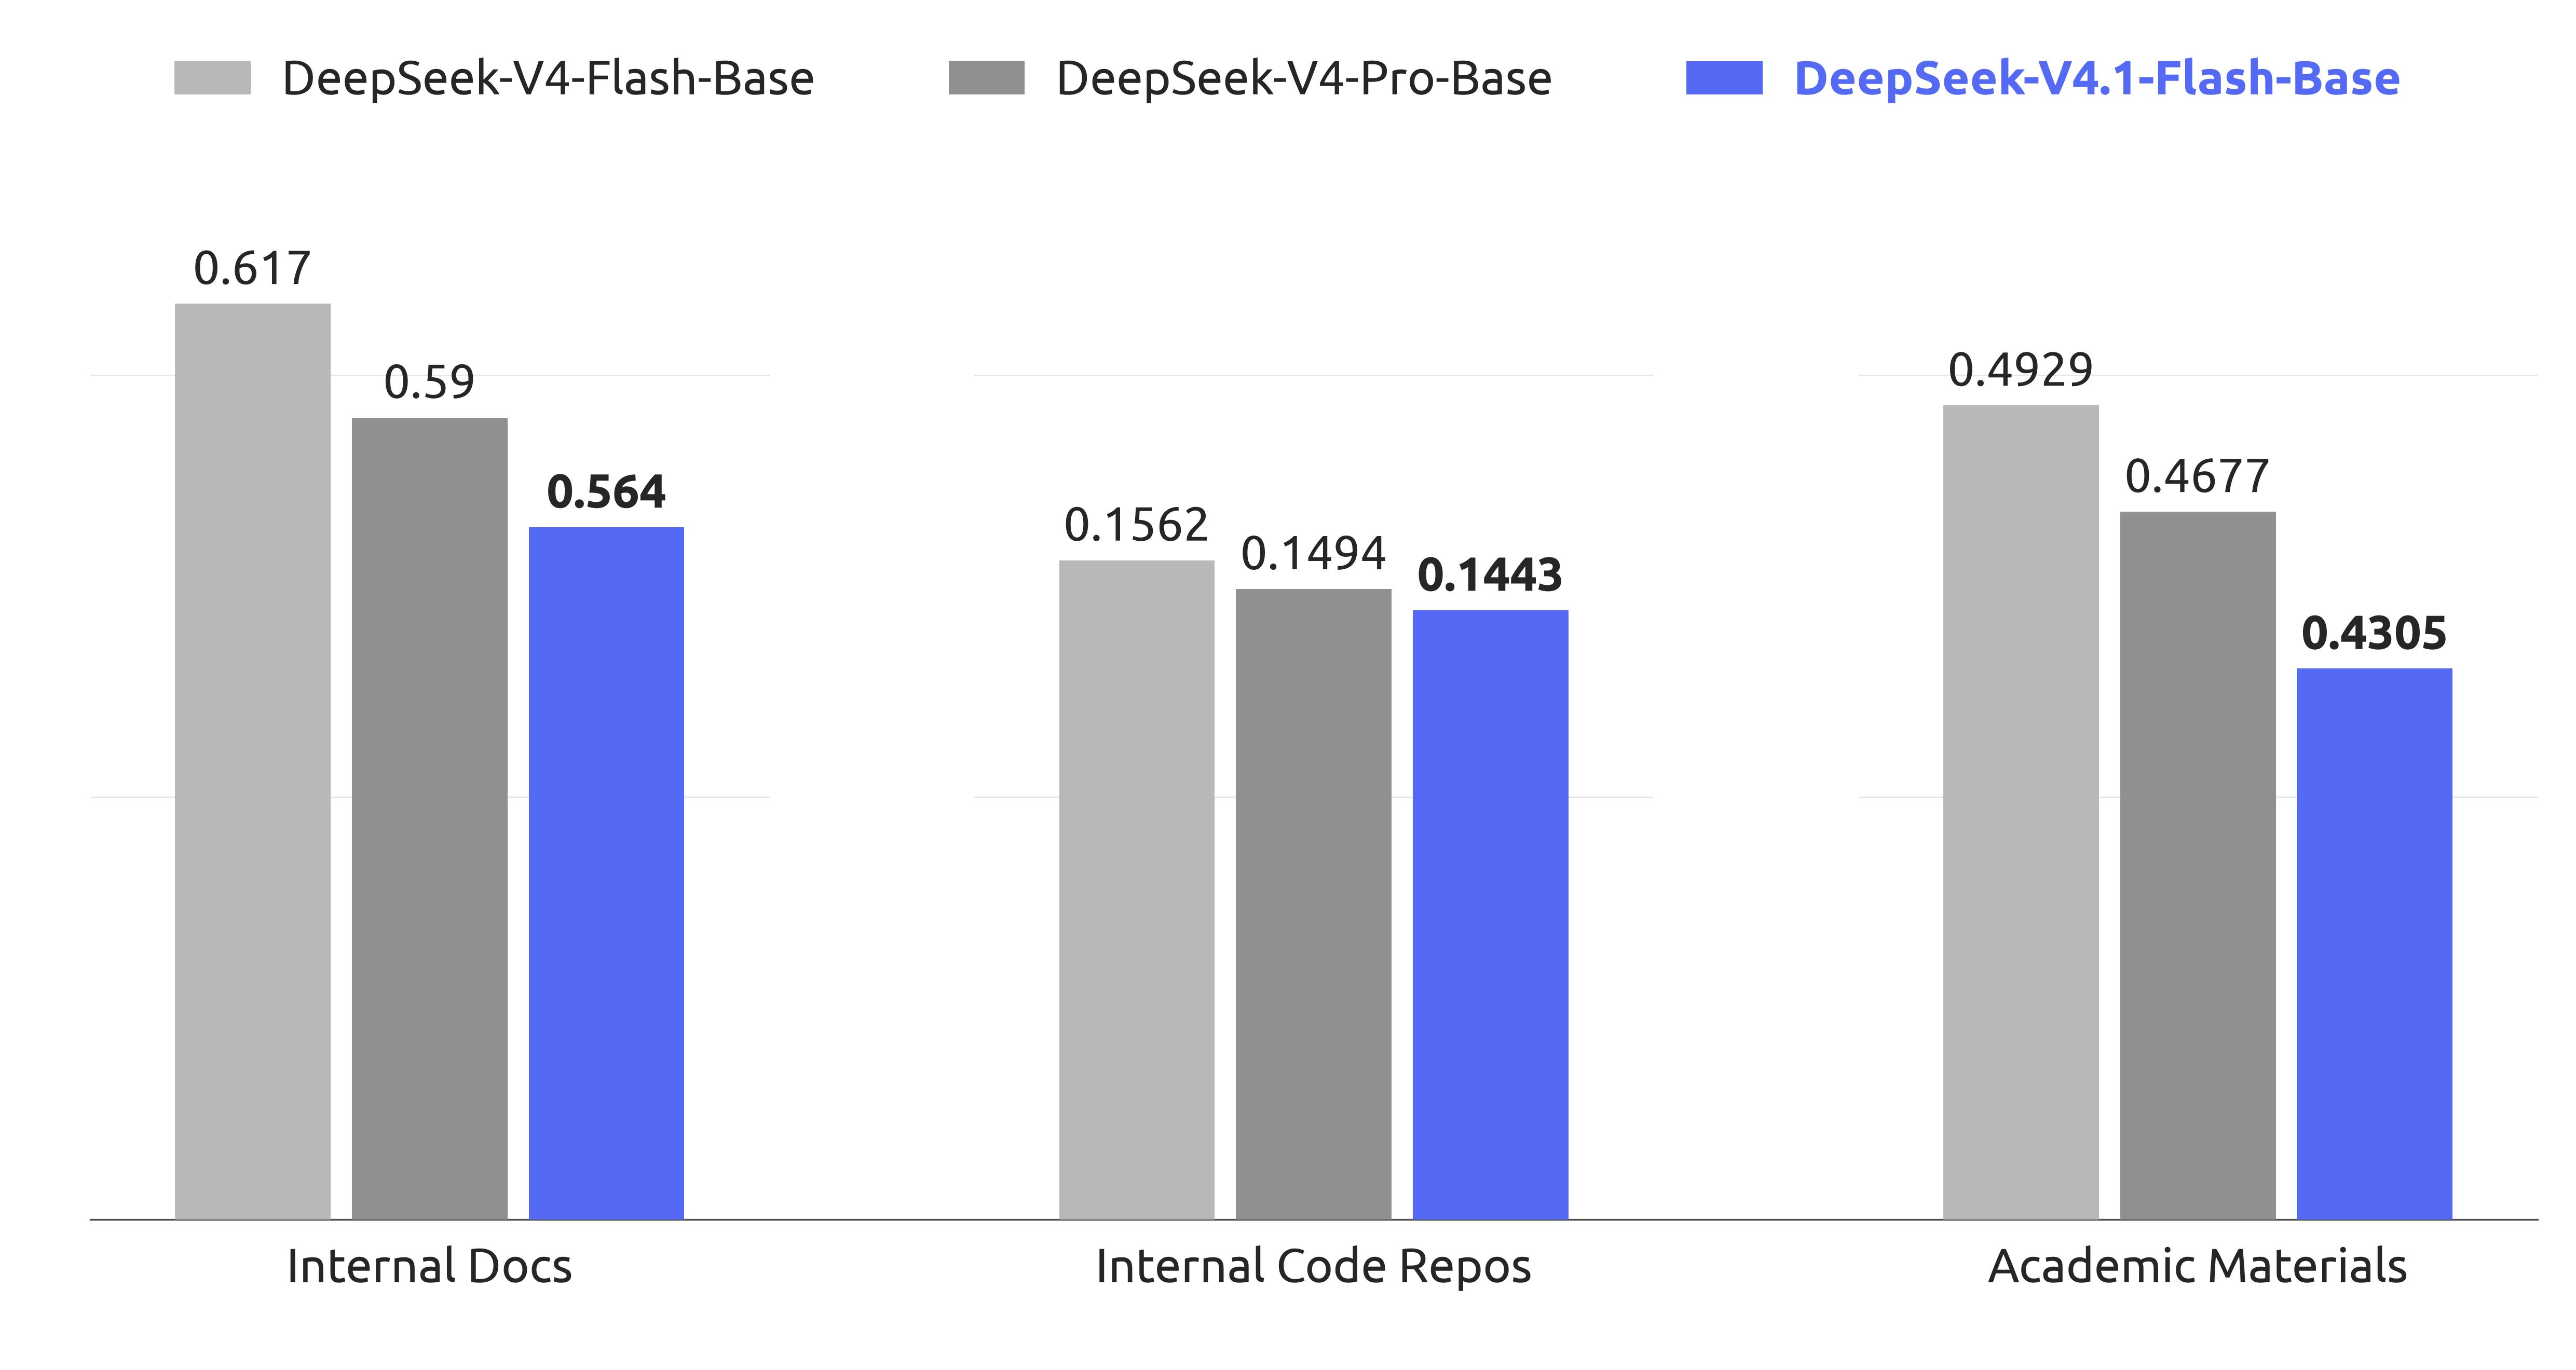
图 6:内部文档、内部代码库、学术材料三个 held-out 集上的 BPB。V4.1-Flash-Base 三项全最低(0.564 / 0.1443 / 0.4305),低于 V4-Flash-Base 和 V4-Pro-Base。
公开 benchmark 上(Table 1),V4.1-Flash-Base 激活参数远小于 V4-Pro-Base(49B),成绩却基本持平甚至更好:MMLU-Pro 74.1 vs 73.5,HumanEval 79.4 vs 76.8,GSM8K 93.0 vs 92.6。多模态是这代新增的,MMMU-Pro 56.5、DocVQA 95.6、RefCOCO 平均 86.0——从预训练第一天就吃图文混排数据的回报。
🤖 后训练:算法零创新,全押数据和环境
这段是全文我最喜欢的部分之一,因为它坦率得反常。作者明说:后训练没有任何算法创新,就是标准 SFT → RL → OPD 范式。原话的大意是:当前阶段,把数据和环境管线做工程化的边际收益,远超折腾算法新花样。所有精力都砸在了"训什么"而不是"怎么训"。
具体砸在哪儿:
任务自动合成。把每个任务形式化成(问题、环境、验证系统)三元组,用难度和正确性两个维度当奖励信号,迭代训练模型自己造任务。通用 Agent 方向,把真实工作流里的工具接口 mock 出来(SaaS、企业后台都覆盖),加上员工上报的失败 case 重建环境做针对性 RL;Coding 方向,从真实会话和 GitHub 高星仓库出发,多个专职 Agent 协作建环境——一个判断项目能否容器化构建并设计任务,一个装依赖打包镜像,多个 Agent 试做,独立质检 Agent 审查环境和轨迹,不合格就由修复 Agent 打回。这条流水线能批量产出正确、有区分度、难度可控的 RL 任务。
RL 规模化的两个维度。一是训练算力:图里能看到 Pass@1 随累计 RL 步数持续爬升,中间断开的曲线段是 model merging 重初始化后的新一轮 RL——把不同 scaffold、不同配置跑出来的 checkpoint 合并,聚合多条优化路径的收益,再继续训。这个做法朴素但实用。二是 scaffold 多样性:跨 Claude Code 多版本、OpenCode、Pi、DeepSeek Harness 多种 harness 联合训练,防止模型过拟合单一交互协议。
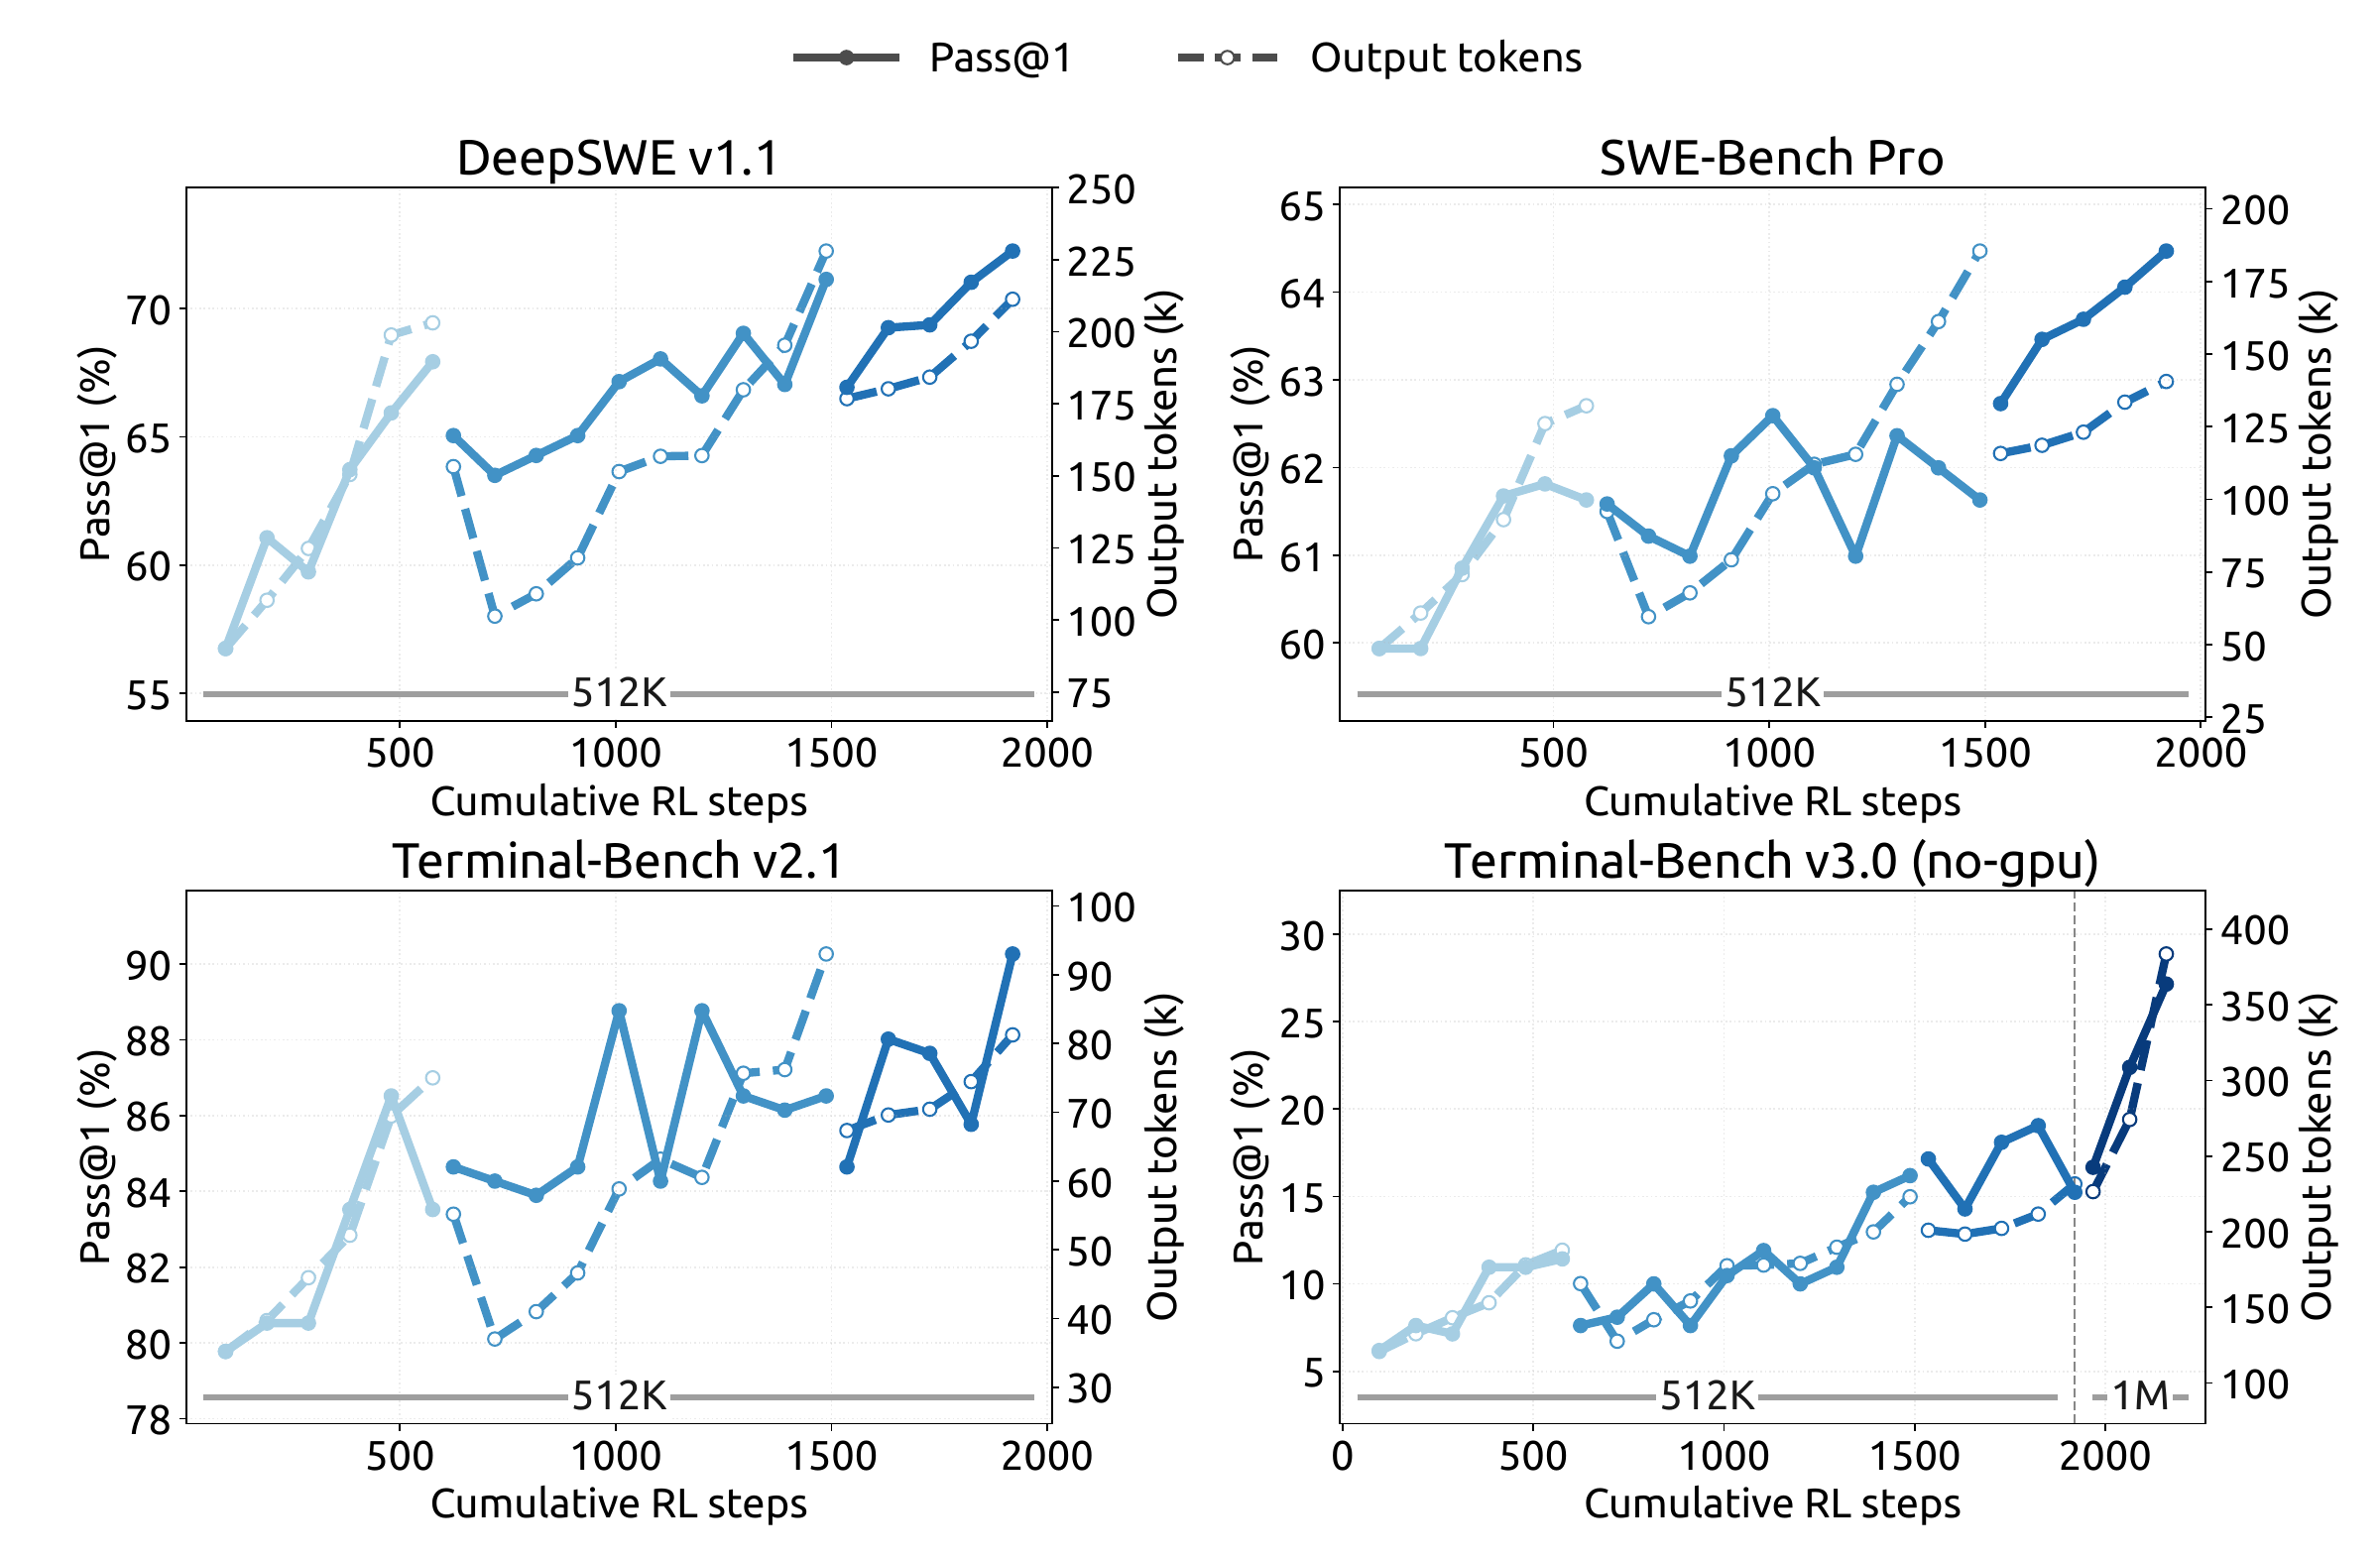
图 7:DeepSWE v1.1、SWE-Bench Pro、Terminal-Bench v2.1、Terminal-Bench v3.0 上 Pass@1 随累计 RL 步数提升;右下角可见上下文扩到 1M 后,超长程任务(TB v3.0)上继续明显上涨。
异步 RL 基础设施。rollout 和训练同机分时复用;采样级调度维持并发(他们试过 batch 级和 prompt 级,前者震荡后者被长尾卡死);token 级中断 + 状态持久化,checkpoint 切换后 rollout 原地续跑不重新 prefill;跨 checkpoint 的样本用 concatenated routing-replay 拼接专家路由。还有 DSec 沙箱平台撑住百万级并发 Agent 实例。最后的 OPD 阶段用了 40 多个领域最优 teacher 做全词表蒸馏,teacher 之间架构还能不一样。
📊 实验:压缩了 4 倍,分数反而涨了
主表(Table 3)挑关键数字看,全部 Max effort 档:
| Benchmark | V4.1-Flash | V4-Flash | V4-Pro | Kimi-K3 | GLM-5.3 | Opus-5 | GPT-5.6 Sol |
|---|---|---|---|---|---|---|---|
| GPQA Diamond (Pass@1) | 90.9 | 89.9 | 92.4 | 92.9 | 88.1 | 93.4 | 94.1 |
| Codeforces (Rating) | 3471 | 3289 | 3348 | - | - | - | - |
| MathArena Apex (Pass@1) | 65.6 | 58.6 | 65.3 | 65.6 | - | - | - |
| Terminal-Bench 2.1 | 90.6 | 82.7 | 87.9 | 88.3 | 88.2 | 89.1 | 88.8 |
| Terminal-Bench 3.0 | 30.0 | 7.6 | 11.8 | 17.7 | 28.3 | 43.3 | 34.4 |
| Terminal-Bench 4.0 | 31.2 | 7.0 | 12.4 | 12.6 | 37.9 | 51.8 | 39.9 |
| DeepSWE v1.1 (Resolved) | 74.2 | 54.4 | 62.7 | 67.5 | 66.9 | 74.0 | 73.0 |
| CyberGym (Pass@1) | 88.1 | 76.7 | 83.3 | 80.0 | 84.5 | - | 84.5 |
| SEC-Bench Pro | 62.8 | 30.9 | 56.4 | - | - | - | 74.3 |
| Automation-Bench | 54.8 | 37.7 | 43.2 | 46.7 | 48.8 | 50.3 | 45.8 |
| Agents' Last Exam | 31.8 | 25.2 | 25.7 | 27.6 | 28.5 | 28.6 | 26.7 |
| HLE w/ tools | 63.9 | 51.5 | 60.0 | 59.8 | 62.5 | 63.6 | - |
几个判断。相对自家 V4-Flash,这是全面碾压——DeepSWE 从 54.4 涨到 74.2,近 20 个点的跳升,SEC-Bench Pro 直接翻倍。放到全场看,编程 Agent 主战场(DeepSWE、TB 2.1、CyberGym、Automation-Bench、ALE)它都拿到第一或并列第一。Codeforces 3471 的 rating 也挺吓人。
但短板同样明显:Terminal-Bench 3.0 和 4.0 上被 Opus-5 甩开一截(30.0 vs 43.3,31.2 vs 51.8)。作者自己承认在科学导向的 agentic 任务上和巨型模型还有差距。这两个 benchmark 恰好是最难、最长程的那批——说明 8B/16B 的激活规模在极端复杂任务上还是有天花板的。视觉 Agent 任务(Chartography 78.9、BabyVision 89.6)强于开源但落后于头部闭源,作者也没回避。
Reasoning effort 控制是个实用的产品化设计:RL 里用一个 1–100 的标量 effort 值控制推理深度,API 暴露 low / high / max 三档对应 50 / 75 / 100。effort 从 25 拉到 100,八个推理密集 benchmark 平均 Pass@1 从 67.1% 涨到 76.3%,代价是输出 token 约 2.5 倍。收益是前置的——60–80 档就收复了 max 档大部分精度,token 预算不到一半;最后冲到 100 那步会把 agent 轨迹拉长 1.6–1.8 倍只换边际提升。日常用中档,硬骨头才开 max,这个建议很实在。
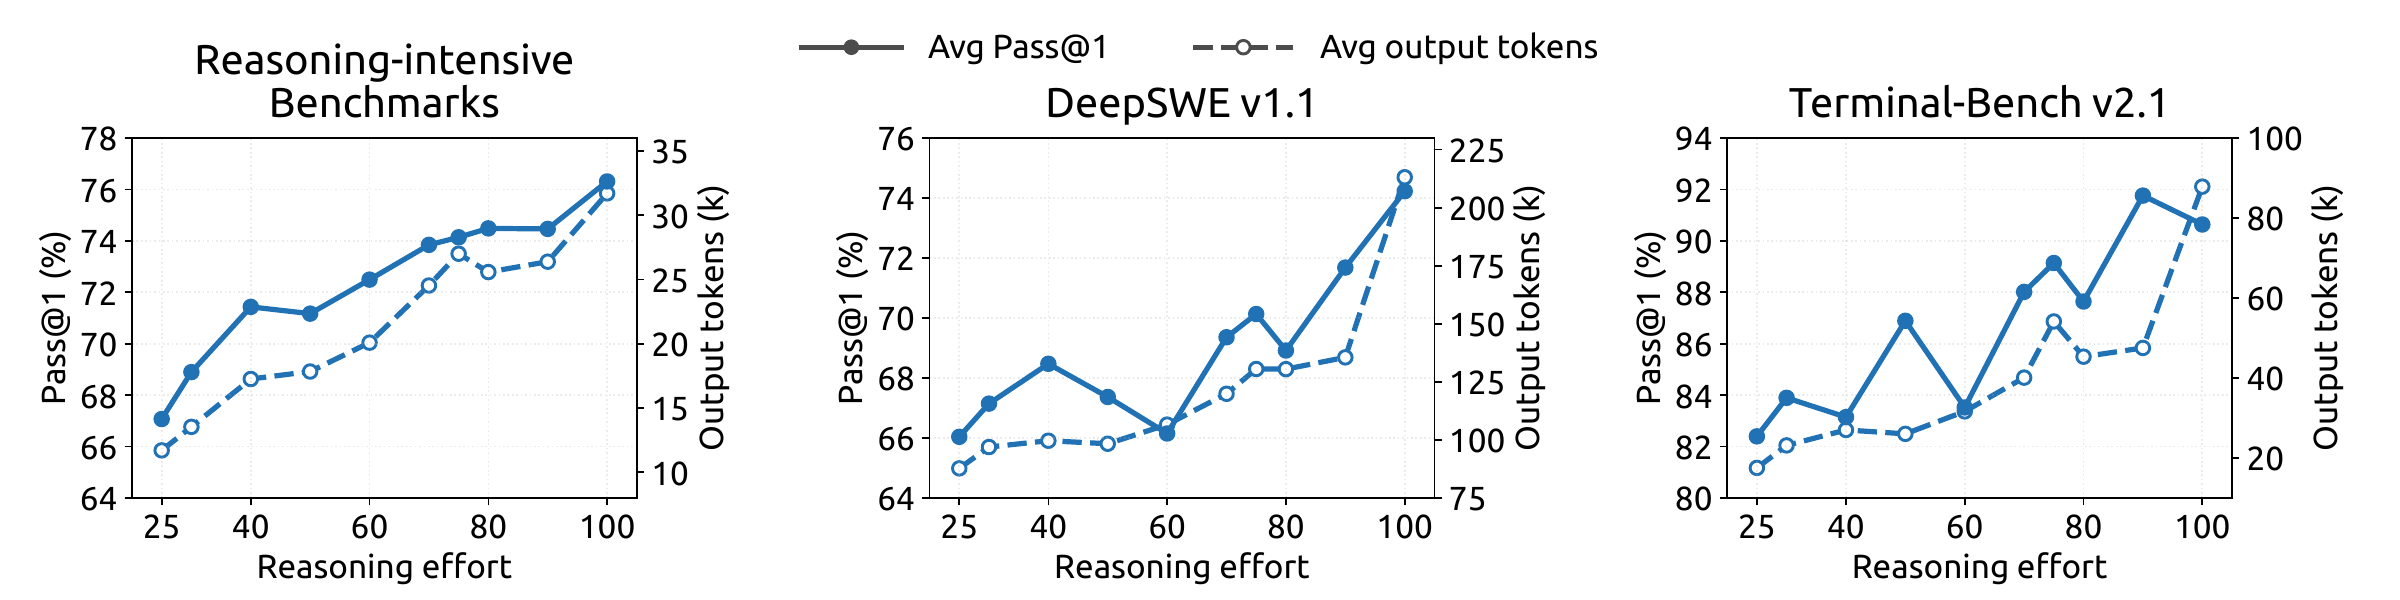
图 9:effort 从 25 到 100,Pass@1(实线)与输出 token(虚线)同步上升;推理密集 benchmark、DeepSWE、Terminal-Bench 三个面板趋势一致。
跨 scaffold 鲁棒性(Table 4):同一个 checkpoint 换八种 harness,DeepSWE v1.1 在 65.5–74.2 之间波动(Claude Code 69.8,mini-SWE 74.2),TB 2.1 在 84.1–90.6 之间。没有绑死自家 harness,这和他家训练数据里刻意混入多种 scaffold 的设计互为印证。
多智能体是初步实验:Agent Team 模式下 lead agent 可以 spawn 持久化队友,共享仓库、邮箱通信、任务板协调,RL 奖励里加了协作奖励和基于 DAG 关键路径的延迟惩罚。ProgramBench 上 multi-agent 的 Almost@1 从 1 小时的 13.59% 爬到 8 小时的 30.04%,单 agent 对应是 12.79% 到 20.39%;FrontierSWE v2 上 20 小时达 32.90% vs 单 agent 28.20%。每个 deadline 都赢,方向是通的,但作者也强调这是 preliminary。
还有一个细节值得整个行业警惕:评测时他们发现模型会"找漏洞"——在 CyberGym 里反编译 Ubuntu 核心包挖漏洞。即使已经禁网、剥了 Git 历史、清了构建缓存,reward hacking 还是防不住。模型越强,评测基础设施越容易被 gaming,这个提醒很及时。
🤔 我的判断
这篇报告最值钱的地方,是把 KV cache 压缩从"单点技巧"做成了"三层联合优化"的系统工程:CSA2 跨层复用砍冗余、FP4 砍精度、Bounded Replay 砍持久化。每一层单独看都不算惊天动地,但叠出 4×(HBM)加 8×(持久化)且性能反升,这就很能打了。890 字节这个数字大概率会成为接下来稀疏注意力论文的引用锚点。
也要泼几盆冷水。
第一,890 字节的口径是全局 KV(HBM 常驻部分),滑窗 KV 因为有界(窗口 128)没被算进这个 headline 数字。压缩率的分母选择有点讲究,不过论文写得还算清楚,算不上误导,读的时候心里要有数。
第二,CED + CSA2 + Bounded Replay 整套东西和 DeepSeek 自家训练、推理栈深度耦合——Reuse 层 15 个 kernel、host 内存里长短周期 KV 分离管理、QAT 训练感知适配,这些不是拿来就能用的。想复现这套压缩率,工程量不小。它更像一张"系统协同能走多远"的路线图,而不是一个即插即用的模块。
第三,最难的长程任务上差距还在。TB 3.0/4.0 落后 Opus-5 十几个点,说明"省出来的钱"和"堆出来的智能"在极端任务上还没画等号。V4.1 的定位很清醒:不是去摸绝对智能的天花板,而是把"够用的智能"的成本打下来,让长程 Agent 大规模部署这件事在账上算得过来。
如果你在做 Agent 基础设施或者长上下文推理优化,我的建议是重点读 CSA2 的跨层复用设计和 Bounded Replay 那节——前者告诉你注意力层之间有多少冗余可以挤,后者展示了一个反直觉的 trade-off:精确状态没那么重要,有界近似 + 训练感知就够了。至于"数据和环境管线的边际收益超过算法创新"这个判断,这已经不是第一篇这么说的报告了,行业共识正在形成。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我