SpectralShift:给 Gated DeltaNet 做长上下文扩展,答案藏在遗忘门的"频谱"里
不知道大家有没有注意过一个现象:现在主流的混合架构大模型——MiniMax-01、Qwen3.5、Kimi Linear 这些——线性注意力层撑起长上下文的半壁江山,上下文窗口动辄 256K 甚至 1M。但你翻它们的技术报告,关于"线性注意力层是怎么扩展到这么长的"这件事,几乎都是语焉不详。位置编码怎么调、RoPE base 怎么改,写得明明白白;线性注意力层?直接 continued pretraining,完事。
说实话我第一次意识到这个问题的时候也挺惊讶的。Transformer 的长上下文扩展早就成了一个精细的手艺活——NTK、YaRN、ABF 一堆方法轮着上——而线性注意力这边,大家默认它"不需要位置编码所以不用管"。但这真的合理吗?循环状态的动力学特性在 8K 训练长度下学到的遗忘模式,凭什么到了 128K 还能用?
人大高瓴联合 IQuest Research、MSRA 的这篇 SpectralShift(arXiv: 2609.14320),就是冲着这个被忽视的角落去的。它给出的答案挺漂亮:问题不在"要不要改",而在"改哪里"——用转移矩阵的频谱视角一看,长上下文检索能力由两个因素决定,于是他们只对遗忘门的 alpha 投影做了一次重参数化加一个学习率缩放,就把事情办了。
核心摘要:这篇论文研究 Gated DeltaNet(GDN)的上下文窗口扩展问题。作者从转移矩阵的谱动力学角度分析发现,长程信息检索取决于两件事:足够宽的"慢速谱带"(能覆盖目标依赖距离的慢衰减状态方向要够多),以及快速衰减模式的保留(用于状态清空和上下文切换)。基于这个观察,SpectralShift 对 alpha 投影做均值中心化重参数化(缩放因子 \(s=(L_{\mathrm{ref}}/L_{\mathrm{tar}})^{0.5}\)),并在训练中只对 alpha 投影缩放学习率。在 1.5B-A0.6B 的 GDN-MoE 上,8K→128K 两阶段扩展后 RULER 平均分 55.18 对 baseline 的 52.38,相对提升约 5.35%,且通用能力不掉。我的判断:这不是工程 trick 的堆叠,而是第一次有人把线性注意力的长上下文扩展从"玄学调参"拉到了"有谱可循"的层面,分析部分比方法本身更值钱。
📖 论文信息
- 标题:SpectralShift: Effective Context Window Extension of Gated DeltaNet via Spectral Reparameterization
- 作者:Zian Liu、Yiwen Hu(共同一作)、Zican Dong、Tian Xie、Wayne Xin Zhao(通讯)、Yucheng Ding、Ran Tao、Bryan Dai(通讯)
- 机构:中国人民大学高瓴人工智能学院、IQuest Research、Microsoft Research Asia
- 发表:2026 年 9 月 13 日,arXiv: 2609.14320 [cs.CL]
- 代码:https://github.com/RUCAIBox/GDN-SpectralShift
🎯 问题动机:被遗忘的线性注意力层
先把背景捋清楚。现在的长上下文模型大量采用混合架构:一部分层用 softmax attention 负责精确检索,大部分层用线性注意力(GDN、Mamba-2、Kimi Delta Attention 这类)负责压缩历史。线性注意力把历史压进一个固定大小的循环状态,计算量随序列长度线性增长,这是它能上 1M 上下文的根本原因。
但代价也很直接:softmax attention 里所有历史 token 都是显式可访问的,而循环模型只能靠那个有限维的状态矩阵去"记"东西。长上下文能力说到底取决于——这个状态能不能把信息保留到需要的依赖距离上。
现有的上下文扩展流程是:调位置编码(ABF、YaRN 之类),然后在更长序列上 continued pretraining。这套流程是为 softmax attention 设计的,线性注意力层被原封不动地带过去了。作者点破了这里的不匹配:循环转移动力学是在原始长度(比如 8K)下学出来的,直接搬到 128K 上用,遗忘节奏根本对不上。
举个直白的例子。一个在 8K 上训练的 GDN,它的遗忘门 α 学到的衰减速度,刚好让信息在 8K 的窗口里"该记的记住、该忘的忘掉"。现在你让它处理 128K——针尖(needle)在第 2000 个 token,问题在第 100000 个 token——中间隔着 98000 步的连续衰减,信息早被磨没了。这就是为什么纯 GDN 模型在 NIAH(大海捞针)上分数惨不忍睹:论文里的探测实验显示,8K 窗口下原始 GDN 的 NIAH 平均分只有 8.60,32K 下 10.07。
🧠 核心分析:用频谱视角拆开 GDN 的遗忘机制
这部分是全文最值钱的地方,我建议慢慢看。
GDN 的状态更新与转移矩阵
GDN 每个头维护一个矩阵状态 \(\mathbf{S}_t\in\mathbb{R}^{d_k\times d_v}\),更新规则是带门控的 delta rule:
其中 \(\alpha_t\in(0,1]\) 是保留门(忘不忘旧信息),\(\beta_t\in(0,1)\) 是更新强度(写不写新信息)。
一条信息从位置 \(i\) 活到位置 \(j\),要经过转移矩阵的连乘 \(\boldsymbol{\Phi}_{i\rightarrow j}=\mathbf{A}_j\mathbf{A}_{j-1}\cdots\mathbf{A}_{i+1}\)。信息能不能活下来,全看这个矩阵的奇异值衰减得有多快。作者定义了第 \(r\) 个状态方向的有限时间衰减率:
这个 \(\gamma_r\) 还能拆成两部分:head 级共享分量 \(\gamma_\alpha=-\frac{1}{\ell}\sum_t\log\alpha_t\)(由遗忘门 α 决定,整头所有方向一起缩放),和奇异值分量 \(\gamma_{\mathbf{R},r}\)(由 key 方向和 β 决定,跟输入内容纠缠在一起,难改)。
这个分解很关键。它告诉你:想动频谱,α 投影是最顺手的旋钮——它对整个头的所有方向施加统一的衰减缩放,而且不依赖 key 的具体方向。
慢速谱带:长上下文记忆的容量指标
有了衰减率,就能定义"慢速谱带":对跨度为 \(\ell\) 的依赖,凡是满足 \(\sigma_r(\boldsymbol{\Phi}_{i\rightarrow j})\geq e^{-1}\)(即有效时间尺度 \(1/\gamma_r \geq \ell\))的状态方向,构成慢速谱带 \(\mathcal{S}_\ell\)。谱带的宽度 \(|\mathcal{S}_\ell|\) 就是"能覆盖这个距离的状态方向有多少个"。
你想想看,这其实是个很自然的容量视角:长上下文检索不是靠一两个"超长记忆"方向撑起来的,而是靠足够多的慢速方向形成宽带存储。单个方向能存的信息有限,谱带越宽,能并行承载的长程信息越多。
作者用 NIAH 探测实验验证了这个视角。他们构造了两组模型做对比:Low-Retrieval(原始 GDN)和 High-Retrieval(缩放 alpha 投影、让更多奇异值超过 \(e^{-1}\) 的版本),在最长的 needle-query 距离上统计两个量——拥有至少一个慢速模式的 head 数 \(H_\ell^{\mathrm{slow}}\),和任务匹配的慢速模式总数 \(M_\ell^{\mathrm{slow}}\):
| 窗口 | 距离 \(\ell\) | 模型 | \(H_\ell^{\mathrm{slow}}\) | \(M_\ell^{\mathrm{slow}}\) |
|---|---|---|---|---|
| 8K | 6535 | Low-Retrieval | 18 | 1036 |
| 8K | 6535 | High-Retrieval | 22 | 1308 |
| 32K | 26195 | Low-Retrieval | 15 | 984 |
| 32K | 26195 | High-Retrieval | 19 | 1109 |
表 1:任务匹配的慢速谱容量对比。High-Retrieval 的慢速模式更多、分布的 head 更广——长程传播靠的是宽带而非个别方向。
光有容量还不够。慢速子空间在那儿,信息得写得进去才行。作者又定义了写入对齐度 \(E_{\mathrm{write}}=\|\mathbf V_{\mathcal{S}_\ell}^{\top}\mathbf k_i\|_2^2/\|\mathbf k_i\|_2^2\),即 needle 的 key 向量投影到慢速输入子空间的比例:
| 窗口 | 组别 | \(E_{\mathrm{write}}\) | NIAH 平均分 |
|---|---|---|---|
| 8K | Low-Retrieval | 0.1006 | 8.60 |
| 8K | High-Retrieval | 0.1503 | 32.93 |
| 32K | Low-Retrieval | 0.0964 | 10.07 |
| 32K | High-Retrieval | 0.1819 | 30.47 |
表 2:写入方向与慢速子空间的对齐度。\(E_{\mathrm{write}}\) 越高,NIAH 分数越高——从 8.6 到 32.93,接近 4 倍。
看到 8.60 到 32.93 这个数的时候我停了一下。写入对齐度从 0.10 提到 0.15——绝对值都不大——NIAH 直接翻了将近四倍。这说明 GDN 的长上下文瓶颈真的很"谱":不是模型记不住,而是信息根本没写进能活过整个距离的那些方向里。
还有第三个发现,同样重要:扩宽慢速谱带并不会挤掉快速衰减的分量。附录里的实验显示,把最慢方向的时间尺度 \(\tau_1\) 小于阈值 \(\tau_0=0.1\) 的 head 定义为"快 head",High-Retrieval 组在 8K 和 32K 下分别保留 5 个和 5 个快 head,与 Low-Retrieval 的 4 个、5 个基本持平。快速衰减模式负责状态清空和上下文切换——聊完一个话题要翻篇,靠的就是它们。扩慢谱的同时保住快谱,这是设计的约束条件,不是可选项。
🏗️ 方法:SpectralShift 的两步操作
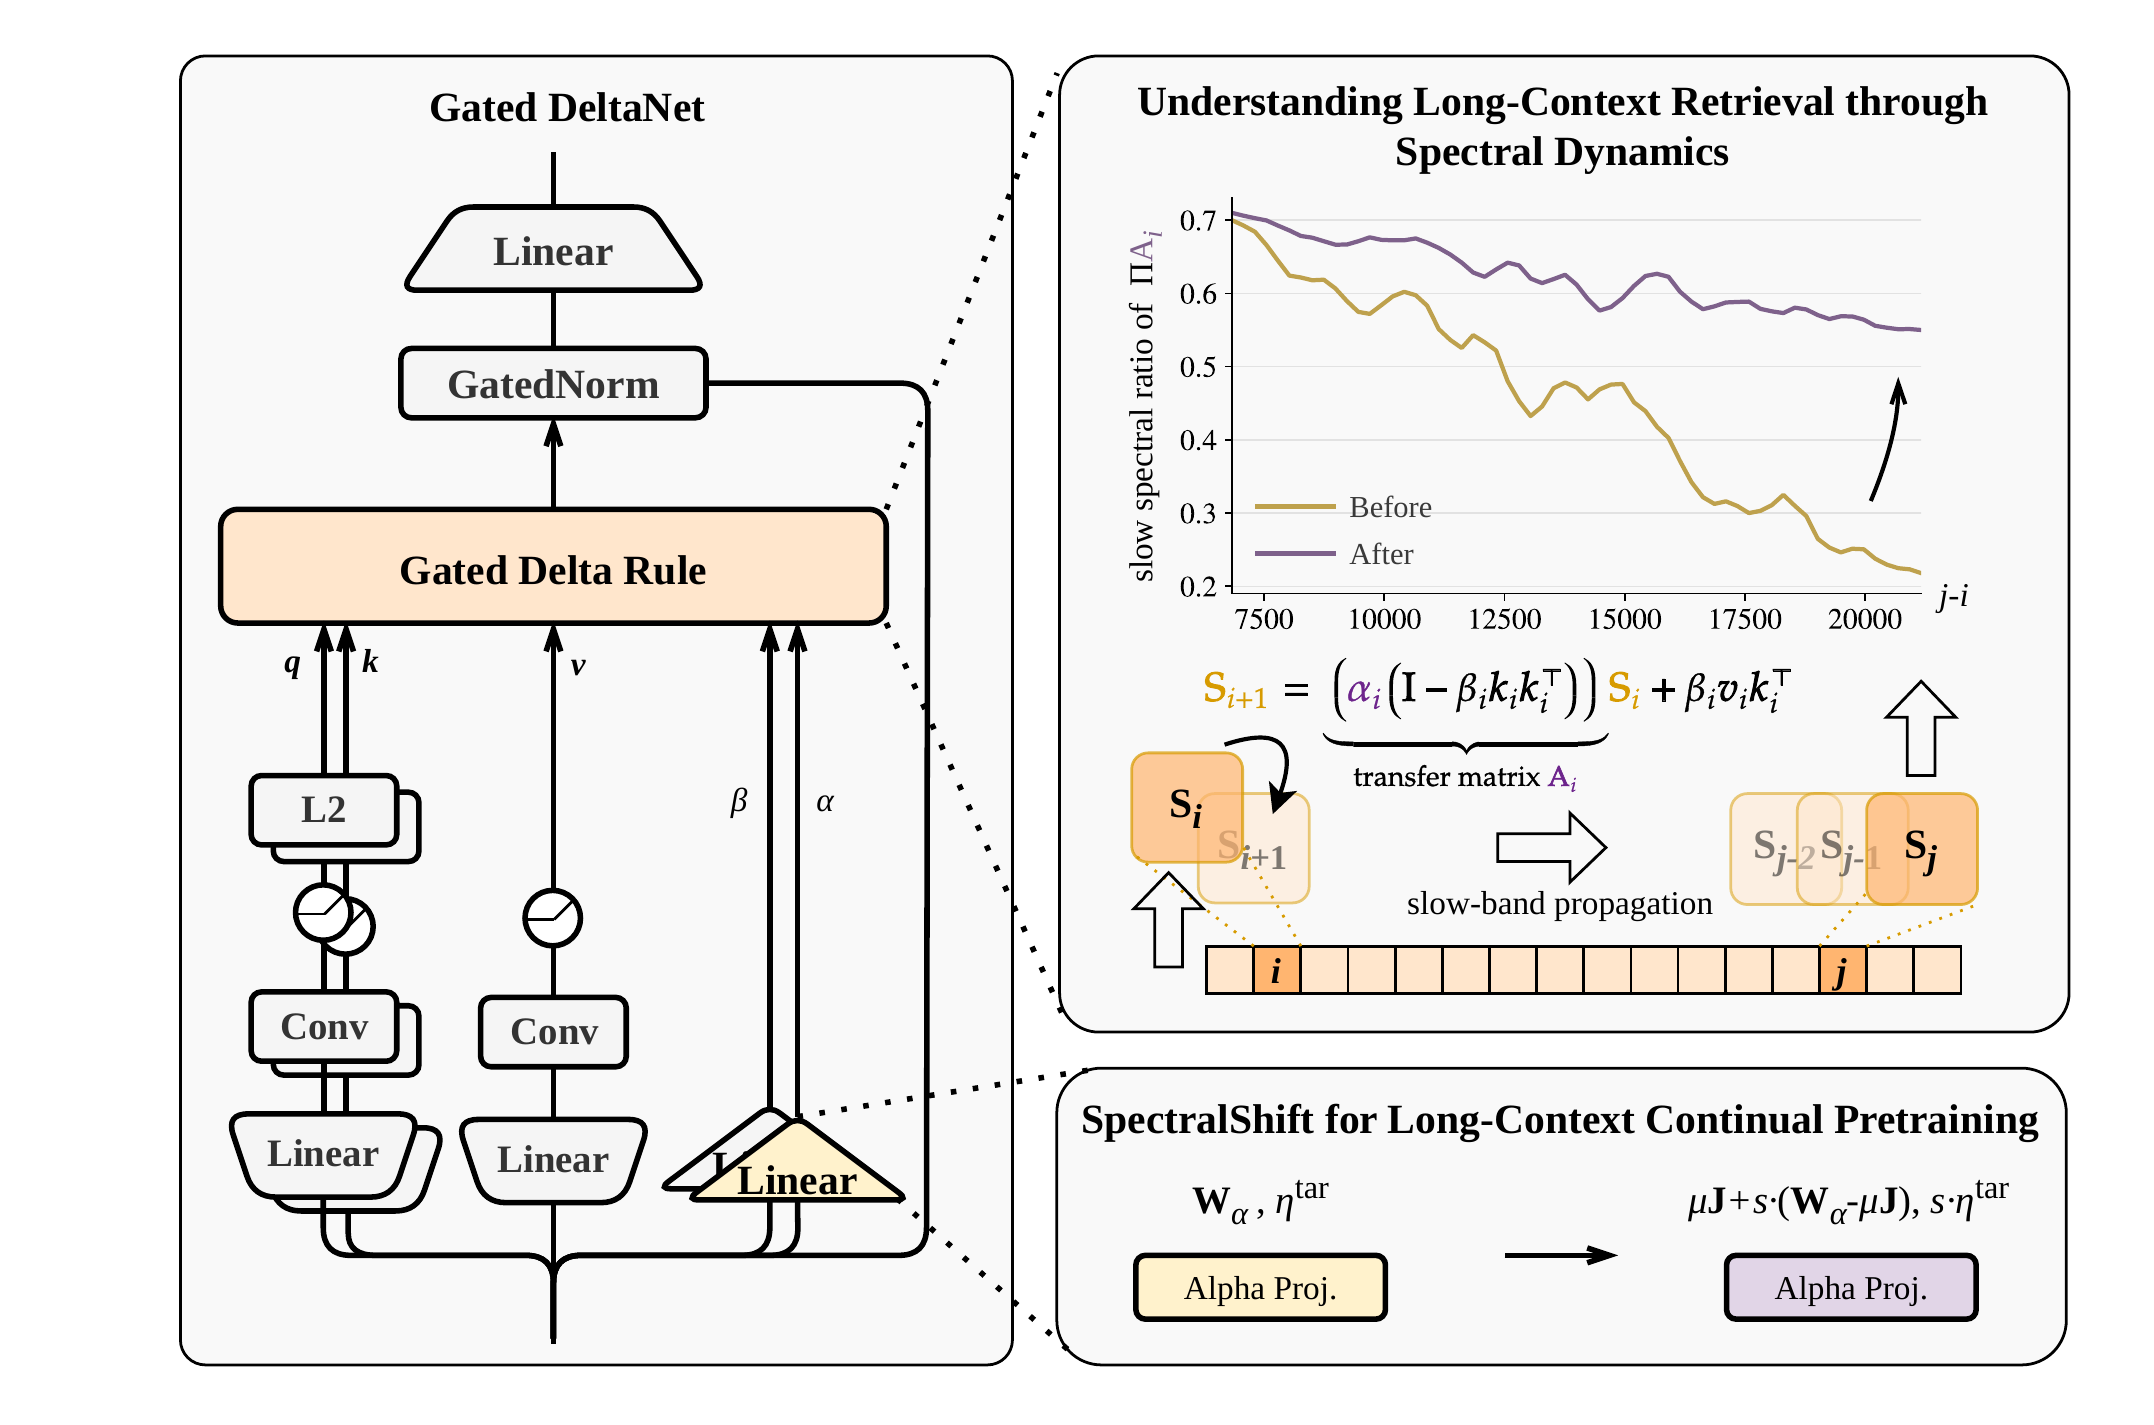
图 1:SpectralShift 总览。左侧是 Gated DeltaNet 的结构——q、k 走 L2 归一化和短卷积,v 走卷积,β 和 α 由各自的 Linear 投影产生,核心是 Gated Delta Rule 加 GatedNorm。右上是谱动力学分析:状态更新 \(S_{i+1}=\alpha_i(I-\beta_i k_i k_i^\top)S_i+\beta_i v_i k_i^\top\) 中的转移矩阵连乘,慢速谱带负责把 \(S_i\) 的信息传到 \(S_j\);曲线图展示了扩谱前后(Before/After)慢速谱占比随距离 \(j-i\) 的变化——Before 在 7500 到 20000 的距离上从 0.7 掉到 0.2,After 则基本维持在 0.55 以上。右下是 SpectralShift 的操作:alpha 投影从 \(\mathbf{W}_\alpha\) 变成 \(\mu\mathbf{J}+s(\mathbf{W}_\alpha-\mu\mathbf{J})\),学习率从 \(\eta^{\mathrm{tar}}\) 变成 \(s\cdot\eta^{\mathrm{tar}}\)。
基于上面的分析,方法设计其实很克制——只动 alpha 投影,别的都不碰。
第一步:Alpha 重参数化(谱初始化)
把 alpha 投影的输出分解成"共享幅度"加"输入依赖的偏差":
其中 \(\mathbf{J}\) 是全 1 矩阵,\(\mu_\alpha^{\mathrm{ref}}\) 是 \(\mathbf{W}_\alpha^{\mathrm{ref}}\) 的全局均值。然后对偏差项做缩放:
这个操作的直觉是什么?\(\mathbf{c}_t\) 是所有输入共享的衰减基底,\(\boldsymbol{\xi}_t\) 是内容相关的调整。缩小 \(s_1\) 等于压缩内容相关偏差的幅度。论文的引理 1 证明了由此产生的非对称效应:\(\xi_t>0\) 的 head 保留能力变强(变慢),\(\xi_t \lt 0\) 的 head 衰减更快(变快)。累积起来,一些 head 被推向慢速区,另一些保持快遗忘——一个非均匀的谱初始化,慢谱带被拉宽,快模式还活着。
缩放因子取多少?作者在幂律族 \(s_k=(L_{\mathrm{ref}}/L_{\mathrm{tar}})^k\) 里做尺度匹配推导,理论最优是 \(k=0.5\),即 \(s_1=\sqrt{L_{\mathrm{ref}}/L_{\mathrm{tar}}}\)。8K 扩到 128K,\(s_1=\sqrt{1/16}=0.25\)。附录里这个推导是从累积 log 保留量的尺度匹配出发的,后面消融实验也验证了 0.5 确实是甜点。
第二步:长度缩放的学习率(谱保持)
初始化把谱摆好了,接下来的 CPT 别把它搅乱。定理 1 给出了 alpha 投影更新对共享衰减 \(\gamma_\alpha\) 的一阶扰动界:在一定条件下,存在与长度无关的常数 \(C_\alpha\),使得
也就是说,给 alpha 投影单独配一个缩放后的学习率 \(\eta_\alpha^{\mathrm{tar}}=s_2\eta^{\mathrm{tar}}\),就能直接控制整头谱的集体漂移——防止训练把刚拉宽的慢谱带又给练回去。与此同时,β、key、value 的更新不缩放,让它们正常适应长序列数据的方向性转移和写入。
实现上取 \(s_2=s_1=(L_{\mathrm{ref}}/L_{\mathrm{tar}})^{0.5}\),一套因子管两处。整个算法就这么多:抽出 \(\mathbf{W}_\alpha\),均值中心化重参数化,alpha 学习率乘 \(s\),然后正常 CPT。定理 2 把两步的联合效果收拢成总谱位移 \(D_r=\delta_r^{\mathrm{init}}+\delta^{\mathrm{CPT},\alpha}+\delta_r^{\mathrm{CPT},\Delta}\),并给出充分条件保证任务相关模式满足 \(D_r \geq g_\star/(2\ell) \gt 0\)——参考慢模式被保住,靠近边界的模式被拉进任务匹配的慢谱带。
说实话这个方法的"轻"让我有点意外。没有新模块,没有新损失,没有额外训练阶段——就是初始化时改一下权重、训练时改一下学习率。但正因为轻,它背后那套谱分析才显得硬:你知道自己在动哪个旋钮、为什么动、动多少。
🧪 实验:数字说话
实验设置
作者从零训了一个 1.5B-A0.6B 的 GDN-MoE 混合模型(Dolma3 语料,8K 上下文,500B token,Muon 优化器,恒定学习率 8.6e-4),然后做 8K→32K/64K/128K 扩展。64K 和 128K 还试了分段课程(先从 8K 到 32K 的 checkpoint 接着扩)。通用能力看 MMLU、LAMBADA、ARC-Easy、WinoGrande、PiQA 五项平均;长上下文看 RACE、DROP 和 RULER(8K 到 128K)。Baseline 就是"只调 RoPE(ABF)直接 CPT"的标准做法。
主实验
| 最大长度 | 课程 | 方法 | 通用平均 | DROP | RACE | RULER-8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|---|---|---|---|
| 8K | / | Base Model | 53.8 | 22.5 | 33.9 | 45.8 | -- | -- | -- | -- |
| 32K | 10B | SpectralShift | 53.1 | 21.5 | 34.2 | 57.1 | 52.9 | 45.8 | -- | -- |
| 32K | 10B | Baseline | 54.3 | 22.3 | 33.8 | 55.5 | 49.7 | 40.6 | -- | -- |
| 64K | 10B+10B | SpectralShift | 55.6 | 24.1 | 33.0 | 64.0 | 59.7 | 52.7 | 45.4 | -- |
| 64K | 10B+10B | Baseline | 55.0 | 21.6 | 31.3 | 61.1 | 56.5 | 47.0 | 41.6 | -- |
| 64K | 20B | SpectralShift | 55.0 | 24.3 | 32.4 | 64.6 | 59.7 | 54.3 | 48.4 | -- |
| 64K | 20B | Baseline | 54.8 | 22.0 | 32.1 | 64.2 | 60.5 | 53.9 | 46.4 | -- |
| 128K | 10B+10B | SpectralShift | 54.8 | 22.1 | 33.4 | 64.6 | 60.1 | 56.7 | 49.9 | 44.6 |
| 128K | 10B+10B | Baseline | 53.7 | 20.7 | 32.4 | 64.3 | 57.2 | 51.9 | 45.4 | 43.1 |
| 128K | 20B | SpectralShift | 54.0 | 22.3 | 31.7 | 62.2 | 56.3 | 49.8 | 42.9 | 42.2 |
| 128K | 20B | Baseline | 52.9 | 15.6 | 33.1 | 58.1 | 52.2 | 46.1 | 42.0 | 41.9 |
表 3:不同扩展设置下的通用与检索评测。粗体为该长度组内最优。
几个值得盯着看的数:
128K 两阶段课程(10B+10B)下,SpectralShift 的 RULER 全线胜出——8K 到 128K 五个评估点分别是 64.6/60.1/56.7/49.9/44.6 对 baseline 的 64.3/57.2/51.9/45.4/43.1。按论文汇总,RULER 平均分 55.18 对 52.38,相对提升约 5.35%。而且提升幅度随评估长度拉大而扩大:8K 上只差 0.3,128K 上差 1.5,32K 上差了 4.8 个点。这个梯度模式跟谱分析的预测完全吻合——距离越长,慢谱带宽窄的影响越大。
还有一个细节我觉得挺能说明问题:128K 直接扩(20B 单阶段)时,baseline 的 DROP 只有 15.6,通用平均 52.9,都有点崩;SpectralShift 把 DROP 拉回到 22.3、通用平均 54.0。长上下文扩展经常伴随通用能力受损,这里重参数化似乎还起到了稳定器的作用。不过公平地说,这一项 RACE 上 baseline 33.1 反超了 SpectralShift 的 31.7,不是全方位碾压。
消融:两个组件缺一不可
在 8K→128K 设置下消融重参数化、学习率缩放和缩放因子:
| 编号 | 重参数化 | 学习率缩放 | 因子 | 通用平均 | DROP | RACE | R-8K | R-16K | R-32K | R-64K | R-128K |
|---|---|---|---|---|---|---|---|---|---|---|---|
| ① | 无 | 无 | 无 | 54.0 | 20.1 | 35.5 | 57.6 | 50.8 | 47.4 | 43.6 | 42.8 |
| ② | α | 无 | \(s^{0.25}\) | 55.1 | 24.0 | 34.6 | 60.0 | 51.9 | 49.1 | 41.2 | 38.4 |
| ③ | α | α | \(s^{0.25}\) | 54.9 | 21.6 | 34.1 | 61.8 | 56.2 | 50.0 | 42.1 | 40.7 |
| ④ | α | 无 | \(s^{0.5}\) | 54.1 | 22.2 | 34.8 | 61.4 | 54.2 | 50.6 | 43.5 | 39.8 |
| ⑤ | α | α | \(s^{0.5}\) | 54.3 | 23.9 | 35.3 | 63.8 | 57.8 | 52.5 | 48.5 | 42.9 |
| ⑥ | α | α | \(s\) | 52.2 | 21.2 | 31.8 | 61.3 | 53.4 | 51.4 | 43.5 | 40.1 |
表 4:8K→128K 消融。\(s=L_{\mathrm{ref}}/L_{\mathrm{tar}}\),表中因子指幂指数(\(s^{0.5}\) 即论文采用的理论最优值)。
这张表信息量很大。最优配置是 ⑤——重参数化加学习率缩放加 \(s^{0.5}\),RULER 五个点全拿第一。去掉学习率缩放(④),128K 端从 42.9 掉到 39.8,说明训练过程中谱确实会被搅回去,光初始化不够。因子取满 \(s\)(⑥)则矫枉过正:通用平均掉到 52.2,RACE 只剩 31.8——谱缩放太狠,优化都不稳了。理论推导的 0.5 指数恰好卡在甜点上,这个自洽性挺难得。
不过我得挑个刺:①的 RACE 35.5 是全表最高,比 ⑤ 的 35.3 还高一丝。RACE 这种偏短上下文的任务上,不扩展反而最好——这提醒我们长上下文扩展永远是有代价的博弈,SpectralShift 缓解了这个代价,没有消除它。
位置编码兼容性与纯线性注意力
作者还验证了 SpectralShift 跟 softmax attention 侧的位置编码策略正交——DroPE、YaRN、ABF 三种 PE 下都试了 8K→32K 和 32K→64K。结论:绝大多数设置下 SpectralShift 优于对应 baseline,尤其在每个设置的最大评估长度上全部胜出。比如 32K→64K 加 ABF,64K 评估点上 SpectralShift 38.5 对 baseline 32.2,差了 6.3 个点——注意力层的容量到顶之后,GDN 层的谱扩展成了决定因素。
更狠的验证在纯 GDN 模型(没有 softmax attention 兜底)上,RULER Single-1 任务:
| 方法 | 4K→8K | 4K→16K | 4K→32K |
|---|---|---|---|
| SpectralShift | 11.96 | 11.25 | 10.63 |
| Baseline | 11.11 | 8.00 | 6.43 |
表 5:纯 GDN 模型的 RULER Single-1 结果。
这组数字值得细看。Baseline 从 8K 到 32K 一路崩——11.11、8.00、6.43,接近腰斩;SpectralShift 只是缓慢下滑——11.96、11.25、10.63。扩展倍数越大,差距越夸张,32K 时领先 65%。没有了注意力层的精确检索做拐杖,循环状态自身的谱特性成了唯一的记忆载体,这时 SpectralShift 的价值才真正裸露出來。
🤔 我的判断
这篇论文最让我欣赏的,是它把一个新问题定义清楚了。
线性注意力的上下文扩展,之前基本是个没人细究的盲区——Mamba 系有 UPI、LongMamba、DeciMamba 这些工作调状态动力学,但 DeltaNet/GDN 这条更新的线(也是 Kimi Linear、Qwen3.5 实际在用的线)一直没被系统研究过。SpectralShift 给出的不只是方法,是一套分析框架:转移矩阵奇异值 → 有限时间衰减率 → 慢速谱带宽度 → 写入对齐度。这套词汇以后讨论任何循环架构的长上下文问题都用得上。
方法本身轻到近乎朴素——均值中心化缩放加一个学习率系数。但轻方法配重分析,这个配比是对的。\(s=(L_{\mathrm{ref}}/L_{\mathrm{tar}})^{0.5}\) 有推导、有消融双重背书,不是手调出来的 magic number。
也得说几个让我皱眉的地方。一个是验证规模:全部实验都在 1.5B-A0.6B 上做,作者自己在 Limitations 里承认没钱从零训大规模混合模型。谱分析在小模型上成立,到 32B、100B 量级 alpha 投影的均值-偏差结构是否还长这样,没人知道。另一个是 NIAH/RULER 这类合成检索任务占了评测的大头,真实长文档理解(RACE、DROP 算半个)上的提升明显更小、互有胜负——谱带宽度跟"真正的长程推理"之间还隔着一层。还有,表 2 里 \(E_{\mathrm{write}}\) 的绝对值只有 0.1 到 0.18,说明即使扩谱之后,needle 写入方向跟慢速子空间的重叠依然很低,这里面应该还有不小的天花板没碰到。
但回到工程视角,这篇的落地门槛低得惊人:如果你手头有一个 GDN 或 DeltaNet 系的模型要扩上下文,改动就是初始化时对 \(\mathbf{W}_\alpha\) 做一次均值中心化缩放、优化器里给这组参数单独配个 \(\sqrt{L_{\mathrm{ref}}/L_{\mathrm{tar}}}\) 倍的学习率。几十行代码的事,换来的可能是长距离检索 5% 以上的相对提升和明显更稳的训练。代码已开源在 RUCAIBox/GDN-SpectralShift,值得一试。
更长远一点看,我怀疑"谱视角"会成为线性注意力长上下文研究的标准语言。softmax attention 的扩展是调位置编码的频率几何,循环模型的扩展是调状态转移的衰减谱——两件事在数学上其实有种对称的美感。这篇论文开了个头,后面大概率会有人把同样的分析搬到 Mamba-2、KDA 甚至混合架构的逐层谱分配上。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我