PPO 的 Critic 其实在"躺平":值平坦化失效模式与稀疏监督的解法
你有没有过这种直觉:PPO 训练 LLM 的时候,critic loss 一路下降,曲线漂亮得很,但你心里总有点虚——这个 critic 真的学会了吗?它真的分得清"这句话写到一半很有希望"和"这句话其实已经没救了"吗?
这篇论文(arXiv:2609.18708)把这个模糊的不安变成了一个可测量、可复现的失效模式,名字起得很直白:Value Flattening(值平坦化)。然后用一个简单到近乎"偷懒"的办法把它治好了:每条 response 只挑 3 个状态算 value loss。就这?就这。4B 模型数学推理平均分从 37.60 涨到 45.57,多了将近 8 个点。
核心摘要:PPO 的 critic 在 LLM 训练中存在系统性失效——同一 response 内部,真实状态价值(用 Monte Carlo 延续估计)剧烈波动,critic 预测却平坦得像一条直线,有时甚至方向相反。作者把成因归到两点:终端共享回报带来的隐式方差惩罚,以及时间高度相邻状态产生的冗余梯度。对策是 SP³O(SParse Proximal Policy Optimization),只在每条 response 的 3 个间隔良好的锚点状态上施加 critic 监督。Qwen3-4B/8B-Base 上数学推理和 OOD 评测全面超过 PPO 和 GRPO。这篇论文最值钱的不是方法本身(方法简单到一行改动),而是把一个被整个社区忽视的 critic 失效模式彻底讲清楚了。
论文信息
- 标题:Rethinking Critic Learning in PPO: Understanding and Mitigating Value Flattening
- 作者:Yizhuo Li, Jianhao Yan, Yun Luo, Zhi Wang, Futing Wang, Rong-Xi Tan, Kanghui Tian, Ganqu Cui, Ning Ding, Peilin Zhao, Yafu Li, Yu Cheng
- 链接:https://arxiv.org/abs/2609.18708 (2026 年 9 月 16 日提交)
- 代码:https://github.com/Dodojordi/SP3O
🎯 Critic 到底哪里坏了
先说清楚 Value Flattening 是什么。
LLM 的 RL 训练里,奖励通常只有终端一个标量(答案对了给 1,错了给 0)。critic 的活儿是估计每个中间状态 \(s_t\) 的价值 \(V(s_t)\),也就是"从当前这句话的这个位置继续写,最终答对的概率"。这个值理论上应该随着生成过程剧烈变化——写到关键一步推理对了,价值应该跳上去;写错了,应该掉下来。
怎么知道真实价值长什么样?作者用了一个笨但可靠的诊断工具:对每个中间状态,从当前策略独立采样 \(K\) 条延续(128 到 256 条,用 Wilson 置信区间控制精度),取终端奖励的均值作为 Monte Carlo 价值估计:
然后对比 MC 价值和 critic 预测。结果相当难看:
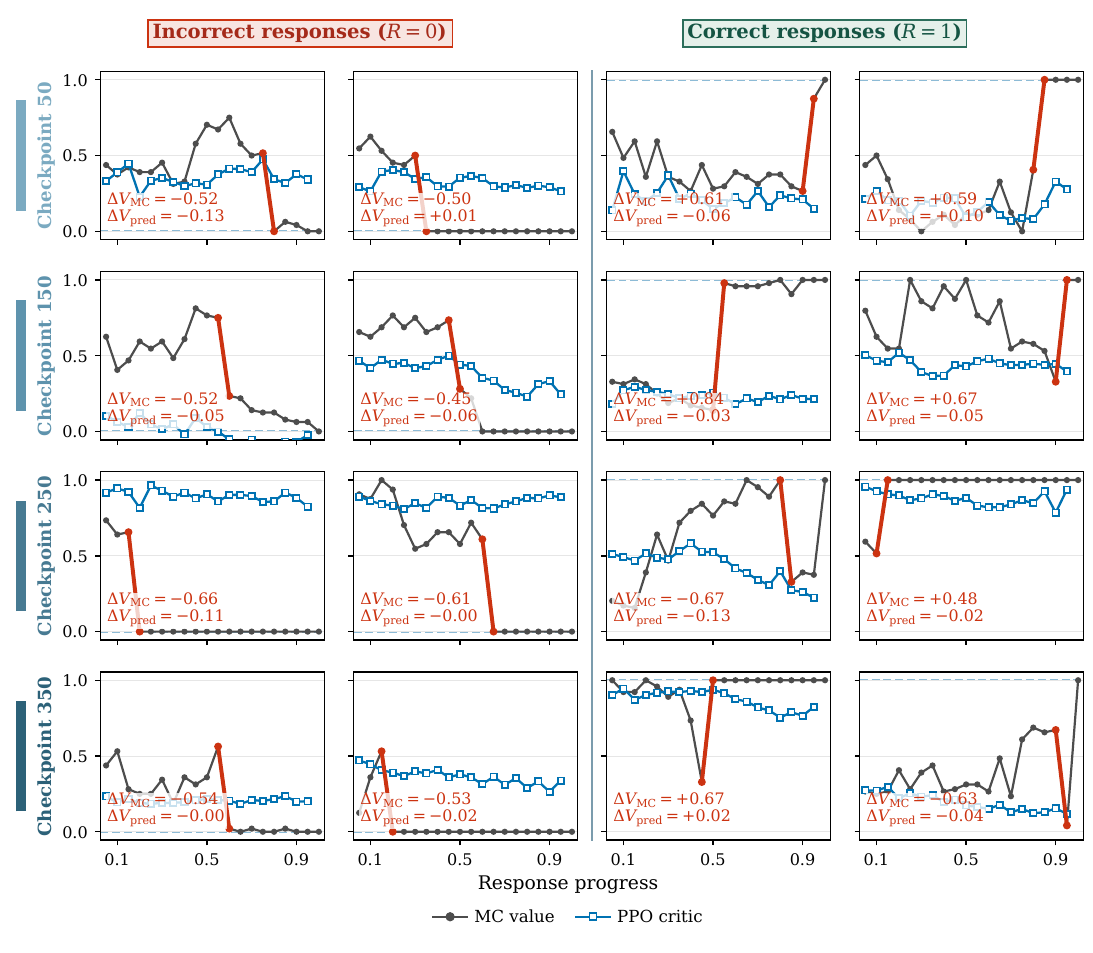
图1:每个小图是一条 response 的价值曲线,灰线是 MC 价值(带圆点),蓝线是 PPO critic 预测(方块)。红色竖段标出 MC 价值变化最剧烈的位置。注意每个 panel 里标注的 \(\Delta V_{MC}\) 和 \(\Delta V_{pred}\)——MC 价值动辄变化 ±0.5 甚至 ±0.67,critic 的变化却常常只有 ±0.01 到 ±0.13,而且不止一次方向是反的。这个现象跨 checkpoint(50 到 350)、跨正确/错误 response 都稳定存在,说明它是 critic 的固有毛病,不是个别轨迹的偶然。
说实话看到这张图我愣了一下。ΔV_MC = -0.66 而 ΔV_pred = -0.11 这种对比,意味着 critic 基本放弃了 response 内部的分辨率——它能区分"这条 response 整体好不好",但对"写到哪一步开始变好/变坏"几乎是瞎的。
作者还在 FrozenLake 这个经典小环境里做了受控验证。FrozenLake 里每个格子的真实价值就是"从这里出发最终到达目标的概率",可以精确算出来。固定训练配置、只增大迷宫尺寸,结果迷宫越大,critic 预测越平滑、跟 ground truth 的偏差越大:

图2:(a) 相邻状态的 MC 价值变化(横轴)vs critic 预测变化(纵轴)散点图——如果 critic 学得好,点应该沿对角线分布;实际全部挤在纵轴零附近,深色点(MC 变化超过 0.3 的)也没有更大的 critic 响应。(b) FrozenLake 价值热力图:上排是 ground truth,下排是 critic 预测,n=32 时还能看到明暗结构,n=128 时预测已经糊成一片近乎均匀的橙色。(c) 量化指标:迷宫越大,critic 与真实值的局部对比度比值越低、MAE 越高。
这个 FrozenLake 实验我觉得挺重要。它排除了"LLM 任务太特殊"的质疑——Value Flattening 是 critic 学习机制本身的问题,而且随状态空间变大而加剧。LLM 的状态空间有多大不用我说了吧。
🧠 为什么 critic 会变平
两个成因,一个来自 loss 结构,一个来自数据特性。
成因一:隐式方差惩罚。 在终端奖励 + \(\gamma=\lambda=1\) 的常见设置下,同一 response 的所有状态共享同一个回归目标 \(R(\tau)\)。对一条长度为 \(T\) 的 response,critic 的 MSE loss 可以精确分解:
第一项没问题,让均值预测去拟合采样回报。第二项就有意思了——它是预测值在 response 内的经验方差,loss 直接惩罚 critic 在同一 response 内给出不同的预测。你想想看,\(T\) 几千个 token,每个位置的预测都被拉向同一个均值,这个平坦化压力是逐 token 施加的。而共享回报本身其实不包含任何"response 内部哪个状态更有价值"的信息。
成因二:时间相关状态的冗余更新。 LLM 里相邻状态 \(s_t=(x, y_{\lt t})\) 只差一个 token,输入几乎完全重叠。critic 的 value head 是 \(V_\phi(s_t)=w^\top h_t\),梯度为 \(2(V_\phi(s_t)-R)h_t\)——表示相似、残差同号的位置会产生方向几乎一致的梯度。

图3:(a) actor 和 critic 隐藏表示的 PCA 轨迹(critic 视图放大 2 倍绘制)——actor 的表示随 response 推进走出一条明显的轨迹,critic 的表示却缩在一个紧凑的小区域里。(b) 左图:hidden-state 余弦相似度、梯度余弦相似度、update energy 在整个训练过程中都维持在 99% 上下;右图:response 内部梯度的余弦相似度随 token 位置距离增大而下降。
这个观察跟 DQN 时代 Mnih et al. 2015 年那篇 Nature 提到的"相邻帧高度相关导致学习不稳定"是一个味道,只是在 LLM 语境下被放大了——相邻状态不是"有点相似",而是"只差一个 token"。密集监督聚合了海量冗余的、方向一致的梯度,把所有预测往同一个方向推,结果就是预测值趋同。
两个成因合起来:loss 结构在罚方差,梯度结构在堆冗余。critic 不平才怪。
🔧 SP³O:少即是多
顺着诊断,药方几乎是直接开出来的:既然密集监督是病根,那就稀疏化。
SP³O 的做法:actor 目标、rollout 流程、回报目标一概不动,只改变哪些状态接收 critic loss。记 \(\mathcal{I}(\tau)\) 为轨迹 \(\tau\) 中被监督的状态集合:
默认配置简单到有点任性:每条 response 只监督 3 个状态,锚点在相对位置 0.3、0.6、0.9;长度超过 6144 token 的 response 额外加一个 0.95 位置的尾部锚点。
这个设计同时针对两个成因:监督位置少了,方差惩罚只施加在少数预测上,response 内部的预测变化不再被全局压制;锚点之间拉开间隔,避免了相邻状态对齐梯度的重复累积。
注意 critic 仍然在每个位置输出值(advantage 计算照常),只是 loss 只在锚点上回传。改动量大概就是 dataloader 里加个 mask。
📊 实验:3 个锚点打赢全量监督
训练配置:Qwen3-4B/8B-Base,DAPO-Math-17k 数据,rollout batch 512(64 prompt × 8),actor 学习率 1e-6、critic 4e-6,clip 0.2,无 KL,critic 预热 20 个 batch。评测分两套:数学推理 7 个基准(avg@32),OOD 推理 6 个基准(avg@4,部分用 gpt-oss-120b 经 xVerify 评分)。
数学推理(avg@32,%):
| 模型 | 方法 | AIME24 | AIME25 | AIME26 | AMC23 | MATH500 | Minerva | Olympiad | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | PPO | 17.50 | 19.90 | 14.69 | 61.80 | 70.15 | 42.82 | 36.35 | 37.60 |
| GRPO | 17.19 | 16.19 | 10.10 | 63.83 | 78.21 | 45.71 | 43.62 | 39.26 | |
| SP³O | 23.02 | 23.54 | 22.08 | 69.92 | 83.79 | 47.93 | 48.68 | 45.57 | |
| Qwen3-8B | PPO | 30.21 | 25.10 | 23.33 | 72.19 | 86.33 | 48.81 | 53.56 | 48.50 |
| GRPO | 28.50 | 22.04 | 22.70 | 73.82 | 85.26 | 52.06 | 50.98 | 47.91 | |
| SP³O | 33.91 | 28.02 | 27.39 | 75.00 | 87.33 | 47.40 | 54.50 | 50.51 |
4B 上 SP³O 比 PPO 高 7.97 个点,比 GRPO 高 6.31 个点,七个基准全部领先。8B 上提升收窄到 +2.01(数学),方向仍然一致——模型变大后 critic 容量更足,平坦化的危害相对缓解,这跟 FrozenLake 里"状态空间越大问题越重"的发现是自洽的。
OOD 评测(avg@4,%):
| 模型 | 方法 | ARC-C | MMLU-Pro | GPQA | AGIEval | BBH | ZebraLogic | Avg. |
|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | PPO | 89.19 | 54.39 | 34.85 | 65.87 | 57.50 | 9.90 | 51.95 |
| GRPO | 90.96 | 56.87 | 38.89 | 68.18 | 71.17 | 12.58 | 56.44 | |
| SP³O | 91.02 | 61.75 | 38.89 | 71.44 | 73.35 | 19.20 | 59.28 | |
| Qwen3-8B | PPO | 93.84 | 64.19 | 47.22 | 74.52 | 79.27 | 27.25 | 64.38 |
| GRPO | 93.04 | 66.27 | 49.49 | 75.15 | 78.10 | 27.40 | 64.91 | |
| SP³O | 93.13 | 65.83 | 49.94 | 76.95 | 80.89 | 31.45 | 66.37 |
OOD 上 4B 涨 7.33 个点、8B 涨 1.99 个点。OOD 涨得比 in-domain 还猛(4B 上),说明 critic 修好以后策略学到的东西更"通用",不只是拟合了数学基准的分布。
机制层面的证据也齐了:
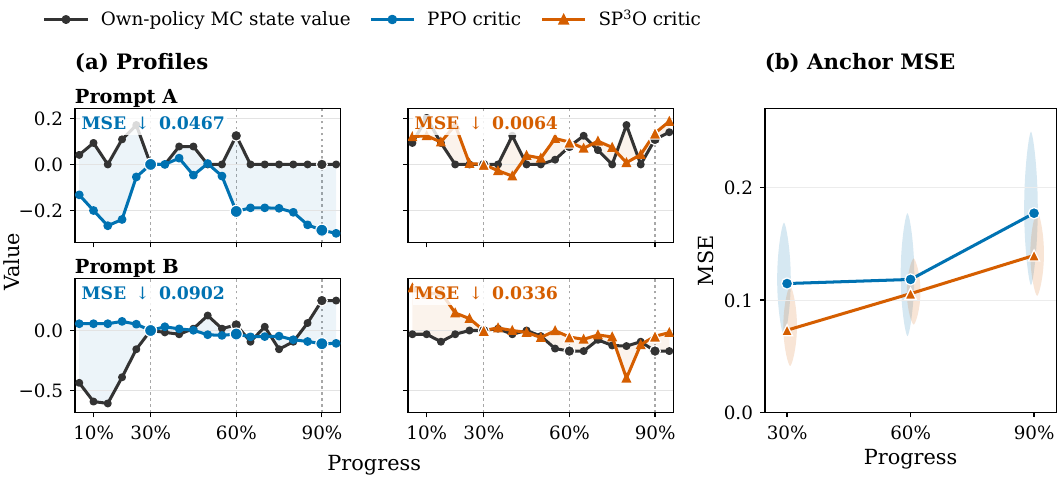
图4:(a) 两个 prompt 上的价值曲线对比——灰线是 MC 价值,PPO critic(蓝)平坦且在后半段直接躺平成一条线,SP³O critic(橙)在方向和幅度上都更贴近 MC。注意 PPO 那两条蓝色曲线在 30% 之后几乎不再变化,阴影区域就是它和真实价值的累计偏差。(b) 锚点位置的 response 中心化 MSE:SP³O 在 30%/60%/90% 进度处分别比 PPO 低 36%/11%/21%。
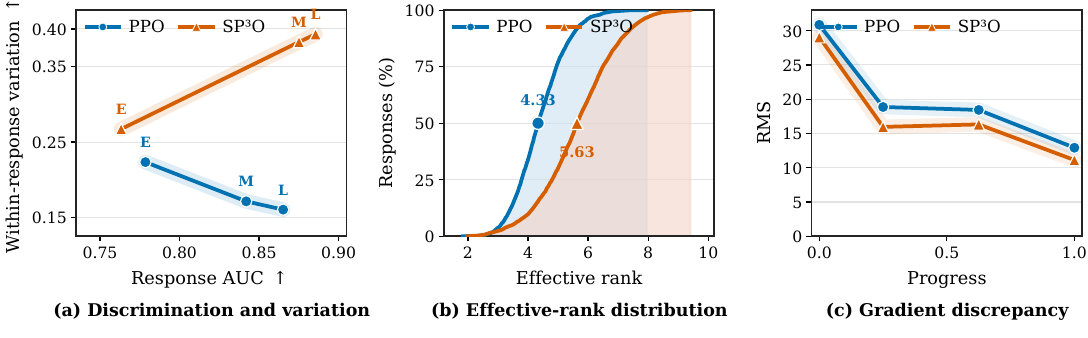
图5:(a) Response AUC(critic 均值能否区分对错 response)与 within-response 方差比例的联合图——PPO 训练越久判别力越高,但 within-response 方差一路流失(从 E 到 L 往右下滑);SP³O 两个指标同时往上走。(b) response 中心化隐藏状态矩阵有效秩的 CDF:中位数从 PPO 的 4.33 提到 5.63,表示更丰富了。(c) 终端回报目标与 MC 目标的 value-head 梯度差异 RMS:SP³O 全程更低。
(a) 这张图把 Value Flattening 的" trade-off 假象"戳破了——PPO 里判别力和 within-response 分辨率像跷跷板,SP³O 证明这个 trade-off 是监督方式造成的,不是任务固有的。
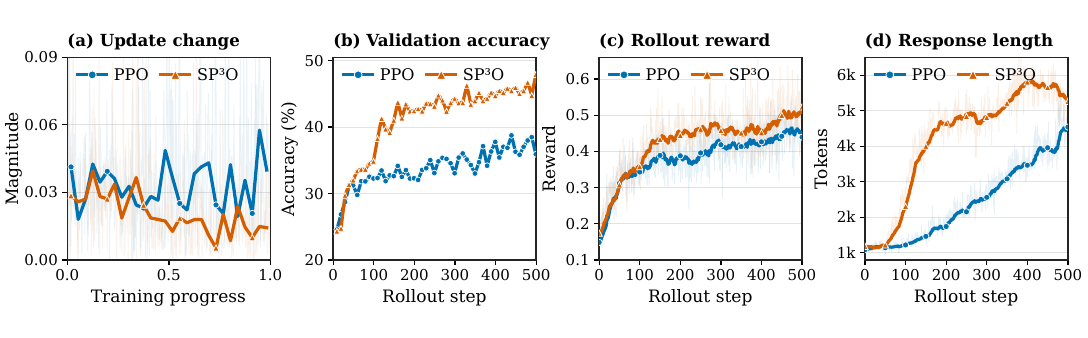
图6:(a) 单次迭代内 actor 更新的变化幅度:SP³O 更小更稳,PPO 的更新在中后期频繁出现尖峰。(b)(c) 验证准确率和 rollout 奖励:SP³O 在早期之后持续领先。(d) response 长度:SP³O 的生成一路拉长到 5k+ token,PPO 爬得慢且停在 4k 左右。
(d) 值得多说一句。response 变长本身不是目的,但在推理任务上,愿意写更长的链通常是探索更充分的表现;PPO 长度爬不动,某种程度上反映了平坦 critic 给出的 advantage 信号缺乏区分度,策略学不到"哪些方向值得展开"。
消融一:监督密度 K。
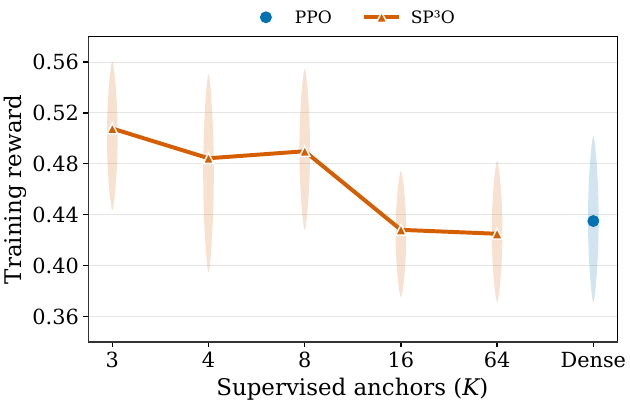
图7:K=3 时训练奖励最高(约 0.51),K=4、K=8 基本持平,K=16、K=64 明显下滑,dense(全量监督)约 0.44 跟 K=64 已经差不多了。单调性非常干净:越稀疏越好,直到稀疏到只剩 3 个为止。
这条曲线几乎是论文理论的直接可视化——监督密度增加 = 方差惩罚项变大 + 冗余梯度变多,性能单调退化。K=3 是甜点。
消融二:锚点放哪。 K=3 时,0.3/0.6/0.9 拿 45.57,0.2/0.5/0.8 拿 44.65,而随机放置只有 36.59——比 PPO baseline(37.60)还低。随机放置差的原因很直白:随机位置经常扎堆,等于在共享大部分历史的邻近状态上重复更新,冗余梯度问题又回来了。间隔(spacing)和稀疏(sparsity)缺一不可。
消融三:尾部锚点。 去掉尾部锚点,准确率从 45.57 掉到 44.10,更要命的是重复生成率从 1.12% 飙到 18.33%。长 response 的尾部缺乏监督,critic 对"快写完了但开始原地转圈"的状态完全没判断力。一行改动换回 17 个点的重复率下降,性价比极高。
附录里还有两张图值得一提:
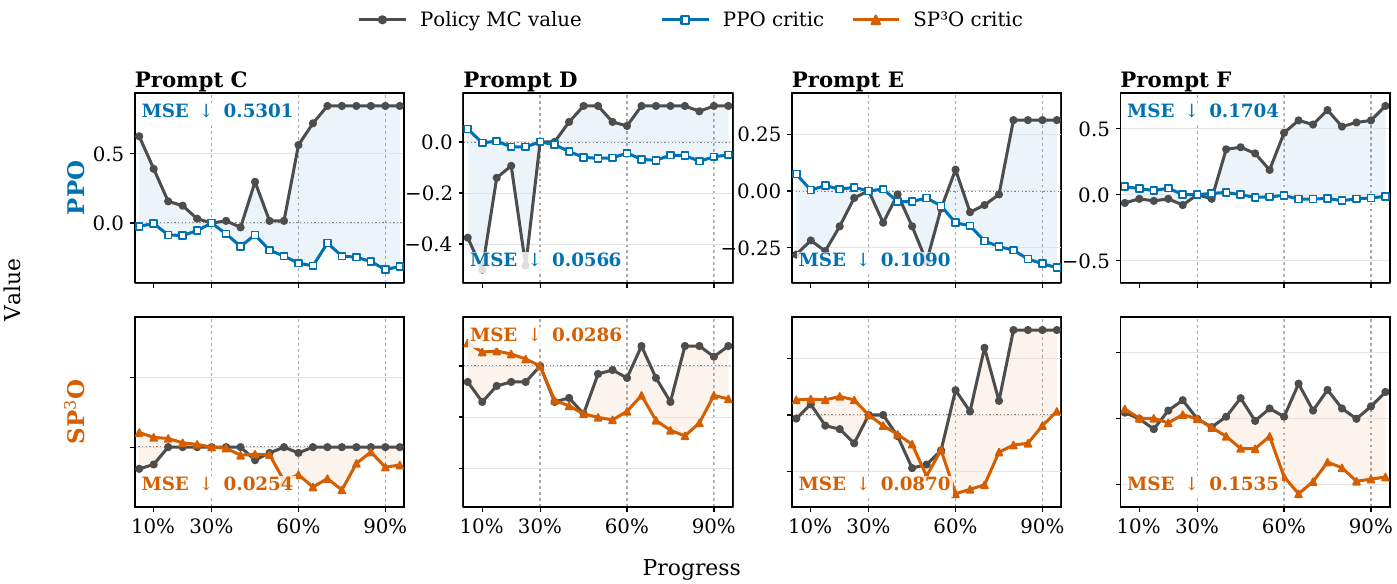
图8:四个额外 prompt 的匹配价值曲线。PPO(上排蓝线)的 MSE 从 0.057 到 0.53 不等,SP³O(下排橙线)在所有四个 case 上都更低(0.025 到 0.15)。Prompt C 最夸张:MC 价值在 50% 进度处从 0.6 崩到 0,PPO critic 几乎纹丝不动,MSE 高达 0.53。
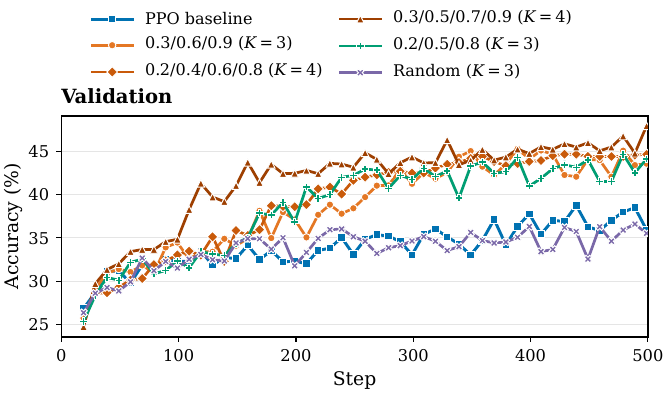
图9:各锚点方案的在线验证准确率轨迹。0.3/0.5/0.7/0.9(K=4,棕线)和 0.3/0.6/0.9(K=3,橙线)领先,Random(紫线)和 PPO baseline(蓝线)垫底。覆盖后段状态的方案整体更好。
🤔 我的判断
这篇论文我最欣赏的地方是它的"诊断先行"。太多 RLHF 工程论文是"我改了个 trick,涨了 2 个点,why it works 不知道";这篇反着来——先用 MC 延续把 critic 的失败量化出来,用 FrozenLake 排除任务特殊性,再把 loss 做方差分解定位到具体的惩罚项,最后才给出对症的药。整条证据链环环相扣,Figure 7 那条单调下降曲线基本就是理论的直接预言被实验验证,看着很舒服。
方法本身的定位要清醒:SP³O 不是什么复杂创新,它就是"给 value loss 加个稀疏 mask"。但也正因如此,它的落地成本几乎为零——任何还在用带 critic 的 PPO 框架(不是 GRPO 系)的团队,改几行代码就能试。
批评的地方也有。第一,主要实验都在数学推理这一个领域,终端二元奖励的设置是 Value Flattening 最严重的场景;对于过程奖励、密集奖励的任务,隐式方差惩罚是否还是主导因素,论文没回答。第二,0.3/0.6/0.9 这组锚点多少有点"调出来的"味道,虽然 Table 3 和 Figure 9 说明它对位置不算极度敏感,但"为什么不是 0.25/0.5/0.75"没有理论答案,只有实验答案。第三,8B 上的收益明显收窄(+2.01 vs 4B 的 +7.97),更大模型上是否还值得做,存疑。不过反过来想,这也侧面印证了论文的缩放规律——状态空间相对模型容量越大,平坦化越严重。
还有个更远的联想:现在主流推理模型训练已经大面积转向 GRPO 这类无 critic 方法,用组内相对优势替代价值基线。这篇论文其实给出了一个有趣的解释视角——GRPO 绕开的也许不只是"省一个 critic 的显存",而是绕开了 critic 在长序列上注定学不平的这个坑。从这个角度看,Value Flattening 可能是理解"为什么无 critic 方法在 LLM 上反而更稳"的一块拼图。
如果你还在维护 PPO 系的训练管线(尤其是需要 critic 的场景,比如 multi-turn agent、process reward),这个 sparse mask 值得今天就试试。成本是零,潜在的收益是 8 个点。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我