不用梯度做对齐:ComPO 把 DPO 扔掉的"噪声对"变成了免费训练信号
你有没有碰到过这种诡异现象——DPO 训着训着,奖励模型分数在涨,但模型开始不好好说话了?更邪门的是,你想让它偏好"No"而不是"Never",结果训完它最爱说的词变成了"Yes"。
这不是玄学,是似然位移(likelihood displacement)。这篇论文给了一个挺另类的解法:别再用那堆"噪声偏好对"去硬算梯度了,把它们当成一比特的比较信号,用零阶优化(zeroth-order optimization)的思路做对齐。
📌 核心摘要
DPO 这类直接偏好对齐方法有个老毛病:它只优化"偏好回答与拒答回答之间的似然差距",而不保证偏好回答的绝对概率上升。当偏好对里的两个回答很像(低 margin 的"噪声对")时,概率质量可能被推到完全不相关的回答上去,甚至让模型从拒答变成服从危险指令。这篇论文提出 ComPO(Comparison-based Preference Optimization,比较偏好优化):把偏好对当作"比较预言机"——随机扰动一下模型输出层,看看扰动后"偏好回答变可能了、拒答回答变不可能了"这个一比特信号是否成立,聚合成稀疏的更新方向。不用反向传播,只改输出层约 1% 的参数(7B 模型只动约 150 万个参数),在 Mistral、Llama、Gemma-2、Qwen3、Gemma-3 上把 AlpacaEval 2 长度控制胜率(LC)最多再拉高 2 个点以上。我的判断:这是把零阶优化引入偏好对齐的一个干净、有理论保证的范式级工作,思路漂亮,工程开销还小。
论文信息 - 标题:A Zeroth-Order Paradigm for LLM Preference Alignment - 作者:Peter Chen, Xi Chen, Wotao Yin, Tianyi Lin - arXiv:https://arxiv.org/abs/2609.19144(2026-09-16,NeurIPS 2025 会议版本的期刊扩展版,新增在线 ComPO 与更多模型实验)
🎯 问题动机:DPO 的 loss 是个"代理目标",遇到噪声对就翻车
先回顾一下 DPO 的损失函数:
注意它优化的是 \(y^+\) 和 \(y^-\) 之间的相对差距。相对差距拉大,不代表 \(y^+\) 的绝对概率上升——完全可能是 \(y^-\) 掉得更快。概率质量被挤出去之后去哪儿了?不受控。论文引了一个让人皱眉的例子:Gemma-2B-it 原本会拒答"如何帮恐怖组织渗透政府机构"这类请求,DPO 训练后反而开始服从——因为似然位移把概率质量从拒答回答上挪走了。
之前的工作怎么处理的?SimPO 作者之外的另一条线(Razin 等人的 Unintentional Unalignment)发现,用 CHES 分数把"太相似"的偏好对过滤掉,比加 SFT 正则更能缓解位移。说实话这个发现挺有价值的——它说明问题出在数据几何上。但过滤的做法有个明显浪费:这些低 margin 的对虽然不适合直接进 margin-based 的 loss,里面的比较信息还在啊。
作者的核心追问就是:这些被过滤的噪声对,能不能不当训练样本,而当比较信号用?
🧠 方法核心:把偏好对变成一比特的比较预言机
一句话直觉:不显式定义"对齐目标函数",而是问一个更朴素的问题——"把模型往这个方向推一小步,偏好回答的概率升了、拒答回答的概率降了吗?"升了降了,方向就是对的。
离线 ComPO
形式化一下。对偏好对集合 \(S\),定义扰动前后的对数似然变化:
偏好比较预言机 \(\mathcal{C}^S_\pi(\theta,\theta')\) 在 \(\Delta^+_S>0\) 且 \(\Delta^-_S<0\) 时返回 \(-1\)(表示 \(\theta'\) 更好),否则返回 \(+1\)。这就是一个标准的一比特比较预言机。
接下来的玩法借自 1-bit 压缩感知(SCOBO 那一脉):在 \(\theta\) 附近采 \(m\) 个随机扰动方向 \(\z_i\),每个方向拿一个比特 \(y_i\),然后把符号化测量聚合成梯度估计:
\(\ell_1\) 约束利用了梯度稀疏性——这也是作者证明收敛性的关键假设之一。在光滑性、梯度近似稀疏、预言机与隐式目标兼容的假设下,离线基础方案有 best-iterate 收敛保证,且查询次数只随维度对数级增长(稀疏度 \(s\) 固定时)。
工程上的三个关键简化
理论方案直接套到 7B 模型上是算不起的,实际实现砍了三刀:
- 只扰动输出层(lm_head),其余参数全冻结。7B 模型的输出层约 0.13B 参数,配合阈值 \(\lambda_g\) 只更新其中约 1% 的条目——Mistral-7B 实际只动约 150 万参数,占全模型的 0.02%。
- 梯度估计简化:不解带约束的优化问题,直接用归一化的符号扰动加权和 \(\hat{g}^o_t = \sum y_i\z_i / \|\cdot\|\),再做逐条目阈值裁剪。
- 更新门控:统计 \(m\) 次扰动中"成功"的比例 \(p_t\),低于阈值 \(\lambda\) 就跳过这一步——避免在信号稀薄的批次上乱动。
数据侧的分工也很清晰:用参考模型的对数似然 margin 把数据集切成 clean / noisy 两半(阈值 \(\delta_{\text{margin}}=3\)),clean 部分照常跑 DPO 或 SimPO,noisy 部分交给 ComPO。ComPO 吃的是别人扔掉的边角料——这一点我觉得是整个工作最优雅的地方。
在线 ComPO:用无标注生成控制步子
期刊版新增的在线扩展走的是 HyPO 那套"偏好监督与正则分离"的思路:比较信号仍然来自固定的离线偏好对,但额外从当前策略采样无标注生成,估一个长度归一化的 reverse-KL 统计量 \(\hat{d}_t\),用它软化步长:
基础方案里是一个硬约束(候选策略的 reverse-KL 超过半径 \(\tau\) 就拒绝更新),配合局部覆盖假设能给出性能上界 \(C_\tau\sqrt{\operatorname{err}(\pi)}\);实际实现换成了软阻尼,作者也坦承这是启发式近似,不在定理覆盖范围内。另外还加了个 replay buffer:把上一个训练块里"通过了更新门控"的批次存下来,以概率 \(\alpha\) 重采——注意重采时用的是当前参数下的新鲜扰动,不是复用旧方向。
📊 实验:只改 0.02% 的参数,还能涨点
评测走 SimPO 的标准协议:AlpacaEval 2(LC/WR)、Arena-Hard、MT-Bench,离线实验用 UltraFeedback,30 张 A40。
主表:DPO_clean + ComPO 对比 DPO 与 DPO_clean
| 模型 | 方法 | AE2 LC (%) | AE2 WR (%) | Arena-Hard (%) | MT-Bench 均分 |
|---|---|---|---|---|---|
| Mistral-7B-Base | DPO | 9.71 | 6.27 | 2.9 | 5.79 |
| DPO_clean + ComPO | 11.66 | 6.55 | 3.2 | 5.77 | |
| Mistral-7B-Instruct | DPO | 24.14 | 16.71 | 14.4 | 5.86 |
| DPO_clean + ComPO | 26.17 | 18.32 | 10.5 | 7.69 | |
| Llama-3-8B-Base | DPO | 4.14 | 10.43 | 12.1 | 6.23 |
| DPO_clean + ComPO | 5.39 | 10.93 | 12.1 | 6.44 | |
| Llama-3-8B-Instruct | DPO | 32.59 | 31.99 | 22.9 | 7.93 |
| DPO_clean + ComPO | 35.79 | 35.03 | 23.1 | 8.05 |
几个观察。AlpacaEval 2 LC 上 ComPO 全线提升,Mistral-Base 涨了近 2 个点,Llama-Instruct 涨了 2.9 个点——只用前 100 个噪声对。MT-Bench 的提升幅度大得有点反常(Mistral-Instruct 从 5.86 到 7.69),单点估计没有方差报告,这个数我会持保留态度。唯一的明显回退是 Mistral-Instruct 的 Arena-Hard(14.4 → 10.5),作者的解释是 Arena-Hard 用原始胜率、偏爱长回答,而 ComPO 的回答更短(513 → 468 token)——这个解释合理但只是相关性的,作者自己也承认无法确立因果。
ComPO 也不绑定 DPO。直接拿来打磨现成的 SimPO checkpoint,三个模型(Mistral-7B-Instruct、Llama-3-8B-Instruct、Gemma-2-9B-it)的 AlpacaEval 2 两项指标全部提升,Gemma-2-9B-it 的 LC 从 60.36 涨到 62.42,Arena-Hard 基本持平或上涨。
在线版本(Qwen3-4B-Base / Llama-3.2-3B-Instruct / Gemma-3-4B-it,GPT-4.1 评判):相比离线 ComPO,加 RKL 阻尼后 Gemma-3-4B-it 的 Arena-Hard 从 57.7 涨到 63.3,涨了 5.6 个点;再加 replay 三个模型全部指标继续上行。阻尼+回放的组合收益是实打实的。
似然位移的诊断证据
这是我最喜欢的部分。作者直接追踪噪声对在 ComPO 更新前后的对数似然:Llama-3-Instruct-8B 上一对初始 \((-46.761, -47.410)\),\(\gamma=1\) 时变成 \((-46.728, -47.520)\)——偏好回答概率升、拒答回答概率降,正是 DPO 做不到的方向。三次独立试验中这个方向性保持一致。当然,作者很克制地把这定位为"训练中的 sanity check",不是总体性能保证。这种写法我喜欢。
效率与消融
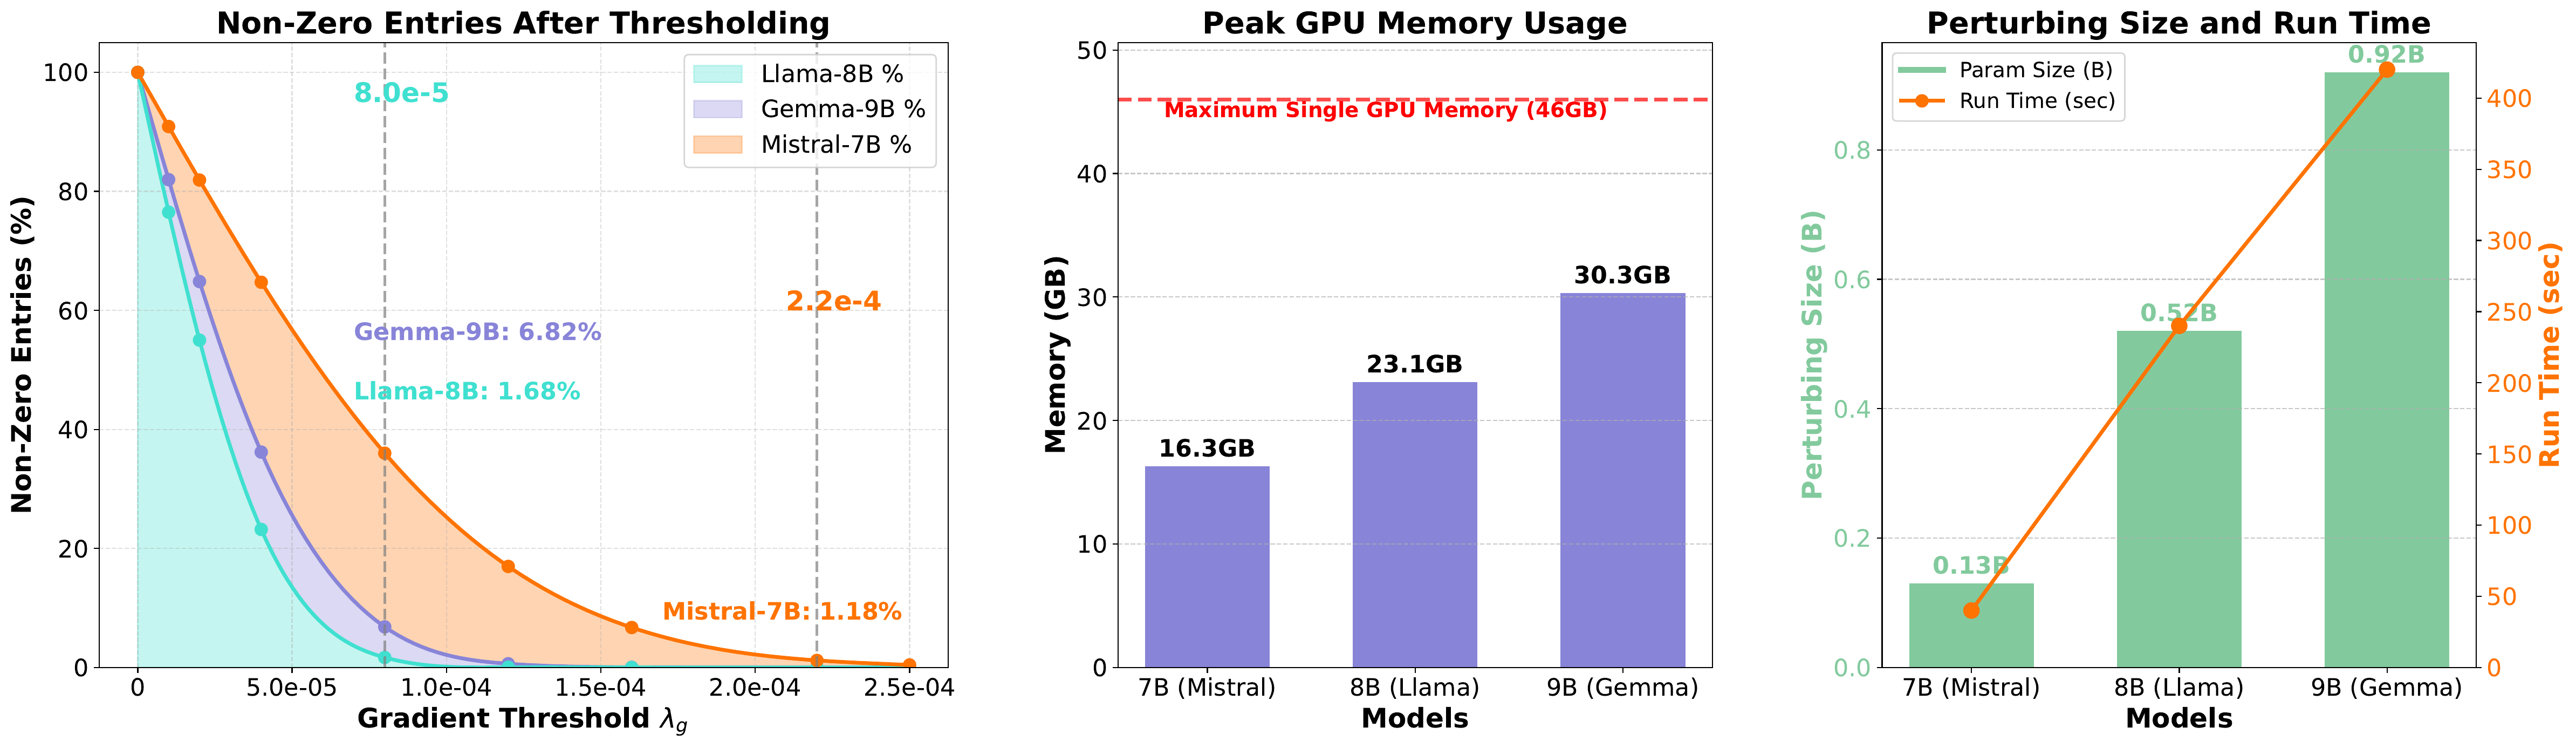
Figure 2:左图显示所选 \(\lambda_g\) 只保留约 1% 的输出层条目(Mistral-7B 1.18%、Llama-8B 1.68%、Gemma-9B 6.82%);中图是峰值显存,Llama-3-8B 的 ComPO 只需约 23GB/A40,而 DPO/SimPO 的报告峰值是 77GB/69GB(H100,非严格对比);右图显示 600 次扰动的耗时随扰动维度近线性增长,最大的 Gemma-9B 输出层(0.92B)也只要约 430 秒。
不做反向传播、rolling 累积不存扰动向量,显存和并行的账都很漂亮。消融方面:扰动数 \(m\) 从 800 增到 5400 收益递减;\(\lambda_g\) 保留 1%–6% 条目时效果最好,全更新或几乎全过滤都掉点;噪声对从 100 加到 300 三个指标继续涨——说明"边角料"的储量还没挖完。
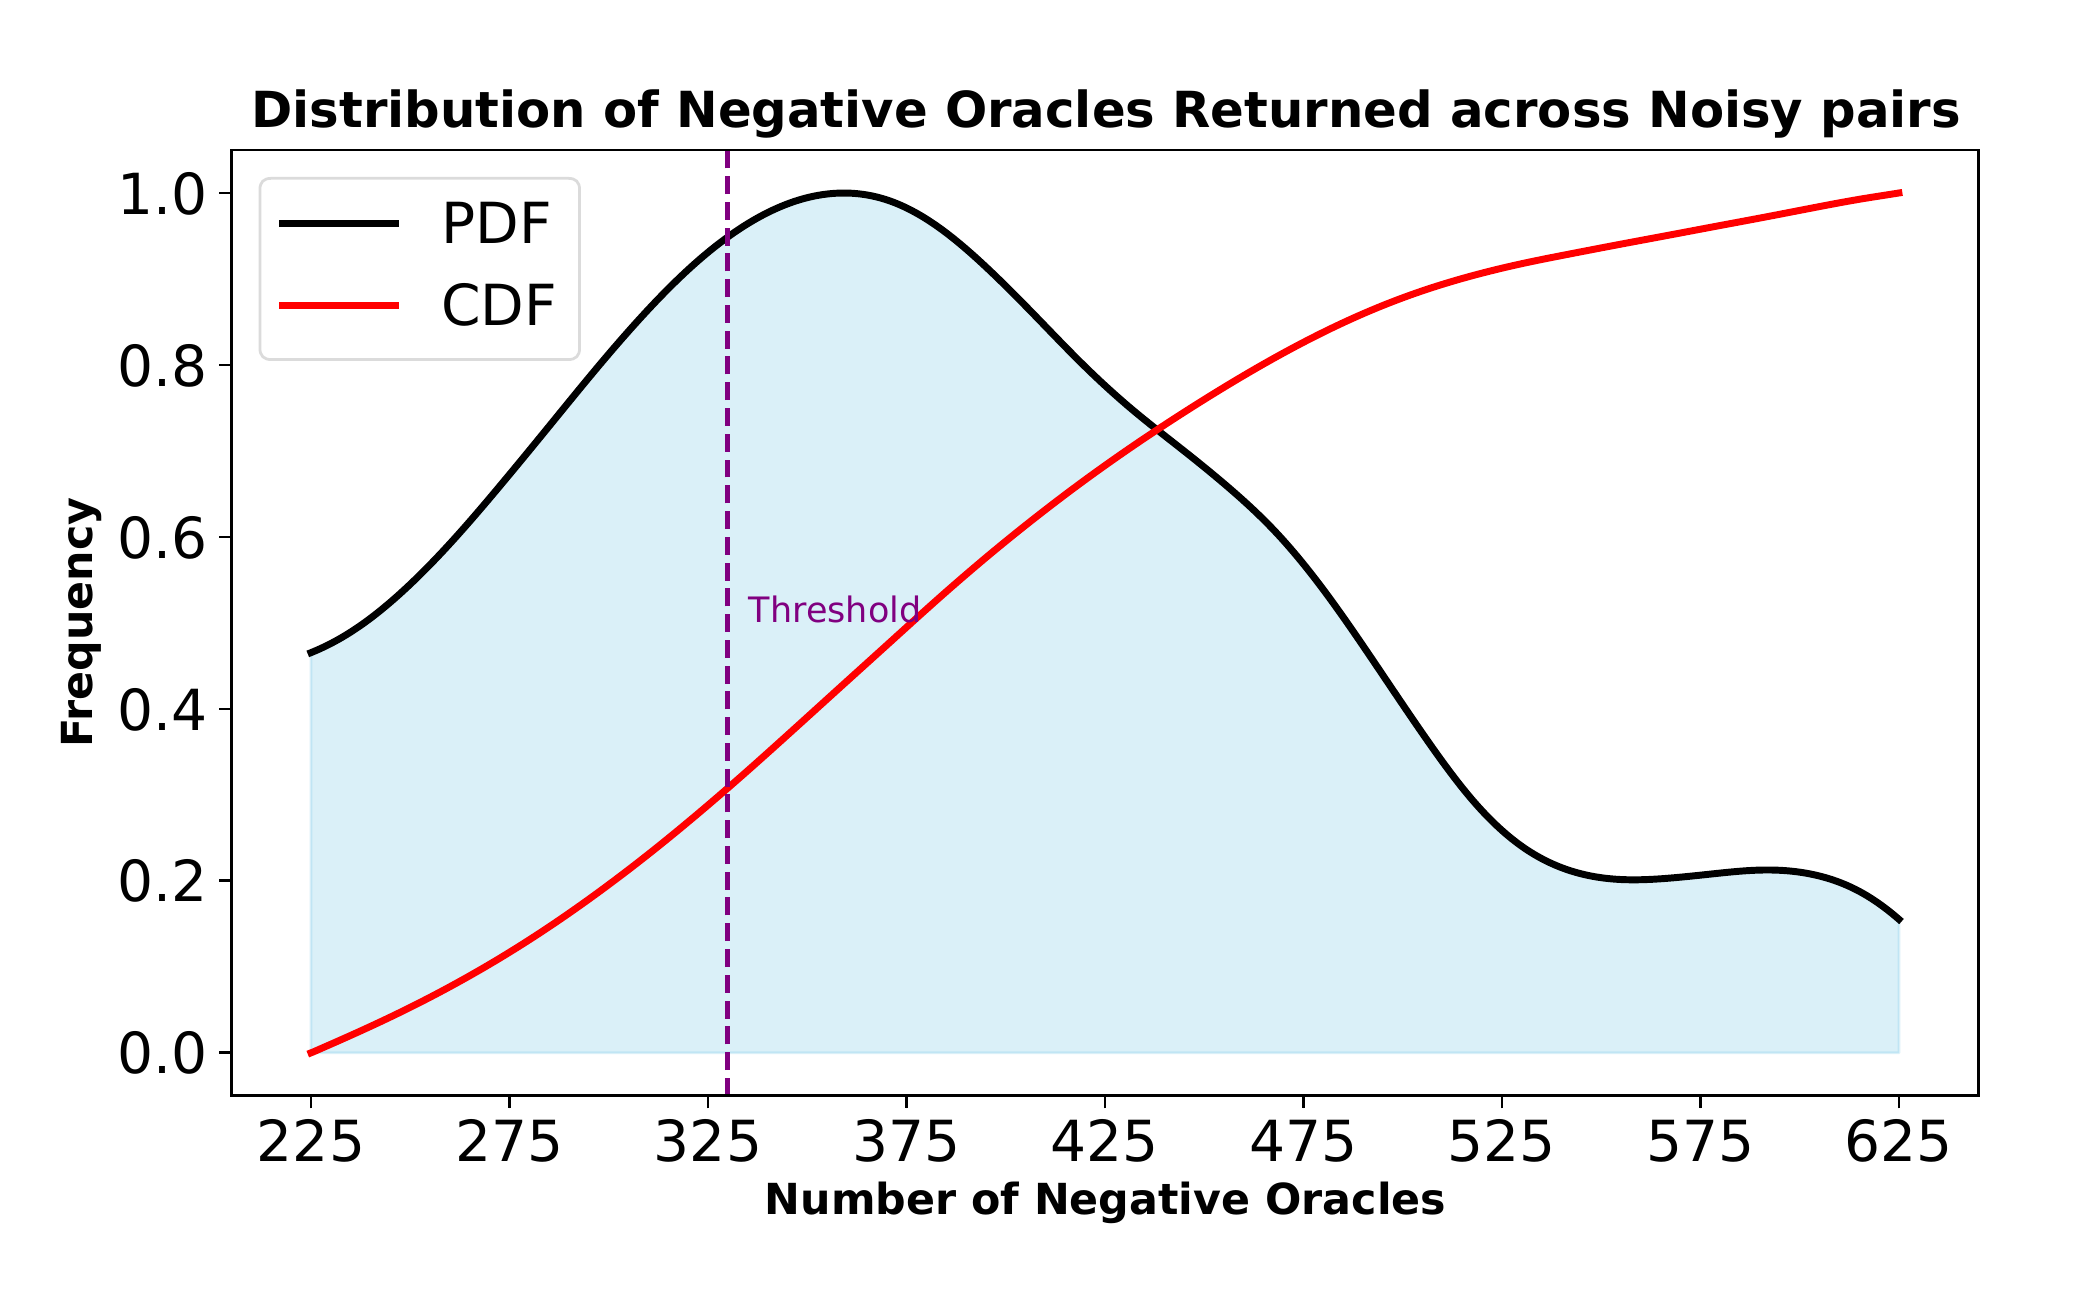
Figure 3:噪声对上"成功扰动"数量的经验分布(Mistral-7B-Base),紫色虚线是裁剪阈值。同一批次在 8 次独立运行中成功计数稳定(例如 Pair 5 为 \(591.00\pm13.46\)),说明预言机反馈量是可复现的,门控机制砍掉的是低信号尾部。
🤔 我的判断
这篇论文最值钱的地方,是视角的转换:低 margin 偏好对不是垃圾数据,而是不适合一阶方法的比较信号。把零阶优化(1-bit 压缩感知那条线)正经引入 LLM 偏好对齐,还配上了收敛性证明和覆盖性分析——这在此前基本只有 Zo-AdaMU 式的微调探索,用在偏好对齐上且有完整理论闭环的,这篇是头一份。
但也有几处要泼冷水。第一,只扰动输出层是个强工程妥协——输出层能表达的"对齐方向"终究有限,多层扰动的消融(1 层 vs 3 层)涨了不到 1 个点,这条路线往深网络走的收益曲线还不明朗。第二,噪声对的判定用的是最朴素的似然 margin,作者自己都说不如 CHES 分数分得准,那 ComPO 的收益有多少来自"切分恰好运气不错",需要更仔细的分解。第三,主表大多是单点估计,MT-Bench 上 5.86 → 7.69 这种跳跃没有方差支撑,我会想看到更多 seed。
工程上的启示倒是很直接:如果你手里有一个已经对齐好的开源模型,还有一批质量参差、margin 很小的领域偏好数据,ComPO 提供了一个近乎零风险的"补丁"式方案——不动主干、不吃显存、失败了也只是跳过更新。30 张 A40 的配置看着唬人,但那是并行摊 1800 次扰动;按显存占用算,单卡 24GB 级别就能跑 8B 模型。
最后说个略遗憾的点:在线版本的定理只覆盖硬约束基础方案,实际跑的是软阻尼启发式,理论和实现之间有条明说的缝。不过作者没藏着掖着,直接写明了"不在定理覆盖范围内",比强行 claim 的论文体面多了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我