把上下文窗口砍掉之后,扩散语言模型还能继续推理吗?这篇论文给它装了一组"寄存器"
用扩散语言模型(dLLM)做长链推理,有个绕不过去的尴尬:它没有自回归模型那种天然的"从左到右"结构,想让模型跨多个生成块(chunk)保持思路连贯,标准做法是把之前生成的文本一直留在上下文里。结果就是注意力开销随着总长度二次方往上蹿——这和自回归模型的 KV cache 越堆越长是同一个病。
这篇论文问了一个挺狠的问题:如果把之前生成的文本全部清掉,只留一个固定大小的连续状态,dLLM 还能不能接着往下想?
核心摘要:作者给 dLLM 引入了 register tokens——几个固定在 prompt 里的特殊位置,它们的连续隐藏状态被训练成跨块传递推理进度的"携带状态"。每生成完一块,就把文本清掉、只保留寄存器的值,下一块从 prompt 加这个状态继续解码。在 LLaDA-8B 和 Dream-7B 上,寄存器在全部 12 组对比中都赢过"携带离散文本"的基线,数学上最多涨 8.5 个点,代码上最多涨 19.5 个点,还能继续用 RL 精调。我的判断:这不是一个"全面碾压"的工作——数学任务上它其实输给了不分块的普通 SFT——但它把 dLLM 的双向注意力用出了自回归模型做不到的花样,代码生成场景的增益是实打实的,值得细读。
📖 论文信息
- 标题:Register Tokens for Bounded-State Reasoning in Diffusion Language Models
- 作者:Albert Ge(UW–Madison)、Chandan Singh(Microsoft Research)、Yufan Zhuang(UC San Diego)、Xiaodong Liu、Jianfeng Gao(Microsoft Research)、Frederic Sala(UW–Madison)
- 链接:https://arxiv.org/abs/2609.16372 (2026 年 9 月 14 日提交)
- 代码:https://github.com/lbertge/dllm-registers-reasoning
🎯 为什么这个问题值得做
先花一分钟对齐一下背景。掩码扩散语言模型——LLaDA、Dream 这一系——生成文本的方式是从一串全是 [MASK] 的序列出发,反复去噪,每次把高置信度的 token 确定下来。和自回归模型比,它的注意力是双向的:序列里每个位置都能看到所有其他位置。
这个特性既是礼物也是诅咒。礼物在于全局一致性和并行解码;诅咒在于——推理(reasoning)这件事,说到底需要时间上的延续性。自回归模型天然有:前缀就是状态。扩散模型没有。
现在 dLLM 做长生成的主流做法是半自回归分块:固定一个窗口大小 C,生成完一块,再往上下文里追加一个新的掩码块。之前生成的文本一直留在那儿。坦白讲,这基本就是把 dLLM 退化成"块级自回归",而且比真正的自回归还贵——没有 KV cache 可复用,每一步都是全序列的双向注意力,开销随总长度平方增长。
作者换了个角度:既然 dLLM 的双向注意力让固定位置既可读又可写(自回归模型里 attention sink 那种特殊位置基本是只读的),为什么不拿几个固定位置当"寄存器"用?每块生成完,把中间进度写进这几个位置的隐藏状态;清空文本,下一块从 prompt 加寄存器状态接着来。无论生成多少块,活动窗口和携带状态的大小都不变——这就是论文标题里的 bounded-state。
这个思路说实话让我想到两件事:一是 Vision Transformer 里那篇经典的 register tokens 工作(加几个可学习 token 吸收注意力 artifact),二是自回归世界的 KV cache 压缩。但这里有个本质区别:寄存器携带的不是文本的压缩副本,而是模型自己决定要写什么的连续向量。它可以是任何对后续推理有用的东西——中间计算结果、规划状态、甚至某种我们还读不懂的表示。
🧠 方法:寄存器怎么写、怎么读、怎么训练
推理流程
设 prompt 里固定了 R 个寄存器位置。流程是这样的:
- 模型在固定窗口里去噪生成一块文本;
- 块写完后,对 prompt 加这块干净文本再跑一次前向传播,取模型最后一层在寄存器位置的隐藏状态,得到一个 \(R \times d\) 的张量;
- 清掉这块文本,把寄存器位置的输入嵌入替换成刚保存的值,开始下一块。
同一组寄存器位置在每一块后被复用和覆写。所以模型必须自己学会:随着推理推进,哪些信息该留,哪些该扔。这个额外的前向传播开销很小——65 次去噪传播只多加 1 次,大约 1.6% 的开销。
训练:分块 SFT,但梯度要跨过块边界
训练数据是长推理轨迹,切成最多 C token 一块的小块,每块用标准的掩码扩散目标训练:
关键在续写块(第 k 块,k 大于 0)的处理:先对 prompt 和干净的前一块做前向传播,读出寄存器隐藏状态,喂给当前块。这个前向传播保留在计算图里——梯度从当前块的去噪损失流回前一次的寄存器写入过程。也就是说,"写什么进寄存器"这件事是被端到端优化的,不是拍脑袋的启发式。供后续块复用的寄存器状态则 detach 掉,保持训练显存有界。
说实话,看到这里我第一反应是:等等,这个设计真的有必要吗?模型会不会直接绕过寄存器走捷径?作者显然也想到了,而且堵了两个漏洞:
漏洞一:prompt 旁路。续写块的补全 token 可以直接注意 prompt,从头把题重新做一遍,寄存器就成了摆设。对策是以概率 \(p_{prompt}\) 对续写块应用 prompt 掩码——补全 token 既看不到 prompt,也无法通过寄存器间接访问 prompt(因为写寄存器那次前向传播同样被掩码)。
漏洞二:未掩码 token 旁路。如果块内只有部分 token 被掩码,未掩码的那些本身就提供了足够上下文,模型不用读寄存器也能预测。对策是每块做 M 次去噪传播(主实验 M=4),第一次强制全掩码:
论文还给了一个挺干净的理论刻画(Proposition 1):在 prompt 掩码且全掩码的续写块上,模型的期望损失下界是
用人话说:要想比"忽略寄存器的最优预测器"做得更好,寄存器 \(\mathbf{r}\) 必须真的携带关于目标 \(Y_j\) 的信息。互信息 \(I(Y_j;\mathbf{r}\mid\ell)\) 就是寄存器被逼着学会的"功课"。这种把设计压力写成互信息下界的做法,我挺喜欢——它不证明方法有效,但至少说明训练目标确实在逼着寄存器干活。
RL 精调:chunked diffu-GRPO
寄存器还有一个隐性优势:它是连续的、可微的。论文顺手做了一个 RL 阶段——在 diffu-GRPO 的基础上,块间状态转移 \(s_{k+1} = f_\theta(p, t_k, s_k)\) 在策略更新时重算,梯度流回第 k 块的寄存器写入(对 \(s_k\) 本身 stop-gradient)。对比之下,离散文本携带的是采样出来的 token id,没有可微的状态路径,RL 信号传不回去。这个差异在长程任务上会兑现成收益,后面实验部分能看到。
🧪 实验:代码上是真的能打,数学上有个扎心的反转
设置
基座模型 LLaDA-8B-Base 和 Dream-7B-Base,60K 混合训练数据(OpenMathInstruct-2 加 OpenCodeInstruct)。数学每块 128 token、最多 8 块;代码每块 64 token、最多 16 块,两者都是 1024 token 总预算。所有方法都从同一基座、同一数据、匹配优化器设置训练——这个对照做得比较干净。
三个基线:Full-sequence SFT(不分块、不携带任何状态);Discrete text(把每块最后 4 个生成的 token id 携带到下一块的 4 个离散槽位,和 4 个寄存器位置数量匹配);Memory tokens(基于重构损失训练的压缩基线,和 ICAE 一脉相承,同样 4 个槽)。
主结果
LLaDA-8B,数学(C=128,最多 8 块):
| 基准 | Full-seq SFT | Discrete text | Memory tokens | Registers |
|---|---|---|---|---|
| GSM8K | 57.4 | 40.6 | 48.4 | 49.1 |
| GSM-Hard | 21.7 | 13.0 | 18.6 | 16.9 |
| MATH500 | 22.4 | 14.6 | 15.6 | 17.6 |
| Omni-MATH easy | 23.6 | 19.2 | 20.9 | 22.7 |
LLaDA-8B,代码(C=64,最多 16 块):
| 基准 | Full-seq SFT | Discrete text | Memory tokens | Registers |
|---|---|---|---|---|
| HumanEval | 14.0 | 18.3 | 12.8 | 26.2 |
| MBPP | 25.7 | 18.3 | 10.5 | 29.2 |
Dream-7B,数学:GSM8K 上 Registers 42.9 对 Discrete text 的 35.0;Omni-MATH easy 19.3 对 16.4。Dream-7B,代码:HumanEval 30.5 对 25.6;MBPP 40.9 对 21.4——19.5 个点的差距,这是全文最大的单点提升。
几个值得停下来看的点。
寄存器在全部 12 行里都赢过 Discrete text,在 10 行里是所有携带方法中最好的。连续状态打赢离散文本,这符合直觉——4 个 token id 能装的信息量跟 4 个 d 维向量没法比。
但扎心的来了:Full-sequence SFT 在全部 8 行数学任务上都是第一名,包括那些它"按道理"不该赢的行。为什么?作者的解释让我愣了一下:Full-seq SFT 的所有正确答案都在第一块就给出了——尽管它训练数据里只有约 3.7% 的补全能装进 128 token。你想想看,一个从没被训练过"压缩答案"的模型,在有界评估协议下自发学会了把解题过程塞进一个小窗口。这说明 dLLM 的并行去噪本身就有很强的"先想清楚再落笔"的能力,分块携带在数学上解决的可能是个半伪命题。
代码任务画风完全不同。正确程序通常要跨好几块(C=64 时代码轨迹中位数 4 块,多块率接近 100%),窗口装不下就是装不下,压缩答案没用。这时候携带状态的价值才真兑现:Registers 对 Full-seq SFT 的领先是 LLaDA HumanEval 加 12.2、Dream MBPP 加 10.9。有界状态推理的真实主场在代码,不在数学——这个区分我觉得是全文最有价值的实验结论之一。
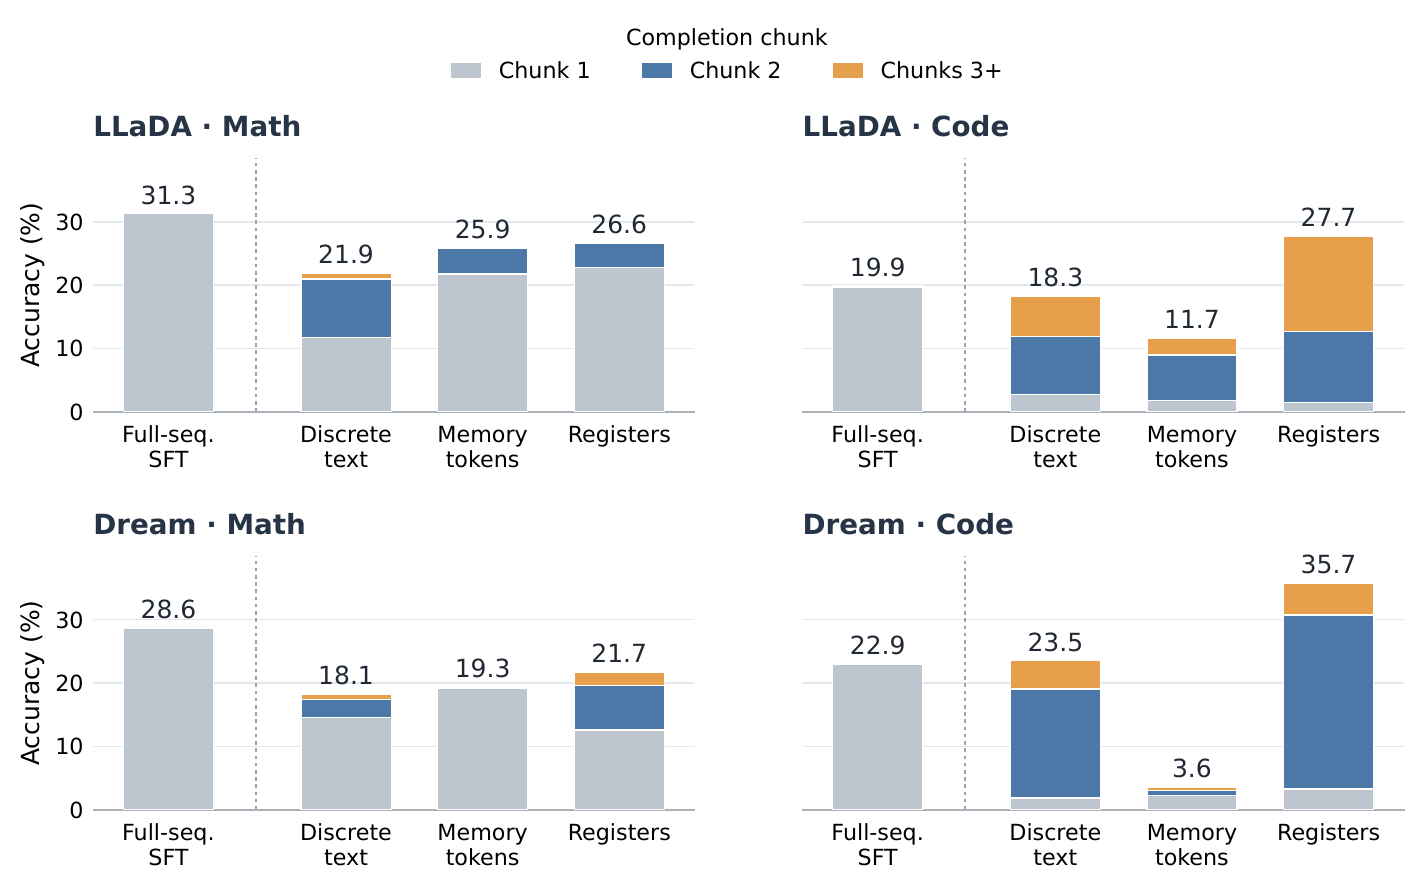
Figure 3:按"第几块完成任务"分解的准确率。灰色是第一块解决的,深蓝是第二块,橙色是第三块及以后。代码任务里 Registers 的大幅领先几乎全部来自第二块之后(LLaDA 27.7 分里的 26.2 分、Dream 35.7 分里的 32.4 分都在首块之后完成);而数学上各方法的大部分分数都堆在第一块——这正是 Full-seq SFT 在数学上难被撼动的结构性原因。
效率:省下的注意力开销是真的
Table 2 给了 wall-clock 对比(禁用早停):2048 token 时有界携带 75.6 秒对全上下文 260.7 秒,3.4 倍加速;3584 token 时 132.4 秒对 736.3 秒,5.6 倍。窗口固定之后,开销随块数线性增长而不是平方增长,长度越长省得越多。当然要注意硬币的另一面:同一个检查点在 GSM8K 上,全上下文解码能到 63.2,有界携带只有 48.9——寄存器目前还不能替代全上下文,它买的是"长度可扩展性",付出的是精度。作者在局限性里也承认了这一点,没有藏着掖着。
RL 精调:连续状态的复利
chunked diffu-GRPO 之后(平均有界奖励乘 100):Countdown 任务 Discrete text 19.7 对 Registers 22.3;LongArithmetic 任务 31.6 对 39.7,8.1 个点的差距。LongArithmetic 是典型的长程任务——一长串算术运算,中间结果必须跨块携带。连续状态在这里把"可微"的优势兑现了:RL 信号能顺着状态转移路径回流到寄存器写入,离散 token 携带做不到这一点。
寄存器里到底装了什么
这是我最喜欢的部分。作者做了两组诊断。
一组是干预实验:LLaDA GSM8K 上,完整携带寄存器时准确率 46.4;把寄存器换成范数匹配的高斯噪声(方向打乱、能量不变),掉到 32.7;换成初始寄存器嵌入(等于重置),掉到 21.5。破坏方向损失 13.7 分,重置再损失 11.2 分。这说明后续块因果性地依赖寄存器里写入的具体内容——不是"多了几个槽位所以容量变大"这种平庸解释。
另一组是线性探针:RL 之后 LongArithmetic 任务的寄存器状态,用线性模型能解码出累计运行总和(Pearson R 0.84)、最终答案(R 0.85)、下一步运算(准确率 80.0%,多数类基线 56.7%)。也就是说寄存器携带的是紧凑的、可读出的计算状态变量,而不是某种玄学的"额外容量"。
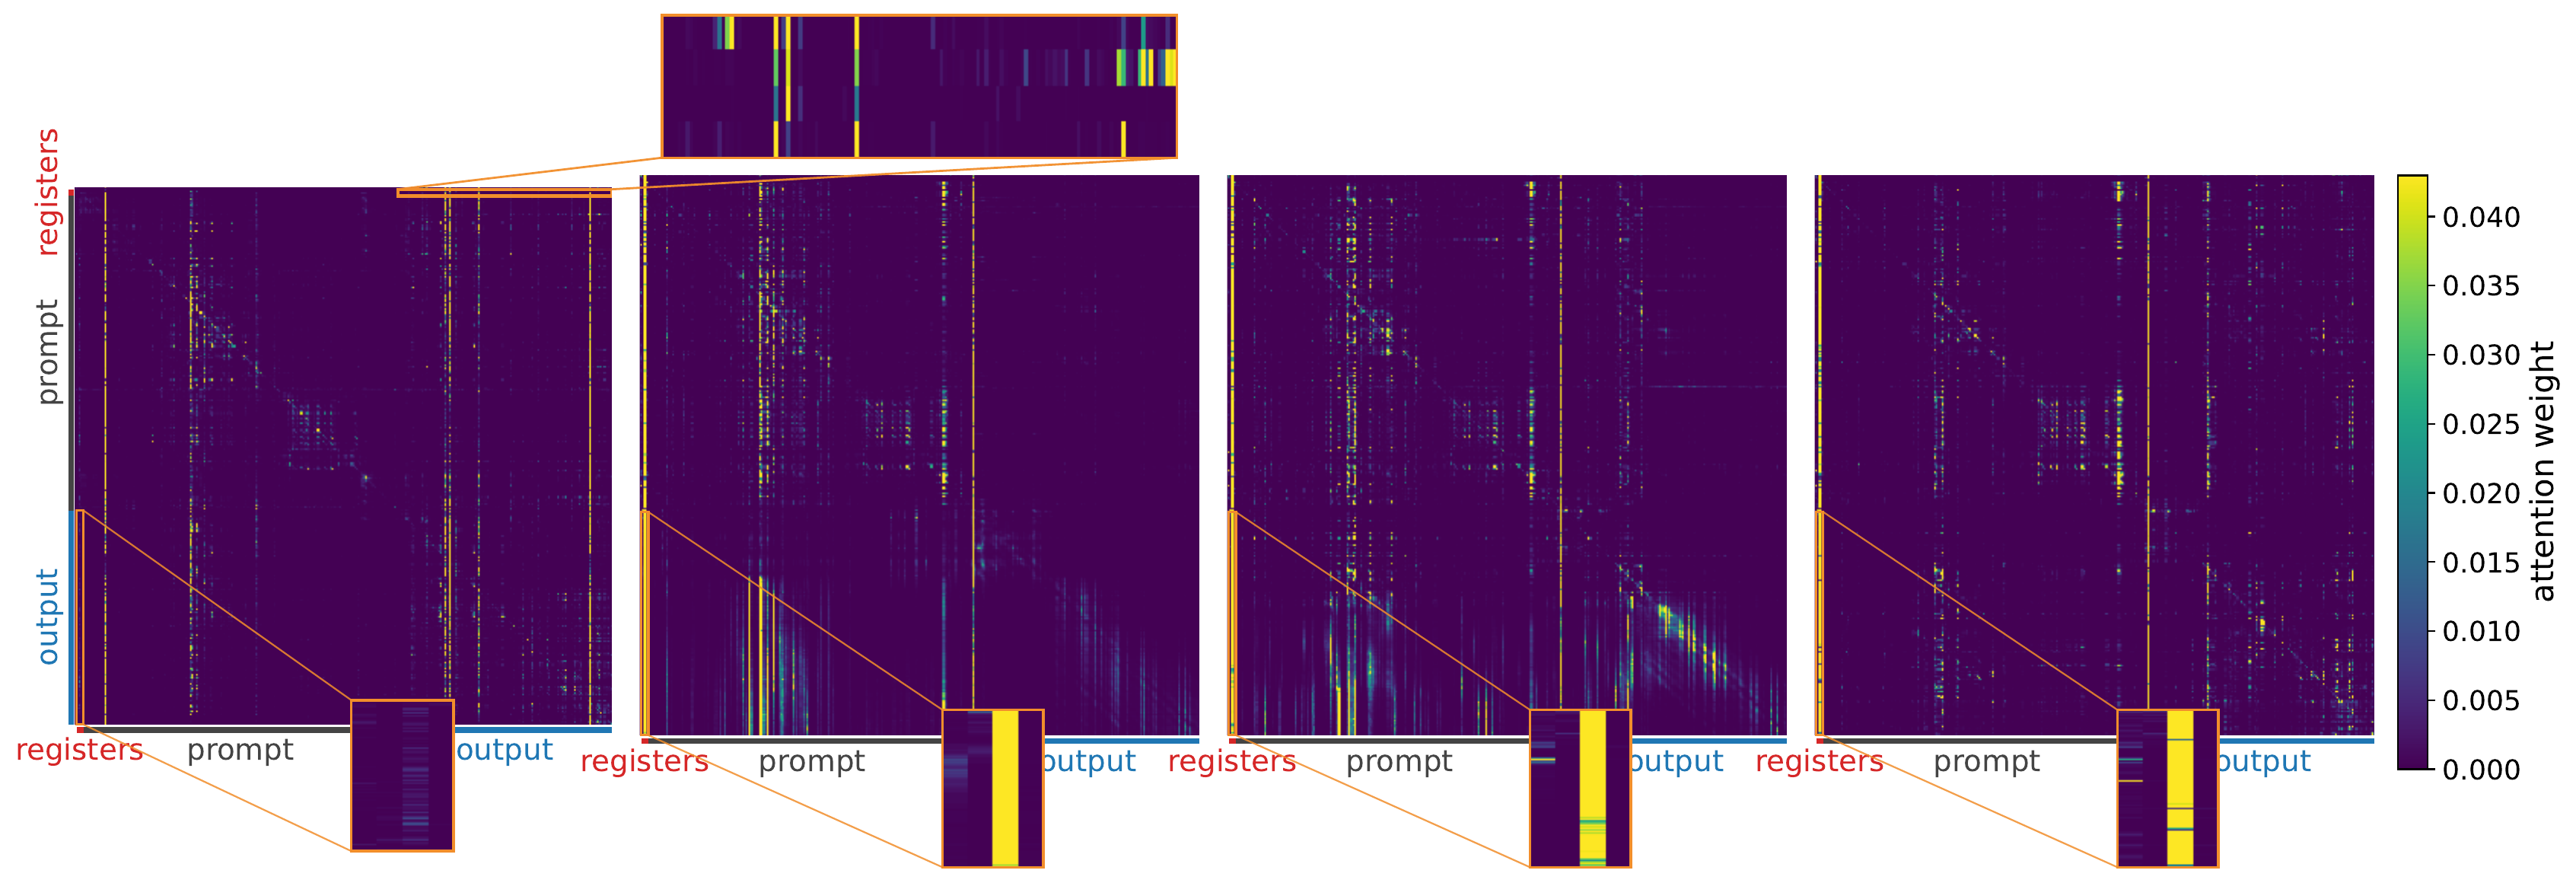
Figure 5:LLaDA 第 29 层第 13 个注意力头的热力图,四个面板展示从"前一块完全去噪"到"下一块去噪收敛"的过程。放大的小窗是寄存器位置的注意力列。前一块写完时这个头是写入主导——寄存器作为 query 强注意输出区的 key(把进度写进去);上下文重置后切换成读取主导——输出 token 作为 query 强注意寄存器的 key(把状态读出来)。一个注意力头在两个阶段扮演了方向相反的角色,这个画面挺漂亮的。
槽位数量与数据量的消长
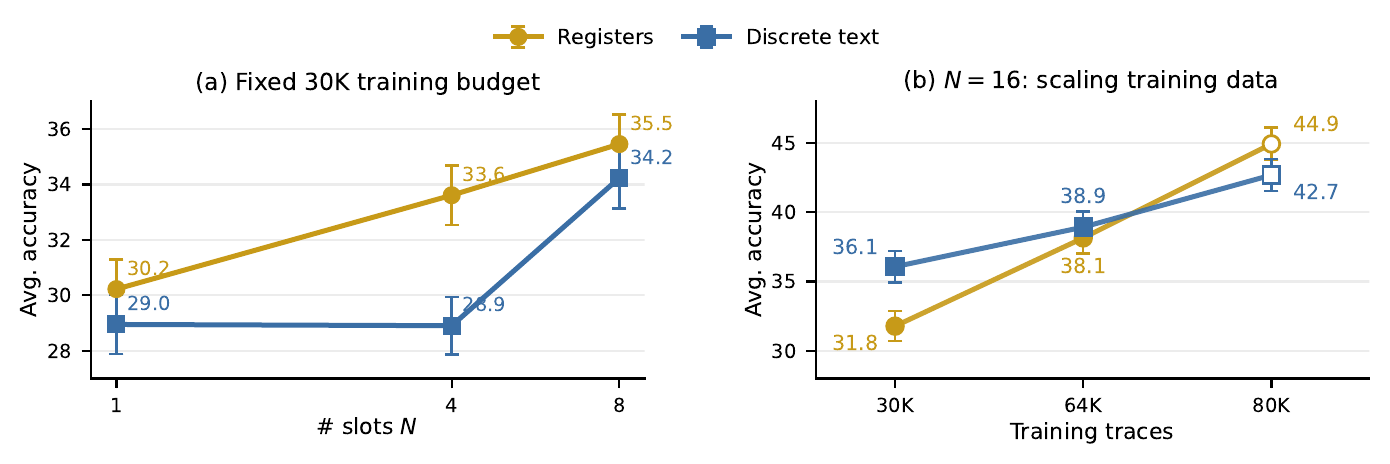
Figure 4:左图是固定 30K 训练预算下寄存器槽位数 N 的扫描——N=4 时寄存器领先离散文本最多(33.6 对 28.9,差 4.7 个点),N=1 和 N=8 时差距收窄;右图是 N=16 时随数据量变化——30K 时寄存器落后(31.8 对 36.1),64K 接近持平,80K 加 warmup-stable-decay 冷却后反超(44.9 对 42.7)。连续状态容量更大,但也更"吃数据",数据不够时反而学不过简单的离散携带。
这个消融其实藏着一个工程上很重要的信号:寄存器不是免费的午餐,它和离散文本的关系类似"高容量但难优化"对"低容量但稳健"。数据预算小的时候,别急着上寄存器。
🔬 批判性审视
这篇论文的诚实程度超出平均水准,局限性一节写得相当坦白,我挑几个重点说。
数学上的反转结果其实动摇了论文的部分叙事。摘要里强调"数学上最多涨 8.5 个点",但那是相对 Discrete text 的;相对不分块的 Full-seq SFT,寄存器在数学上全败。也就是说,在窗口能装下完整推理链的任务里,dLLM 自己就会压缩答案,携带状态是多余的。论文真正的贡献圈应该画在"推理链必然跨块"的场景——长代码、长算术、长程规划。这不是贬低,是校准。
评估统计上偏弱。多数 SFT 比较只用单个种子,作者自己承认"并非每个数值领先都单独显著"。像 Dream MATH500 上 Registers 12.4 对 Memory tokens 12.6 这种差距,基本就是一道题的事。好在主要结论(寄存器全胜离散文本、代码上大幅领先)跨 12 行一致,方向性结论还是稳的。
槽位匹配的方式值得商榷。4 个寄存器对 4 个离散 token,匹配的是数量而不是信息容量——一个 d 维向量能装的比特数和 4 个 token id 完全不在一个量级。更公平的对照或许是给离散文本更多槽位,或者反过来限制寄存器维度。作者也承认了这一点。
最让我警觉的是附录里那个存在性证明实验:写/读协议不会自发涌现。小规模合成实验里,只靠任务损失,模型学会块内预测后就弃用携带槽;全边界反向传播在 24K 步预算内也没改变。需要辅助损失直接监督槽位对齐真实边界状态才能打破僵局,而且这个退火过程跨种子不稳定。说实话这块我也还没完全想透——主实验的 chunked SFT 之所以 work,可能部分得益于真实推理轨迹里块边界天然携带了强监督信号。这个机制什么时候自发涌现、什么时候需要额外引导,是个没关上的问题。
💡 我的判断
这篇论文最值钱的地方,不是"寄存器涨了多少点",而是它指出并验证了 dLLM 相对自回归模型的一个结构性差异:双向注意力让固定位置既可读又可写,这使得"模型自主管理的连续携带状态"成为可能。自回归模型里 KV cache 是生成的副产品,被动累积;这里的寄存器是主动写入、主动覆写的,更像 RNN 的隐状态,或者计算机里真正的寄存器——名字起得很准。
对工程的启发,我会这么排:
如果你在部署 dLLM 做长代码生成或长程 Agent 任务,上下文长度是硬约束,这个方案值得试——1.6% 的额外开销换线性注意力增长,代码场景还有两位数的精度收益。
如果你在数学类任务上用 dLLM,先别急着上分块携带。试试让模型自己压缩到单窗口,Full-seq SFT 的结果说明 dLLM 在这方面有未被充分利用的潜力。
如果你在做 RL 后训练,连续携带状态提供的可微路径是个真实的差异化优势,LongArithmetic 上 8.1 个点的差距就是证据。
最后留一个追问:寄存器目前是靠 prompt 掩码加全掩码"逼"出来的,那个"自发涌现"的失败实验暗示这套机制对训练配方相当敏感。什么时候携带状态能像 attention sink 那样自然涌现而不是被设计出来?这个问题要是解决了,dLLM 的推理范式可能真的要变天。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我