递归自我改进到底是个什么东西?这篇论文用"两个旋钮"把它和经典强化学习缝在了一起
你有没有发现一个挺微妙的状况——这两年"自我改进"这个词在 AI 圈被用滥了。一个智能体跑个 Reflexion 循环叫自我改进,一个 LLM 改写自己的 prompt 叫自我改进,Darwin Gödel Machine 那种直接重写自己代码的也叫自我改进。大家都在谈 RSI(recursive self-improvement,递归自我改进),但你要是真追问一句"这些系统是同一个东西吗?它们和经典 RL 里的 policy iteration 到底差在哪?",大多数人只能给你一个含糊的回答。
今天这篇论文就是来回答这个问题的。它不提出新算法、不刷榜,而是干了一件更底层的事:给"自我改进"建一个形式化的坐标系,让所有号称在做 RSI 的系统都能被放到同一张图上比较,并且把 RSI 会出问题的环节一个一个点名出来。
📌 核心摘要
这是天津大学与山西大学团队的一篇纯理论框架论文。核心观察是:经典强化学习里的广义策略迭代 GPI(Generalized Policy Iteration)之所以有漂亮的收敛保证,是因为改进规则和评估标准都在 agent 之外;而 RSI 恰恰把这两样东西往 agent 内部搬。作者提出 Generalized Agent Iteration(GAI)框架,把 agent 定义为系统内一组可修改组件的配置,学习过程就是"评估 agent"与"改进 agent"的交替循环。GPI 和 RSI 的区别被压缩成两个"旋钮":改进机制(modifier)在不在 agent 内部、评估基准(evaluation base)是否锚定在 agent 之外。旋钮一拨,policy iteration、STOP、Gödel machine、Darwin Gödel Machine 这些看似不相关的系统全部落到同一个坐标系里。顺着坐标,作者还推出了 RSI 的四个结构性缺陷——其中两个已经在真实系统中被观测到了。说实话,这类"建坐标系"的论文很容易写成自嗨的空中楼阁,但这篇的坐标系是真的能用来干活的,值得细读。
📖 论文信息
- 标题:Generalized Agent Iteration: One Formal Framework for Iterative Policy Improvement and Recursive Self-Improvement
- 作者:Hongyao Tang(唐洪尧)、Yi Ma、Pengyi Li、Yifu Yuan
- 机构:天津大学、山西大学
- arXiv:https://arxiv.org/abs/2609.13406 (2026 年 9 月 11 日)
🎯 问题动机:RSI 这个词已经快失去意义了
先把问题摆清楚。
当我们说一个系统在"递归自我改进"时,我们到底在说什么?是一个现象(分数确实在涨)、一个机制(它在改自己的某部分代码)、还是一个愿景(智能爆炸的起点)?论文开篇就抛出这个追问,因为现状确实是混乱的:
- Reflexion、Self-Refine 这类方法,让 LLM 在固定循环里反思修改输出,也叫自我改进;
- STOP(Self-Taught Optimizer)用 LLM 改进自己的 scaffolding 代码,作者自己都承认"不是完全递归的自我改进"——因为底层模型没动;
- Darwin Gödel Machine(DGM)维护一个智能体档案库,不断改写自己的 Python 代码库,SWE-bench 从 20.0% 干到 50.0%,看起来更像"真 RSI";
- 而 Schmidhuber 2003 年提出的 Gödel machine 原版构想,要求每次自我修改都附带数学证明,至今没有真正实现过。
这些系统共享一个名字,但形式化上完全是不同的动物。更要命的是,没有一个统一语言能描述"它们各自改的是什么、谁来评判改得好不好、评判的标准会不会自己动"。
而经典 RL 那边其实早就有答案的雏形——GPI。policy evaluation 和 policy improvement 交替进行,互相推着对方向上走,有限 MDP 下收敛到最优策略,理论干干净净。但 GPI 的描述里藏着一个从来不被点破的前提:更新算子和奖励函数都是环境给的,agent 碰不到它们。RSI 打破的恰恰是这个前提。
我之前看 DGM 那篇论文的时候就有点不舒服:它说自己实现了 Gödel machine 的精神,但 DGM 的 evaluator 是固定的外部 benchmark,而 Gödel machine 的构想里证明器本身是系统的一部分。这俩到底算不算一类东西?没有框架你根本没法严肃讨论。这篇论文给的框架,刚好能回答这类问题。
🏗️ GAI 框架:把 agent 拆成五个组件
先看老坐标:GPI 长什么样
经典 GPI 的循环大家都熟,两个角色来回拉扯:
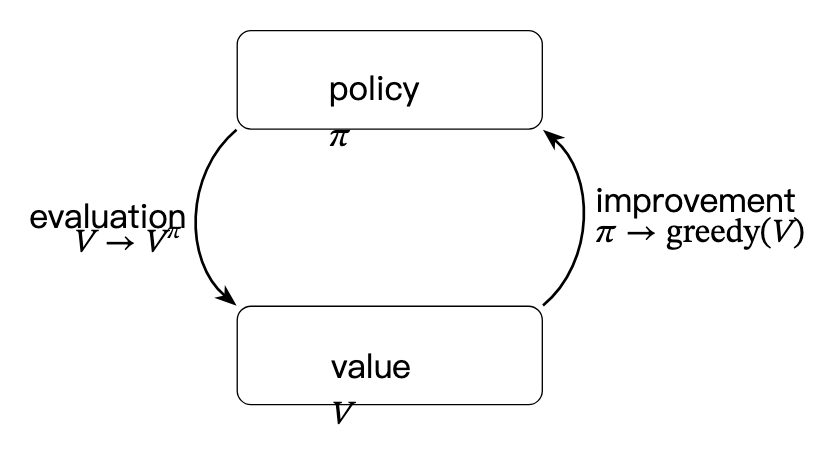
图1:GPI 循环——evaluation 让价值函数向当前策略靠拢(\(V \to V^\pi\)),improvement 让策略向价值函数的贪心方向走(\(\pi \to \text{greedy}(V)\))。每一步可以是部分的、交错的,但只要评估和改进的规则固定在 agent 之外,有限 MDP 下就能收敛到最优。
注意这张图里没被画出来的东西:谁在做 evaluation 和 improvement? 是 Bellman backup 和 greedy 算子——它们写在算法里,不在 agent 里,agent 自己永远改不了它们。这就是 GPI 所有理论保证的隐形地基。
GAI 的拆法:系统 = 五个可修改组件
GAI 框架的第一步,是把"系统"和"agent"分开。
世界建模为 MDP \(\mathcal{W} = (\mathcal{S}, \mathcal{A}, p, r)\),外部目标为 \(G\)——这俩都属于环境,不属于系统。系统的任务是让累积回报最大化:
关键的一句话:这个最优目标由世界和目标固定,而不是由系统自己固定。这句话现在看是废话,后面会发现它是整个框架的命根子。
然后,系统 \(\chi\) 被拆成五个组件 \(\mathcal{O} = \{\pi, V, m, U, \rho\}\):
| 组件 | 名字 | 干什么 |
|---|---|---|
| \(\pi\) | policy | 干活策略 |
| \(V\) | action critic | 评估动作好坏(价值函数) |
| \(m\) | modifier | 改进机制,负责产生新的 agent 实例 |
| \(U\) | modification critic | 评估"某次修改好不好" |
| \(\rho\) | evaluation base | 评估所依据的基准(比如奖励函数、benchmark) |
agent 不再是"整个系统",而是系统内一组可修改组件的配置。记 \(Ag \subseteq \mathcal{O}\) 为构成 agent 的组件集合,agent 实例 \(\xi\) 就是给这些组件赋上具体内容。系统每走一步,modifier 抽取一个新实例 \(\xi \sim m(\cdot | \chi)\),系统迁移到 \(\chi[\xi]\)。
学习过程 = agent evaluation 与 agent improvement 的交替循环。形式上跟 GPI 完全同构——这就是"Generalized"的含义,作者在脚注里明说,GAI 的命名就是对 Sutton & Barto 书里 GPI 的致敬。
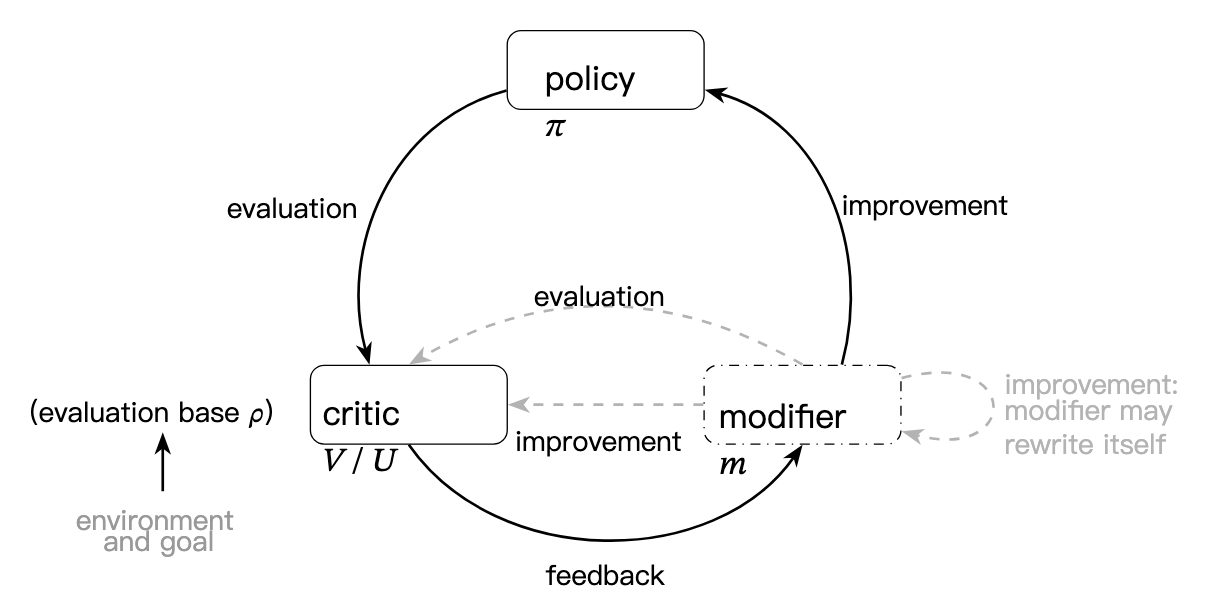
图2:GAI 循环——policy、critic、modifier 三方成环。critic 依据 base \(\rho\) 评估 policy 和 modifier 并回传反馈;modifier 产生改进,灰色虚线表示它还可能重写 critic 乃至它自己(递归在 \(m\) 处闭合);modifier 的点划线边框标记它只有在 \(m \in Ag\) 时才属于 agent。把 modifier 钉死在 agent 外面,这张图就退化成图1的 GPI。
两个旋钮:所有系统的坐标
框架真正的精华是两个"dial"(旋钮/开关):
旋钮 1:modifier \(m\) 是不是 agent 的一部分?
- \(m \notin Ag\):改进规则固定在 agent 之外。GPI 就是这个设置——\(Ag = \{\pi, V\}\),modifier 的内容就是固定的评估算子 \(\mathcal{E}_m\) 和改进算子 \(\mathcal{I}_m\): $\(V \leftarrow \mathcal{E}_m(V, \pi; \rho_V), \qquad \pi \leftarrow \mathcal{I}_m(V)\)$ 当 \(\mathcal{E}_m\) 是 policy evaluation、\(\mathcal{I}_m\) 是 greedy,这就是教科书上的 policy iteration,收敛保证自动继承。
- \(m \in Ag\):系统能改写自己的改进机制,递归在 \(m\) 处闭合,没有任何外部 meta 层来更新它。这才是强 RSI。
旋钮 2:评估基准 \(\rho\) 是否锚定在 agent 之外?
评估是 grounded 的,当且仅当基准的内容来自系统之外(世界与目标),而且基准本身不在 agent 里——也就是 agent 无法重写衡量自己的那把尺子。
旋钮 2 拨出三种"极性"(polarity):
| 极性 | \(\rho\) 的状态 | 后果 | 代表系统 |
|---|---|---|---|
| Anchored(锚定) | 内容来自外部,且 \(\rho \notin Ag\),agent 改不了 | 朝着固定外部标准改进 | Gödel machine、STOP |
| Goal Drift(目标漂移) | 内容来自外部,但 \(\rho \in Ag\),agent 能改 | 衡量标准被重写,改进逐渐漂离原目标 | Red Queen Gödel Machine |
| Fully Self-Referential(完全自指) | 无外部内容,或 \(\rho\) 依赖 \(U\) 自身 | 没有任何外部信号进入循环 | Socratic learning 等构想 |
有个细节值得玩味:Goal Drift 指的不是目标本身变了——外部目标 \(G\) 名义上一直在那儿——而是衡量"离目标多近"的那把尺子被 agent 自己挪了。所以它是两种失控模式里更难察觉的那种。分数照涨,世界照骗。
另外作者很诚实地指出:目前真正能跑起来的自我改进系统几乎全部落在 Anchored 这一行,下面两行主要是边界案例和立场性论文。这跟我观察到的行业现状一致——没人真敢把评估标准交给 agent 自己改。
🧭 把现有系统放上坐标系
框架搭好了,立马可以用来给现有系统"对号入座"(论文 Table 3 的整理):
| 系统 | agent 组件 \(Ag\) | 旋钮1:\(m\) 可改? | 旋钮2:极性 | 分类 |
|---|---|---|---|---|
| Policy/value iteration、PPO | \(\{\pi, V\}\) | 否,更新规则固定 | Anchored(环境奖励) | (Anchored) GPI |
| 固定外循环 pipeline(Reflexion、Self-Refine 等) | \(\{\pi\}\) | 否,循环由设计者写死 | Anchored(外部验证指标) | (Anchored) GPI |
| Gödel machine | \(\{\pi, m\}\) | 是,证明通过才改代码 | Anchored(固定外部效用 + 证明门) | Anchored RSI(带守卫) |
| DGM、Gödel Agent、STOP、SICA、Polaris 等 | \(\{\pi, m\}\) | 是,改写 prompt/memory/工具/代码 | Anchored(外部 benchmark) | Anchored RSI |
| Red Queen Gödel Machine | \(\{\pi, m, U\}\) | 是,evaluator 跟着一起演化 | Goal Drift | Drifting RSI |
| 封闭系统构想(Socratic learning 等) | 全部组件含 \(\rho\) | 是,连基准都能改 | Fully Self-Referential | 完全自指 RSI |
看到这张表我才意识到这个框架的用处——它一刀切开了一个长期被搅在一起的区别:绝大多数号称"自我改进"的系统,其实只是固定机制里的 bounded self-improvement。DGM 确实能改自己的代码,但它的 evaluator(SWE-bench)从头到尾没动过,modifier 改写的只是"干活的那部分",衡量它的尺子牢牢钉在外部。按 GAI 的分类,DGM 和 policy iteration 共享同一个极性——都是 Anchored。它们的差别只在旋钮 1。
这个观察其实挺扎心的。2025 年 DGM 出来的时候一堆人喊"RSI 来了",但按这个坐标系看,它和真正的强 RSI 之间还隔着至少一个旋钮的距离。倒是 Nathan Lambert 最近提的"LSI(有损自我改进)"说法——现实里各种摩擦会拖慢自我改进循环——和这篇论文的悲观调子意外地合拍。
⚠️ RSI 的四个缺陷:经典保证是怎么一条条丢掉的
这是我觉得全文最值钱的部分。
GPI 的理论保证依赖两个条件:改进步骤廉价且单调(每次 improvement 不会让策略变差),以及目标与评估工具都在 agent 之外。RSI 把旋钮一拨,这两个条件就可能全丢。作者把丢失的方式拆成四个缺陷,每个都能对应到被违反的具体 GPI 条件:
| 缺陷 | 触发条件 | 违反的 GPI 条件 | 状态 |
|---|---|---|---|
| 候选自我搜索 | 旋钮1:\(m \in Ag\) | 改进廉价且单调 | 结构性;已观测 |
| 自我评估 | 旋钮1:\(U \in Ag\) | 评估者立于被评估者之外 | 结构性 |
| 无锚基准 | 旋钮2:\(\rho_U\) 不 grounded | 目标由 agent 之外评估 | 结构性 |
| 目标漂移 | 旋钮2:\(\rho_U \in Ag\) | 同上,随基准被重写而失去 | 结构性;已观测 |
挑两个重点说。
缺陷一:改进不再单调。 GPI 里每次 greedy improvement 数学上保证不退化,但 RSI 的改进是在无界内容空间上找 argmax,不存在通用程序能保证找到最佳候选——Gödel machine 用"证明门"(证明有益才改)来绕开这个问题,DGM 用 benchmark 实证检验来绕,但绕法都有代价。作者引了一个实证数据(RSIBench-Data):58.33% 的设置里第一次有效尝试就有改进,但越过最佳分数继续搜的实验中,78.26% 最终以更低的分数收场。看到 78.26% 这个数我愣了一下——即使外部标准固定不动,自我改进的轨迹也不是单调向上的,搜过头反而更差。这跟做工程时"再调一版说不定更好,结果越调越烂"的体感完全吻合。
缺陷四:目标漂移有形式化先例。 当评估基准 \(\rho_U\) 变成 agent 的组件,问题不是"目标变了"而是"衡量机制被收编了"。作者把这个问题接到了决策理论的老文献上:Everitt 等人 2016 年证明过,能改写自身效用函数的 agent,只有当它的价值函数"预期到改写、且仍用当前效用去评估未来"时才无害;Ring 和 Orseau 2011 年的 delusion box 思想实验则展示了更极端的形态——agent 重写自己的输入通道后,不需要世界配合就能让评估信号满分。说白了(哦不,换个说法)你想想看,一个连"考卷和阅卷老师"都能换的考生,分数还有什么信息量?
等等,这里有个我得坦诚的点:论文把 delusion box、效用改写这些决策理论结果当作 RSI 缺陷的"形式先例"来引用,逻辑上是类比而非严格归约。作者自己也承认,从 RSI 到 GPI 的归约目前还是散文式描述,不是带显式假设的命题。这个框架现在是"描述性工具",还不是"证明机器"。
🤔 我的判断
这篇论文的定位要放准:它是一篇概念框架论文,价值不在定理而在坐标系。
亮点有三个。一个是两个旋钮的设计真的干净——m 在不在 agent 里、ρ 在不在 agent 外,两个二元问题就把 GPI 到完全自指 RSI 的整个谱系张开了,而且现有系统放上去几乎没有放不下的。二个是四个缺陷的拆解方式,"每个缺陷对应一条被违反的 GPI 条件",这让"RSI 有风险"这种泛泛而谈变成了可以逐条检查、逐条设计 guard 的清单。三个是作者的克制——明确承认绝大多数现有系统只是 Anchored,明确指出自己的归约还是散文不是命题,这种诚实在这个动不动就喊"智能爆炸"的方向上挺稀缺的。
问题也有。框架只描述系统"如何变化",不描述变化"如何计算"——modifier 内部的搜索成本、样本复杂度全在视野之外,所以它没法告诉你 DGM 那样的系统到底能不能 scaling。另外表格里某些系统的归类依赖作者对系统的解读(比如把 PPO 的 clipped update 也算作固定 modifier),细抠会有争议。还有一个更现实的缺口:框架明确不建模人类监督,但实践中所有跑起来的 RSI 系统(DGM、SICA)都靠沙箱加人工审查兜底——而兜底机制恰恰是实践里最贵的部分。
工程上的启发倒是很直接:如果你在设计自我改进系统,先用两个旋钮给自己定位,然后对着四个缺陷逐条装护栏。modifier 可改?那就必须有类似证明门或 benchmark 验证的 gate,并且警惕"搜过头更差"的非单调性。evaluator 想跟着一起演化?那就是主动选择 Goal Drift 档位,得想清楚拿什么外部锚点兜底。这套检查清单比"我们的系统是安全的"这种空话有用得多。
回到开头的问题:GPI 和 RSI 是两种东西吗?这篇论文的答案挺漂亮——不是。它们是同一个交替循环在两组旋钮设置下的实例。真正的问题从来不是"能不能自我改进",而是"改进机制放在哪、尺子握在谁手里"。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我