GVA:KV 缓存里的 Key 其实可以不存——从 Value 里"现算"出来就行
做推理服务的人对 KV cache 的痛恨应该是共通的:模型权重是死的,一次加载完就完事;但 KV cache 是活的,每来一个 token 就往显存里塞一份 Key 和 Value,序列越长越撑不住,decode 阶段每步还要把整段 cache 从 HBM 里搬一遍,带宽直接被打满。GQA 把 K/V 头数砍到 G 组,已经省了一大块。这篇论文的作者问了一个更激进的问题:Value 必须存,那 Key 呢?能不能干脆不存,要用的时候从 Value 里重建出来?
📌 核心摘要
这篇 arXiv:2609.13285 提出了 Grouped Value Attention(GVA):只缓存 GQA 里的分组 Value,每个 query head 的 content key 用一个可学习的线性映射 \(K_h = V_{g(h)} M_h\) 从 Value 里重建。因为 \(M_h\) 在推理时是固定权重,可以直接吸收进 query,decode 路径上根本不需要物化 content key。位置信息交给一个很窄的共享 decoupled RoPE 通道,每 token 只多花 \(d_r\) 个标量。结果:持久化缓存比同配置 GQA 省约 45–47%,350M 参数、30B FineWeb-Edu token 的从零训练下,\(d_r=16\) 版本五个下游任务平均准确率 44.35,GQA 是 44.36——差距 0.01 个点,远在种子噪声范围内。我的判断:这是一篇思路漂亮、但系统收益还没兑现的"表示层"工作,值得收藏等它的 kernel 开源。
📖 论文信息
- 标题:Grouped Value Attention: Efficient KV Caching via On-Demand Key Reconstruction
- 作者:Vishesh Tripathi、Abhay Kumar(共同一作)、Ramsha Khan
- 机构:FrontiersMind
- 链接:https://arxiv.org/abs/2609.13285(v2,2026 年 9 月 15 日)
🎯 问题:K 和 V 真的是两笔独立的钱吗?
先把 KV cache 的账算清楚。每层每个序列,标准多头注意力要存 \(N_{\mathrm{MHA}} = 2THd_h\) 个标量——T 是缓存长度,H 是 query 头数,\(d_h\) 是头宽,那个 2 就是 Key 一份、Value 一份。MQA 只留一对共享 K/V(\(G=1\)),GQA 折中成 G 组,缓存是 \(N_{\mathrm{GQA}} = 2TGd_h\)。DeepSeek 的 MLA 更狠,把 K 和 V 压成一个宽度 \(d_c\) 的联合 latent 再加一小条共享 RoPE 通道,缓存变成 \(T(d_c + d_r)\)。
注意 MLA 的思路:它认为 K 和 V 有冗余,但选择压成一个第三方的 latent 表示,decode 时再各自上投影回去。GVA 的方向相反——不引入新表示,直接问:Value 本身能不能兼任 Key 的信息来源?
这个假设其实挺大胆的。作者的论证是:K 和 V 编码的是同一段底层内容,只是一个用来打分("我这个 token 值不值得被 attend")、一个用来被聚合("attend 到我之后拿走什么")。既然是同一段内容的两个视图,那从 V 推 K 至少在理论上是条可走的路。
说实话我第一反应是怀疑的——打分用的特征和被取走的特征,训练中明明会分化成很不同的东西。但作者的实验路线很诚实:他们先试了最naive的版本,失败了,然后才走到线性重建。
🧠 方法:先撞墙,再绕路
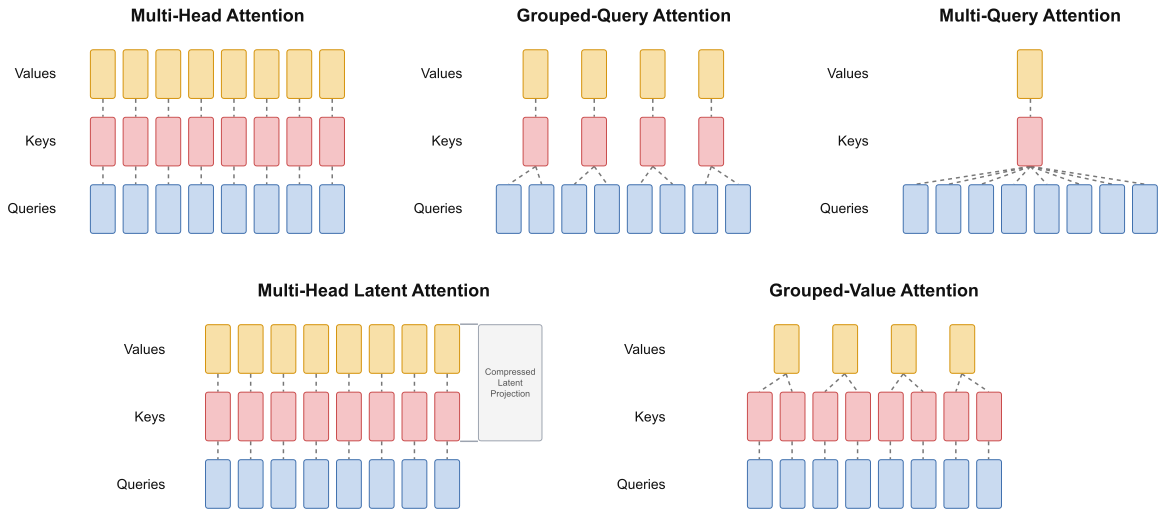
图1:8 个 query head 下五种方案的缓存结构。MHA 每个 head 各有 K/V;GQA 按组共享 K/V;MQA 只剩一对共享 K/V;MLA 把 K/V 压成一个联合 latent 再投影回去;GVA(右下)只缓存 4 个分组 Value,8 个 head 各自的 content key 由 \(K=VM\) 重建。
第一次尝试:K=V,撞墙了
最简单的砍法是让 Key 直接等于 Value,一条流当两用,缓存正好减半。结果呢?训练 loss 从头到尾追不上 GQA 基线。

图3:shared_kv(品红)对比 GQA 基线(橙)的训练 loss,横轴是消耗的 token 数。缓存确实减半了,但 gap 全程不收敛——一个向量既要负责打分又要负责被取走,两个角色互相打架。
这个失败其实信息量很大。它说明 K 和 V 虽然描述同一段内容,但训练确实会把它们推向不同的功能分工,硬合并是不行的。作者顺带还提到用这个共享 KV 思路加 query normalization 训了个 Lumma-0.6B 开源在 Hugging Face 上——算是失败探索的副产品。
第二次尝试:线性重建,K = VM
撞墙之后的修正很克制:保留独立的 Value,给每个 query head 配一个自己的线性映射 \(M_h \in \mathbb{R}^{d_h \times d_n}\),content key 用 \(K_h = V_{g(h)} M_h\) 重建。
这个设计有个我很喜欢的不对称性:GQA 是同组的 query head 共享同一把 Key,而 GVA 从 G 条 Value 流里能重建出 H 把不同的 Key。换句话说,key 的多样性(H 把)反而比 GQA(G 把)更丰富了,代价只是每 head 一个 \(d_h \times d_n\) 的小矩阵——参数量和序列长度无关,不碰缓存。当然作者也很清醒,自己点明了这个优势是对 GQA 而言的,MLA 本来就有 per-head 的 key 上投影。
关键技巧一:decode 时把 M 吸收进 query
\(M_h\) 是训练完就固定的权重,这带来一个漂亮的恒等式:
\(\tilde{q}_h\) 每个 query token 只算一次,之后对所有缓存位置的打分就是跟 Value 直接做内积。content key 从头到尾不需要被写出来——不是"压缩了再解压",而是压根不存在。这个吸收是精确的,不是近似。
但问题来了:标准 RoPE 会毁掉这个吸收。因为 query 和 key 之间的相对旋转 \(R_{j-t}\) 取决于位置对,它夹在 \(q_t\) 和 \(M^\top\) 中间,没法折进一个对所有缓存位置通用的变换后 query。这就是第二个技巧存在的理由。
关键技巧二:抄 DeepSeek 作业的 decoupled RoPE
作者直接采用了 MLA 的解耦 RoPE 方案:每个 head 切成不旋转的 content 切片(宽 \(d_n\))和旋转的 positional 切片(宽 \(d_r\)),RoPE 只作用于后者。positional key 是所有 head 共享的一条流,每 token 只占 \(d_r\) 个标量,而不是 \(G d_r\)。打分变成两项相加:
第一项继续享受吸收(content 切片不旋转,没有位置依赖挡路),第二项直接用缓存里已经转好的 \(k^{\mathrm{rope}}\)。位置信息保住了,content key 缓存没有复活。这个设计不是原创——作者自己写明是 follow DeepSeek MLA——但把它嫁接到"value-only 缓存"上是这篇论文的拼装巧思。
关键技巧三:一个容易被忽略的初始化细节
这个点论文放在 3.1 节末尾和附录 A,我觉得反而是工程上最值钱的细节之一。
GQA 里 Q 和 K 是同一份 hidden state 的两个独立投影,初始化约定天然给两者一个量级参考。但 GVA 的 \(K = VM\) 是"投影的投影",\(M\) 用默认初始化的话,K 的尺度会明显小于 Q——attention logits 几乎相等,softmax 输出接近均匀分布,等于 attention 直接失效,训练前期全在爬这个坑。
修复方法是让 \(M\) 的初始化匹配 Q/K 的初始 RMS:
这样 \(K\) 的初始方差约等于 \(\sigma_Q^2\),起步就和 Q 同量级。附录里还有两组 attention heatmap(图4、图5)展示尺度不匹配时长什么样:key 太小 → attention 接近均匀;key 太大 → 权重塌成 one-hot。说实话这个坑我自己在改 attention 结构时也踩过类似的——凡是"投影的投影"结构,初始化尺度都要单独核算,默认 init 的假设已经不成立了。这条经验是通用的,不限于 GVA。
缓存账本
最终 GVA 的持久化缓存是:
不带 RoPE 切片时正好是 GQA 的一半;带上 \(d_r\) 后第二项只占几个百分点——\(d_r=16\) 时省约 47%,\(d_r=24\) 时省约 45%。
三种方法的横向对比:
| 方法 | 不同的 content key 数量 | 每层缓存流数 |
|---|---|---|
| MHA | H | 2H |
| GQA | G | 2G |
| GVA | H(重建) | G 条 Value + 1 条共享 positional key |
🧪 实验:350M 规模、30B token 从零训练
实验设置:350M 参数的 decoder-only Transformer,在 30B FineWeb-Edu token 上从零训,所有变体共享数据顺序、token 预算、优化器和上下文长度。评测是 HellaSwag、WinoGrande、OpenBookQA、ARC-Easy、ARC-Challenge 五个任务的 zero-shot 准确率,每个配置跑 3 个不同随机种子取平均。预训练用了 ZClip 做梯度尖峰抑制。
变体一共七个:Shared KV(失败参照)、GQA、MLA、GVA baseline(默认初始化)、GVA scale-matched + query RMSNorm、GVA variance-fixed(无 Q-norm)、以及带 decoupled RoPE 的 \(d_r \in \{16, 24\}\) 两档。
训练 loss

图2:FineWeb-Edu 上的训练 loss。尺度匹配后的 GVA 各变体在初期瞬态过后基本贴着 GQA 和 MLA 走;GVA baseline(默认初始化)前期明显落后,后期慢慢追近——和附录的尺度分析完全对得上。
下游准确率(主结果)
| 方法 | HellaSwag | WinoGrande | OBQA | ARC-E | ARC-C | 平均 |
|---|---|---|---|---|---|---|
| GQA | 43.41 | 52.48 | 33.40 | 63.42 | 29.09 | 44.36 |
| MLA | 43.20 | 51.61 | 34.60 | 62.87 | 27.13 | 43.88 |
| GVA baseline | 42.12 | 52.96 | 34.80 | 61.95 | 27.73 | 43.91 |
| GVA scale-matched + Q-norm | 42.05 | 53.51 | 34.40 | 62.75 | 29.35 | 44.41 |
| GVA variance-fixed | 42.71 | 53.35 | 32.20 | 62.33 | 28.24 | 43.77 |
| GVA + DRoPE \(d_r=24\) | 42.94 | 53.12 | 33.20 | 63.69 | 28.50 | 44.29 |
| GVA + DRoPE \(d_r=16\) | 42.69 | 53.35 | 33.60 | 63.81 | 28.32 | 44.35 |
几个值得停留的点:
0.01 个点。 推荐部署形态(DRoPE \(d_r=16\))平均 44.35,GQA 44.36——差距完全在种子噪声里。而缓存省了 47%。这笔交换非常划算。
有意思的是最强的一行其实是 scale-matched + Q-norm(44.41),略微反超 GQA。但作者很诚实地标注:GVA baseline 不做尺度匹配也有 43.91,说明重建本身已经站得住,尺度匹配主要改善的是训练早期,不是最终上限。这种克制我很欣赏——换别的论文可能就把 44.41 当成头条吹了。
论文附录还给了逐任务的训练过程曲线,摘两张感受一下:

图6:HellaSwag 上七个配置的训练过程曲线,横轴是消耗的 token(十亿计)。各方法全程缠在一起,GVA 系和 GQA/MLA 没有系统性分层。

图10:ARC-Challenge 上的过程曲线。可以看到所有方法都在 0.17–0.28 区间抖动,噪声不小——这也解释了为什么论文反复强调"小差距不要当成统计显著"。
🤔 我的判断
这篇论文最值钱的地方不是一个新 SOTA,而是把一个直觉——"K 可以从 V 重建"——走通成了一套自洽的系统方案:K=V 失败 → 线性重建 → 尺度初始化 → RoPE 解耦 → 吸收进 query。每一步都在回应上一步暴露的问题,逻辑链非常干净。而且作者的表述罕见地诚实:缓存数字明确说是"表示层计数,不是实测 serving 显存";Shared KV 明确标注是"失败的第一次尝试,不推荐作为 baseline";延迟和吞吐收益明确说"本文实验未建立"。
但短板也同样明显,而且作者自己都承认了:
- 没有系统测量。 自定义 decode kernel 还在测试中,fused 吞吐、峰值显存、batch 容量全部未报告。缓存减半 ≠ 端到端快一半——MLA 当年也是 kernel 跟上之后才真正兑现收益,GVA 现在处于"表示层赢了、系统层待验"的阶段。在这个兑现之前,它是个漂亮的 idea,不是一个可以直接上线的方案。
- 规模太小。 单一 350M 规模、单一数据配方、30B token。GQA 当年被验证是在 70B 级别的 Llama 2 上,GVA 能不能在 7B/70B 和长上下文下保持这个 gap,完全是开放问题。RoPE 宽度也只试了 16 和 24 两档。
- 对 MLA 的优势没那么大。 GVA 的卖点是"直接用 Value 作为持久状态,保留直接的 value 路径",不像 MLA 那样引入额外的 latent 投影。但 MLA 的缓存 \(T(d_c + d_r)\) 在 \(d_c\) 取得小的时候可以比 GVA 更省——GVA 省的是"结构简单"和"key 多样性",不是绝对的缓存下限。
工程上的启发:如果你在做推理优化或者自定义 attention 变体,两个东西可以直接拿走——一是"投影的投影必须重新核算初始化尺度"这条通用教训,二是 \(K=VM\) 这个重建视角本身。它提示了一个审视 KV cache 的新角度:缓存里存的不该是"张量",而该是"重建 attention 所需的最小信息"。顺着这个思路,Value 也许还能再压(比如低秩 V),那缓存账本就又有得算了。
等它的 decode kernel 开源和实测数据出来,这篇论文的分量才能真正定下来。目前我给它的定位是:一个逻辑漂亮、实验克制、值得跟踪的表示层创新。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我