不是所有 Prompt 都值得练:给多模态 RL 训练配一个"智能选题官"
做 RL post-training 的人应该都有过这种体验:训练集几千条 prompt,模型哗哗地 rollout,可你仔细去看 reward 分布就会发现——一大批 prompt 模型已经全做对了,rollout 八次八次全 1 分;另一大批 prompt 模型死活做不出来,八次全 0 分。这两类 prompt 占掉了大量 rollout 预算,贡献的梯度却约等于零。
说实话,这个问题在 DAPO 那篇工作里就被点破了:组内奖励方差为零的 prompt 不产生任何学习信号,应该过滤掉。但过滤完之后呢?扔掉就完了?这篇被 EMNLP 2026 主会接收的论文(arXiv:2609.15051)给出了一个更有意思的答案:别扔,让教师模型把难题"讲"得简单一点,再喂回来继续练。
核心摘要:论文提出 Exploration Potential Score(EPS),一个从 GRPO rollout 统计里免费算出来的 prompt 效用分数——推导自 KL 正则化策略改进理论,形式却简单到只是"奖励的 softmax 加权均值减去普通均值"。低 EPS 的 prompt 不丢弃,而是连同学生的错误回答和奖励一起丢给教师模型,改写成保留原意但更容易出学习信号的 scaffolded prompt,异步回流训练池。在 Geo3K 和 MMK12 上、基于 Qwen3-VL-2B/4B,相比 GRPO 基线域内最高相对提升 9.7%,OOD 的 MathVision 和 MMMU-Pro 上分别拿到 11.5% 和 11.1% 的相对增益。我的判断:这不是底层算法突破,而是把"prompt 筛选"从二值过滤升级成"诊断+治疗"的闭环工程方案,思路干净、落地成本低,但 answer-aware 的教师设置是个不小的水分点,后面细说。
📖 论文信息
- 标题:Not All Prompts Are Equal: Exploration-Guided Prompt Scaffolding for Multimodal Reinforcement Post-Training
- 作者:Yuanhao Yue、Qianli Ma(共同一作)、Chengyu Wang(通讯)、Haoting Wang、Lei Shen、Jun Huang
- 机构:阿里云计算(Alibaba Cloud Computing)等,Lei Shen 来自复旦大学,Jun Huang 来自西安交通大学
- 发表:EMNLP 2026 主会,2026 年 9 月 14 日提交
- 链接:https://arxiv.org/abs/2609.15051
🎯 问题动机:Prompt 的"可教性"是不均匀的,而且会变
标准的在线 RL 训练里,所有训练 prompt 被一视同仁——每个 prompt 分到一样的 rollout 预算。这背后藏着一个很少被审视的假设:每条 prompt 对当前策略的信息量相同。
这个假设在实践中频繁被打破。论文把训练池里的 prompt 分成三类:
| 类型 | 表现 | 学习价值 |
|---|---|---|
| 已饱和(saturated) | 模型基本全做对,rollout 奖励普遍高 | 改进空间耗尽,梯度信号递减 |
| 当前过难(currently hard) | 采样响应全军覆没,奖励 uniformly low | 只有弱信号甚至噪声 |
| 中间状态 | 对错参半,部分能力已显现 | 能做出有效的 credit assignment,最该练 |
之前在做 RL 训练的时候我也观察到类似现象:训练中后期,reward 曲线还在涨,但涨得越来越"虚"——因为越来越多的 prompt 滑向了饱和区,有效 batch 其实在缩水。DAPO 的 dynamic sampling 用了一个简单粗暴的办法:组内全对或全错的 prompt 直接丢掉重采。有效,但浪费。
更麻烦的是,prompt 的效用不是静态属性。随着策略变强,昨天还有信息量的 prompt 今天可能就饱和了;而有些难题要等模型能力强到一定程度才变得"可学"。所以训练 prompt 分布本身就是优化问题的一部分——这话说得漂亮,也是这篇论文真正的出发点。
🧠 方法核心:先打分,再治病
整个框架可以用一句话概括:用一个免费的分数给 prompt 排序,低分的不扔,送去找教师"补课",补完再回来考。
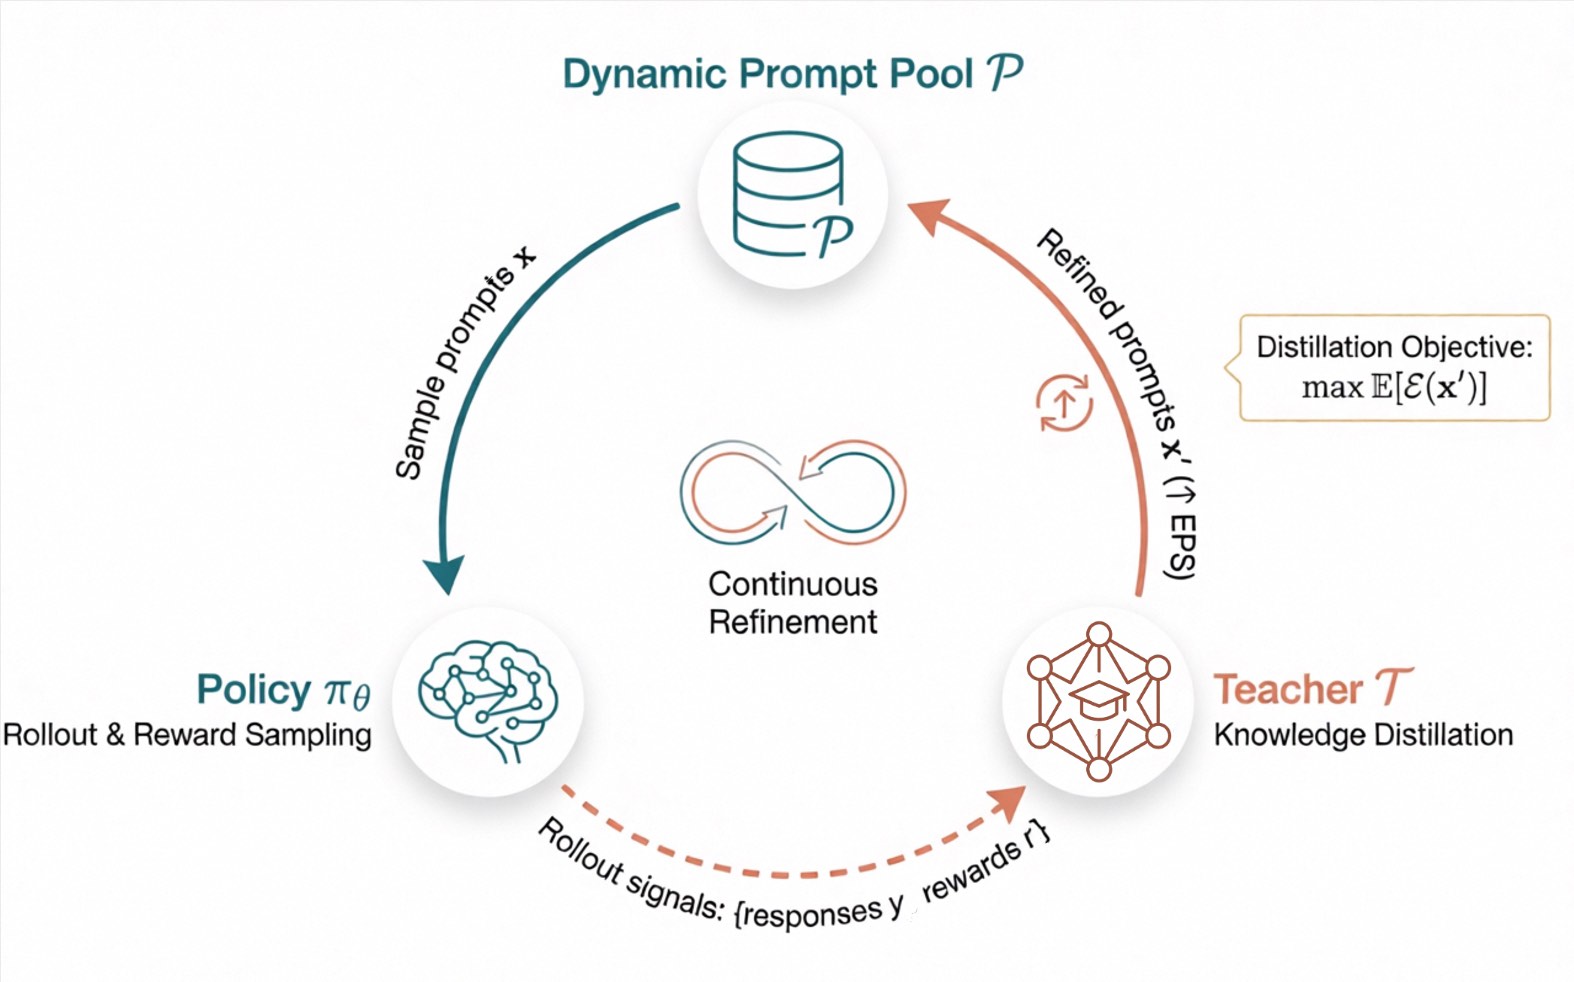
图1:框架的三元循环——动态 prompt 池采样出题,策略 \(\pi_\theta\) rollout 拿奖励,教师 \(\mathcal{T}\) 拿到 rollout 信号(回答 y 和奖励 r)后把低分题改写成 refined prompt 回流进池。注意右上角那个蒸馏目标:\(\max \mathbb{E}[\mathcal{E}(x')]\),教师改写的目标是让新 prompt 的 EPS 变高,而不是让学生模仿教师输出。
EPS:一个从理论里长出来、却免费可算的分数
EPS 的定义来自 KL 正则化策略改进理论。固定 prompt \(x\),KL 正则化目标下的最优策略有闭式解:
理想的 EPS 就是"这个最优软策略的期望奖励"减去"当前策略的期望奖励":
直觉很直白:当前策略离"稍微改进一下能拿到的分数"还有多远。差距大,说明这个 prompt 还有肉可吃;差距小,要么已经吃饱(饱和),要么根本咬不动(过难)。
问题是怎么算。论文用自归一化重要性采样一推,未知配分函数 \(Z(x)\) 被消掉,最终形式简单得有点可爱:
就是"高奖励 rollout 加权平均"减去"普通平均"。GRPO 本来就要采样 \(N\) 个 rollout 算奖励,所以这个分数零额外开销——不需要辅助模型,不需要额外采样。
等等,有个细节值得玩味。如果组内奖励全一样(全对或全错),softmax 权重退化成均匀分布,\(\hat{\mathcal{E}}(x)\) 恰好等于 0。你品一品——DAPO dynamic sampling 过滤的"零方差 prompt",在 EPS 框架里恰好就是 EPS 为 0 的边界情形。所以 EPS 其实是把 DAPO 那个二值过滤器连续化了:不只是"有信号/没信号",而是"信号有多强"。这个视角论文自己没太强调,但我觉得这是理解 EPS 最顺的一条线。
温度 \(\beta\) 的行为也符合直觉:\(\beta\to 0^+\) 时 softmax 集中到 argmax,EPS 退化成 best-of-\(N\) 奖励差距;\(\beta\to\infty\) 时所有权重拉平,EPS 归零。论文默认阈值 \(\tau=0\)——理想 EPS 非负,估出负值基本就是采样噪声或纯难题,0 是个自然的操作点。
教师不是来蒸馏答案的,是来改卷子的
低 EPS 的 prompt 进入改写队列后,教师模型(Qwen-VL-Max)收到三样诊断材料:原始 prompt \(x\)、学生采出来的 \(N\) 个回答、以及对应的奖励。然后输出改写版本 \(x'\)。
这个设计我觉得是全文最聪明的地方。传统蒸馏是教师输出答案、学生模仿输出分布——但在线 RL 里学生是从自己的 rollout 里学习的,你硬塞教师输出反而水土不服。这篇论文把教师的角色从"输出蒸馏"重新定位成训练数据精炼:教师不告诉学生答案,而是把题目本身讲得更清楚——澄清缺失的约束、把任务拆成中间子目标、把学生跑偏的推理路线拽回来。
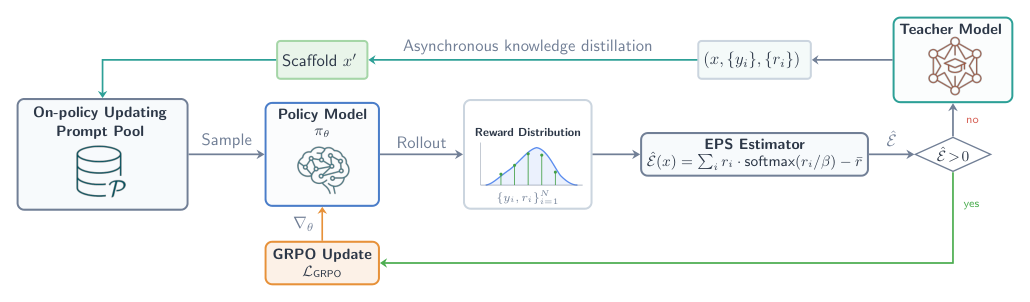
图2:方法流水线。右侧菱形判断 \(\hat{\mathcal{E}}>0\):yes 走下方绿色路径直接进 GRPO Update;no 走上方,把 \((x,\{y_i\},\{r_i\})\) 异步发给教师模型,产出 scaffold \(x'\) 回流到 prompt 池。整个改写由独立 worker 异步处理,不阻塞主训练循环。
工程上还有几个值得抄的设计:
- 异步改写:教师查询由独立 worker 处理,和主 RL 循环并行,refresh buffer 周期性合并回训练池,改写不拖吞吐;
- reserve set 机制:被移出的原始 prompt 不会永久删除,随着策略变强定期重估,效用回升超过 \(\tau\) 就重新激活——这产生了一种课程式的效果,模型"长大"后再回头挑战当年的难题;
- 容错循环:改写后的 prompt 如果还是低 EPS,会再次被过滤再改写,prompt 质量随训练螺旋上升。
一个必须点破的前提:教师是看着答案改题的
这里要泼一盆冷水。论文在实验设置里明确写了:教师可以访问参考答案(answer-aware),只是被要求"不要直接把答案说出来"。
这和 answer-free 的脚手架是两回事。教师看着标准答案去"澄清约束、拆解子目标",它写出的 scaffold 天然会往正确方向上引——这在多大程度上算"让训练更有信息量",又在多大程度上算一种变相的答案泄漏?作者自己也坦诚结果应该在 teacher-assisted training 的设定下解读,完全 answer-free 的版本留作未来工作。这个诚实态度我认可,但读实验数字的时候,这个前提得一直挂在脑子里。
🧪 实验结果:数字确实能打
实验配置先交代清楚:backbone 是 Qwen3-VL-2B 和 4B,先在 OmniThoughtV 的 50 万多模态推理样本上 SFT,再分别在 Geometry3K 和 MMK12(MM-Eureka 的数据集)上做 RL。奖励用 MathRuler 的可验证奖励,每 prompt 采 8 条 rollout,训 3,000 步,8 卡 FSDP,学习率 1e-6。基线是相同设置下的标准 GRPO。
主实验
Geometry3K 作为 RL 训练集(准确率 %):
| 方法 | Geo3K | MathVerse | MathVision | M-Val | M-Pro | OOD Avg |
|---|---|---|---|---|---|---|
| 2B:N/A(零样本) | 18.97 | 34.09 | 20.39 | 47.89 | 32.08 | 33.61 |
| 2B:SFT | 38.69 | 43.02 | 27.30 | 49.22 | 35.61 | 38.79 |
| 2B:GRPO | 55.41 | 43.81 | 26.64 | 50.22 | 37.69 | 39.59 |
| 2B:本文 | 59.07 | 46.57 | 29.61 | 50.56 | 39.13 | 41.47 |
| 4B:N/A(零样本) | 47.08 | 36.40 | 31.91 | 56.67 | 41.33 | 41.58 |
| 4B:SFT | 55.07 | 53.15 | 32.89 | 60.33 | 46.94 | 48.33 |
| 4B:GRPO | 60.57 | 52.54 | 34.54 | 60.56 | 46.53 | 48.54 |
| 4B:本文 | 65.39 | 53.73 | 35.20 | 61.00 | 49.08 | 49.75 |
MMK12 作为 RL 训练集(准确率 %):
| 方法 | MMK12 | MathVerse | MathVision | M-Val | M-Pro | OOD Avg |
|---|---|---|---|---|---|---|
| 2B:N/A(零样本) | 37.45 | 34.09 | 20.39 | 47.89 | 32.08 | 33.61 |
| 2B:SFT | 36.35 | 43.02 | 27.30 | 49.22 | 35.61 | 38.79 |
| 2B:GRPO | 51.40 | 42.44 | 28.62 | 50.33 | 36.59 | 39.50 |
| 2B:本文 | 56.40 | 47.34 | 31.91 | 51.44 | 40.64 | 42.83 |
| 4B:N/A(零样本) | 46.45 | 36.40 | 31.91 | 56.67 | 41.33 | 41.58 |
| 4B:SFT | 56.48 | 53.15 | 32.89 | 60.33 | 46.94 | 48.33 |
| 4B:GRPO | 68.05 | 50.96 | 41.78 | 60.67 | 50.06 | 50.87 |
| 4B:本文 | 71.15 | 55.10 | 44.41 | 60.89 | 50.29 | 52.67 |
挑几个有代表性的数字说。MMK12 上 2B 模型域内从 51.40% 涨到 56.40%,5.0 个点的绝对提升,这就是摘要里 9.7% 相对提升的来源。更值得注意的是 OOD 泛化:2B 的四个 OOD 基准平均从 39.50% 到 42.83%,MathVision 从 28.62% 到 31.91%,MMMU-Pro 从 36.59% 到 40.64%——4.05 个点。
说实话,域内提升我预期之中(prompt 池优化直接作用于训练分布),OOD 也跟着涨这么多倒是加分项——说明教师改写学到的不是对特定题集的过拟合,而是推理能力的真实迁移。
还有个规律值得留意:2B 的相对增益比 4B 大。这其实符合 EPS 的逻辑——越强的基座模型,能直接搞定的 prompt 越多,留给脚手架"救"的空间自然越小。反过来说,这套方法对小模型、弱起点场景价值更大。
EPS 这个分数真的有用吗?
论文没有止步于端到端对比,专门做了一组验证(Figure 3):把 MMK12 训练 prompt 按 EPS 分组,分别只用各组 prompt 训练 2B 模型前 1,000 步。
| 训练用的 prompt 组 | MMK12 准确率 |
|---|---|
| 仅 EPS ≥ 0.5 | 44.85% |
| 仅 0 < EPS < 0.5 | 39.55% |
| 全体 EPS > 0 | 46.00% |
| 未过滤全池 | 约 41.90% |
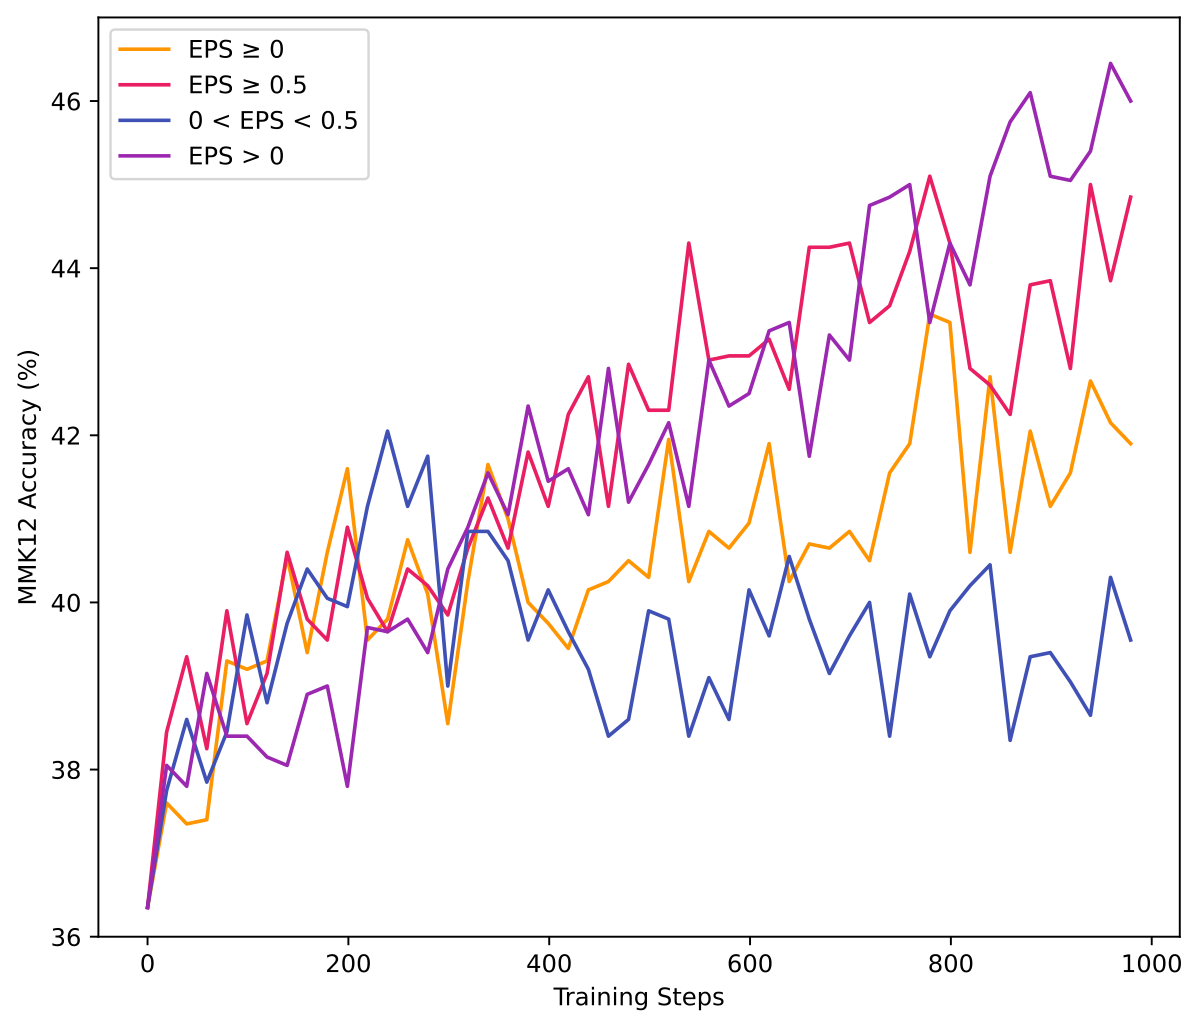
图3:四条曲线分别对应四个 EPS 区间的 prompt 子集。紫色(EPS > 0 全体)和粉红(EPS ≥ 0.5 高分组)明显跑在上面,蓝色(0 < EPS < 0.5 中低分组)一路垫底,橙色(EPS ≥ 0,近似全池)居中。
这组实验的信息量比主表还大,它说了三件事:
一,高 EPS prompt 训练效果确实更好(44.85% vs 39.55%),EPS 不是玄学分数,是真的捕捉到了 prompt 质量差异。
二,只练高分题不是最优。EPS > 0 的全体(46.00%)反而比只练 EPS ≥ 0.5 的尖子组高 1.15 个点——中等信息量的 prompt 提供了有用的多样性,激进地只留难题/好题会掉点。这个发现和直觉相反,但细想合理:RL 训练也怕"偏科"。
三,近零 EPS 的 prompt 确实是拖累:把它们排掉比全池训练高出 4.10 个点。这给 \(\tau=0\) 这个默认阈值提供了实证支撑。
改写回流到底贡献了什么?
EPS 过滤本身就有用(上面已经证明了),那教师改写这部分是锦上添花还是真有贡献?Figure 5 给了答案。
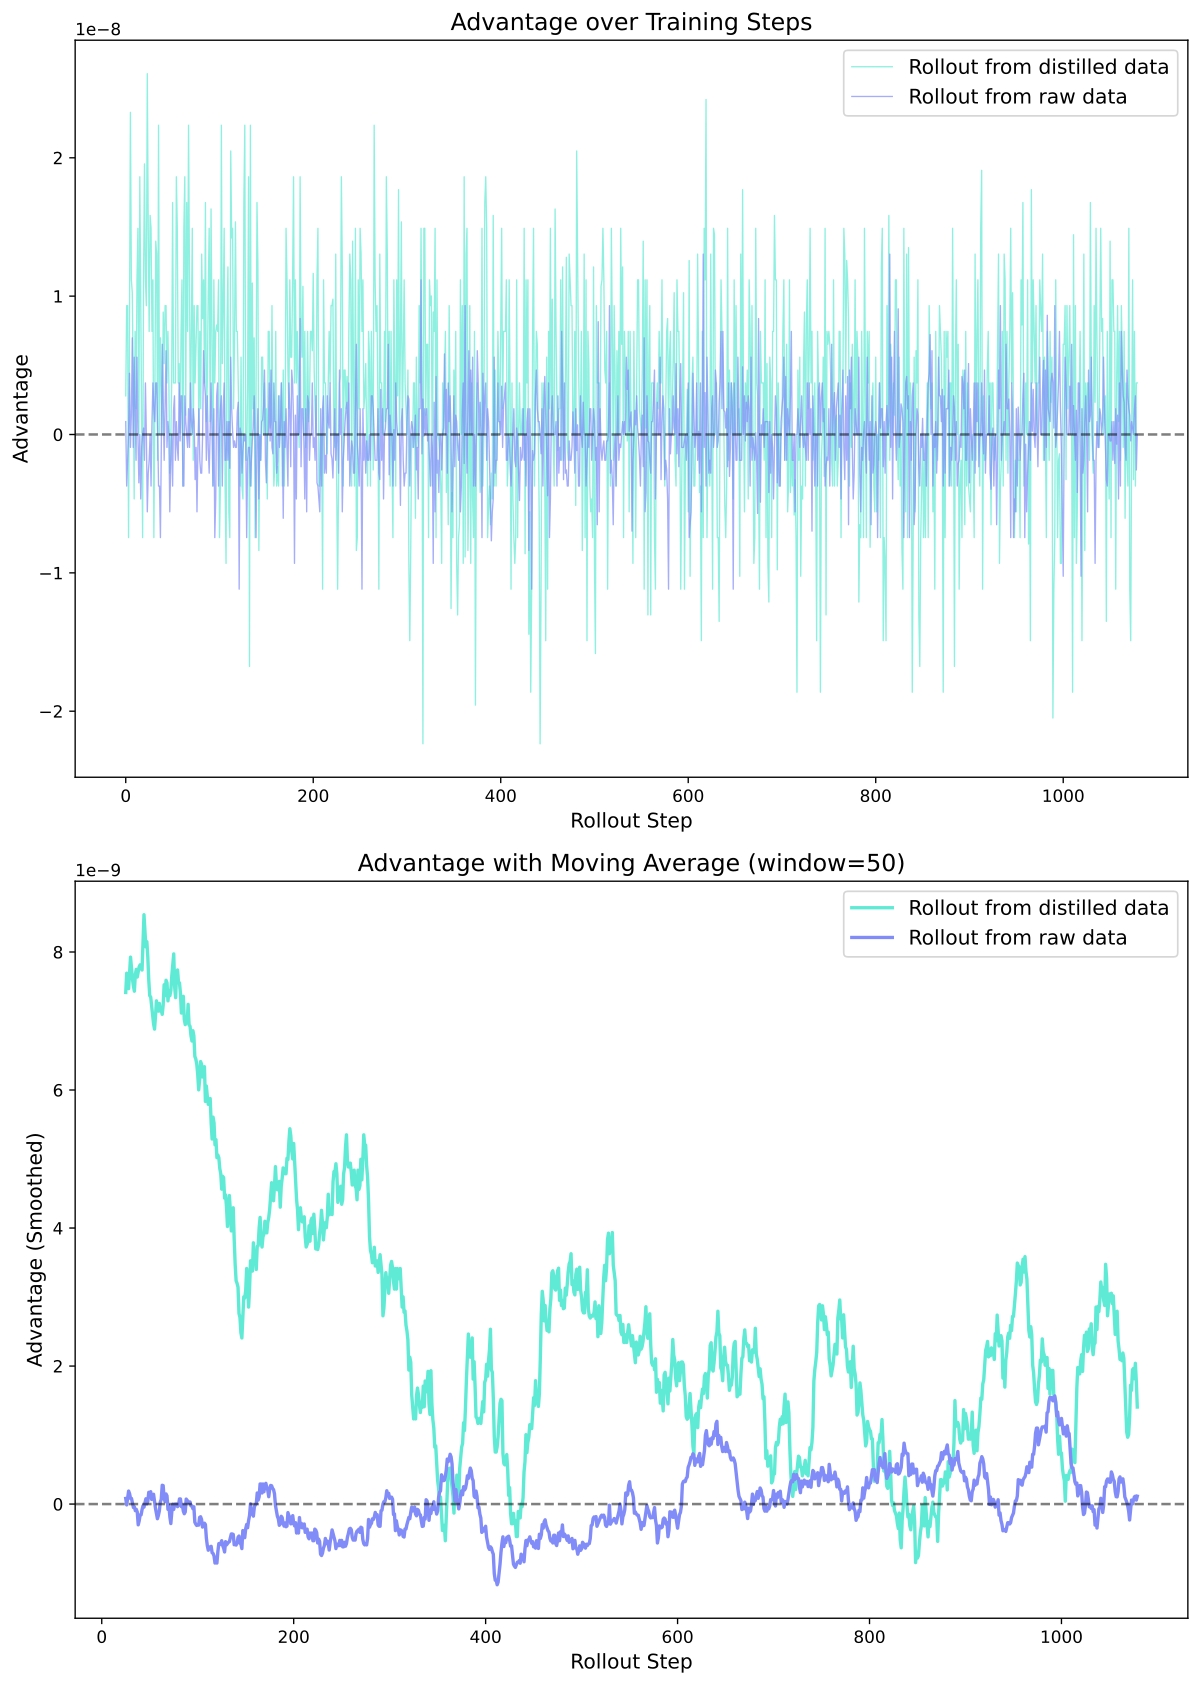
图4:上半部分是逐步的原始 advantage,下半部分是窗口 50 的滑动平均。青色是 scaffolded prompt 上的 rollout,紫色是原始 prompt。平滑后青色持续压在紫色上方,说明刷新后的 prompt 池平均产出更有信息量的更新。坦白讲,这张图的 y 轴量级是 1e-8 到 1e-9,小得反常——GRPO 组内归一化后的 advantage 应该在 O(1) 量级,这画的可能是归一化前的某种原始信号。量级本身没法解读,只能看相对位置和正负性,作为证据力度要打个折扣。
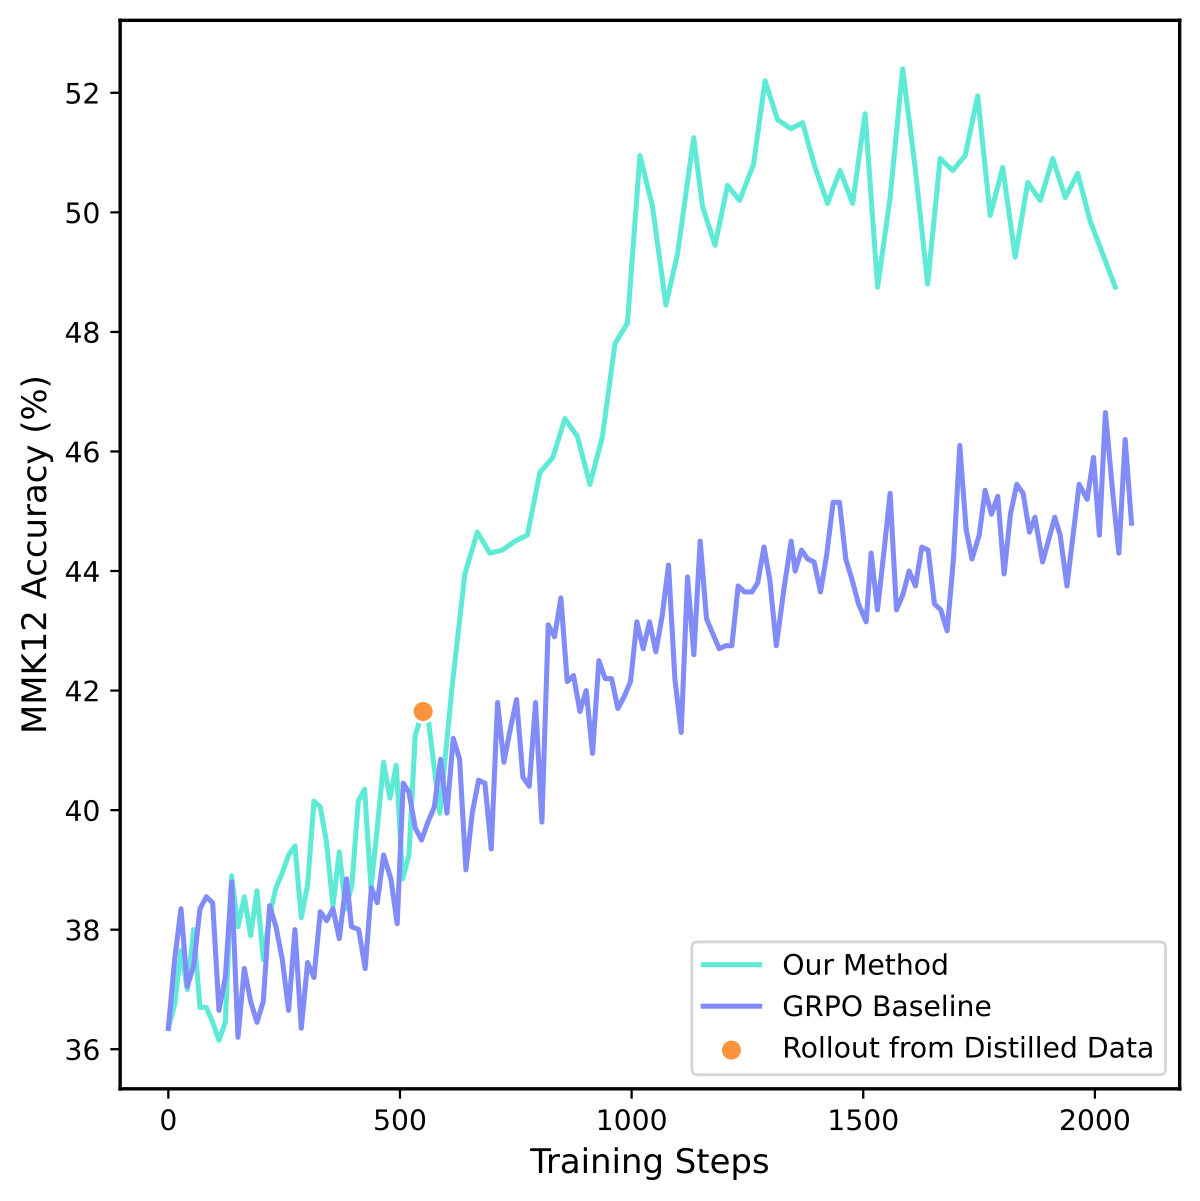
图5:青色(本文)对紫色(GRPO 基线)。两条曲线在约 550 步(橙点,第一批 scaffolded prompt 回流)之前基本纠缠,回流之后青色从 42% 左右跳到 44% 以上,之后差距一路拉大,2,000 步时领先约 4 个点。
Figure 5 这张曲线图是全文我最喜欢的一张证据。橙点标注的是第一批 scaffolded prompt 回流训练的时刻——在此之前两条曲线你侬我侬,之后本文方法明显跳变并持续压制基线。这个时间对齐关系说明收益来自改写回流本身,而不只是 EPS 过滤。干得漂亮。
案例分析
附录 D 给了三个定性案例(圆几何、三角函数、反比例函数),展示教师如何在低 EPS prompt 上把学生跑偏的推理拽回正轨——比如原题缺少约束表述导致学生误解图意,教师改写时补上约束并拆解子目标,但不透露最终答案。论文 HTML 版本这部分内容被截断,我这里不做超出原文正文的转述。这类定性证据看看就好,真正的说服力还是在上面的定量实验里。
🤔 我的判断:一套务实的"数据侧"方案,但别忽略前提
这篇论文最值钱的地方,是把 RL 训练里"prompt 怎么办"这个问题从过滤器思维升级到了闭环思维。DAPO 的 dynamic sampling 证明了"坏 prompt 该扔",这篇论文追问了一步:扔掉的 prompt 里,有多少其实只是"题目出得不好"而不是"知识没价值"?让教师把题讲清楚再喂回来,数据飞轮就转起来了。EPS 作为 DAPO 二值判据的连续化推广,理论出处干净(KL 正则化最优策略的软改进差距 + 自归一化重要性采样),实现零成本,这个组合很优雅。
但几个地方要清醒看待。
其一,基线只有标准 GRPO。DAPO 的 dynamic sampling 是这个方法最自然、最该打的对手——同样处理低效 prompt,一个是丢、一个是改,到底谁划算?论文没比。EPS > 0 过滤组 46.00% 的数字暗示过滤本身就贡献了大头,改写带来的增量(Figure 5 里大约 4 个点)是在自家过滤之上的增益,但和 DAPO 式重采放一起比才公平。
其二,answer-aware 的教师设置是绕不过去的水分点。教师看着答案"不直接说出来"地引导,和真正的答案无关脚手架之间有多大差距,论文留白了。如果未来 answer-free 版本掉点明显,那现在 9.7% 的相对提升里有多少是"教师剧透"的贡献就不好说了。
其三,实验规模偏小:2B/4B 模型、3,000 步、batch 16,曲线噪声肉眼可见(Figure 3 抖动很厉害),大概率是单 seed 结果。教师用的是闭源的 Qwen-VL-Max,复现成本和吞吐开销(论文自己也承认教师端推理成本是实际考量)对工程落地是真实门槛。
瑕不掩瑜,如果你在做多模态推理的 RL 后训练,这套东西的工程启发很直接:rollout 统计里藏着免费的 prompt 质量信号,别浪费;低效 prompt 别急着扔,诊断一下学生的错误回答,往往能把题"修"好。哪怕不引入教师模型,光是把 EPS 当作课程学习的排序信号用,性价比就已经不错了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我