Atria Dawn:当 AI 开始参与研发自己的下一代,人类还剩什么角色?
核心摘要:这篇论文(arXiv:2609.15818)表面上是发布一个智能体模型 Atria Dawn Preview——基于 744B MoE 基础模型,用一条"可验证经验流水线"(Verifiable Experience Pipeline)把工具调用、环境交互和外部可验证结果串起来做训练,在 16 个基准上拿下 5 个第一。但说实话,模型本身反而不是最吸引我的部分。真正值钱的是后半篇:作者把自己研发这个模型的真实过程当成案例,分析了 56 名参与者的 769 条任务记录,回答了一个越来越难回避的问题——当 AI 开始参与研发 AI,人和 AI 的分工到底变成了什么样?数据给出的答案挺反直觉:AI 提出了大部分方法,但 85% 以上的最终决定权仍在人手里;约三分之一已完成的 AI 辅助任务,被参与者评定为"没有 AI 根本不会去做"。稀缺的不再是执行力,是判断力。这篇论文一半是技术报告,一半是难得的人机协作实证研究,后者我认为更值得细读。
论文信息 - 标题:Atria Dawn: The Dawn of Agentic Superintelligence — On the Evolving Roles of Human–AI Collaboration - 作者:Honglin Guo、Tao Gui、Yicheng Chen 等(署名作者超过百人,首页机构标识包括中科院自动化所、中科院软件所、中国人民大学、上海人工智能实验室等) - 链接:https://arxiv.org/abs/2609.15818 (2026 年 9 月 14 日提交,23 页,10 图) - 代码:https://github.com/atria-asi/Atria-Dawn-Preview
🎯 为什么这篇论文值得聊
你有没有注意到一个变化:今年(2026)发布的前沿模型,越来越少强调"我在 MMLU 上又涨了几分",而是越来越多地展示"我能独立完成一件真实的工作"——写一个能跑的操作系统、生成一份带数据分析的行业报告、操作 CAD 软件画一个发动机。
Atria Dawn Preview 就是冲着这个方向去的。它的定位很直白:面向科学研究和工程工作流的基础智能体模型,目标是拓展真实世界里智能体的生产力边界。
但真正让我觉得"这篇得写"的,是作者做了一件很少有团队敢做的事:他们把自己研发模型的过程打开给人看。56 名研发参与者、769 条任务记录、逐日的智能体日志,全部拿来做量化分析。这相当于一个 AI 实验室把自己"人和 AI 怎么协作"的家底翻出来给你研究。我在之前做项目的时候一直好奇这个配比到底是多少——人出主意还是 AI 出主意?人改稿还是 AI 改稿?这篇论文第一次给了有样本量的答案。
🧠 模型本体:可验证经验流水线
一句话讲清核心思路
训练智能体最头疼的问题是:模型在环境里折腾了一大圈,哪些经验是真的有用的?Atria Dawn 的回答是——只保留能被外部证据验证的经验。任务、轨迹、产物、验证证据,四个环节必须完整链接,缺一环就扔掉。

图5:论文对人机关系演变的划分——(a) AI 作为研究对象,人类主导全程;(b) AI 作为任务级执行者,在人类设计的工作流里干活;(c) AI 作为项目级同事,朝着人类设定的目标自主规划迭代;(d) 下一个阶段是什么?递归自我改进之后人类扮演什么角色,这是个开放问题。这张图基本是全文的纲。
技术细节
模型基于一个 744B 参数的 MoE 基础模型构建(论文引用 Z.ai 2026,即 GLM 系基础模型)。训练流水线的运转方式:
- 任务连接真实执行环境。每个训练任务都挂到真实环境里——模型观察状态、调用工具、产出中间产物(代码、文件、报告),再根据环境反馈调整动作。不是静态的 SFT 语料,是活的交互轨迹。
- 结果由外部信号验证。验证方式五花八门:可执行测试、实验指标、文件状态、几何结构检查、来源证据、人类定义的标准。关键是这些信号都在模型之外,模型自己说了不算。
- 轨迹筛选。不完整的、自相矛盾的、重复的、行为无效的样本全部剔除。留下来的每条经验都带着完整的"任务 → 轨迹 → 产物 → 验证证据"链条。
- 失败分析驱动迭代。反复出现的失败模式(工具选择无效、验证不完整、证据缺失、恢复失败)被用来指导后续的任务构建和环境优化。失败的运行只要结果能被独立确认,也会留下来当诊断案例。
说实话,这个思路本身不算横空出世——可验证奖励(RLVR)这两年已经是推理模型训练的标配,把 verifier 从数学/代码扩展到通用环境也是大家都在做的事。但 Atria Dawn 把它推得更远:验证信号的种类扩展到了文件系统状态、CAD 几何结构、来源证据这类"脏活累活"的环境,这是工程量很大的事。我的判断是,这更像一次大规模、高完成度的工程整合,而不是某个单点算法突破——但能把整合做到这个程度,本身就是壁垒。
能力案例:不只是跑分
论文展示的几个产物案例挺能说明这条流水线练出了什么。

图2a:智能体生成的全球天气预报可视化界面。中间是交互式地球,左上是训练日志面板(45,000 步训练 loss 稳定下降、预测误差同步收敛),右侧是 T2m、U10、Z500、T850 四个气象变量的真值与预测对比。注意底部那行小字——这是智能体完整走完"训练一个天气预测模型 + 搭建可视化前端"这条长工作流后的产出。
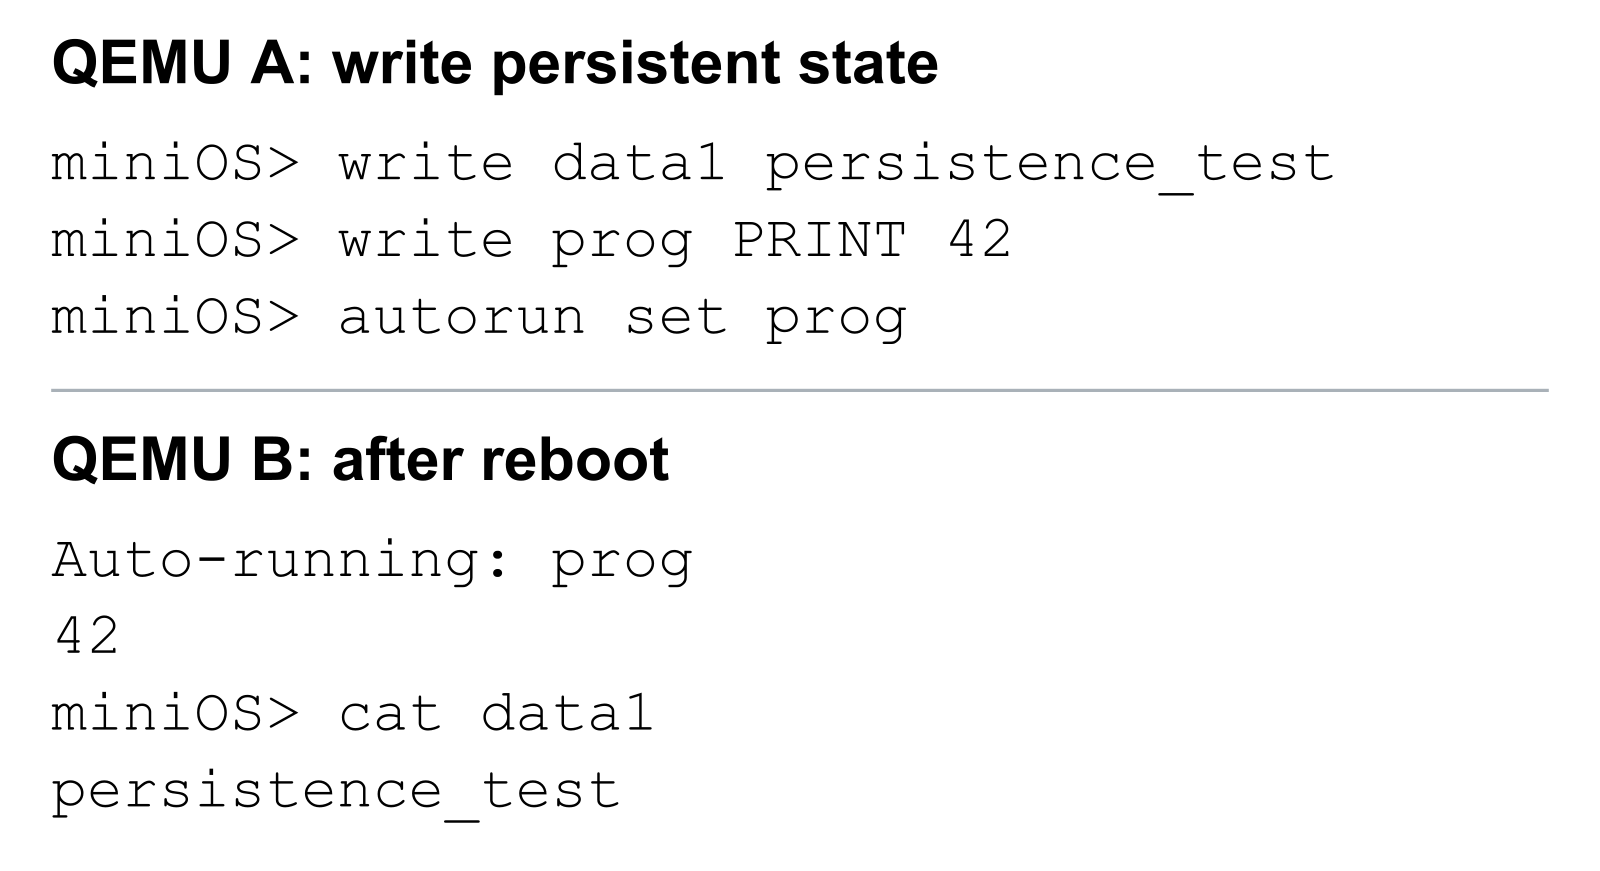
图2b:MiniOS 的 QEMU 串口记录。上半段是重启前:写入持久化数据、写一个打印 42 的程序、设置开机自动运行;下半段是重启后:系统自动运行该程序输出 42,且之前写入的数据还在。这个案例秀的是跨会话的状态持久化能力——智能体写的操作系统真的能"记住东西"。

图3a:智能体生成的四缸发动机 CAD 装配体(前视图)。左侧聊天记录值得一看——智能体在中文对话里主动报告了两处既有干涉问题(主轴承孔中心 z 坐标写错、连杆大头孔 SUBTRACT 顺序错误),给出干涉量数值,然后问用户"要我一并修掉吗?"这种主动发现问题的行为,比建模本身更能体现智能体性。

图3b:机器人关节驱动模组的组件视图。左侧是用户给的 20 项零件 BOM 表(行星架、太阳轮、内齿圈、摩擦盘……),要求"每个零件都做到工业级的细致"。需要说明,论文自己也强调了:这些图展示的是几何形状和组件结构,不构成机械或制造层面的验证。
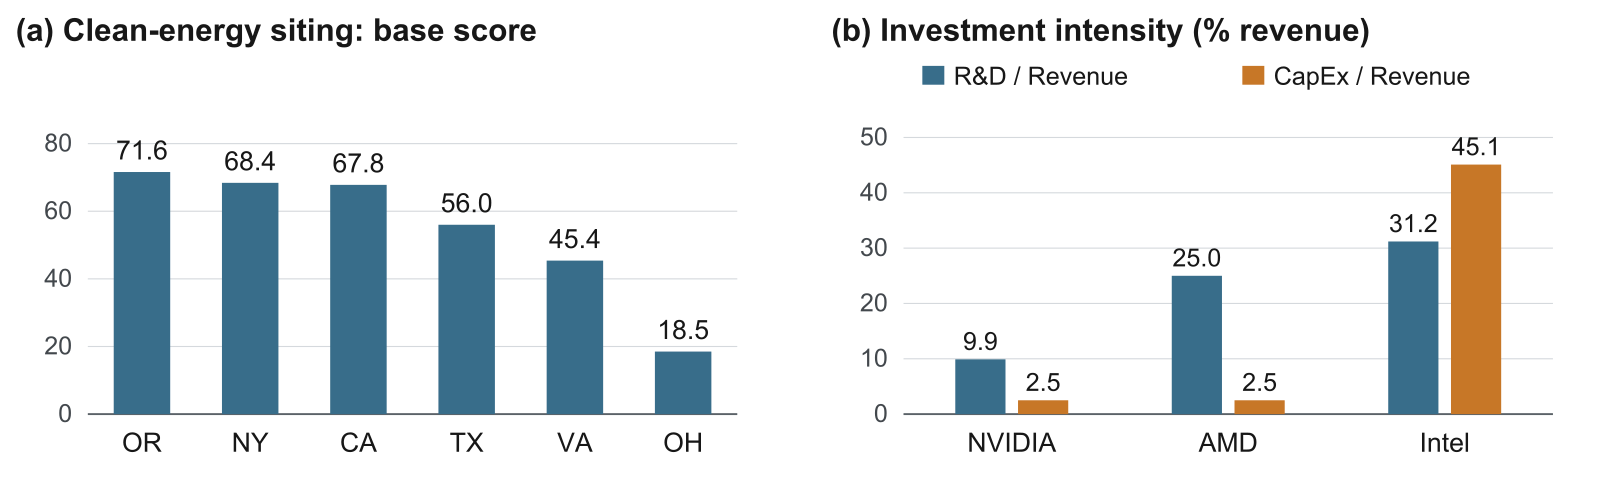
图4:智能体生成报告里的两类分析内容。(a) 清洁能源选址的基础评分——俄勒冈 71.6、纽约 68.4、加州 67.8 领先;(b) 三家芯片公司的投资强度对比——英特尔 CapEx 占营收 45.1%,而英伟达只有 2.5%,研发投入则是英特尔 31.2% 对英伟达 9.9%。这些是生成文档内嵌的分析,不是模型评测指标。
📊 实验:16 个基准,5 个第一
主实验对比了 6 个前沿模型:DeepSeek V4 Pro 0813、KIMI K3、Qwen 3.8 Max、GLM 5.3、GPT 5.6 sol、Claude Opus 5。

图1:Atria Dawn Preview 与六个对比模型在 8 个代表性基准上的柱状图对比(蓝色为 Atria Dawn)。可以看到它在 AutomationBench 和 CyberGym 上领先幅度明显,但在 SWE-Bench Pro、GDPval 上与 Claude Opus 5 差距不小。
| 基准 | Atria Dawn | 最强对比模型 | 对比最高分 | 位置 |
|---|---|---|---|---|
| AutomationBench | 53.8 | Qwen 3.8 Max | 49.7 | 🥇 第一 |
| BFCL v4 | 77.0 | GLM 5.3 | 74.1 | 🥇 第一 |
| CyberGym | 86.5 | GLM 5.3 | 84.5 | 🥇 第一 |
| DeepSearchQA | 96.0 | KIMI K3 | 95.9 | 🥇 第一 |
| BrowseComp | 92.5 | GPT 5.6 sol | 92.2 | 🥇 第一 |
| Workspace-Bench-Lite | 68.2 | Claude Opus 5 | 70.1 | 第二 |
| SkillsBench | 66.4 | Qwen 3.8 Max | 66.7 | 第二 |
| Workspace-Bench | 65.0 | Claude Opus 5 | 65.8 | 第二 |
| MLE-bench Lite | 86.2 | GPT 5.6 sol | 88.9 | 中游 |
| WideSearch | 81.9 | GPT 5.6 sol | 83.3 | 领先梯队 |
| DeepResearch Bench II | 51.1 | Claude Opus 5 | 54.1 | 中游 |
| SWE-bench Pro | 59.6 | Claude Opus 5 | 74.7 | 中游 |
| τ³-Bench Banking | 41.2 | Qwen 3.8 Max | 55.2 | 较弱 |
| Terminal-Bench 2.1 | 78.3 | Claude Opus 5 | 90.2 | 较弱 |
| GDPval | 1583 | Claude Opus 5 | 1768 | 较弱 |
| JobBench | 50.3 | Claude Opus 5 | 68.0 | 较弱 |
表1:16 个基准完整结果(分数越高越好,GDPval 为 Elo 式评分)。加粗为该行最高分。
怎么读这张表?我有几个观察。
拿下第一的 5 个基准有个共同点:AutomationBench、BFCL v4、CyberGym、DeepSearchQA、BrowseComp 都是"工具密集型"任务——函数调用、深度搜索、浏览、自动化操作。这和可验证经验流水线的训练取向完全对得上,说明训练确实在它瞄准的方向上起效了。AutomationBench 领先第二名 4.1 分,这个幅度在智能体基准上不算小。
但短板同样明显,而且同样有规律。输给 Claude Opus 5 较多的几项——Terminal-Bench 2.1(差 11.9 分)、GDPval(差 185 分)、SWE-bench Pro(差 15.1 分)、JobBench(差 17.7 分)——集中在长程终端操作、真实工作任务、软件工程这类需要长链条自主执行的场景。你想想看,这恰恰说明"工具调用强"和"长程工程能力强"是两回事。论文对这点倒是坦诚,没有藏着掖着。
还有一个要泼冷水的地方:16 个基准里 5 个第一、3 个第二,"与前沿智能体竞争力相当"这个表述是准确的,但如果只看到处流传的"5 个 SOTA"宣传,你会误以为它全面领先。并不是。Claude Opus 5 在更重的工程类任务上仍然明显更强。
🔬 重头戏:769 条任务记录里的人机协作真相
模型部分到此为止。下面这部分才是我认为这篇论文 23 页里最值钱的 8 页。
作者把 Atria Dawn 的真实研发过程做成了研究对象:56 名参与者、769 条任务记录,覆盖工具与基础设施、评测、分析报告、训练 rollout、任务生成、数据收集、外部调研、协调沟通等类别。在有明确 AI 使用记录的 739 条任务里,713 条(96.5%)用了 AI。这已经不是"试点",是全面渗透。
智能体自主性在四周内翻倍
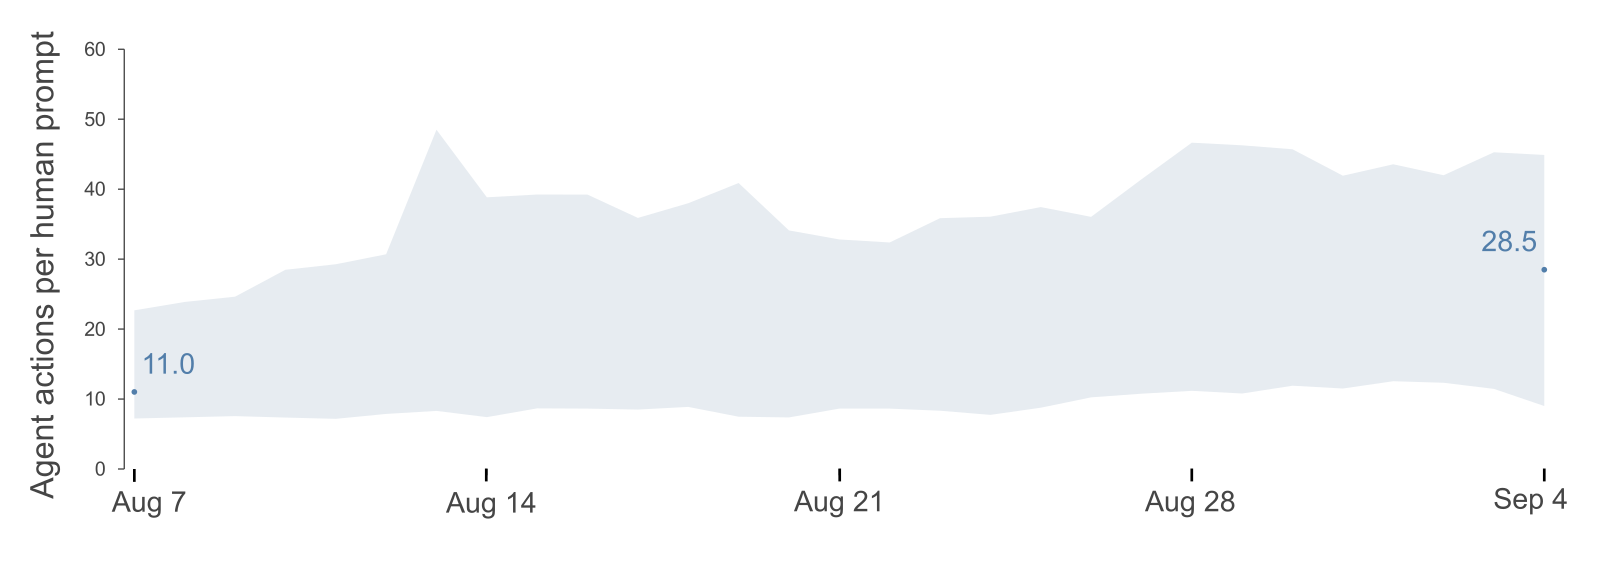
图6:2026 年 8 月 7 日到 9 月 4 日,同一批 22 名参与者"每次人类提示对应的智能体行动数"的变化。蓝点是日度中位数,从 11.0 涨到 28.5,不到一个月翻了 1.6 倍。阴影是四分位距——注意阴影在同步变宽,说明这个转变在参与者之间很不均衡,有人已经把 AI 当主力,有人还在浅用。
这个趋势比绝对值更有意思。同样的团队、同样的工具,四周之内人说话的次数相对智能体干活的次数少了一半多。这不是模型换了版本,是人在快速学会放手。
三分之一的任务"没有 AI 根本不会存在"

图7:按任务类别统计的"无 AI 所需时间"热力图。最右列 ∞ 是被评定为"没有 AI 则不可行"的任务占比。全体任务里这个比例是 33.2%;任务生成类 35.3%,协调沟通类甚至达到 40.0%。
455 个已完成的 AI 辅助任务里,151 个(33.2%)被参与者自己评定为没有 AI 就不可行。而且这些任务来自 56 人中的 27 人——不是几个重度用户的个别现象,是大约半数团队都碰到了。
这个数让我愣了一下。我们平时讨论 AI 提效,潜意识里把 AI 当成"压缩工时"的工具——原来 8 小时的活现在 2 小时干完。但这张图说的是另一回事:有三分之一的工作,在旧世界里根本不会被人尝试。可行任务的边界本身被推开了。这是从"效率工具"到"能力扩展"的质变,论文里这个区分做得很干净。
谁出主意,谁拍板
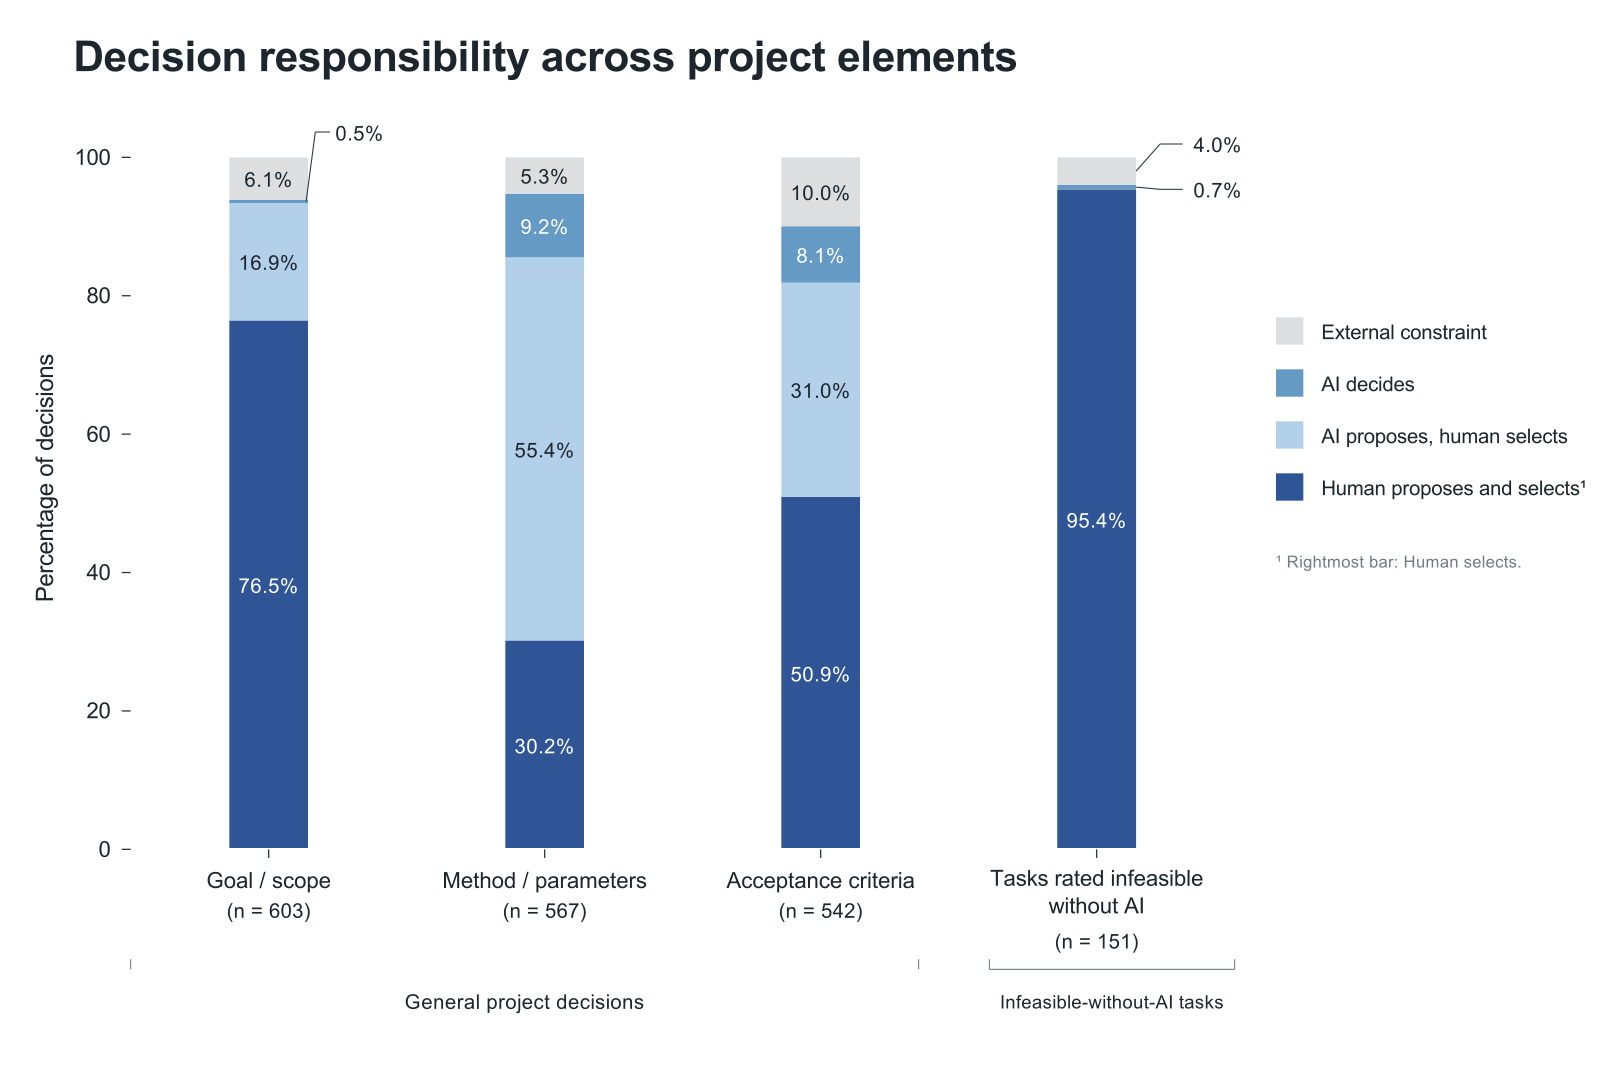
图8:决策责任的分布。目标与范围:76.5% 由人类提出并选定;方法与参数:55.4% 是"AI 提出、人类选择",AI 自主决定的只有 9.2%;验收标准:人类主导 82% 左右。最右一根柱子最惊人——在"无 AI 不可行"的 151 个任务里,95.4% 的最终目标仍是人类选定的。
汇总数据:567 个报告的方法决策中,AI 提出了 64.6%,但人类最终选择了 85.5%。
这是全文我最喜欢的一组数字。"AI 提出、人类选择"成了主流模式——变化的是谁生成选项,不变的是谁做选择。说实话这和我自己的体感完全一致:现在用智能体干活,大部分时间是它在给我列方案、写实现、做修订,我在做的是说"这个方向不对"、"要那个版本"、"这里重新来"。人从一个"干活的人"变成了"审稿人 + 方向感来源"。
卡住的时候怎么办
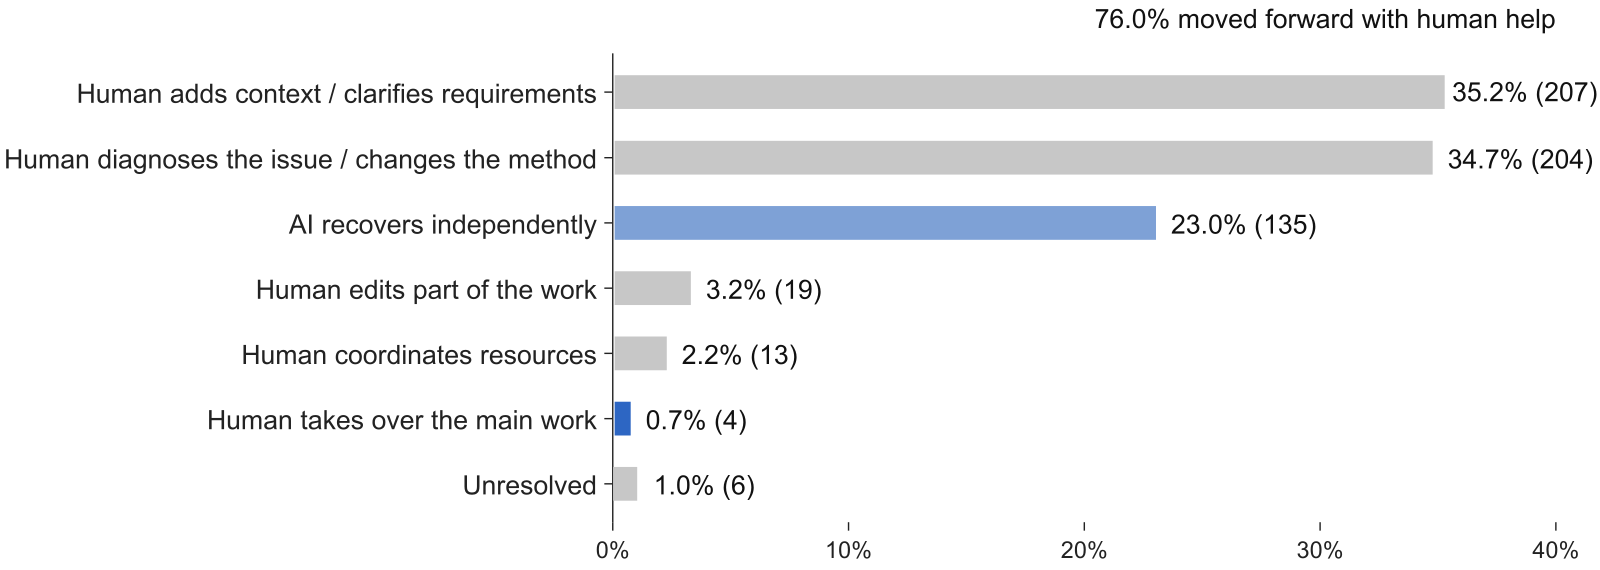
图9:588 个记录了困难的任务的恢复方式。76.0% 靠人类帮助推进,其中补上下文/澄清需求 35.2%(207 例)、诊断问题/换方法 34.7%(204 例),而人类直接接管只有 0.7%(4 例)。智能体自行恢复 23.0%,彻底卡死仅 1.0%。
这里有个很有意思的对比:人类帮忙的方式里,"补上下文 + 诊断换方法"合计约 70%,直接接管干活只有 0.7%。论文算了一笔账——人类的帮助"改变智能体所知"的可能性,是"改变谁来干活"的约 18 倍。
你想想看这意味着什么:在成熟的人机协作里,人的价值几乎全在"信息差"上——你知道需求的真实意图、知道上次为什么失败、知道哪条路是死胡同。这些上下文喂给智能体,它自己就能跑出来。人根本不需要碰键盘。
AI 的产出去了哪

图10:上半部分——627 个任务中 AI 主要输出的去向:56.5% 经实质性修订后采用,28.1% 原样采用,仅 1.0% 未被采用;下半部分——354 个实质性修订里,75.4% 由 AI 根据人类反馈完成,人类直接编辑只有 19.2%。
两个数值得记住:95.9% 的 AI 输出以某种形式进入了最终交付物;而修订工作本身,四分之三也是 AI 干的(在人的反馈驱动下)。
到这一步,整个图景就完整了:人类定目标、补上下文、做选择;智能体生成选项、写几乎所有的代码和文本、完成大部分修订。论文的结论一句话——稀缺投入是判断,不是执行。
🤔 我的判断
这篇论文我打算分两半评价。
模型那一半,是可验证经验训练路线的一次扎实的规模化展示。744B MoE、覆盖十几种验证信号的经验流水线、16 个基准 5 个第一,工程完成度很高。但要说方法论上有什么别人没想到的东西?谈不上。可验证奖励 + 环境交互 + 轨迹筛选,这套组合的每个零件都有出处,Atria Dawn 的贡献在于把它们拧成了一个能在 CAD、天气建模、操作系统这种硬核环境里出活的系统。工具调用类任务的优势和终端/工程类任务的短板,都在情理之中。
实证研究那一半,我认为是真正有长期价值的部分。市面上关于"AI 会不会取代研究员"的讨论几乎全是立场先行,而这篇论文拿出了带样本量的行为数据:33.2% 的任务无 AI 不可行、64.6% 的方法由 AI 提出、85.5% 的选择由人做出、0.7% 的接管率。这几组数字画出来的图景比任何社论都清楚——取代没有发生,分工重构发生了。
当然也要泼两盆冷水。第一,这些数据来自"研发 AI 的 AI 团队",这群人对工具的熟悉度和信任度远超普通用户,结论外推到一般知识工作要打折。第二,769 条任务里相当一部分是围绕造这个模型本身的,存在自证嫌疑——"我们用 AI 造出了这个 AI"的故事里,乐观偏差很难完全排除。论文自己在开放式挑战一节也承认:任务性能的提升不等于研究能力的提升,智能体之间共享先验会导致相关性盲点,经验跨任务的积累目前仍主要发生在人类研究者身上。
还有一个立场我觉得值得单独拎出来:论文明确反对把人类的安全守护权限像其他权限一样逐步授予 AI,原话是 "The answer is clearly no",并警告人类不应沦为只能说 "yes" 的橡皮图章审批者。在一个自家产品就是冲着"自主性"去的论文里看到这段话,多少增加了前面那些数据的可信度。
如果你也在搭智能体系统,这篇论文至少给了两个可以直接用的工程启发:一是训练数据筛选时把"验证证据链完整性"作为硬门槛,比单纯堆轨迹数量靠谱;二是做人机协作产品设计时,把资源优先砸在"让人高效地补上下文、做选择"上,而不是砸在"让人能随时接管"上——数据显示前者才是高频刚需。
至于图5 里那个虚线框 (d)——递归自我改进之后人干什么?论文没给答案,只给了方向:自主性可以涨,问责的锚必须留在人这边。这个问题接下来几年只会越来越真实。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我