SAS:别再让稀疏注意力"抄作业"了,让语言模型损失直接教它怎么排序
做长文本推理的朋友应该都有这个体会:模型每吐一个 token,都要把前面所有 KV 重新扫一遍,上下文越长越肉疼。稀疏注意力是个显然的解法——每个 query 只看一小撮最相关的上下文块就行了。但问题来了:这"一小撮"怎么选?
现在主流的可训练方案(比如 SeerAttention-R、NSA)都卡在同一个地方:选择动作是个硬 Top-K,不可导,语言模型损失的梯度根本传不回选择器。于是大家集体走了一条弯路——让选择器去蒸馏原始稠密模型的注意力分布,逐层模仿"老师看哪儿我看哪儿"。
这条路听起来合理,但你细想会发现一个错位:选择器学会的是复刻老师的注意力形状,而不是在预算有限时选什么对最终预测最有用。这两件事不是一回事。
这篇 SAS(arXiv 2609.13141)做的事情简单到让人意外:训练时把选择器的连续打分以 log 形式加进 attention logits,梯度就顺过去了。没有蒸馏,没有辅助损失,就用标准的 next-token prediction 损失端到端地训。结果在低预算下把蒸馏路线按在地上摩擦——GPQA-Diamond 上预算 1024 时领先 SeerAttention-R 10.6 到 15.5 个点。
核心摘要
痛点:可训练稀疏注意力的选择器普遍靠"逐层蒸馏稠密注意力"来训练,这个代理目标和"有限预算下对预测最有用的上下文排序"是错位的,预算都浪费在了不太有用的块上。方案:SAS 把选择器的 softmax 归一化分数当作 log 空间的门控,直接加进 attention logits,让语言模型损失通过标准反向传播训练选择器;配一个 FlashAttention 风格的 Triton kernel 解决长序列训练显存问题。效果:在 Qwen3-4B/8B/14B 上,推理(MATH500/GPQA/AIME)、长上下文(LongBench)、智能体任务(BFCL/VitaBench)全线超过蒸馏基线,预算越紧优势越大;SGLang 实测 512K 上下文解码提速 5.6 倍。我的判断:这是一篇"思路极朴素但消融极扎实"的论文,四个设计选择每个都配了梯度层面的分析,属于稀疏注意力方向少见的把"为什么这么设计"讲透的工作。
📖 论文信息
- 标题:SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking
- 作者:Zhiwei Li, Lei Zhu(通讯), Hao Gu, Xiang Hu, Yan Wang, Haitao Mi, Sirui Han, Leo Liang, Zhijiang Guo
- 机构:Tencent HY LLM Frontier(混元)、香港科技大学(广州)、香港科技大学
- 链接:https://arxiv.org/abs/2609.13141 | 代码:https://github.com/Tencent-Hunyuan/Simple-Attention-Sparsification
- 日期:2026 年 9 月 11 日
🎯 问题动机:蒸馏出来的选择器,学错了目标
先交代下背景。块稀疏注意力的标准玩法是:把上下文切成若干块(比如每块 64 个 token),用一个轻量选择器 \(\mathcal{R}_\theta\) 给每个块打分,硬 Top-K 选出若干块,query 只跟这些块做注意力:
麻烦就在 Top-K 这步——它对选择器分数 \(\mathbf{s}\) 是分段常数的,梯度为零。于是 SeerAttention-R、NSA 这些工作的做法是:选择器每层拟合原始稠密模型的注意力分布,用蒸馏损失绕开不可导问题。
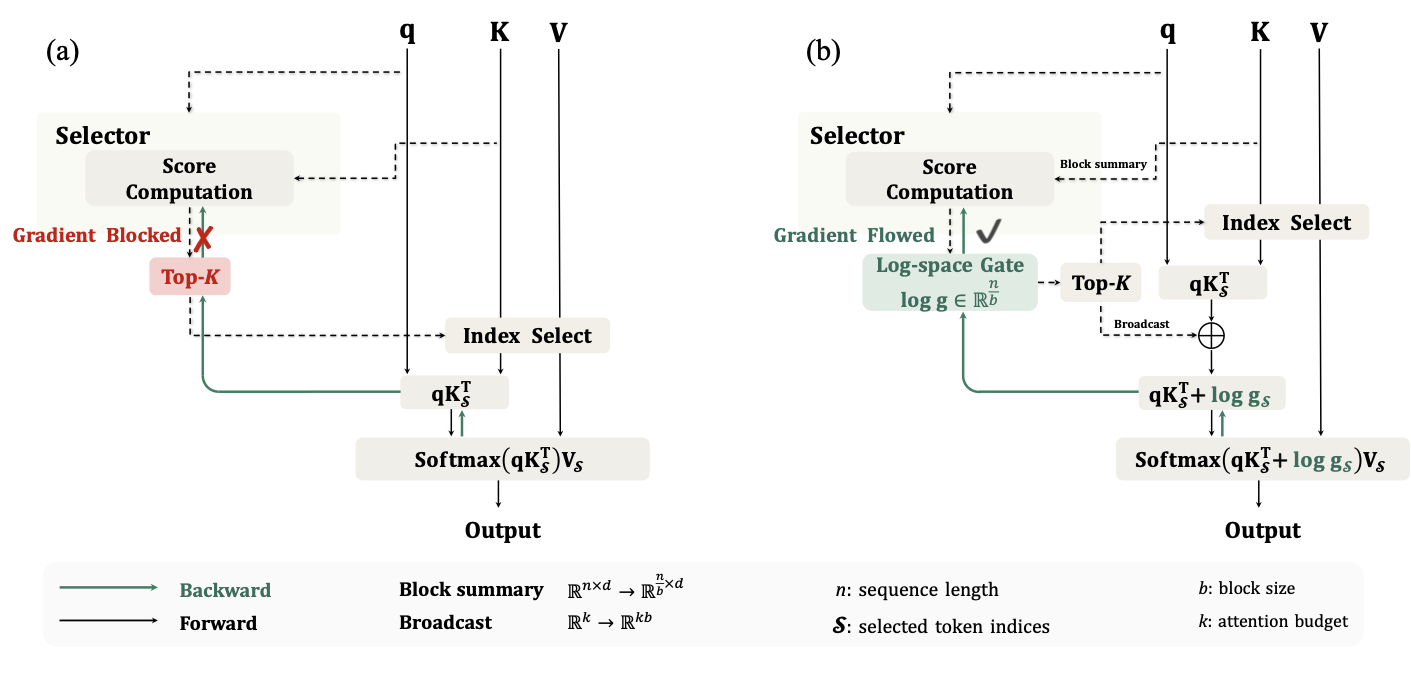
图1:(a) 传统做法——硬 Top-K 把语言模型损失的梯度挡在选择器门外,只能靠蒸馏或启发式规则绕行;(b) SAS——保留离散 Top-K 选择,但给每个选中的块挂上一个连续的 log 空间软门控 \(\log\mathbf{g}\),加进 \(\mathbf{q}\mathbf{K}^\top\) logits,梯度就能从输出一路流回选择器的 Score Computation 模块。
蒸馏路线有两个具体的毛病。一个是逐层目标各自为战:第 5 层该看的块和第 20 层该看的块可能是互补的,但逐层蒸馏根本看不到跨层互补性。另一个是只匹配注意力权重,不管 value:最终预测吃的是 \(\text{softmax}(\cdot)\mathbf{V}\) 的输出,value 向量的模长同样重要,但注意力匹配对它一无所知。
说到底,蒸馏在教选择器"老师把注意力花在哪儿",而真正该学的是"在只能看 K 个块的前提下,看哪 K 个块能让下一个 token 预测得最准"。这两个排序在低预算下差异巨大。
🧠 方法核心:一个 log 门控,四个关键选择
SAS 的完整训练式就一行:
其中 \(\mathbf{g} = \operatorname{softmax}(\mathbf{s})\) 是选择器分数经 softmax 归一化后的门控,广播到块内每个 token;当前块 \(B_0\) 恒为 1(零偏置,不打扰局部上下文)。推理时退化成普通硬 Top-K,门控不参与。训练与推理之间唯一的桥梁就是选择器学到的排序。
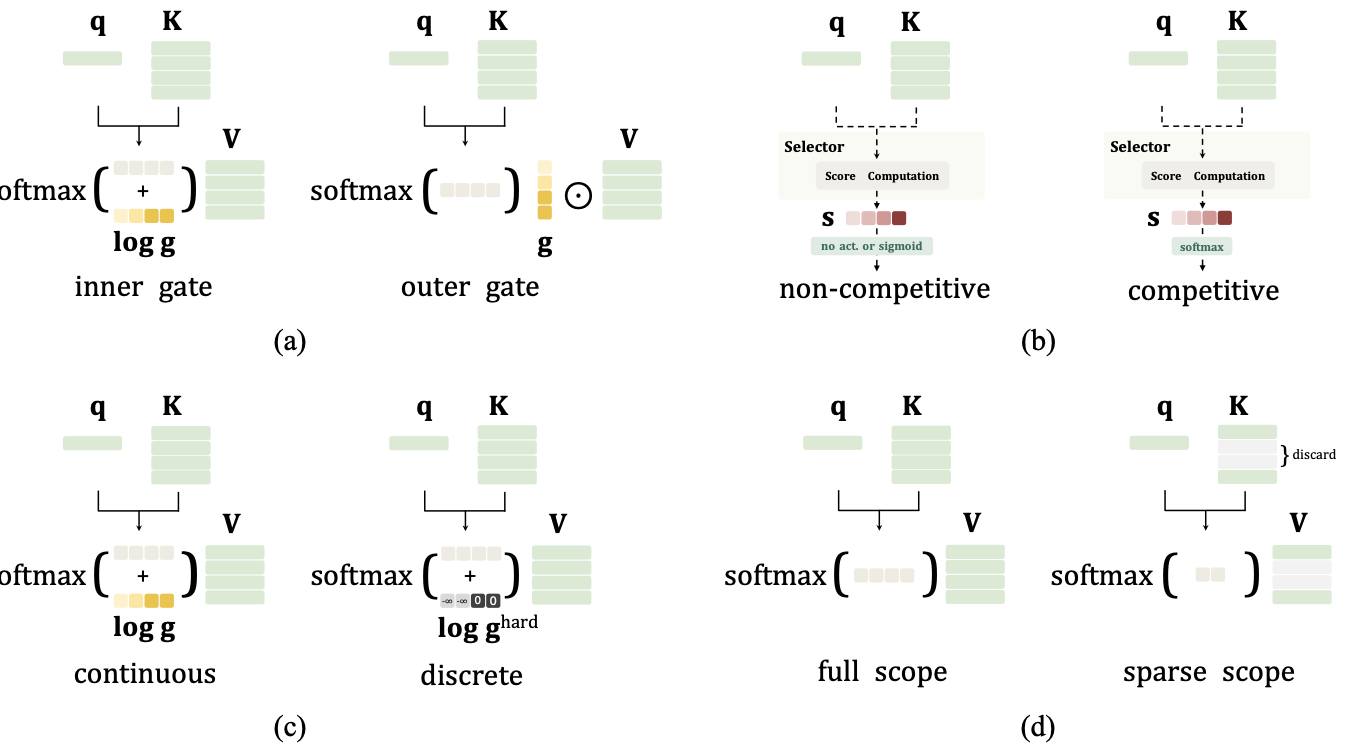
图2:SAS 拆解出的四个设计维度。(a) 门控位置——加在 softmax 里面(inner)还是外面(outer);(b) 门控激活——softmax 归一化(competitive)还是 sigmoid/原始 logit(non-competitive);(c) 排序保持——连续软门控还是塌缩成二值硬门控;(d) 训练范围——全量上下文(full scope)还是只训选中块(sparse scope)。
这篇论文最值钱的部分不是那一行式子,而是对"为什么这么配"的逐条消融。作者在 GPQA-Diamond(Qwen3-4B,预算 2048,avg@16)上做了对照实验,结果非常干脆:
| 消融维度 | 配置对比 | 1 epoch 精度 | 结论 |
|---|---|---|---|
| 门控位置 | inner vs outer | 54.4 vs 41.6 | 加进 softmax 里,差 12.8 个点 |
| 门控激活 | softmax vs sigmoid vs 原始 logit | 54.4 vs 17.0 vs 18.8 | 归一化是生死线,sigmoid 和原始 logit 直接崩 |
| 排序保持 | 连续软门控 vs STE 硬门控 | 54.4 vs 46.0 | 保留分数差异明显更好更稳 |
| 训练范围 | full scope vs sparse scope | 54.4 vs 54.8 | sparse 收敛慢但最终打平,成本还低 |
注意基线 Full Attn 是 56.1——SAS 用 2048 预算的稀疏注意力,1 epoch 后已经追到 54.8。
每条选择背后都有个梯度层面的解释,挑两个我觉得最漂亮的讲讲。
为什么门控必须进 softmax? 两种位置的梯度形态完全不同:
outer 门控用的是固定的注意力概率 \(p_i\),只能缩放 value 贡献;inner 门控里出现了 \((\mathbf{v}_i - \mathbf{o})\) 这个相对量——块的 value 比当前输出好还是差,直接决定梯度方向。这才是"排序"该有的信号。
为什么必须 softmax 归一化? 看 sigmoid 和原始 logit 会发生什么:
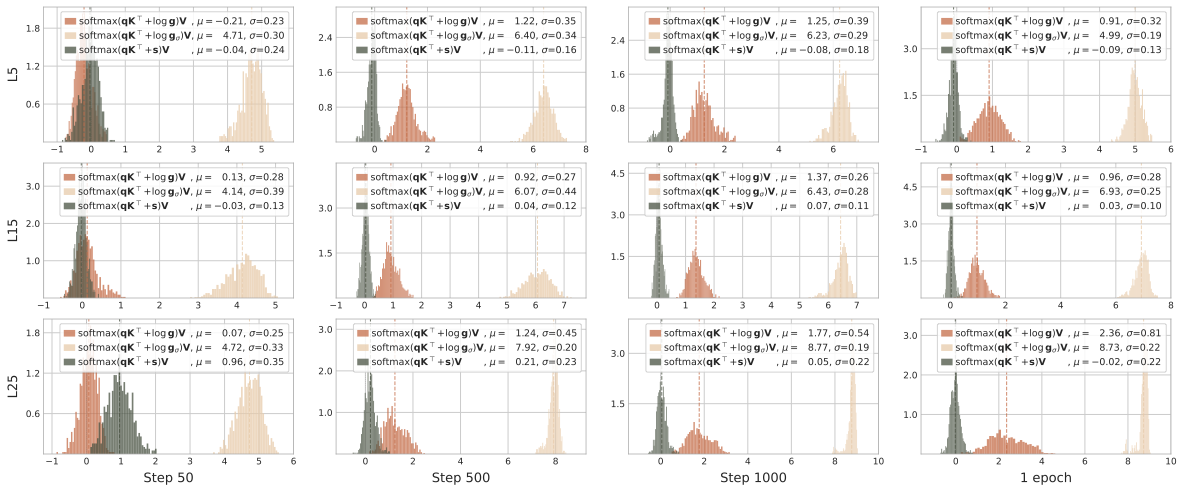
图3:第 5/15/25 层选择器 logit 分布随训练步数的演化。sigmoid 门控(米色)一路饱和冲向大值(\(\mu\) 从 4.7 涨到 9.0 附近),历史块门控趋近 1;原始 logit 注入(深色)则坍缩到 0 附近且方差变小。两种都等于"退化成没门控",只有 softmax(红棕色)维持了有区分度的分布。
sigmoid 饱和到 1、原始 logit 坍缩到 0,都会让历史块和恒为 1 的当前块失去区分。softmax 的竞争性强迫历史块之间互相抢份额——你想让某个块的门控变大,就必须压低别的块。这个"零和"性质恰恰是学排序所需要的。
硬门控(STE)为什么不行? 硬门控前向只在选中集合上归一化,一个被丢掉的块如果分数其实很高,它的隐含注意力权重没有上界,会指数增长,传导成比软门控大几个数量级的梯度。训练初期选择器还是随机初始化的,这种爆炸式梯度频繁出现,训练直接不稳。
sparse scope 为什么够用? sparse scope 下,没选中的块只能通过 softmax 归一化项被"间接"更新,梯度噪声大且高度相关;full scope 下每个块都有自己的梯度。但从图 4 的散点能看出,sparse 的间接更新虽然次优,方向大体是对的,最终精度几乎追平(54.8 vs 54.4),训练成本却低得多。所以主实验都用 sparse scope。
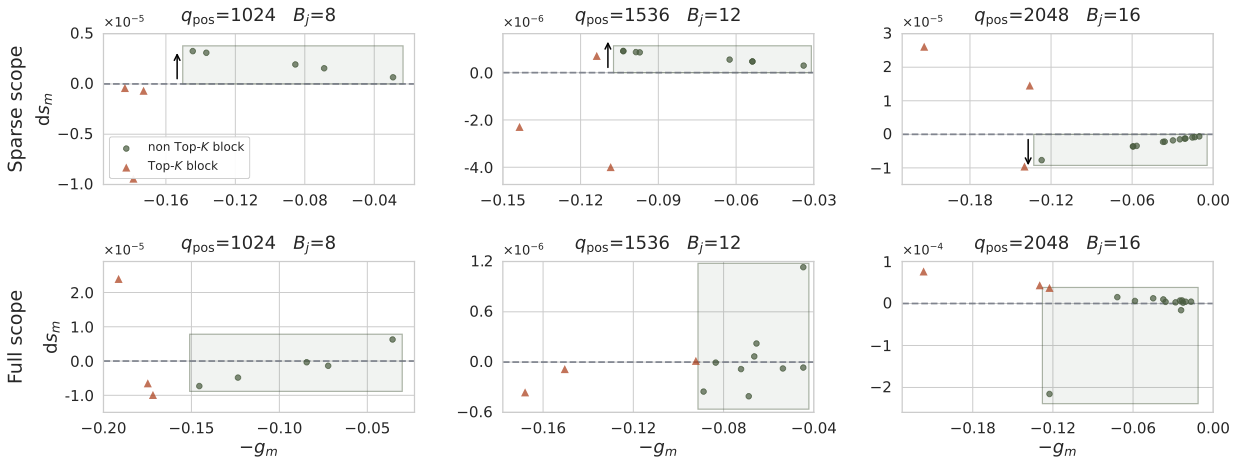
图4:Top-K 为 3 时,未选中块的梯度 \(ds_m\) 与其自身重要性 \(-g_m\) 的散点关系。sparse scope(上排)下未选中块的梯度要么集体为正要么集体为负,基本不看自己的重要性分数;full scope(下排)下每个块有基于自身内容的梯度信号。
工程上还有一块不得不提:朴素实现要把整个注意力矩阵物化出来再加门控,长序列下显存爆炸。作者写了个 FlashAttention 风格的 Triton kernel,把 log 门控的加法融进 tile 级的 \(\mathbf{q}\mathbf{K}^\top\) 计算,反向时在块内聚合门控梯度,还顺手用"门控阈值"实现了免排序的 Top-K。部署侧做成了 SGLang 的原生 attention backend,prefill 稠密、decode 稀疏,支持 GQA 和 CUDA graph。
📊 实验:预算越紧,优势越大
实验设置先说清楚:只训选择器(SeerAttention-R 同款的 AttnGate),backbone 冻结,OpenR1-Math-220k 上训一个 epoch,block size 64,AdamW lr 1e-3。同架构、同数据、同 backbone,唯一变量是训练信号——蒸馏 vs 端到端。这个对照设计我很喜欢,剥离得干干净净。
推理任务(Qwen3-4B/8B/14B)
| 预算 | 方法 | MATH500 (4B/8B/14B) | GPQA-D (4B/8B/14B) |
|---|---|---|---|
| Full | Full Attn | 93.93 / 94.43 / 95.22 | 56.19 / 60.54 / 65.25 |
| 1024 | SeerAttn-R | 84.67 / 83.57 / 86.12 | 39.84 / 39.43 / 45.64 |
| 1024 | SAS | 90.65 / 91.27 / 92.93 | 50.41 / 53.17 / 61.14 |
| 2048 | SeerAttn-R | 91.85 / 91.67 / 93.02 | 49.94 / 54.41 / 61.68 |
| 2048 | SAS | 93.47 / 93.17 / 93.54 | 54.86 / 58.74 / 65.09 |
预算 1024 时 GPQA-Diamond 上 4B 模型从 39.84 提到 50.41,涨了 10.6 个点;14B 从 45.64 到 61.14,涨了 15.5 个点。AIME24 预算 2048 时 4B 从 55.83 到 68.85,涨了 13.0 个点。顺便说,Quest 这种 training-free 的查询感知方法在 AIME 预算 2048 时直接拿 0 分,Sliding Window 也是腰斩起步——稀疏化这件事,不学习选择策略是真的不行。
还有个耐人寻味的点:预算 4096 时 SAS 在好几个格子上追平甚至反超 Full Attn(比如 AIME24 4B 的 71.72 vs 71.25)。稀疏注意力超过稠密,可能的解释是丢掉干扰上下文反而有正则化效果,不过作者没展开,我也不敢过度解读。
长上下文与智能体任务
选择器只在数学数据上训过,直接搬到 LongBench(非思考模式)依然有优势,而且输入越长差距越大:预算 2048、Qwen3-14B 的 8K+ 桶,53.9 vs 51.5,+2.4。BFCL 多轮工具调用全线领先,预算 2048 的 Qwen3-4B 上 +3.5;VitaBench 预算 4096 时多数指标领先并逼近 Full Attn。数学数据训出来的排序能力能迁移到工具调用场景,说明它学的不是"数学题怎么答",而是"什么样的上下文对预测有用"这种更底层的东西。
继续预训练也能用
作者还把 SAS 从"冻结 backbone 只训选择器"扩展到继续预训练:OLMo3-7B 上 backbone 和选择器联合训 50B token。通用任务平均 43.28,压过 HiLS-Attn-RoPE 的 41.68,基本追平稠密 base 的 43.88;LongBench 平均 30.0 与 HiLS 并列最佳,且明显超过稠密 base 的 29.0——增益集中在 8K 以上的长输入。这说明端到端训练选择器的思路不止适用于后训练改造。
🔬 分析:SAS 选出来的块,"覆盖更少,命中更准"
实验之后的分析部分是我觉得全文最有意思的地方。作者对比了蒸馏和 SAS 学到的块选择,发现一个反直觉的现象:
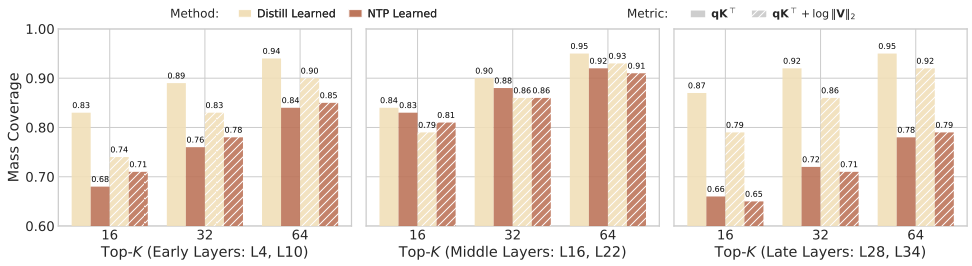
图5a:选中的 Top-K 块在每层覆盖了多少注意力质量(两种权重口径:纯 \(\mathbf{q}\mathbf{K}^\top\) 和考虑 value 模长的 \(\mathbf{q}\mathbf{K}^\top+\log\|\mathbf{V}\|_2\))。浅色是蒸馏,深色是 SAS——SAS 几乎在所有层、所有 Top-K 设置下覆盖的质量都更少。
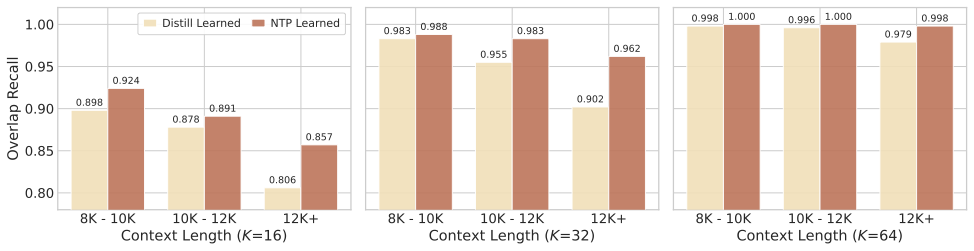
图5b:把各层选中的块取并集,跟 Full Attn 的 oracle 选择算重叠召回率。SAS(深色)在所有上下文长度和 K 值下都更高,K=16、12K+ 长度时 0.857 vs 0.806。
逐层看,SAS 覆盖的注意力质量更少——废话,蒸馏的训练目标就是匹配质量分布,当然覆盖得多。但跨层取并集后再看,SAS 对 oracle 的召回率反而更高。
这两张图放在一起,故事就通了:蒸馏是逐层的局部目标,每层都在拟合同一个老师的分布,层与层之间的选择容易冗余;SAS 被最终损失逼着做全局优化,每层可以选得"互补",单层看覆盖率吃亏,整体看命中率更高。这才是"为预测服务"和"为复刻服务"的本质区别。
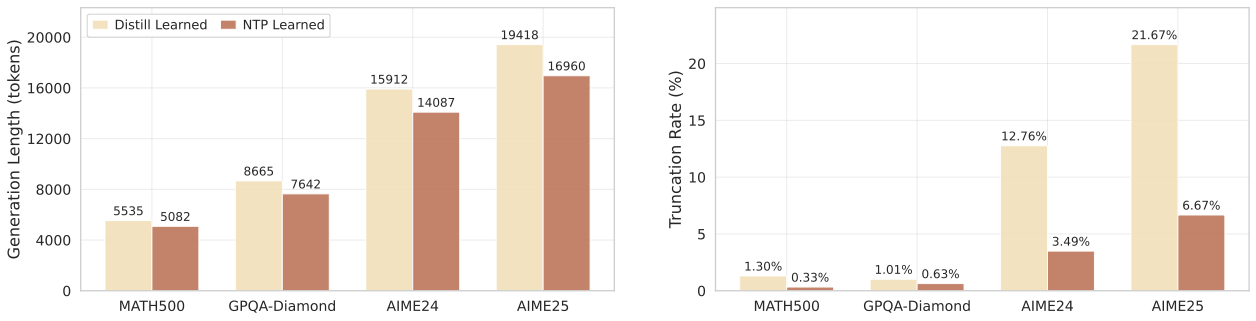
图6:Qwen3-4B、预算 4096 下的生成长度(左)和 32K 上限截断率(右)。SAS 生成更短(AIME25 上 16960 vs 19418 token)、截断更少(AIME25 上 6.67% vs 21.67%),越难的任务差距越大。
上下文选得准还有个副产品:推理链更短、截断更少。上下文里塞着没用的块,模型容易生成又长又散的推理,32K 上限都兜不住;SAS 在 AIME25 上截断率只有蒸馏路线的三分之一不到。这对推理成本是双重省钱——注意力省了,生成 token 也省了。
实测加速
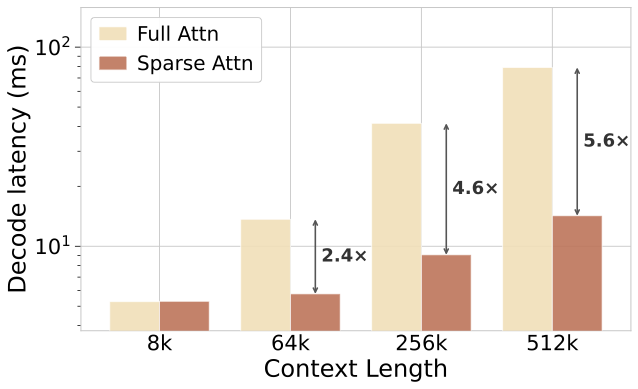
图7a:SGLang 单卡实测,Qwen3-4B、batch 1。Full Attn 解码延迟随上下文线性增长,SAS 基本恒定:64K 快 2.4 倍、256K 快 4.6 倍、512K 快 5.6 倍。
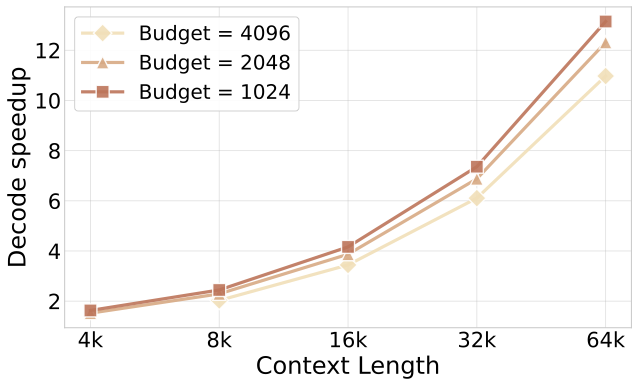
图7b:batch 8 下 64K 上下文加速接近 13 倍,且对预算不敏感——收益主要来自"不用读整个 KV cache",而不是预算的具体取值。
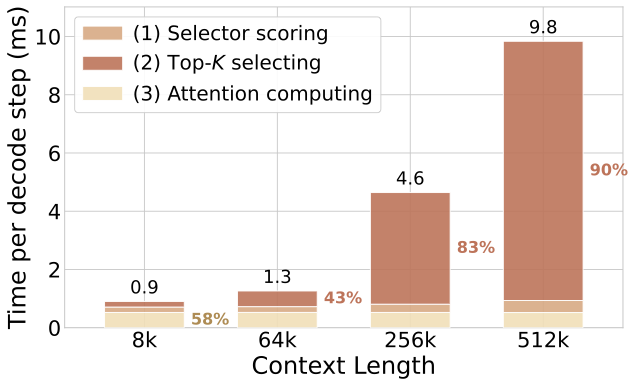
图7c:单步耗时拆成 selector 打分、Top-K 选择、注意力计算三部分。注意力计算恒定,但 Top-K 选择从 8K 时的 21% 涨到 512K 时的 90%,成为超长上下文下的新瓶颈。
说实话最后这张分解图挺打脸的:注意力本身省完了,瓶颈转移到 Top-K 排序和 selector 打分上了——512K 时选择阶段占了 90% 的耗时。超长上下文场景的下一步优化目标其实是选择器本身,而不是注意力 kernel。作者把这一点明明白白写出来,比藏着掖着强。
🤔 我的判断
亮点:
- 把"错位"讲清楚并修掉了。蒸馏 vs 端到端的差异以前大家隐约知道,这篇用"覆盖率更低但召回率更高"的实验把它量化成了直觉可见的图,再用受控对照(同 selector、同数据、只换训练信号)证明因果。这个论证链条很完整。
- 消融质量罕见地高。四个设计选择每个都给了梯度公式层面的解释,不是"我们试了这样更好"的黑盒调参。sigmoid 饱和、logit 坍缩、STE 梯度爆炸的分析都有对应的分布图佐证。
- 工程闭环完整。Triton 训练 kernel + SGLang 推理 backend + 开源代码,不是纸面方法。
几个要泼冷水的点:
- 端到端训练需要训练阶段就定死 block size 和预算粒度,想换预算得重训选择器,灵活性不如 training-free 方法。论文里各预算共用一个选择器(Top-K 32、block 64),靠推理时调整 K 来适配不同 token 预算,这块的泛化边界论文没有系统扫。
- 消融只在 GPQA-Diamond + Qwen3-4B 一个组合上做,虽然主实验铺得很开,但"四个选择缺一不可"的结论严格说只在单一配置下验证过。
- 图 7c 暴露的问题很现实:512K 场景下选择阶段占 90% 耗时,SAS 目前还没解决这个,宣称的"constant decode cost"在超长上下文下要打折扣。
跟同期工作比,SAS 的定位是"蒸馏范式(SeerAttention-R/NSA)的直接替代者"——selector 架构、kernel、部署栈全部复用,只换训练范式就能低预算涨 10 个点。这种"成本不变、信号换对"的改进,落地阻力极小。如果你正在用蒸馏路线做稀疏注意力改造,这篇值得直接上手复现;如果你做超长上下文 serving,图 7c 的瓶颈分析可能比方法本身更有参考价值。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我