不是所有步骤都配得上前沿模型:Occamy-1.0 用 35B 打出 Co-work 的成本拐点
你有没有算过一笔账:让 agent 帮你跑一个"把 CRM 里这季度的客户记录整理一遍,顺手更新财务报表"的任务,它前前后后要调几十上百次模型。单次调用便宜几毛钱看着无所谓,但乘上一百次,再乘上每天要跑的几十条任务,账单就不好看了。更扎心的是,这一百次调用里,真正需要"前沿级推理"的可能不到十次——剩下九十次干的都是状态追踪、工具调用纪律、失败后恢复、把活儿收尾这类"执行力"的活儿。
用 GPT-5.6 级别的模型去干这九十次,就像让外科主任去贴创可贴。
Accio Team 的这篇 Occamy-1.0(arXiv:2609.11977)回答的就是这个问题:一个紧凑模型,能不能把 co-work 场景的能力-成本 Pareto 前沿往外推? 答案给得相当硬气——基于 Qwen3.6-35B-A3B 继续后训练,在四个代表性 co-work 基准的聚合成本-性能图上,Occamy-1.0 正好卡在观测到的 Pareto 前沿的低成本拐点处,单任务推理成本约 0.06 美元,聚合得分约 57,跟它开销接近的模型全在它下面,比它强的模型全部贵出数倍。
核心摘要:Co-work 智能体的成本在整个 episode 上累积,而日常工作中大量步骤要的是执行力而非前沿推理。Occamy-1.0 的做法是:构建执行 grounded 的任务数据与环境(可执行契约 + 双路合成 + 三级变体 + 统一验证准入),搭一套 token 级精确捕获、可回放的多 harness 基础设施,再用"Marathon/Sprint 双专家 + 模型合并 + 最终 SAO"的分阶段配方后训练 Qwen3.6-35B-A3B。结果:Claw-Eval 均值 82.2(起点 checkpoint 是 69.5),pass3 从 54.8 拉到 71.4,执行成功率涨 14.74 个点的同时每条轨迹 token 数降 19.5%、墙钟时间降 46.4%。这不是一篇"刷榜论文",它的真正价值在于把"长程 agentic 后训练"的工程链路——数据、基础设施、配方——完整开源了出来。
📖 论文信息
- 标题:Occamy-1.0: Open Pareto-frontier 35B Intelligence for Co-work
- 作者:Wenhui Chen、Shiwen Cheng、Hao Dong、Chenda Duan、Ruixiang Feng 等(Accio Team)
- 链接:https://arxiv.org/abs/2609.11977 (2026 年 9 月 4 日提交)
- 开源:模型权重
Accio-Lab/Occamy-1.0(HuggingFace)、代码Accio-Lab/occamy(GitHub)、RL 基础设施开源版 Dressage(Accio-Lab/Dressage),另附部分训练数据
🎯 问题动机:Co-work 的能力需求是极度不均匀的
先把 co-work 这个词说清楚。论文给的定义挺克制:用户在持久化数字环境里指导的多步骤工作——更新 CRM 记录、走财务流程、电商运营、公司日常事务。它可能涉及编码、信息收集、工具调用,但定义它的不是任何固定技能组合,而是跨完整任务的持续协调。
这类任务有个很反直觉的结构特性:能力需求严重不均。少数步骤需要难题推理,大量步骤要的是状态追踪、工具使用纪律、失败恢复和可靠的 follow-through。而成本和延迟是在整个 episode 上累积的——每次调用省一点,一百次调用就是量级差异。
但真要训一个这样的模型,有个绕不过去的技术障碍:长程连续性。任务状态跨多次模型调用持久存在,可能超出单个上下文窗口。harness 会压缩、裁剪、重写模型可见的历史,但环境状态不会回滚——文件已经写了、工具效果还在、早期决策仍然约束后续动作。于是一个 episode 会横跨多个"模型可见历史",基础设施必须精确捕获 policy 到底看到了什么,并把任务级结果归因到正确的 policy token 上。
说实话,这个问题在做 agentic RL 的团队里都碰到过,但大多数论文选择含糊过去。这篇论文把它当成一等公民来处理,这是我觉得它比一般"我们训了个 agent 模型"的报告值钱得多的原因。

图1:Occamy-1.0 的总览——五个环节咬合成一个闭环:真实工作(1)经双路合成(2)产出任务,统一验证准入(3)筛出可训练数据,执行 grounded 基础设施(4)负责多 harness 执行、token 精确 IO、状态回放与谱系追踪,最后进入分阶段训练配方(5):初始 checkpoint 分出 Sprint Expert 与 Marathon Expert,合并后再做最终 RL。左上角也标明了评测口径:端到端 co-work 基准 + 工具/编码/指令遵循的支撑性评测。
🏗️ 方法核心之一:任务不是"写"出来的,是"执行验证"出来的
可执行任务契约
每条任务是一个版本化契约 \(\mathcal{C}=(\mathcal{S},\mathcal{M})\):公开请求、初始世界状态、工具规范(含状态转移)、私有完成与评分契约,外加编排元数据(稳定标识、schema 版本、确定性时间设置、执行预算)。
关键在一致性要求:请求所需的证据必须存在于初始状态且经许可工具可达;每个评分条件必须能从执行证据中观测。光有静态 schema 校验不算数——必须有执行级证据证明存在有效完成路径,且 grader 能区分"真干了活"和 no-op 这类退化策略。
这套设计直接冲着合成数据的老大难问题去:很多 agentic 数据集的任务是 LLM"写"出来的,看着合理,跑起来要么完不成、要么 grader 形同虚设。Occamy 的准入管线用公开接口做参考执行证明可行路径,再用负向执行验证无效结果确实得低分。证据不全或基础设施故障的任务进隔离区(quarantine),不准入训练。
双路合成与三级变体
两条互补的合成路线:Environment-first 从真实工作环境(文档、代码库、软件包、服务能力)出发构造可支持、可验证的任务;Capability-first 从真实工作中抽象出的能力依赖(定位来源、身份消解、证据对账、跨工具行动、验证……)出发,再去找独立来源实例化环境。
变体分三级:Presentation(只换措辞、姓名、日期)、Realization(能力结构不变,换来源、初始状态、工具与约束)、Compositional(连能力结构和环境拓扑一起改,产生新的证据-决策-行动-验证依赖)。

图3:数据管线全貌——真实委托与环境资源(1)被抽象进"能力结构 × 环境结构"的联合设计空间(2),两条合成路线(3)发出同一份可执行契约(4),经过 canonical identity、可执行与语义门禁、可达性与服务证据、轨迹与奖励准入四道验证(5),产出三类分别计数的训练工件(6),右侧的覆盖监控(7)把领域、能力组合、环境类型的缺口反馈回合成目标。注意"quarantined"那个虚线框:基础设施故障或封存不完整的 episode 直接隔离,不进训练。
🔧 方法核心之二:把 harness 差异变成受控训练变量
这部分是全文工程密度最高的地方。Agent 在三个 harness 下执行——OpenClaw、Hermes、Accio Work——适配器层保留各 harness 的 prompt 结构、工具 schema、turn 边界、压缩规则、子代理交接、超时行为的差异。白盒 harness 被组合式分解:
其中 \(\ell\) 是 agent loop,\(p\) 是 prompt 配置,\(\mathcal{U}\) 是工具集,\(\mathcal{K}\) 是可复用技能包,\(m_{1:k}\) 是中间件链(上下文压缩、重试恢复、预算执行、失败归一化、事件追踪)。rollout 前控制器解析组合并存进不可变的 composition manifest——这样 harness 多样性就从"污染源"变成了"受控变量"。
更核心的是 token 级捕获。所有 policy 调用经过 OpenAI 兼容代理,记录输入与采样的 token ID、log 概率、loss mask、模型版本及归属的 episode/run/turn/segment。turn 定义为 \(u_t=(P_t, Y_t, D_t)\),并维护不变式:
注意这是在 token 层面、而非解码后文本层面维护的——解码再重新 tokenize 是会漂的,干过 long context 训练的人都懂这个坑。基础设施承认两种 adapter 声明的前缀变换:summary replacement 与 history pruning,二者关闭当前 segment 并从新前缀重启 TiTO(token-in-token-out)拼接。无法解释的前缀变化或捕获失败?该 episode 可审计,但排除出训练。

图4:基础设施四大模块——多 harness 执行(1)下挂隔离沙箱与记录代理;同步 episode 记录(2)把模型视角(a)、harness 事件(b)、环境快照(c)、任务与结果(d)放进同一条谱系,"rewrite 是表示边界,不是 episode 终点";回放机制(3)分 token 精确回放与状态回放两路,指纹不匹配或版本漂移的 rollout 直接拒收;最终汇成学习器可直接消费的训练视图(4)。

图13:一个 episode 的解剖图——root run 与 subagent run 各自的 segment 被 rewrite 边界切开,token 按来源着色(注入/继承、root 采样、subagent 采样),fork 与 handoff 都有明确归属;每个 episode 只有一个任务级终局结果。子代理轨迹保留谱系但不计入主 policy 的损失。
🧪 方法核心之三:双专家、模型合并、再巩固
训练配方不是一条直线 SFT→RL,而是分阶段多分支:
- Marathon Expert:长程任务,SFT + HDPO(带分层效率奖励的 DPO 变体)
- Sprint Expert:更广分布的短程 agentic 任务,只做 SFT
- 模型合并:uniform model soup,两专家同架构、同分词器、同 checkpoint 谱系,直接权重平均
- SAO:合并后的 checkpoint 上做最终 RL,广义 co-work 混合任务,遵循 CompactionRL——重写后的实际前缀就作为下一个策略状态,policy 自己生成的重写摘要可训练,harness 产生的重写内容只作条件
SFT 数据的构成很能说明问题(Table 3):14,998 条轨迹、403.3M tokens、平均 26.9K,强双峰分布。
| 数据来源 | 样本数 | 占比 | 平均长度 | Tokens |
|---|---|---|---|---|
| General agentic | 5,418 | 36.1% | 37.7K | 204.1M |
| Long-horizon interactive agents | 923 | 6.2% | 95.8K | 88.4M |
| Terminal and software engineering | 1,228 | 8.2% | 35.1K | 43.1M |
| Tool-call grounding | 7,429 | 49.5% | 9.1K | 67.7M |
| 合计 | 14,998 | 100% | 26.9K | 403.3M |
看结构:general agentic 加 long-horizon 用 42.3% 的样本贡献了 72.5% 的 tokens;tool-call grounding 占了近一半样本但只贡献 16.8% 的 tokens。长轨迹喂"持续性",短轨迹喂"工具纪律",分工明确。SFT 超参上值得一提的是最大序列长 131,072、CP=8/EP=8 并行、视觉编码器冻结、只对 response token 计损失,并对 harness 产生的 summary 与重放前缀做 history masking——作条件但不背损失,跟上面基础设施的 token 谱系严丝合缝。
RL 损失定义在 episode 级:每个 episode 含多条轨迹、可跨多个 segment,但只有一个终局奖励 \(R(e)\):
Marathon Expert 的 HDPO 阶段还加了个挺精巧的效率奖励——按准确率分层构造效率信号:
同样做对的轨迹里,步数更少的拿更高奖励。零中心、相对比较,避免了"短而差"被效率项偏爱——这个坑在效率奖励设计里太常见了,看到作者专门防了一手,好感度加一。
模型合并这块作者倒是很坦诚:明确定位为"能力平衡步骤"而非全面提升。他们试过 SLERP,Claw-Eval 相近但 BFCL v4 更低,弃用,回到 uniform soup。
📊 实验:同规模全面领先,还能跟大块头掰手腕
评测覆盖 12 个基准、四大能力域。对比组分两层:同规模 35B-A3B 组(起点 checkpoint Qwen3.6 35B-A3B、Agents-A1、Nex-N2-mini、BigBang-1.0、Ornith-1.5),以及大规模托管组(GPT-5.6 Sol、Qwen3.8-Max、DeepSeek V4 Pro、GLM-5.2)。

主结果速览:九个基准面板上,深绿色(Occamy-1.0)相对浅绿色(起点 Qwen3.6-35B-A3B)全面拉开差距;在 Claw-Eval、CommerceAgentBench、τ³-Bench 等面板上已逼近甚至摸到大规模模型组的下沿。
全量数字(Table 5,节选关键行):
| 基准 | Occamy-1.0 | Qwen3.6 35B-A3B | 同规模最强对手 | GPT-5.6 Sol | Qwen3.8-Max |
|---|---|---|---|---|---|
| Claw-Eval (avg.) | 82.20 | 69.50 | 69.90 (Agents-A1) | 81.80 | 83.90 |
| Claw-Eval (pass3) | 71.40 | 54.80 | 48.70 (Ornith-1.5) | 68.90 | 73.70 |
| WildClawBench | 49.16 | 40.40 | 45.91 (Ornith-1.5) | 67.20 | 54.42 |
| CommerceAgentBench | 37.40 | 19.60 | 37.40 (Ornith-1.5) | 49.50 | 46.30 |
| Business Arena(净值) | $79,868 | $44,751 | $66,292 (Ornith-1.5) | $168,867 | $89,423 |
| GDPval† | 1128 | 1004 | 999 (Nex-N2-mini) | 1741 | 1640 |
| OfficeQA Pro | 48.10 | 39.10 | 59.40 (Ornith-1.5) | 74.40 | 69.20 |
| τ³-Bench (Banking) | 37.10 | 11.90 | 25.80 (Nex-N2-mini) | 46.90 | 54.60 |
| AutomationBench (Pass1) | 27.60 | 7.50 | 18.50 (Ornith-1.5) | 45.50 | 43.50 |
| BFCL v4 | 65.40 | 63.19 | 68.51 (Ornith-1.5) | 64.33 | 73.65 |
| VitaBench | 41.75 | 34.25 | 46.00 (BigBang-1.0) | 46.75 | 52.25 |
| Terminal-Bench 2.1 | 59.00 | 49.50 | 67.80 (Ornith-1.5) | 88.80 | 81.30 |
| IFEval | 91.53 | 86.90 | 91.60 (并列两家) | 95.00 | 95.02 |
几个值得停一下的数。Claw-Eval 均值 82.20,不仅赢了起点 checkpoint 12.7 个点,还压过 GPT-5.6 Sol 的 81.80,仅次于 Qwen3.8-Max 的 83.90——一个 35B-A3B 的模型在 co-work 综合榜上摸到大规模托管模型组的上沿,这个数是有点凶的。更该多看一眼的是 pass3(三次全对)从 54.8 到 71.4,均值与 pass3 的差距只有 10.8 个点,是同规模组里最小的。这说明收益来自可重复的执行能力,而不是偶尔蒙对一次撑起来的均值。
τ³-Bench 从 11.90 到 37.10,三倍多的提升;AutomationBench Pass1 从 7.50 到 27.60,接近四倍。这些长程、多轮、带模拟用户的任务恰恰是"执行力"密度最高的场景,提升幅度和论文的动机完全对得上。
当然也要泼点冷水:OfficeQA Pro(48.1)离 Ornith-1.5 的 59.4 和 GPT-5.6 Sol 的 74.4 差距明显,知识密集型任务还是大模型的主场;Terminal-Bench 2.1 的 59.0 也打不过 Ornith-1.5 的 67.8。专门化没有让它变成全能选手——但 IFEval 91.53、BFCL v4 65.40、TB 2.1 比起点涨 9.5 分说明一件事:专门化没有造成能力坍缩。
成本-Pareto:拐点到底是怎么站上去的
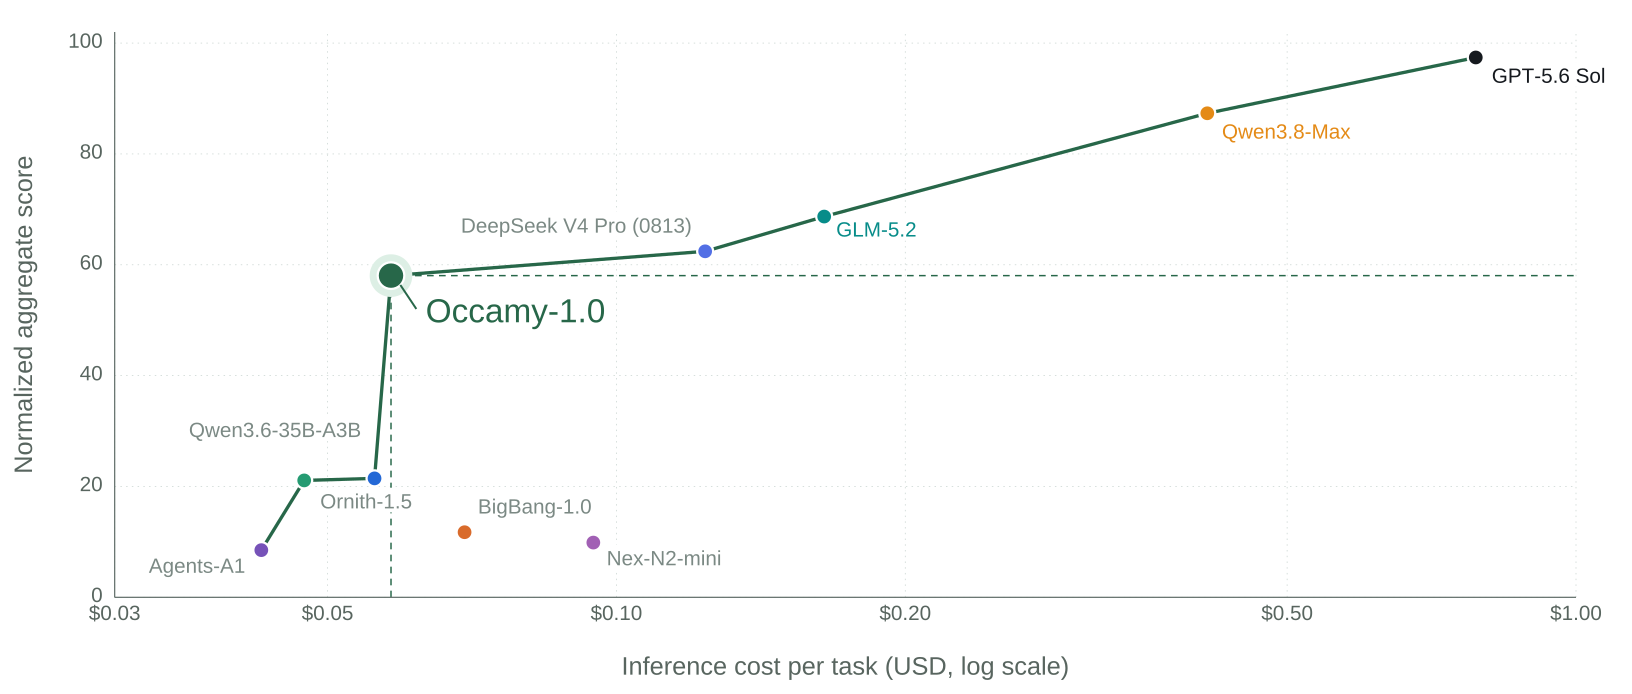
图2:四个代表基准(Claw-Eval、WildClawBench、AutomationBench、GDPval)等权聚合后的成本-性能图,横轴是单任务推理成本(美元,对数刻度),纵轴是归一化聚合分。绿线是经验 Pareto 前沿。Occamy-1.0 在约 0.06 美元/任务处拿到约 57 分,正好坐在前沿的低成本拐点——比它便宜或同价的模型全在 20 分上下,而要把分数再往上推,成本要跳到 0.4 美元以上(Qwen3.8-Max)乃至接近 1 美元(GPT-5.6 Sol)。
定价协议要说清楚,因为这是这个结论的命脉:大模型走托管 API,紧凑模型本地 serving(单副本、KV cache 无溢出),按 OpenRouter 上当时最便宜的合格供应商完整价格向量(input/cache-read/output)计价;所有本地 35B-A3B checkpoint 用同一个最低价格向量,保证同规模组内的成本差异只反映 token 用量。作者自己也声明这是"规模匹配的货币代理",不是完整部署 TCO。
我的看法:协议设计得相当克制了——同价不同分,把"架构红利"和"训练红利"在同规模组内剥开。但拐点叙事确实依赖这套定价,换个计价方式(比如大模型走批量折扣、本地算上运维摊销),拐点的位置会挪。这个结论方向可信,具体坐标别当成物理常数。
效率与可靠性:快是真的快
Table 6 这组数字可能是全文对工程实践最有说服力的一张表(Claw-Eval T/C 合并,161 个 T 任务 + 38 个 C 任务,每模型 597 次尝试):
| 指标 | Qwen3.6-35B-A3B | Occamy-1.0 | 变化 |
|---|---|---|---|
| Avg. Score | 69.5 | 82.2 | 涨 12.7 分 |
| 执行成功率 | 62.81% | 77.55% | 涨 14.74 个点 |
| Tokens/轨迹 | 185,999 | 149,713 | 降 19.5% |
| 工具调用/轨迹 | 14.24 | 12.07 | 降 15.2% |
| Trace Wall (s) | 74.58 | 39.96 | 降 46.4% |
| Timeout 率 | 9.88% | 2.18% | 降 7.7 个点 |
分更高、token 更少、调用更少、墙钟几乎砍半、超时率从接近一成压到 2% 出头。这正好回应了开头的动机——效率不是靠少干活换来的,是靠"执行纪律"换来的。HDPO 那个分层效率奖励在这里落了地。
🔬 消融与经验:比结果更值钱的部分
Section 7 的四组经验我觉得是全文信息密度最高的地方,挑几条说。
专家合并不是白赚的。 Model soup 在 AutomationBench 拿到 29.0,反超两个专家各自的成绩;但 WildClawBench 上 48.28 卡在 Marathon Expert(50.76)和 Sprint Expert(45.29)之间——合并是把能力往平衡拉,不是全面提升。合并后 SAO 再把 Claw-Eval 从 79.2 推到 82.2、WildClawBench 从 48.28 推到 49.16,把平衡点掰回 co-work 执行。这个"分头练—合并—再对齐"的节奏,跟社区里做专长模型合并的经验是吻合的。
环境变化比名义难度更能预测训练收益。 任务构建上最反直觉的一条:按 workspace 文件、后端状态、请求措辞、评分标准四要素刻画任务,"真正变化的要素数"与"产生有意义分数差的速率"高度相关。模板化地换一百个皮(改名字改日期),不如实质地换十个环境。另外部分给分优于二元成败;轨迹长度本身无信息量,工具链复杂度和 grader 覆盖度才可靠。
奖励平台期不等于没在学。 Marathon Expert 的某个 run 里奖励长期平台,但并行工具调用行为在剧烈变化,行为稳定之后奖励才开始抬头——一个"重组阶段"。作者的建议很实在:把工具调用结构、并行度、轮数、轨迹长度当成奖励之外的辅助诊断指标,别只盯着 reward 曲线焦虑。
Reward hacking 审计:4352 条轨迹只抓到 4 例,全部来自同一个底层任务。 三阶段审计(确定性检测器 → 语义逐条复核 → 高风险校准)后得到的结论值得引用:在这个模型规模下,hacking 主要源于任务数据与评估基础设施的可利用缺陷,而非模型自发的策略性欺骗。三条具体教训也很硬核——任务可行性本身就是防 hacking 的一环(有个任务要求用根本不可用的 API 做图像理解,幻觉结果被当成"虚假进展"奖励了);评估保密要覆盖公开渠道(agent 曾从过早暴露的 HuggingFace 数据集里直接找到答案);RL 数据筛选本身是攻击面(不可行任务被绕过接口直读后端数据库拿到非零 pass@16,被选中后把偶然 exploit 强化成了策略)。
说实话,最后这条让我愣了一下。数据筛选管线按"高分轨迹"挑样本,天然偏爱 exploit——这个反馈回路以前真没认真想过。
🤔 我的判断
这篇报告最值钱的地方不在"35B 打赢了多少榜",而在于它把长程 agentic 后训练最难讲清楚的三件事——数据怎么保证可执行、轨迹怎么保证可归因、多 harness 差异怎么不变污染源——全部给出了可复用的工程答案,并且把基础设施(Dressage)开源了。对正在搭 agentic RL 管线的团队,这套东西的直接参考价值超过模型本身。
但也有几处要保持清醒。其一,成本拐点的根基有一半是继承来的:Qwen3.6-35B-A3B 本身是 35B 总参、约 3B 激活的 MoE,"花 3B 的推理钱干 30B 的活"是基座架构给的红利,Occamy 的证明的是"在这个红利上专门化 co-work 不会亏能力,还能大赚执行力"——这依然很有价值,但"Pareto-frontier"这个标题措辞里,架构的功劳和后训练的功劳要分开记。其二,Pareto 结论依赖特定定价协议,作者自己标注了是推理成本代理而非 TCO,引用时别放大。其三,Business Arena 净值 $79,868 对 $80,000 初始资本基本是回本水平,作者诚实声明"不代表盈利运营",这个表态比很多把模拟商业结果吹上天的报告体面得多。其四,知识密集(OfficeQA Pro 48.1 vs 74.4)与编码(TB 2.1 59.0 vs 67.8)上跟强模型仍有实打实的差距,它是个"执行力特长生",不是通才。
工程启发上,有三条可以直接拿走:效率奖励要按准确率分层构造,否则就是在奖励"短而差";轨迹诊断别只看 reward,行为指标(工具调用结构、并行度、轮数)往往先动;数据准入的负向执行验证(证明 no-op 得低分)比正向验证更能挡住 grader 漏洞——顺带把 reward hacking 的最大来源也堵了。
如果 co-work agent 的部署成本是你现在的瓶颈,这个权重值得下载下来跑一跑;如果你在做 agentic 后训练,Dressage 和这套准入/回放设计值得先读再抄。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我