自己教自己,怎么越教越笨了?一篇综述把 On-Policy Self-Distillation 的"崩溃病"拆成了三个杠杆
你有没有碰到过这种事:模型训练曲线一路向好,pass@1 稳步上涨,你正开心呢,回头一测 pass@16,居然掉了。模型变得更"会考试"了,但它能走出来的推理路径反而变少了——原来会三种解法,现在只会一种。
这不是个别现象。在 On-Policy Self-Distillation(OPSD)这个最近半年火起来的方向里,这几乎成了绕不开的诅咒。OPSD 的想法本来很漂亮:不请大模型当老师,让模型自己拿着"参考答案"当老师,逐 token 地教那个看不到答案的自己。省钱、信号稠密、效果号称能打平 GRPO。
但同样这份"信息不对称",既是信号的来源,也是偏差的来源。
上周读到一篇综述(arXiv 2608.25936),坦白说我本来以为又是一篇流水账式的 survey,结果读下来挺惊喜——它没跑一个新实验,却把过去半年散在十几篇论文里、被起了各种名字的现象(entropy collapse、diversity collapse、rich-get-richer、shortcut……)统一收进了一个框架:一个症状(collapse),三个杠杆(信号几何、特权信息、环路稳定性)。这种"不做实验、只做结构"的综述,其实比大多数灌水实验论文难写得多,也有用得多。
核心摘要:OPSD 让模型以"看过答案的自己"为老师做在策略蒸馏,用信息差替代了外部大模型的能力差,在数学推理上以远少于 GRPO 的生成 token 数达到可比精度(Qwen3-1.7B 上 AIME24 最佳 57.2%)。但稠密信号会加速"崩溃"——推理多样性收窄,thinking 模型上实测退化最高达 -17%(avg@16)。这篇综述的贡献是把崩溃拆成两个成因族(RL 固有的熵侵蚀 vs OPSD 特有的 PMI 捷径机制),并给出三个控制杠杆:token 加权(往哪打信号)、特权信息选择(给老师看什么)、教师动态(信号何时变)。结论很扎心:最顺手的选择(直接给参考答案)恰恰是最不可迁移的选择。如果你在做推理模型后训练,这篇值得细读;如果你想把 OPSD 直接搬上生产,它劝你别。
论文信息
- 标题:One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
- 作者:Justin Robert(通讯)、Raheel Qader
- 机构:OVHai LLM
- 链接:https://arxiv.org/abs/2608.25936 (2026 年 8 月 26 日提交)
- 说明:综述范围限定在数学推理,不含新实验
📖 从 SFT 到 OPSD:每一步都在补上一个的坑
这条演化链其实特别清晰,每个方法都在修前一个方法的缺陷。
SFT 信号稠密(逐 token 模仿),但学的是别人生成的序列(off-policy),模型一旦偏离正确前缀就开始漂——这就是 exposure bias。RL(先是 RLHF,后来是 RLVR)让模型从自己的生成里学(on-policy),治好了 exposure bias,但信号变得稀疏:几百个 token 的轨迹只在最后给一个奖励,信用分配又成了难题,而且长 rollout 采样很贵。
On-Policy Distillation(OPD,代表作 GKD)把密度找回来了:一个更大的教师模型逐 token 给学生的 rollout 打分。信用分配解决了,但代价是要全程养着一个更大的模型。
OPSD(Zhao et al. 的创始论文)砍掉了这最后一个依赖:老师不用更强,只要"知道得更多"。教师就是同一个模型,只是条件里塞了特权信息 \(y^{\star}\)(参考答案、提示或环境反馈)。这个想法其实不新——Vapnik 2009 年就提出过 LUPI(Learning Using Privileged Information)理论,蒸馏本身也可以看作特权信息传递的特例(Lopez-Paz et al.)。
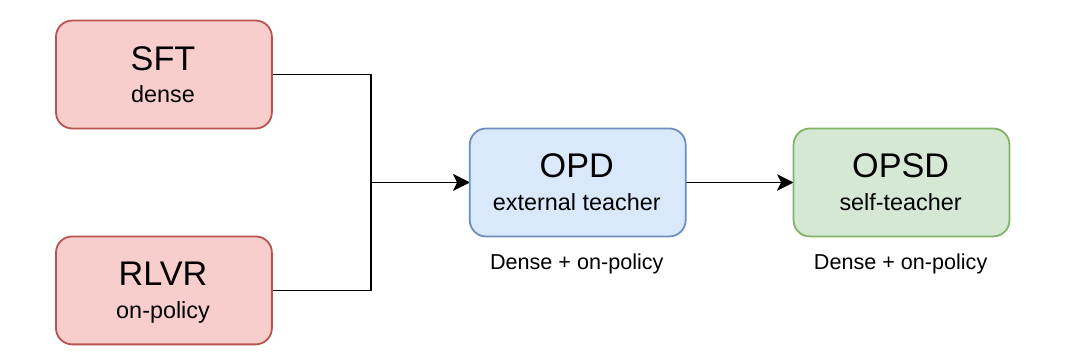
图1:OPSD 的谱系。SFT 提供密度,RLVR 提供 on-policy,OPD 两者兼得但要外部教师,OPSD 用"信息差"替代"能力差",实现自蒸馏
同期还有个姊妹方法 SDPO(Hübotter et al.):同样的自蒸馏机器,但特权信息从参考答案换成了环境反馈(代码执行报错、验证器输出),天然适合代码和工具调用场景。在 LiveCodeBench v6 上 SDPO 拿到 48.8%,而 GRPO 只有 41.2%。
🏗️ OPSD 到底怎么转起来的
整个循环五步,看图就明白:
- 学生看到问题 \(x\),自回归采样一个 rollout \(\hat{y} \sim p_S(\cdot \mid x)\)(长度上限 1024 token);
- 教师拿到 \(x + y^{\star}\) + 指令("读完解答后,给出你自己的推理"),逐位置给学生的 rollout 打分,得到 \(p_T(\cdot \mid x, y^{\star}, \hat{y}_{<n})\);学生那边也算一份 \(p_S(\cdot \mid x, \hat{y}_{<n})\)。两张约 \(1024 \times 150000\) 的概率矩阵;
- 逐位置算前向 KL 散度,每个词表项的贡献先 clip 到阈值 \(\tau\),再求和、再对整条 rollout 取平均:
- 反传只更新学生,教师冻结;
- 换下一批 \((x, y^{\star})\),循环。
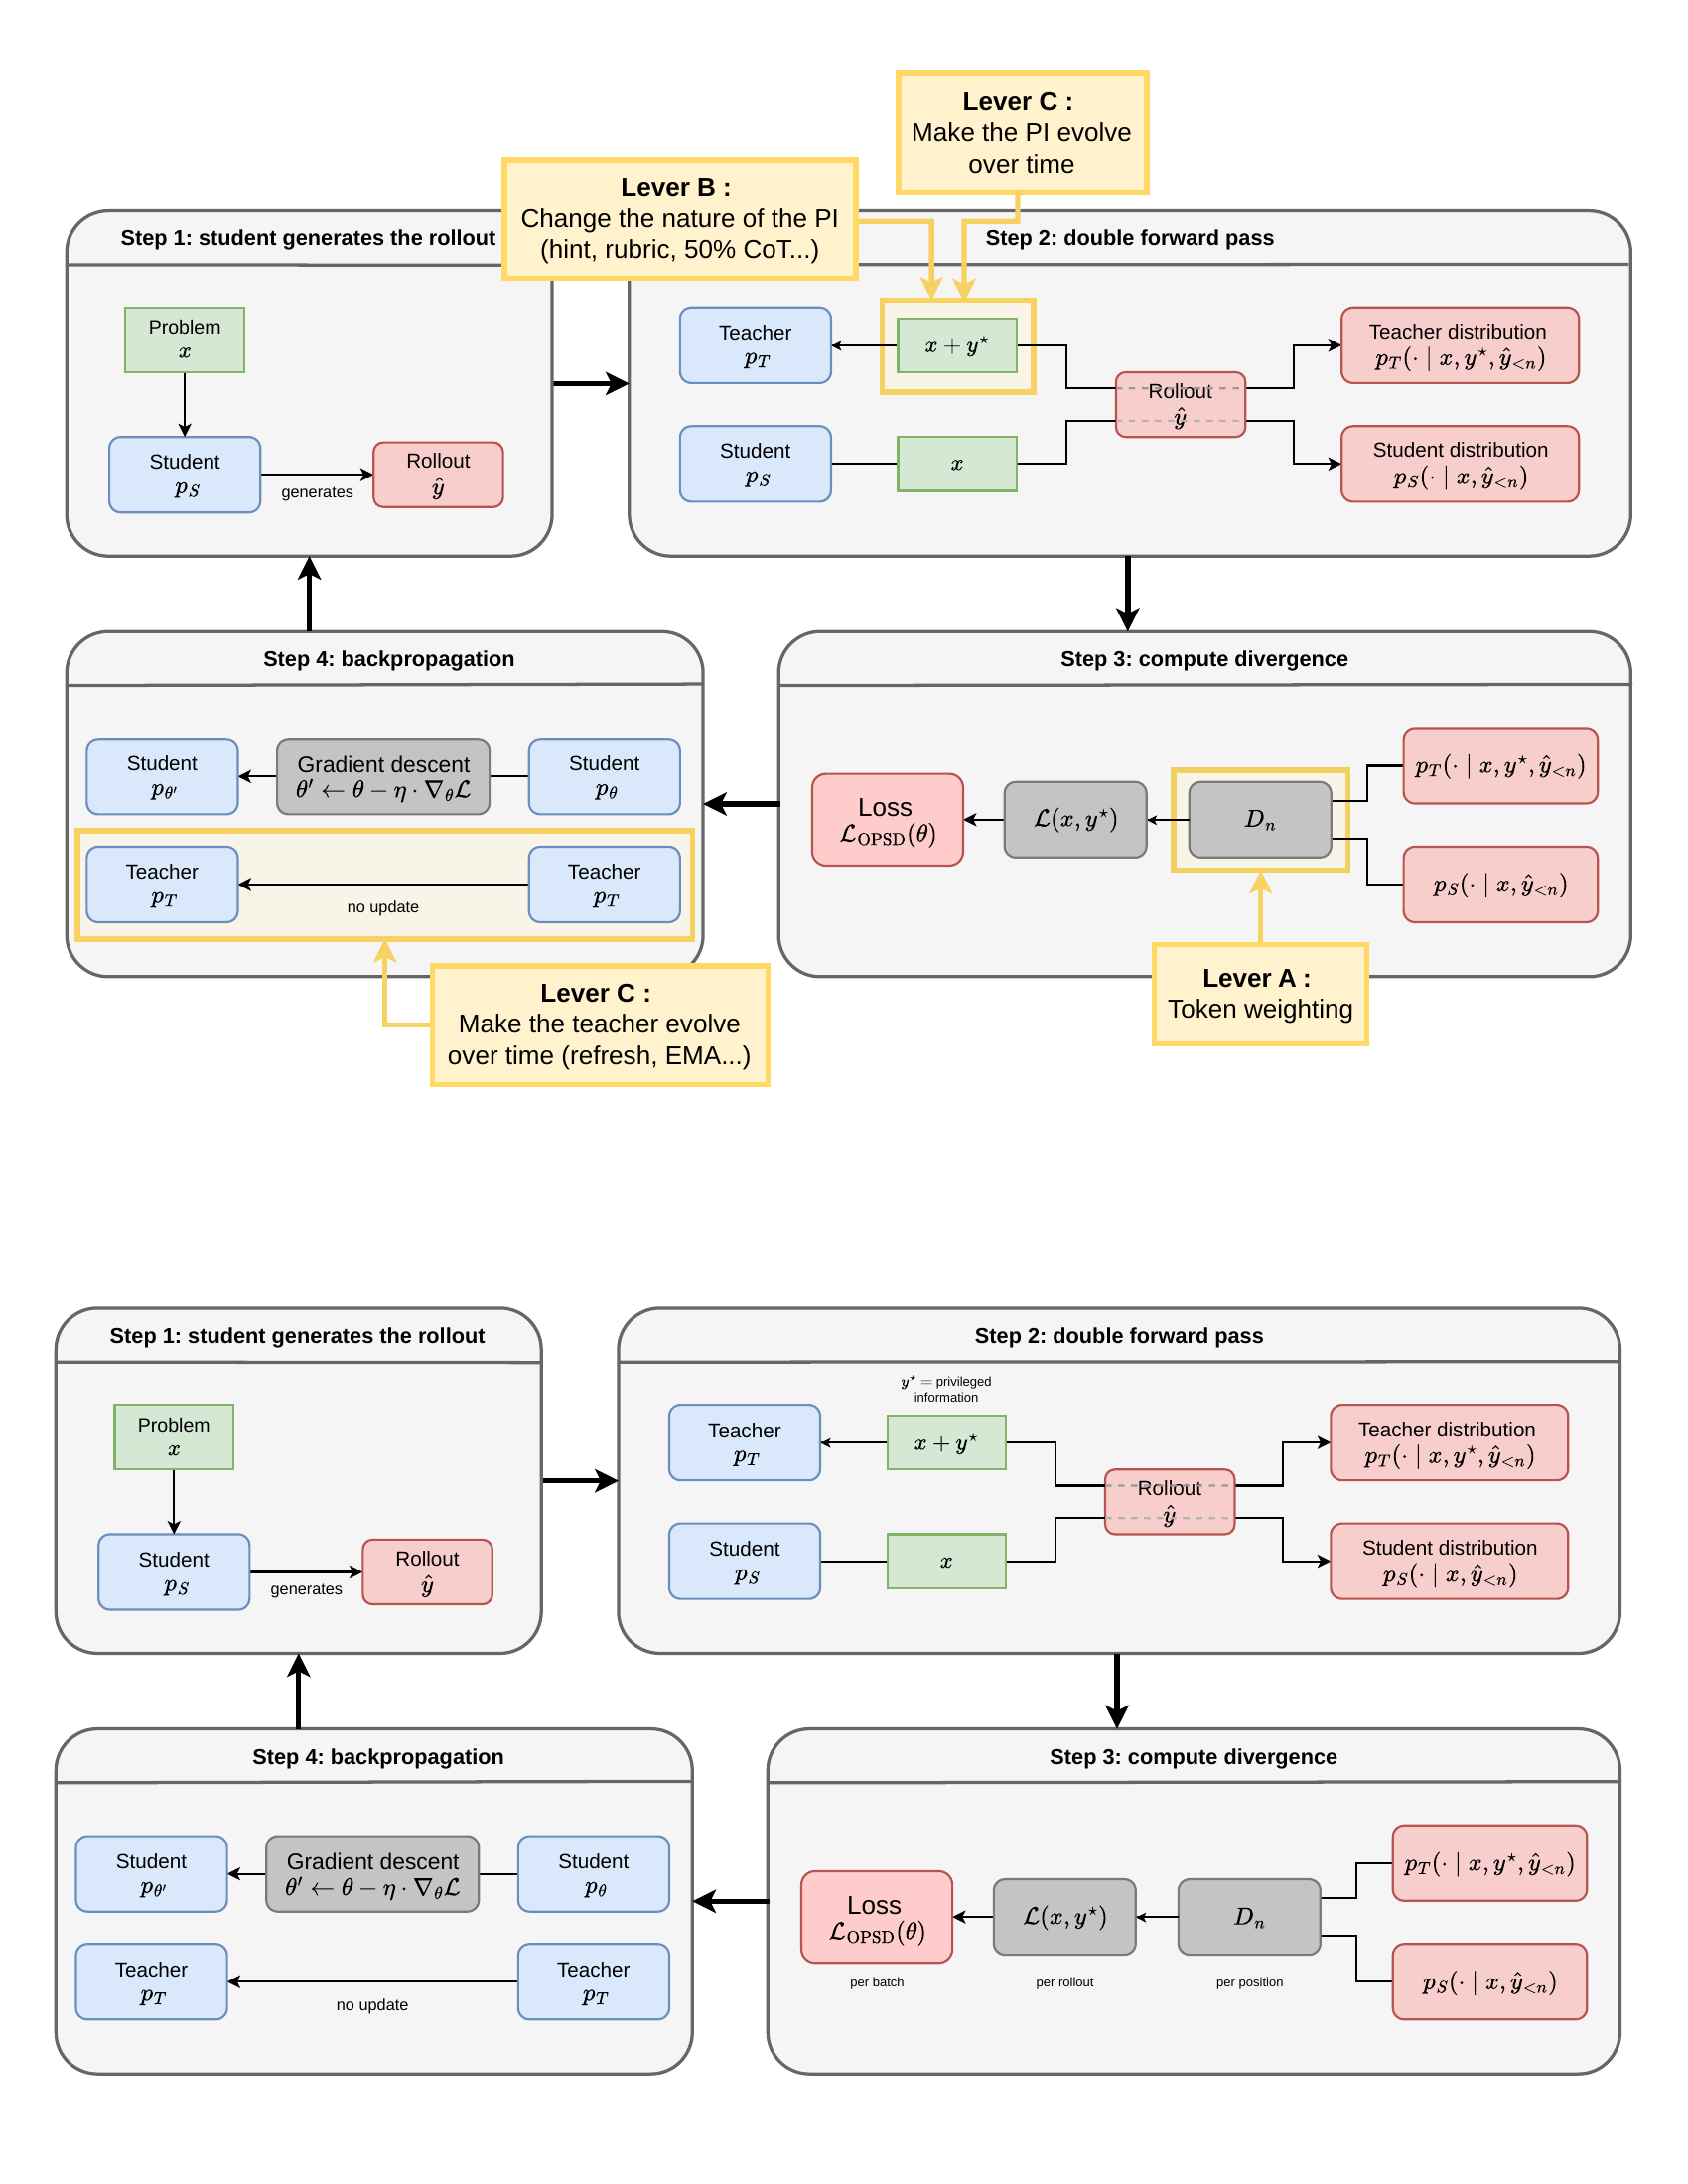
图2:OPSD 的四步循环——学生生成、双前向打分、算散度、只反传学生。注意教师全程"no update",这是后面 Lever C 要讨论的痛点
创始论文的账面数字确实好看:GRPO 每题采 8 条最长 16k token 的 rollout,OPSD 一条 1024 token 的生成就够用;Qwen3-1.7B 上一次 run 在 4 张 H100 上十五分钟跑完;AIME25 从 36.7 涨到 43.9(第 50 步)。
但等等,先别急着高潮。这篇综述很冷静地泼了两盆冷水。
第一盆冷水:省的是生成 token,不是算力。OPSD 每步要两次前向加一次反向,等预算下每一步成本约是 GRPO 的两倍(Qwen3-8B、8×H100 上 20.6 秒对 11.2 秒)。优势是收敛步数少,不是单步便宜。
第二盆冷水:那些分数是 best-over-checkpoints 选出来的。AIME25 训练结束时的值其实只有 41.1%,比最佳的 43.9% 低了近 3 个点。而且 AIME 一共就 30 题,一道题翻盘就是 3 分多,两个解码种子之间的差距能到 15 分。再叠加 AIME24 题目在预训练语料里部分泄漏、Qwen 家族"随机信号都能涨分"的特异体质——综述专门用一节(§1.4)立了规矩:后面所有数字,必须先问几个种子、报没报 pass@k、用的哪个模型家族,否则不采信。
说实话,光是这一节的"阅卷标准",就已经值回阅读时间了。
🤒 症状:崩溃,而且是两种病共用一个名字
崩溃(collapse)指模型能产出的推理路径集合持续收窄。它在三个层面显形,而且这三个层面并不等价——这是综述里我觉得最值钱的澄清之一:
- 行为上:pass@1 涨,pass@k 平甚至跌。Nicolicioiu et al. 在 Qwen3-8B 上实测,自蒸馏后 pass@1 从 71.9 升到 73.4,pass@16 却从 83.6 掉到 78.5;
- 分布上:token 熵趋向零;
- 几何上:目标变成单峰,模型对每道题只锁定一种解法。
关键点来了:上面那组实验里,自蒸馏模型的 token 熵其实比 GRPO 训练的模型更高,但功能多样性更低。熵根本不是多样性的有效代理指标。只看均分和熵的论文,很可能完全看不到崩溃正在发生——只有 pass@k 能抓出来。
病因有两族,必须分开:
第一族:OPSD 之前就存在的通病。 一是 RL 梯度本身在侵蚀熵——Cui et al. 给出了那条著名的规律 \(R = -a\,e^{H} + b\),性能被单调递减的熵预算锁死;二是 model collapse(Shumailov et al.),任何拿自己生成物再训练的循环都会先丢分布的尾部、再收敛到近零方差的单峰。不过 Gerstgrasser et al. 证明 collapse 的前提是合成数据替代真实数据,而 OPSD 每一步都通过教师条件重新注入了真实的 \(y^{\star}\),所以 model collapse 描述了现象的形状,却解释不了它的成因。
第二族:OPSD 特有的机制,PMI。 Shen et al. 证明,教师逐 token 传给学生的信号,其实是 token 与特权上下文之间的点互信息(PMI)。看过答案的教师变成了"先知":它不再犹豫,于是强烈奖励那些答案已经蕴含的 token(连接词、可验证内容),惩罚深思熟虑的 token("wait"、"maybe"、回退)。而恰恰是这些犹豫 token,支撑着学生测试时的多步搜索。三个工作从不同角度确认了这条机制:Kim et al. 称之为"认知言语化被压制"(epistemic verbalization suppression),Nicolicioiu et al. 给出 rich-get-richer 动态(示范大多采样自主流模式,稀有正确策略信号越来越弱直至消亡),Kaur et al. 则定位到 privileged context 降低了推理的"分叉率"。
Kaur et al. 的实测数字相当难看:同样的特权信息,在 thinking 模型上造成最高 -17% 的相对退化(avg@16),在 instruction-tuned 模型上反而是帮忙的。同样的信息,伤谁帮谁,取决于模型本身会不会"想"。
这个 PMI 视角还有个推论让我印象很深:它或许不只是事后解释,而是一张预测网格——特权信息越直接蕴含解答的 token,信号就越会吹大捷径、压垮深思。可惜目前还没有研究真的拿它当预测器去验证过。
🎛️ 杠杆 A:信号打在哪——散度方向与密度的选择性
第一个杠杆管两件事:用什么散度把学生和教师拉近,以及信号打多密、打在哪些 token 上。
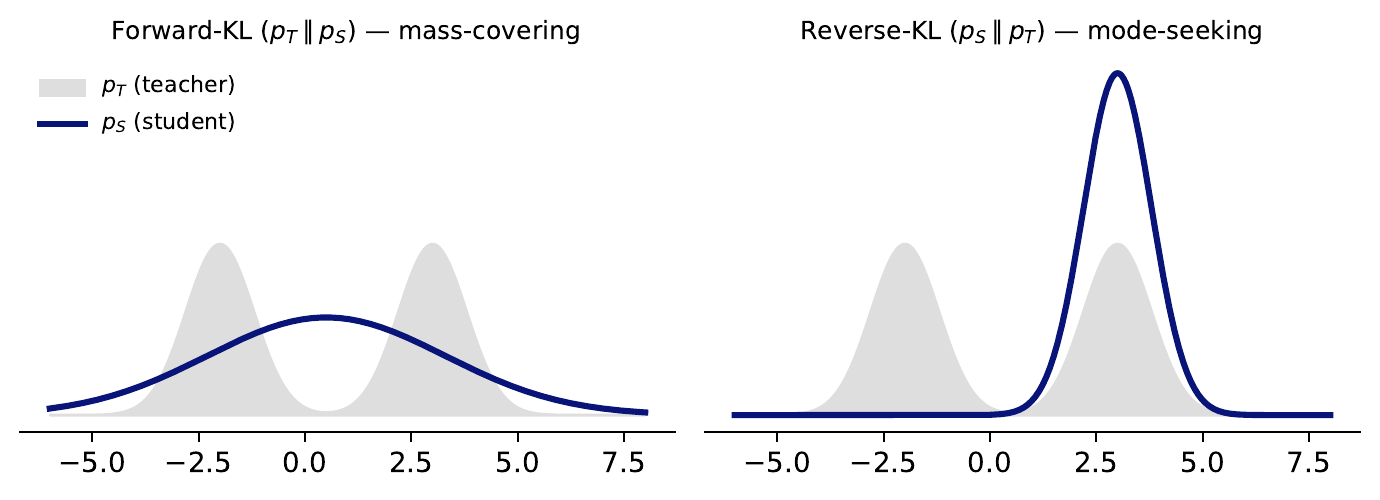
图3:前向 KL(左)是 mass-covering,学生被迫覆盖教师的所有峰;反向 KL(右)是 mode-seeking,学生锁定教师的某一个峰。这个方向选择直接决定性能-多样性权衡的站位
GKD 早在 2023 年就把散度空间摆出来了:反向 KL 性能最好但多样性最低,前向 KL 反之,JSD 居中。DPH-RL 进一步证明反向 KL 会加速多样性崩溃(pass@1 升、pass@k 降,域外更糟)。OPSD 选前向 KL 是站对了队。
但"越密越好"的直觉被最近的工作直接打脸。Denser \(\neq\) Better 发现全链蒸馏在短轨迹任务(工具调用)上有用,在数学和科学的长轨迹上反而放大瑕疵;持续学习场景里 SDPO 快速专精然后崩溃,稀疏奖励的 GRPO 反而保留更多。Unmasking OPD 的诊断更扎心:把蒸馏梯度和理想的逐 token 梯度对齐打分后发现——蒸馏主要在错误轨迹上起作用,学生已经走对的时候教师基本是个噪声源;如果只在对齐为正的 token(大约一半)上蒸馏,信号质量能提升 10 到 15 倍。这个数字是 oracle 测量,还没人能在训练里兑现,但方向已经很清楚了。
最漂亮的修法来自 Entropy-Aware OPD:反向 KL 在教师自信(低熵)的 token 上很好用,但在教师不确定(高熵)的 token 上会强迫学生做单选,而高熵 token 恰恰是推理的分叉点。实测数据显示,训练中学生高熵位置的 argmax 变了 84 次(低熵位置只变 7 次),学生只保留了 6.8% 的高熵 token,教师却有 18.5%——学生在最该探索的地方被榨干了。他们的方案简单得可爱:低熵处保持反向 KL,只在教师高熵 token 上补一个前向 KL,开销每步只多 4.5% 左右。回头看 OPSD 那个 clip 操作,算是个粗糙的前身——它能机械地压一压格式 token,但完全分不清哪些位置教师其实心里没底。
这个杠杆剩下的开放问题也很实在:理想梯度对齐是事后才能算的(得知道轨迹结局),教师熵是在线的但没人保证它和对齐相关;粒度上到底该逐 token 还是逐题目加权,也没有答案。
🎛️ 杠杆 B:给老师看什么——特权信息的安全等级
这是全文着墨最重的一个杠杆,也是我读下来觉得对工程最有直接指导意义的部分。
先给一个老原则。机器人领域早就回答过类似问题:特权信息安全的充要条件,是学生能在测试时凭自己的感知重建它。Learning by Cheating 里"作弊"的教师(看得见完整场景布局)能教会只有摄像头的学生,因为学生能从图像里恢复教师知道的东西;而 Weihs et al. 证明,当教师依据学生拿不到的信息行动时,模仿会产生 imitation gap 和可证明的差策略。RMA 的做法最干净:特权信息从不被直接抄,学生学的是自己从历史里重新生成它。
LLM 这边 2026 年的工作把这个判据重新捡了起来,结论连成了一条风险递减的光谱:
| 特权信息类型 | 测试时可重建 | 实测效果 | 训练范式 | 需要什么资源 |
|---|---|---|---|---|
| 仅最终答案(oracle) | 否 | 有害或无效 | 强→弱蒸馏 / 自蒸馏 | 标注答案 |
| 参考解答:推理+答案(标准 OPSD) | 否 | 在 thinking 模型上有害(最高 -17%) | 自蒸馏 | 标注解答 |
| 部分轨迹锚点(AR-OPD) | 部分 | 正向,捷径事件降 20%+ | 自蒸馏 | 标注轨迹 |
| 计划、提示(DOPD) | 是 | 正向 | 强→弱蒸馏 | 标注解答+生成 |
| 错误对齐批评 | 是 | 正向(比 OPSD 高 5.27,比 GRPO 高 16.11,avg@12) | 自蒸馏 | 批评模型 |
| 评分准则 rubric | 是 | 多样性保住,精度提升有限 | 自蒸馏 | 人工撰写 |
| 执行反馈(SDPO) | 是 | 正向 | 自蒸馏(代码) | 可验证环境 |
表:按"对解答的预设程度"递减排列的特权信息光谱(整理自论文 Table 1 及其注释)
两组受控对比把光谱的两头都钉死了。Kara and Ersoy 在严格自蒸馏下比了三种上下文:GRPO 二元奖励、参考解答(标准 OPSD)、逐步对齐批评(批评模型逐字保留学生的正确步骤、只重写错误步骤)。对齐批评以 +5.27 赢过 OPSD、+16.11 赢过 GRPO(avg@12)——而且它的逐 token 分析揭示了 PMI 之外的第二个机制:看到参考解答的模型会在每个 token 上改变行为,包括本来已经对的;对齐批评只动错的那些,信号集中得多。Yu et al. 把对比扩到五种形式:仅最终答案(C-Eval 上 59.5)居然低于完全不给特权信息(63.0),而无执行的分步提示拿到 71.3 大幅领先。他们的结论和安全判据完全咬合:让特权信息有效的不是答案的正确性,而是它传递技能的能力。
修复手段也从"选什么信息"进化到了"怎么提纯":
- AR-OPD 把教师信号拆成锚点(只看前半段轨迹、不含答案)加残差,只保留残差的 \(\lambda\) 倍:\(q_{\lambda} = p_T^{\text{anchor}} + \lambda\,(p_T^{\text{oracle}} - p_T^{\text{anchor}})\),\(\lambda = 0.6\),捷径事件降了 20% 以上。问题从"给哪种信息"变成了"token 级别上还剩下多少可学的部分";
- Purified OPSD 更刁钻:让一个教师只看答案不看题目,这个教师暴露的就是捷径成分而非推理成分,把这部分从信号里扣掉,学生的不确定性标记就稳住了;
- DemoPSD 逐 token 看师生分歧决定跟不跟教师:分布接近就跟,差太远就无视(说明特权信息把教师带偏太多了),效果同时压过 GRPO 和 SDPO。
有个细节我得承认有点意外:rubric 蒸馏(给教师看好答案的标准而不是答案)能保住多样性、甚至在前向 KL 下让熵回升,但手写的 rubric 明显好于模型自己生成的 rubric。这条路要规模化,rubric 从哪来是个真问题。
🎛️ 杠杆 C:信号何时变——教师动态与指导衰减
最后一个杠杆加了时间维度。创始论文里教师冻结在初始策略上,学生在往前走,靶子却原地不动——增益自然越练越小。那让教师跟着学生一起更新行不行?不行,环路会自我确认而不是自我纠正,直接塌。
这个问题视觉自监督五年前就解过,三条规则可以直接搬:
- 永远别把梯度反传进教师(stop-gradient)。SimSiam 证明这是决定性成分——没有它,模型直接塌到 0.1% 准确率。OPSD 天然满足这条;
- 让教师演化,但要比学生慢,比如 EMA:\(\theta_T \leftarrow \rho\,\theta_T + (1-\rho)\,\theta_S\)。有意思的是,视觉文献内部对这条都有分歧(SimSiam 说 momentum encoder 不必要,BYOL 和 Mean Teacher 靠它活),而这个分歧在 LLM 场景从来没被检验过;
- 保持两个角色的结构不对称(BYOL 的教训)。OPSD 里这条是自动的——教师看得见特权信息,学生看不见。
LLM 侧 2026 年的两个工作把"何时动、动多少"说细了。CGTR 管时机:固定间隔刷新教师可能把它锁在一个正在漂移的学生身上(他们叫 state-oblivious collapse),改成只在学生真有进步(奖励增益确认)时才刷新,换取稳定性的是两次刷新之间的"隔离期"——按这个逻辑,EMA 教师每步都吸收一点漂移,等于没有隔离期。TOP-D 管距离:教师离学生太远会产生又大又噪的梯度,得像 trust region 一样把教师拴近一点。
遗忘问题也有个漂亮的统一视角。RL's Razor 证明遗忘程度由一个量预测:训练后策略与初始策略在新任务上的 KL 距离。on-policy RL 在所有解里选移动最小的那个,所以比 SFT 忘得少。那稠密自蒸馏呢?SDFT 说它忘得少,Denser \(\neq\) Better 说它忘得多甚至崩溃。综述给的调和我觉得挺合理:自蒸馏比 SFT 动得少,但比稀疏 RL 动得多,排序应该是——遗忘程度:原始 SFT \gt 稠密自蒸馏 \gt 稀疏 RL。不过 Hübotter et al. 的报告又跟这个排序拧着(SDPO 比 GRPO 忘得少),作者也承认这个分歧没解决。这块我自己也拿不准,协议差异(单任务 vs 任务序列)可能是根源。
还有一个独立但常被混淆的机制:特权信息本身的衰减。ATESD 指出标准 OPSD 永远给教师看完整轨迹(teacher-side exposure mismatch),他们用小控制器按学生进步速率自动调节教师能看到的轨迹比例,在 Qwen3-1.7B/4B/8B 上拿到 +0.95 到 +2.33(avg@12)。隔壁 off-policy 引导那边(R3、Prefix-RFT、AdaBack、UFT)这套衰减思路已经很成熟了,UFT 甚至给了理论保证:没有初始帮助,弱模型碰到好轨迹要等指数级时间。还有一个谁都没试过的方向:不只衰减信息的量,还衰减它的性质——训练初期给 oracle,中期给计划,后期只给提示。
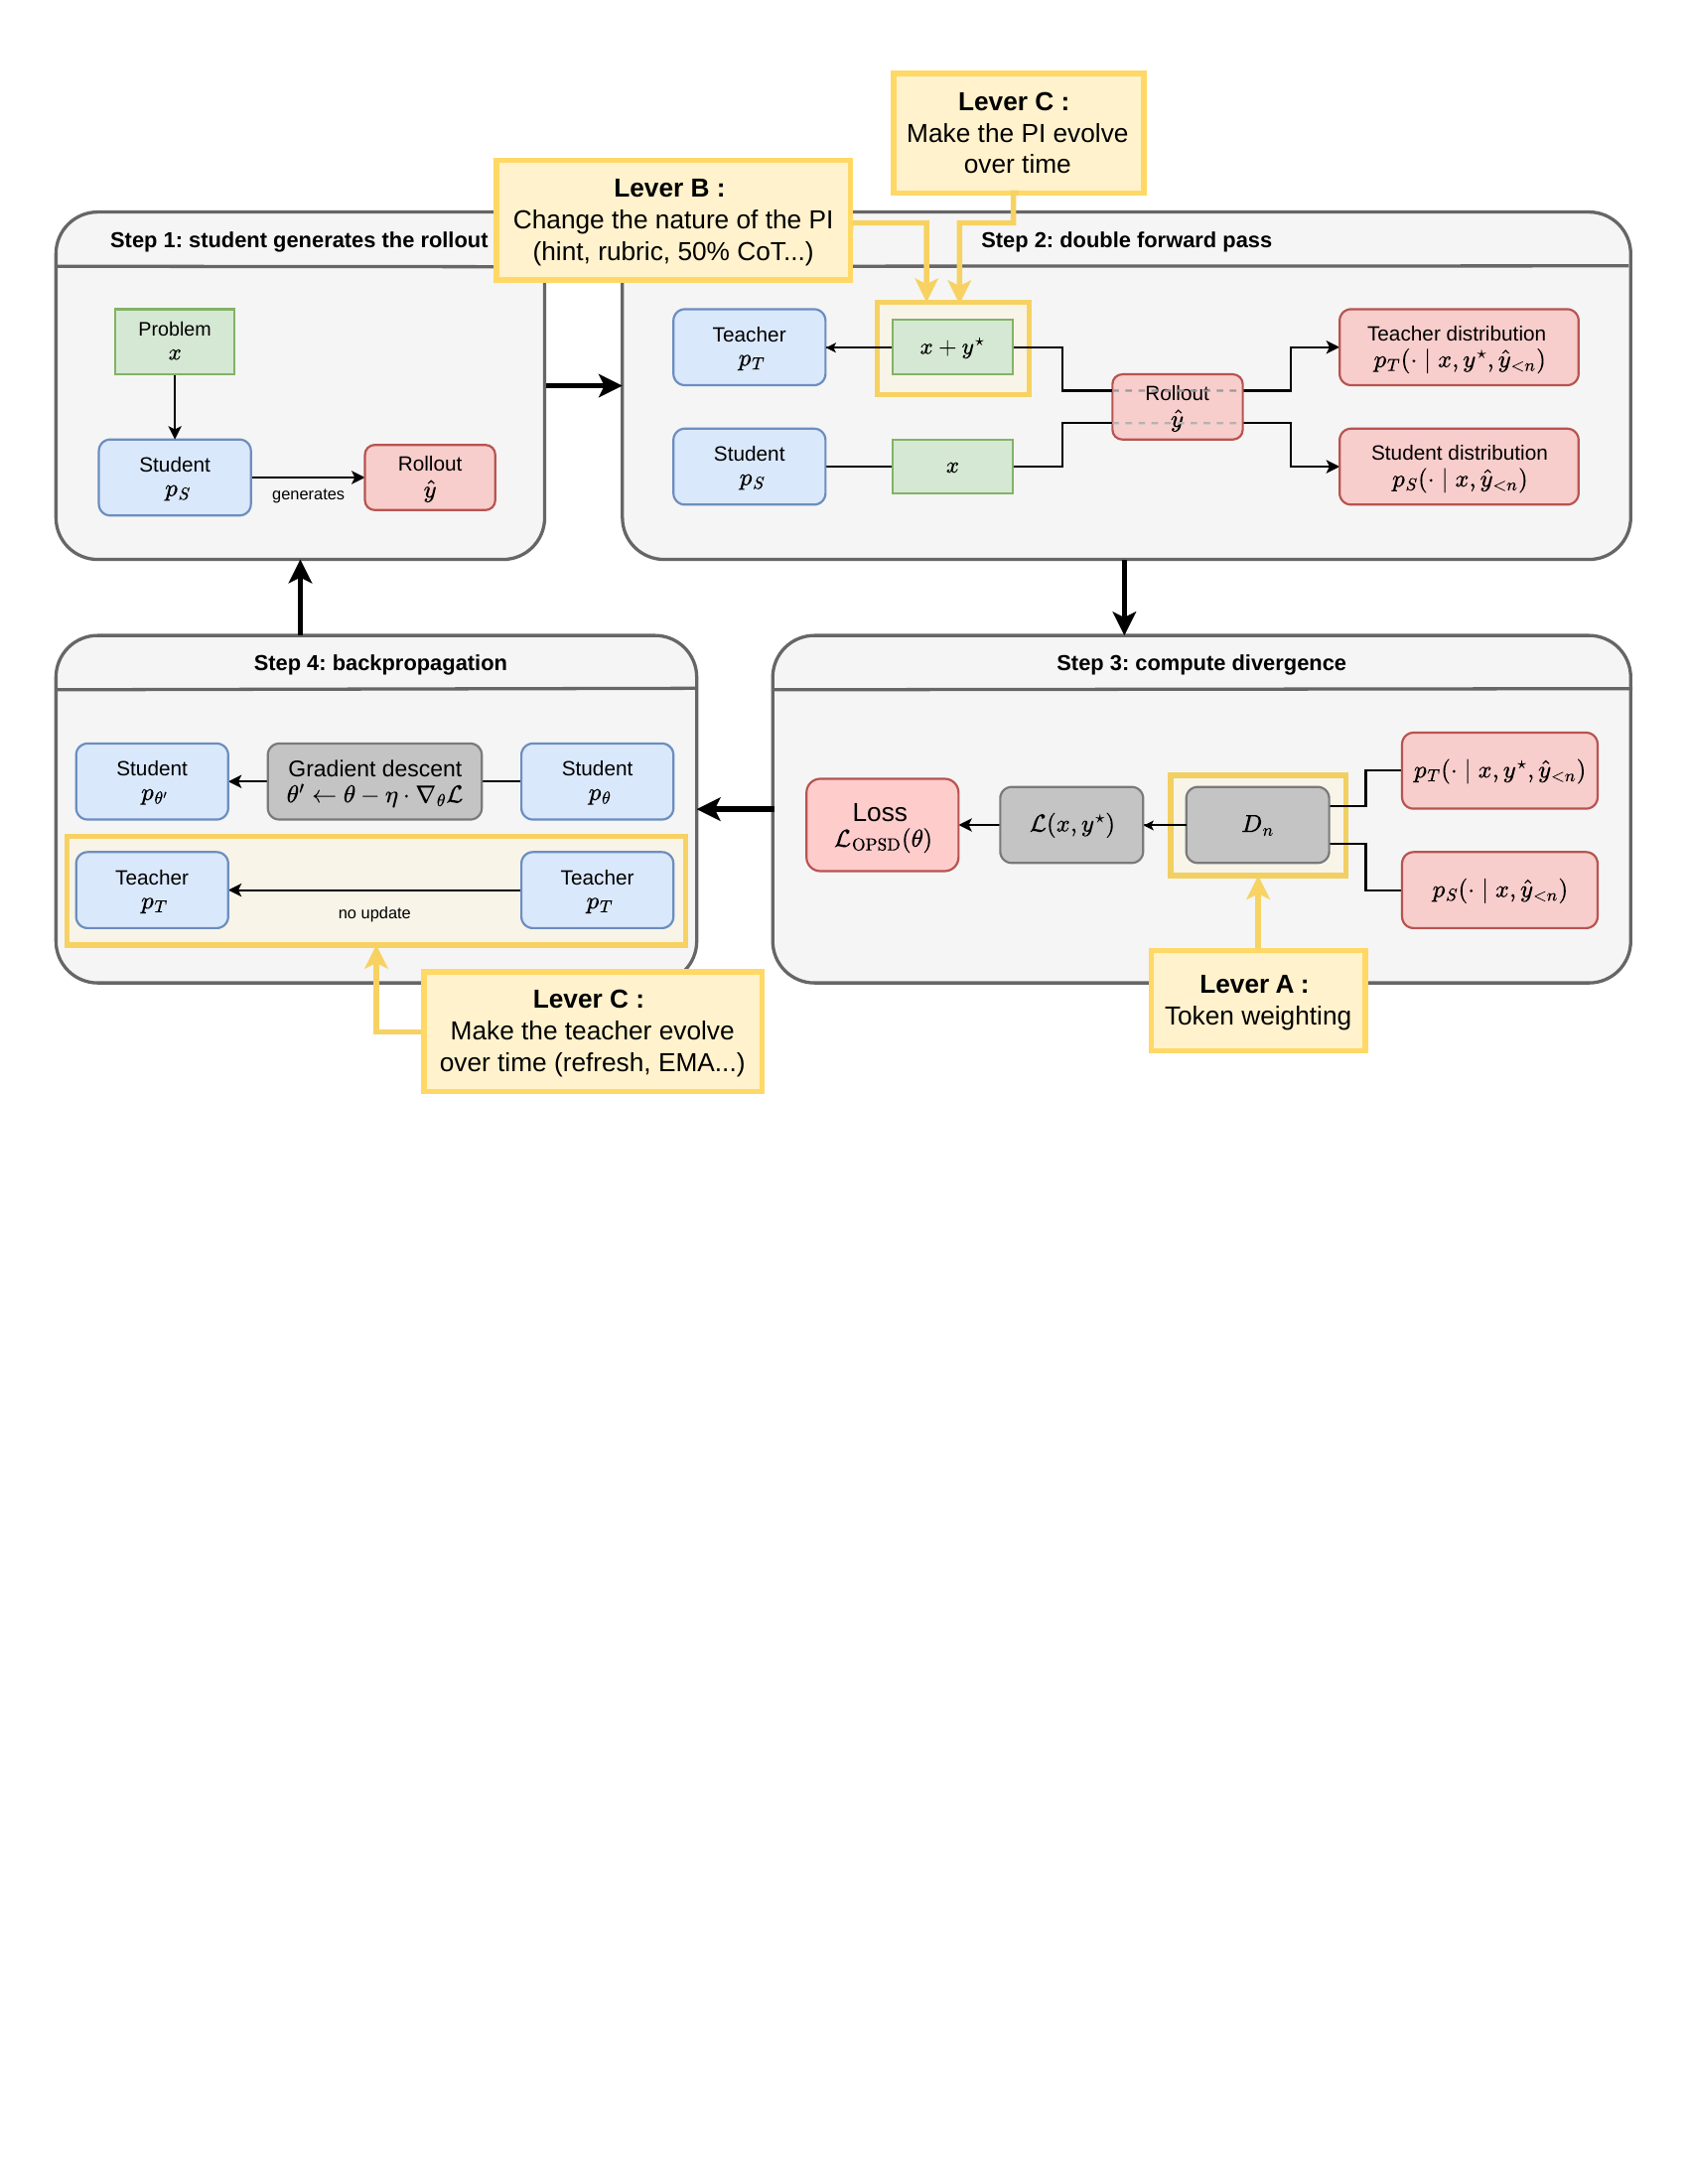
图4:三个杠杆映射到 OPSD 环路。Lever A 在散度计算处(token 加权),Lever B 在教师输入处(特权信息的性质),Lever C 出现在两处——教师接触特权信息的程度、以及教师权重的更新,这是两个独立机制
💡 我的判断
这篇综述的定位很诚实:没有新实验,贡献是结构性的。但我觉得它做的事恰恰是当前 OPSD 领域最缺的——过去半年这个方向出了十几篇论文,同一个现象被起了至少五个名字(collapse、entropy decay、rich-get-richer、epistemic suppression、fork rate 下降),各引各的,各治各的。把它们按"症状—成因族—杠杆"重新归拢之后,有几件事一下子清楚了:
- 最顺手的选择是最差的选择。参考解答是最便宜、最自然的特权信息,却几乎是最不可迁移的——这条结论对任何想快速复现 OPSD 的人都是当头一棒;
- 崩溃在均分和熵里都不可见,pass@k 是唯一的照妖镜。只看 avg@1 报成果的 OPSD 论文,从今天起都应该打个问号;
- 三个杠杆里,Lever C(教师动态)研究最薄,而恰恰是这个家族的崩溃要几百步之后才显形,短实验根本看不见——也就是说,现有文献可能系统性地低估了风险。
也有让我皱眉的地方。特权信息那张风险光谱,作者自己承认"只被文献部分支持,可能有误"——诚实是诚实,但"最终答案最危险"这个排序的强证据其实都来自强→弱蒸馏范式(Yu et al.)或非严格协议,严格自蒸馏下的全形态横向对比至今没人做过。另外全书式地引用视觉自监督的三条规则虽然顺滑,LLM 教师要不要 EMA、动量怎么随 batch 校准,全部没有直接实验,移植过来到底有多成立,我持保留意见。
工程上如果你现在要用这类方法,我的 takeaway 是三条:别直接喂参考解答,优先考虑错误对齐批评或分步提示;监控指标必须带 pass@k,别信熵;教师别急着上 EMA,先试试"学生真进步才刷新"的门控策略。
还有一个更本质的问题悬着:PMI 那张"信息越预设解答、崩溃越狠"的预测网格,如果真能被验证,特权信息的选择就可以从试错变成设计。谁来把这个实验做了,我觉得会是一篇很有分量的工作。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我