技能优化不一定要烧钱:COBRA-Skills 用老虎机算法把评估成本砍掉一半
你有没有算过一笔账:给 Agent 优化一份"技能"(skill),到底要花多少钱?
现在主流的做法是 generate–evaluate–refine 循环——生成一个候选技能,让目标 Agent 真跑一遍任务看效果,再根据轨迹改写,如此往复几十轮。每一轮评估都要烧 target model 的 token,每一次改写都要烧 teacher model 的 token。SkillOpt 这类方法跑一轮下来,光优化阶段就能花掉一百多美元。更要命的是,这里面大量评估预算花在了"一看就不行"的候选上——你得先花钱跑一遍,才知道它不行。
这篇 COBRA-Skills(arXiv 2609.11682)给出的答案挺直接:既然评估预算是有限的、候选的效用是不确定的,那这不就是个多臂老虎机问题吗?
核心摘要:论文把 Agent 技能优化建模为"动态演化候选空间上的带预算序列优化",用神经奖励预测器加 LinearUCB 探索奖励给候选技能排优先级,只把真金白银的评估花在"有前途或信息量大"的技能上;同时用三种基于执行证据的进化算子(重生、变异、交叉)周期性刷新技能种群。在 6 个异构 Agent 基准、3 个目标模型上,平均性能全部最强,比无技能基线分别提升 13.1、26.9、22.5 个点,而优化成本比 SkillOpt 降低 55% 到 58%,每个基准只用 50 条优化样本。我的判断:这不是底层突破,而是把该团队之前在 prompt 优化上的 neural bandit 工作平移到 skill 优化的一次漂亮落地——但"省钱一半还更强"这个性价比,对工程实践非常实在。
论文信息 - 标题:COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization - 作者:Pingchen Lu、Xiangyi Wang、Xiang Li、Jie Mao、Zikun Qu、Junfeng Luo、Yao Shu、Bryan Kian Hsiang Low、Zhongxiang Dai(通讯) - 机构:香港中文大学(深圳)、天津大学、香港科技大学(广州)、新加坡国立大学 - 链接:https://arxiv.org/abs/2609.11682 ,代码开源在 GitHub(Jerry-LuP/COBRA-Skills)
🎯 问题动机:技能优化的钱到底花在哪了
先把背景捋一下。Agent skill 就是从过往任务经验里蒸馏出来的可复用程序化知识——任务指南、推理策略、工具使用流程,解新任务时注入到 Agent 的上下文里。手写技能费时费力,让 LLM 凭空生成又容易产出"看起来对但没经过验证"的指导,所以近期工作都把技能构建锚定在真实执行轨迹上,再配合进化式迭代 refinement。
这条路work,但有两个效率瓶颈。
第一个瓶颈:候选效用太贵了。现有方法要知道一个技能好不好,必须让 target agent 在任务上真跑。评估预算大头就这么烧在了低质量候选上。
第二个瓶颈:改写本身也贵。反复调用 LLM 分析轨迹、诊断失败、聚合修改,token 开销随着轮数线性膨胀。
作者把这个问题提炼得很干净:在有限算力和有限任务经验下,关键不是"评估更多候选"或"改写更多次",而是有选择地分配评估,并且高效复用已有的执行证据。
看到这里我第一反应是——这不就是 contextual bandit 的标准设定吗?每个候选技能是一只"臂",用语义 embedding 当特征,观察到的 target agent 性能就是 reward。而技能种群会随进化不断变化,恰好对应 arm 集合可变的 contextual bandit。作者也是这么想的。
🧠 方法:Bandit 排序 × 证据进化 的闭环

图1:COBRA-Skills 整体流程。每轮先用神经奖励预测器加 LinearUCB 奖励给种群内技能打分(①),选出优先级最高的技能交给目标 Agent 执行评估(②),reward 和轨迹写入优化历史并更新打分模型(③);到了预定的种群更新节点,再从累积证据中进化出新技能(④),同时用最新优先级分数剪掉低分技能,组成新种群(⑤)。虚线框表示只在调度节点执行的操作。
整个框架是一个五步闭环,核心就两个模块。
Bandit 引导的技能搜索
对每个候选技能 \(s\),先用固定的 embedding 模型(实验用 Qwen3-Embedding-4B)拿到语义表示 \(z_s = \phi(s)\)。然后用一个轻量两层 MLP \(f_\theta\) 预测它的潜在效用——这个预测器在累积历史 \(\mathcal{H}_{t-1}\) 上用带 \(\ell_2\) 正则的 MSE 训练:
但只靠预测 reward 会过度利用当前看好的技能,漏掉那些"没怎么试过但可能不错"的候选。所以加一个 LinearUCB 风格的置信奖励:
其中 \(A_{t-1}=\lambda I+\sum_{i=1}^{t-1}z_{s_i}z_{s_i}^\top\) 是已评估技能 embedding 构成的正则化设计矩阵。直觉上,embedding 空间里探索得少的区域,置信奖励就大;被反复评估过的技能及其语义近邻,不确定性就衰减了。
最终优先级分数就是两者相加:\(U_t(s)=f_{\theta_{t-1}}(z_s)+b_t(z_s)\)。每轮只评估分数最高的那个候选。这个分数还身兼二职——种群更新时也用它来决定剪谁。
证据锚定的技能进化
种群不是每轮都刷新,而是周期性更新(满足 \(t-t_{\text{last}}\geq d\) 且 \(\log(t/t_{\text{last}})\geq\eta\) 才触发)。每次更新时重算优先级分数,把最低的 \(m\) 个技能剪掉,空位由三个进化算子补上:
- 重生(Regeneration):直接从最初的"无技能轨迹" \(\mathcal{T}_0\) 独立生成新候选,不依赖任何父技能,给种群注入新搜索方向,防早熟收敛;
- 轨迹变异(Rollout Mutation):拿本轮刚评估的技能 \(s_t\) 当父本,从它新产生的成功和失败轨迹中采样当证据,做局部改写。这把 bandit 评估和证据驱动的局部 refinement 直接缝在了一起;
- 交叉(Crossover):历史足够多之后,把已评估技能分成高绩效组和低绩效组,取一个强技能当骨干,用其他强技能的兼容策略当正面证据、弱技能当负面证据,做"以性能为依据的重组"——注意不是直接拼接父技能文本。
三个算子的比例也有讲究:评估过的不同技能不到 8 个时,重生:变异:交叉 = 2:1:0(还没攒够历史,先探索);之后切换为 1:1:1。
说实话,这套设计里我觉得最聪明的一点是:新生成的技能不继承任何 reward,必须重新进入同一个 bandit 评估循环。很多进化式方法会默认"子代站在父代肩膀上",COBRA-Skills 不信这个,一切效用都靠 target agent 真刀真枪跑出来。这避免了无依据的性能假设在进化链上累积放大。
工程配置:总共跑 \(T=30\) 轮,种群大小 \(K=10\),每次更新剪 \(m=3\) 个,\(\nu=0.1\),\(d=3\),\(\eta=0.35\)。所有超参在三个模型、六个基准上完全固定——这一点后面会再聊。
📊 实验:性能、成本、效率三头都占
实验设置:6 个基准覆盖问答(SearchQA)、表格操作(SpreadsheetBench)、视觉文档理解(DocVQA)、数学推理(LiveMath)、社会推理(SocialMaze 的 HRD 任务)、具身决策(ALFWorld),3 个目标模型 Qwen3.6-35B-A3B、GPT-5.4-Nano、Gemma-4-26B-A4B-it,teacher model 统一用 GPT-5.5(medium reasoning),测试集 100 条。对比方法:无技能 Baseline、LLM Skill(只做一次证据锚定生成、不做后续优化)、Trace2Skill、SkillOpt。
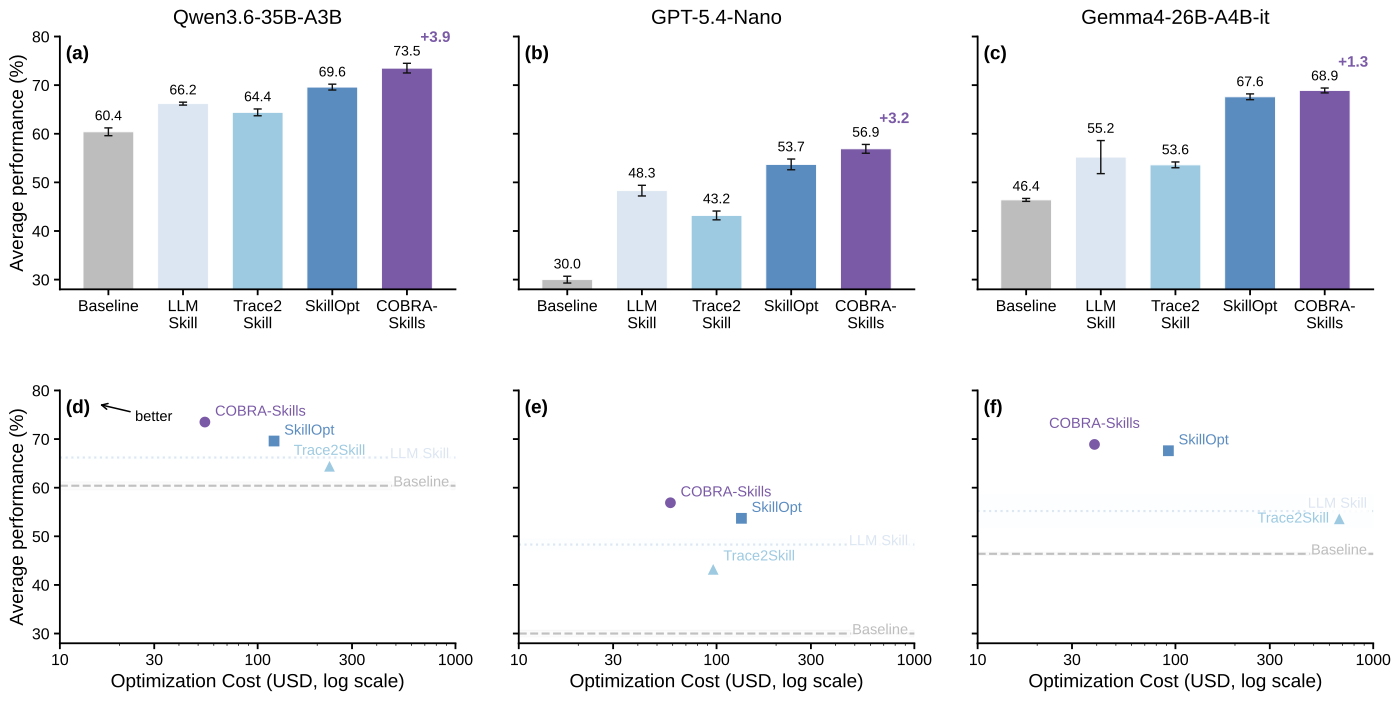
图2:上排是三个目标模型在六个基准上的平均测试性能,COBRA-Skills 在每个模型上都是最高的;下排是"性能—优化成本"散点图(横轴为对数刻度的美元成本),越靠左上越好——COBRA-Skills 在所有三个模型上都占据左上角位置。
主结果表(平均准确率 %,三次独立运行均值):
| 目标模型 | Baseline | LLM Skill | Trace2Skill | SkillOpt | COBRA-Skills |
|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | 60.4 | 66.2 | 64.4 | 69.6 | 73.5 |
| GPT-5.4-Nano | 30.0 | 48.3 | 43.2 | 53.7 | 56.9 |
| Gemma-4-26B-A4B-it | 46.4 | 55.2 | 53.6 | 67.6 | 68.9 |
相对无技能基线分别涨了 13.1、26.9、22.5 个点。GPT-5.4-Nano 上提升最猛——基线只有 30.0 分,技能注入空间本来就大。有意思的是 LLM Skill 这个"只生成不优化"的对照也稳定超过基线,说明证据锚定的技能生成本身就是个不错的起点,后续优化的增量是建立在这个起点之上的。
再看钱。Table 2 的效率对比是这篇论文最硬的干货:
| 模型 | 方法 | 提升点数 | Teacher/Target token(百万) | 成本(美元) | 每点成本(美元) |
|---|---|---|---|---|---|
| Qwen | SkillOpt | +9.2 | 15.16 / 93.77 | 121.02 | 13.15 |
| Qwen | COBRA-Skills | +13.1 | 3.00 / 115.92 | 54.10 | 4.13 |
| GPT-Nano | SkillOpt | +23.7 | 14.28 / 168.97 | 133.59 | 5.64 |
| GPT-Nano | COBRA-Skills | +26.9 | 3.78 / 110.07 | 58.46 | 2.17 |
| Gemma | SkillOpt | +21.2 | 12.51 / 89.38 | 92.14 | 4.35 |
| Gemma | COBRA-Skills | +22.5 | 4.13 / 125.16 | 38.98 | 1.73 |
总成本降 55%–58%,每点提升的成本降 60%–69%。但仔细看 token 分解会发现一个值得玩味的细节:省的钱几乎全来自 teacher model 侧——teaching token 比 SkillOpt 少了 67%–80%;而 target model 侧 COBRA-Skills 的 token 量其实跟 SkillOpt 同量级甚至略高(Qwen 上 115.92M 对 93.77M)。
等等,target 侧花的还更多,凭什么说评估分配更高效?作者的解释是:每个被选中的技能都在全部 50 条优化样本上评估,拿到的是聚合性能信号;钱没少花,但同样的 target 预算换来了更高的最终性能。这个解释我觉得成立,但也说明"bandit 省评估"主要体现在"少评估烂候选、把预算集中给好候选",而不是绝对评估次数的下降。进化算子只在调度节点触发,反复调 LLM 分析轨迹的开销被大幅压缩——这才是成本大头省下来的地方。
另外注意样本效率:COBRA-Skills 每个基准只用 50 条优化样本,而 Trace2Skill 和 SkillOpt 用的是更大的优化池。数据更少、成本更低、效果还更好,这个三角形同时成立确实不容易。
换执行框架还好用吗?
技能优化最怕"过拟合到某个执行接口"。作者把 Qwen 目标模型分别塞进 Claude Code 和 Codex 两个外部 harness,COBRA-Skills 平均分依然最高(68.2 和 72.4,对比 SkillOpt 的 64.0 和 71.1)。说明学到的技能捕捉的是任务层面的策略,不是某个 harness 的怪癖。
消融:两个组件都重要,但差距不算悬殊
Table 4 在 Qwen 上做了三组消融:w/o Bandit(保留进化但随机选候选,71.3)、w/o Evolution(bandit 跑在固定的 30 技能池上,71.1)、Best-of-30(同样大小的固定池直接选最好,71.0),完整版 73.5。
三个变体都掉 2.2 到 2.5 个点。结论是两个组件互补、且收益不能只靠"生成更多候选选最好的"来解释。不过说实话,2.5 个点以内的差距谈不上碾压——如果预算充足,Best-of-30 这种暴力做法也能拿到大部分收益。COBRA-Skills 的价值更多体现在"预算受限时"的场景,这也正是它建模问题的出发点。
自教学:没有更强的老师行不行?
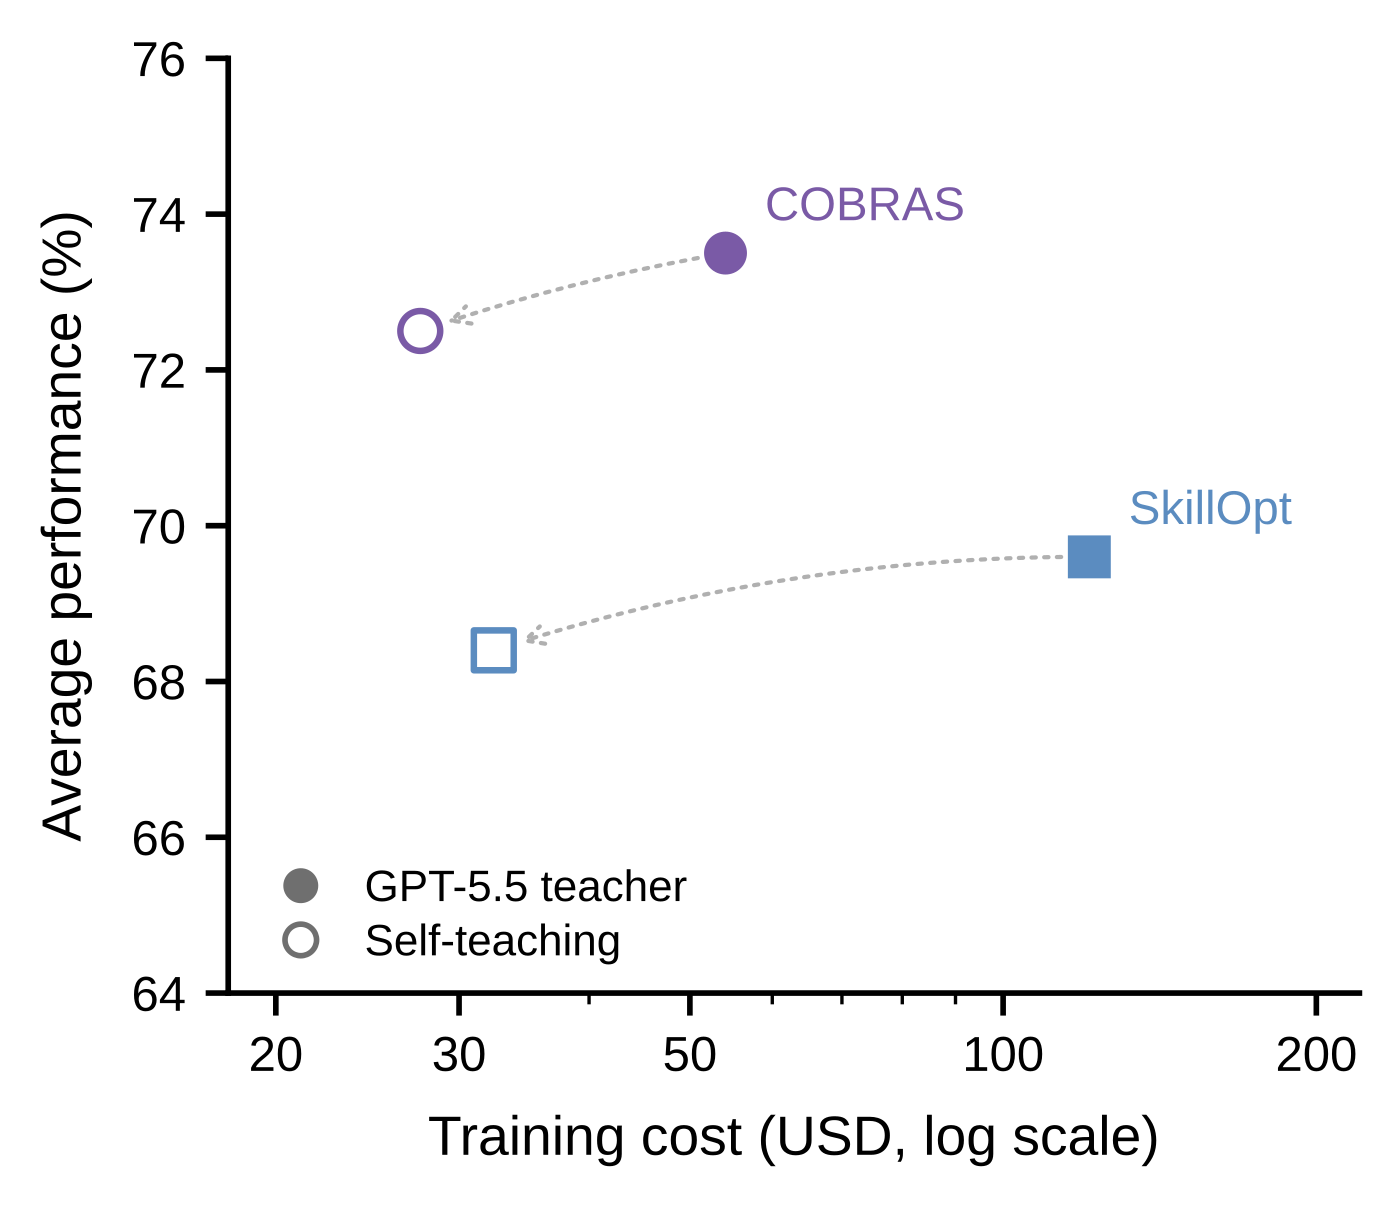
图5:实心点是 GPT-5.5 当 teacher,空心点是目标模型自己当 teacher。COBRA-Skills 自教学只从 73.5 微降到 72.5,成本还降了约一半;而 SkillOpt 自教学从 69.6 掉到 68.5。两种教学设置下 COBRA-Skills 都明显更强。
这个实验我挺喜欢,因为它正面回应了一个尖锐质疑:性能会不会主要来自 GPT-5.5 这个强 teacher?答案是基本不会——自教学只掉 1 个点,还省一半钱。对没有条件调强模型 API 的团队,这是个很实用的结论。
跨模型迁移:技能是任务策略,不是模型补丁

图6:行是优化时用的目标模型,列是评估时的目标模型,格子内是测试分数及相对评估模型无技能基线的提升。36 个跨模型迁移里有 34 个是正向的,SocialMaze 上甚至出现 +83.7 这种夸张提升;仅有的两个负迁移都出现在 DocVQA 的 Gemma 列。
36 个迁移组合 34 个正向,说明优化出的技能确实编码了可复用的任务级策略。SocialMaze 迁移收益普遍几十个点,DocVQA 上那两个微弱的负迁移(-1.3、-1.7)更像是任务本身天花板已到——基线就有 80 分,技能能加的空间本来就小。
探索系数的甜点
ν 的敏感性实验显示性能随 ν 先升后降,在 0.1 处见顶。探索太少会过早锁死在当前最优,探索太多则浪费预算在明显没戏的候选上——标准的 exploration–exploitation 权衡,没什么意外,但至少说明默认配置踩在了甜点上,而且全部实验用同一组超参没调过,鲁棒性加分。
💡 我的判断
先说这篇论文的"出身"。通讯作者 Zhongxiang Dai 和 Yao Shu、Bryan Low 这个组合,此前就做过 INSTINCT(用 neural bandit 优化指令)和 federated neural bandits 这一系列工作。COBRA-Skills 其实是把这套"neural 预测 + LinUCB 探索"的候选选择框架,从 prompt 空间平移到了 skill 空间,再缝上进化算子处理"候选集在变"这个新问题。
所以你要是问这是不是底层突破,我的答案是:不是。这是把成熟工具用在对的问题上,而且用得很干净。
但它的工程价值是实打实的。三个地方让我愿意推荐:
第一,问题建模诚实。"评估有预算、样本只有 50 条、候选效用不确定"——这是真实工程场景,不是实验室里无限预算的刷榜设定。Best-of-30 的消融也承认了"预算充足时暴力法也能打",没有过度包装。
第二,成本分解透明。token 按 teacher/target 分开报,美元成本按固定单价折算,读者能清楚看到钱省在哪一侧。这比只报一个"效率提升 xx%"的笼统数字可信得多。
第三,自教学和跨 harness 两个实验回应了最可能的质疑,而且结果都对它有利。
要挑刺的话也有几处。一是消融差距偏小(2.2–2.5 个点),组件贡献有但没有压倒性;二是 30 轮 × 每轮全量评估 50 条样本的协议,target 侧 token 并不比 baseline 省,如果 target model 本身是贵价 API,成本优势会缩水——论文三个模型里恰好 target 都不算贵;三是种群更新调度的 \(d\)、\(\eta\) 是启发式的,论文没给敏感性分析,换任务分布时可能要重调;四是技能目前还是"单技能注入"形态,没涉及技能库检索、组合这些更接近生产环境的设定,那是另一条研究线的事了。
如果你正在做 Agent 技能的自动优化,或者更广义的"LLM 产物(prompt、skill、配置)在有限评估预算下的搜索",这套"bandit 排序 + 证据进化"的闭环值得直接抄作业。代码已开源,超参全固定,复现门槛不高。
更一般地,这篇论文再次验证了一个我一直在观察的趋势:序列决策里的经典工具(bandit、贝叶斯优化)正在系统性地接管 LLM 时代的"昂贵黑盒优化"问题。prompt 优化如此,skill 优化如此,接下来大概率轮到 tool 配置、memory 策略这些更复杂的对象。工具是旧的,问题是新的,这就够了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我